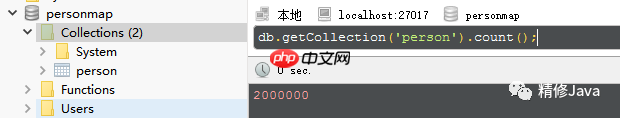
为了展示mongodb的性能分析方法,我们首先创建一个包含200万个文档的集合。(在我的电脑上,插入过程大约耗时15分钟。如果您想插入更多文档,只要有耐心等待即可。)
为了演示的效果,我们先来创建一个有200万个文档的记录。(我自己的电脑耗了15分钟左右插入完成。如果你想插更多的文档也没问题,只要有耐心等就可以了。)
下面是用于创建这些文档的JavaScript代码:
for(var i=0;i<2000000;i++){ db.person.insert({name:"person"+i,age:Math.floor(Math.random()*100)})}
在mongoDB 3.0及之后的版本中,explain()方法的返回值和使用方式与之前的版本有显著变化。鉴于3.0版本的优越特性和我们当前使用的是3.0.7版本,本文仅讨论mongoDB 3.0+版本的explain()方法。3.0+版本的explain()有三种模式:queryPlanner、executionStats和allPlansExecution。在实际开发中,常用的是executionStats模式,本文主要分析这种模式。
mongoDB 3.0之后,explain的返回与使用方法与之前版本有了很大的变化,介于3.0之后的优秀特色和我们目前所使用给的是3.0.7版本,本文仅针对mongoDB 3.0+的explain进行讨论。3.0+的explain有三种模式,分别是:queryPlanner、executionStats、allPlansExecution。现实开发中,常用的是executionStats模式,主要分析这种模式。
接下来,我们为person集合中的age字段创建索引:
db.person.createIndex({"age":1})
然后,我们使用explain()方法来查看具体的执行计划:
db.getCollection('person').find({"age":{"$lte":2000}}).explain("executionStats")
对queryPlanner的分析
queryPlanner: queryPlanner的返回
queryPlanner.namespace:该值返回的是该查询所涉及的集合名称。
queryPlanner.namespace:该值返回的是该query所查询的表
queryPlanner.indexFilterSet:表示该查询是否有索引过滤器。
queryPlanner.indexFilterSet:针对该query是否有indexfilter
queryPlanner.winningPlan:查询优化器针对该查询返回的最优执行计划的详细信息。
queryPlanner.winningPlan:查询优化器针对该query所返回的最优执行计划的详细内容。
queryPlanner.winningPlan.stage:最优执行计划的阶段,此处返回的是FETCH,可以理解为通过索引位置检索具体文档(stage有多种模式,将在后文中详细解释)。
queryPlanner.winningPlan.stage:最优执行计划的stage,这里返回是FETCH,可以理解为通过返回的index位置去检索具体的文档(stage有数个模式,将在后文中进行详解)。
queryPlanner.winningPlan.inputStage:用来描述子阶段,并为其父阶段提供文档和索引关键字。
queryPlanner.winningPlan.inputStage:用来描述子stage,并且为其父stage提供文档和索引关键字。
queryPlanner.winningPlan.stage的子阶段,此处是IXSCAN,表示进行的是索引扫描。
queryPlanner.winningPlan.stage的child stage,此处是IXSCAN,表示进行的是index scanning。
queryPlanner.winningPlan.keyPattern:所扫描的索引内容,此处是did:1,status:1,modify_time: -1和scid : 1。
queryPlanner.winningPlan.keyPattern:所扫描的index内容,此处是did:1,status:1,modify_time: -1与scid : 1
queryPlanner.winningPlan.indexName:winning plan所选用的索引。
queryPlanner.winningPlan.indexName:winning plan所选用的index。
queryPlanner.winningPlan.isMultiKey:是否是Multikey,此处返回是false,如果索引建立在数组上,此处将是true。
queryPlanner.winningPlan.isMultiKey是否是Multikey,此处返回是false,如果索引建立在array上,此处将是true。
queryPlanner.winningPlan.direction:此查询的查询顺序,此处是forward,如果使用了.sort({modify_time:-1})将显示backward。
queryPlanner.winningPlan.direction:此query的查询顺序,此处是forward,如果用了.sort({modify_time:-1})将显示backward。
queryPlanner.winningPlan.indexBounds:winning plan所扫描的索引范围,如果没有指定范围就是[MaxKey, MinKey],这主要是直接定位到mongoDB的chunk中去查找数据,加快数据读取。
queryPlanner.winningPlan.indexBounds:winningplan所扫描的索引范围,如果没有制定范围就是[MaxKey, MinKey],这主要是直接定位到mongodb的chunck中去查找数据,加快数据读取。
queryPlanner.rejectedPlans:其他执行计划(非最优而被查询优化器reject的)的详细返回,其中具体信息与winningPlan的返回中意义相同,故不再赘述。
queryPlanner.rejectedPlans:其他执行计划(非最优而被查询优化器reject的)的详细返回,其中具体信息与winningPlan的返回中意义相同,故不在此赘述。
对executionStats返回逐层分析
第一层,executionTimeMillis
最直观的explain返回值是executionTimeMillis值,表示这条语句的执行时间,当然希望这个值越小越好。
最为直观explain返回值是executionTimeMillis值,指的是我们这条语句的执行时间,这个值当然是希望越少越好。
其中有3个executionTimeMillis,分别是:
executionStats.executionTimeMillis该query的整体查询时间。
executionStats.executionStages.executionTimeMillisEstimate:该查询根据索引去检索文档获得2001条数据的时间。
executionStats.executionStages.executionTimeMillisEstimate该查询根据index去检索document获得2001条数据的时间。
executionStats.executionStages.inputStage.executionTimeMillisEstimate:该查询扫描2001行索引所用时间。
executionStats.executionStages.inputStage.executionTimeMillisEstimate该查询扫描2001行index所用时间。
第二层,索引与文档扫描数与查询返回条目数
主要讨论3个返回项,nReturned、totalKeysExamined、totalDocsExamined,分别代表该查询返回的条目、索引扫描条目、文档扫描条目。
这个主要讨论3个返回项,nReturned、totalKeysExamined、totalDocsExamined,分别代表该条查询返回的条目、索引扫描条目、文档扫描条目。
这些都是直接影响到executionTimeMillis,我们需要扫描的越少速度越快。
这些都是直观地影响到executionTimeMillis,我们需要扫描的越少速度越快。
对于一个查询,我们最理想的状态是:nReturned=totalKeysExamined=totalDocsExamined。
对于一个查询,我们最理想的状态是:nReturned=totalKeysExamined=totalDocsExamined
第三层,stage状态分析
那么是什么影响到了totalKeysExamined和totalDocsExamined?是stage的类型。类型列举如下:
那么又是什么影响到了totalKeysExamined和totalDocsExamined?是stage的类型。类型列举如下:
COLLSCAN:全表扫描
COLLSCAN:全表扫描
IXSCAN:索引扫描
IXSCAN:索引扫描
FETCH:根据索引去检索指定文档
FETCH:根据索引去检索指定document
SHARD_MERGE:将各个分片返回数据进行合并
SHARD_MERGE:将各个分片返回数据进行merge
SORT:表明在内存中进行了排序
SORT:表明在内存中进行了排序
LIMIT:使用limit限制返回数
LIMIT:使用limit限制返回数
SKIP:使用skip进行跳过
SKIP:使用skip进行跳过
IDHACK:针对_id进行查询
IDHACK:针对_id进行查询
SHARDING_FILTER:通过mongos对分片数据进行查询
SHARDING_FILTER:通过mongos对分片数据进行查询
COUNT:利用db.coll.explain().count()之类进行count运算
COUNT:利用db.coll.explain().count()之类进行count运算
COUNTSCAN:count不使用Index进行count时的stage返回
COUNTSCAN:count不使用Index进行count时的stage返回
COUNT_SCAN:count使用了Index进行count时的stage返回
COUNT_SCAN:count使用了Index进行count时的stage返回
SUBPLA:未使用到索引的$or查询的stage返回
SUBPLA:未使用到索引的$or查询的stage返回
TEXT:使用全文索引进行查询时候的stage返回
TEXT:使用全文索引进行查询时候的stage返回
PROJECTION:限定返回字段时候stage的返回
PROJECTION:限定返回字段时候stage的返回
对于普通查询,我希望看到stage的组合(查询的时候尽可能用上索引):
对于普通查询,我希望看到stage的组合(查询的时候尽可能用上索引):
Fetch+IDHACK
Fetch+IDHACK
Fetch+ixscan
Fetch+ixscan
Limit+(Fetch+ixscan)
Limit+(Fetch+ixscan)
PROJECTION+ixscan
PROJECTION+ixscan
SHARDING_FILTER+ixscan
SHARDING_FITER+ixscan
COUNT_SCAN
COUNT_SCAN
不希望看到包含如下的stage:
不希望看到包含如下的stage:
COLLSCAN(全表扫描),SORT(使用sort但是无index),不合理的SKIP,SUBPLA(未用到index的$or),COUNTSCAN(不使用index进行count)
COLLSCAN(全表扫描),SORT(使用sort但是无index),不合理的SKIP,SUBPLA(未用到index的$or),COUNTSCAN(不使用index进行count)
以上就是玩转mongoDB(五):mongoDB 3.0+ 查询性能分析的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/21527.html
 微信扫一扫
 支付宝扫一扫