Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
在Loom中利用虚拟线程实现递归任务:告别ForkJoinPool的限制_创想鸟

在Loom中利用虚拟线程实现递归任务:告别ForkJoinPool的限制

在Loom中利用虚拟线程实现递归任务:告别ForkJoinPool的限制

本文探讨了Java Loom中RecursiveAction和RecursiveTask与虚拟线程的兼容性。由于它们设计上依赖于ForkJoinPool及其特定的工作线程,无法直接与虚拟线程配合使用。文章提供了两种替代方案:一是利用CompletableFuture结合虚拟线程工厂实现自定义递归任务,二是介绍孵化阶段的StructuredTaskScope API,以更结构化的方式管理并发子任务。这些方法允许开发者在虚拟线程环境下高效地执行递归分解任务,同时避免了传统ForkJoinPool的限制。

RecursiveAction与RecursiveTask不兼容虚拟线程的原因

recursiveaction和recursivetask是java并发api中用于支持分治算法的抽象基类,它们专为forkjoinpool设计。正如其文档所述,它们是“在forkjoinpool中运行任务的抽象基类”。forkjoinpool虽然允许通过线程工厂进行定制,但它要求的是forkjoinpool.forkjoinworkerthreadfactory接口的实现,用于生产forkjoinworkerthread实例。

ForkJoinWorkerThread是Thread的子类,这意味着它们是平台线程(Platform Thread)的特化。虚拟线程(Virtual Thread)则是一种轻量级的线程,由Thread.Builder.OfVirtual创建,与传统的平台线程在实现机制上存在根本差异。因此,ForkJoinPool无法通过其内部的线程工厂机制来创建或使用虚拟线程。这意味着,RecursiveAction和RecursiveTask无法直接与虚拟线程结合使用。

重新思考递归任务在虚拟线程环境下的实现

RecursiveAction和RecursiveTask的核心价值在于提供了任务分解的抽象,并与ForkJoinPool的窃取式工作队列(work-stealing queue)机制相结合,以有效地平衡平台线程上的工作负载。然而,当引入虚拟线程时,这种工作负载平衡的必要性发生了变化。虚拟线程非常轻量,可以大量创建,并且由JVM运行时高效地映射到少量平台线程上。如果每个子任务都可以在自己的虚拟线程上运行,那么ForkJoinPool提供的复杂工作调度和负载平衡机制可能不再是必需的。开发者可以更直接地实现任务的递归分解,并利用虚拟线程的优势。

方案一:基于CompletableFuture的自定义递归任务

在虚拟线程环境下,我们可以利用CompletableFuture的异步执行能力来构建自定义的递归任务。CompletableFuture.runAsync()或CompletableFuture.supplyAsync()方法可以接受一个Executor,我们可以传入一个创建虚拟线程的Executor,例如Thread::startVirtualThread。

以下是一个简单的示例,演示如何使用CompletableFuture和虚拟线程实现一个递归任务:

import java.util.concurrent.CompletableFuture;import java.util.concurrent.TimeUnit;import java.util.concurrent.locks.LockSupport;public class VirtualThreadRecursiveTask {    /**     * 模拟一个递归任务,使用虚拟线程执行子任务。     * 每个子任务都会在新的虚拟线程中运行。     */    record PseudoTask(int from, int to) {        public static CompletableFuture run(int from, int to) {            // 使用Thread::startVirtualThread作为Executor,确保任务在虚拟线程中运行            return CompletableFuture.runAsync(                new PseudoTask(from, to)::compute, Thread::startVirtualThread);        }        protected void compute() {            int mid = (from + to) >>> 1; // 计算中间值            if (mid == from) {                // 达到基本情况,模拟实际处理,可能包含阻塞操作                System.out.println(Thread.currentThread().getName() + " processing: [" + from + ", " + to + ")");                LockSupport.parkNanos(TimeUnit.MILLISECONDS.toNanos(50)); // 模拟耗时操作            } else {                // 递归分解任务                CompletableFuture sub1 = run(from, mid);                CompletableFuture sub2 = run(mid, to);                // 等待所有子任务完成。这里的join()会阻塞当前虚拟线程,                // 但由于虚拟线程的特性,它可以在阻塞时被卸载,不会阻塞底层平台线程。                sub1.join();                 sub2.join();            }        }    }    public static void main(String[] args) throws InterruptedException {        long startTime = System.currentTimeMillis();        System.out.println("Starting recursive task with virtual threads...");        PseudoTask.run(0, 1_000).join(); // 启动根任务并等待其完成        long endTime = System.currentTimeMillis();        System.out.println("Recursive task completed in " + (endTime - startTime) + " ms.");    }}

注意事项:

join()的阻塞性:尽管CompletableFuture.join()是阻塞的,但在虚拟线程中,这种阻塞不会像在平台线程中那样导致底层操作系统线程的浪费。当虚拟线程被阻塞时,它会被JVM卸载,允许底层平台线程执行其他可运行的虚拟线程。线程数量:上述示例中,每个子任务都会创建一个新的虚拟线程,这在任务分解粒度很细时可能导致创建大量的虚拟线程。对于PseudoTask.run(0, 1_000)这样的调用,可能创建接近2000个虚拟线程。虽然虚拟线程非常轻量,但过多的创建和调度仍可能带来开销。

为了优化线程创建数量,可以采用类似ForkJoinPool中“工作窃取”的策略,即一个线程处理一部分任务,另一部分任务提交给其他线程。例如,只将一半范围的任务提交到新的虚拟线程,而另一半则在当前虚拟线程中局部处理:

import java.util.concurrent.CompletableFuture;import java.util.concurrent.TimeUnit;import java.util.concurrent.locks.LockSupport;public class OptimizedVirtualThreadRecursiveTask {    /**     * 优化后的递归任务,将一半子任务提交到新的虚拟线程,另一半在当前线程处理。     */    record PseudoTask(int from, int to) {        public static CompletableFuture run(int from, int to) {            return CompletableFuture.runAsync(                new PseudoTask(from, to)::compute, Thread::startVirtualThread);        }        protected void compute() {            CompletableFuture pendingFutures = null; // 用于收集异步子任务的CompletableFuture            // 循环处理,直到达到基本情况            for (int currentFrom = this.from; ; currentFrom = (currentFrom + to) >>> 1) {                int mid = (currentFrom + to) >>> 1;                if (mid == currentFrom) {                    // 达到基本情况,模拟实际处理                    System.out.println(Thread.currentThread().getName() + " processing: [" + currentFrom + ", " + to + ")");                    LockSupport.parkNanos(TimeUnit.MILLISECONDS.toNanos(50));                    break; // 退出循环                } else {                    // 提交一半任务到新的虚拟线程                    CompletableFuture subTaskFuture = run(currentFrom, mid);                    if (pendingFutures == null) {                        pendingFutures = subTaskFuture;                    } else {                        // 将新的子任务Future与之前的Future组合                        pendingFutures = CompletableFuture.allOf(pendingFutures, subTaskFuture);                    }                    // 另一半任务 (mid到to) 将在下一次循环中由当前虚拟线程处理                }            }            // 等待所有异步提交的子任务完成            if (pendingFutures != null) {                pendingFutures.join();            }        }    }    public static void main(String[] args) throws InterruptedException {        long startTime = System.currentTimeMillis();        System.out.println("Starting optimized recursive task with virtual threads...");        PseudoTask.run(0, 1_000_000).join(); // 启动根任务并等待其完成,处理更大范围        long endTime = System.currentTimeMillis();        System.out.println("Optimized recursive task completed in " + (endTime - startTime) + " ms.");    }}

这种优化策略对于PseudoTask.run(0, 1_000_000)这样的大范围任务会产生显著差异,它将创建大约100万个虚拟线程,而不是200万个。这体现了在虚拟线程环境下,开发者仍然需要考虑任务分解的粒度与效率,尽管虚拟线程本身非常轻量。

方案二:利用StructuredTaskScope进行结构化并发 (孵化中)

Java的孵化模块jdk.incubator.concurrent中引入了StructuredTaskScope,它提供了一种更结构化的方式来管理并发任务的生命周期。StructuredTaskScope允许在一个作用域内启动多个子任务,并等待所有子任务完成,或者在任何子任务失败时关闭整个作用域。这与递归任务的分解和聚合模式非常契合。

import jdk.incubator.concurrent.StructuredTaskScope;import java.util.concurrent.TimeUnit;import java.util.concurrent.locks.LockSupport;public class StructuredTaskScopeRecursiveTask {    /**     * 使用StructuredTaskScope实现递归任务。     * 注意:StructuredTaskScope是孵化API,可能在未来版本中发生变化。     */    record PseudoTask(int from, int to) {        public static void run(int from, int to) {            // 使用ShutdownOnFailure策略,任何子任务失败都会导致整个作用域关闭            try (var scope = new StructuredTaskScope.ShutdownOnFailure()) {                new PseudoTask(from, to).compute(scope);                scope.join(); // 等待所有子任务完成                scope.throwIfFailed(); // 抛出任何失败的异常            } catch (InterruptedException e) {                Thread.currentThread().interrupt();                throw new IllegalStateException("Task interrupted", e);            } catch (Exception e) {                throw new RuntimeException("Task failed", e);            }        }        protected Void compute(StructuredTaskScope scope) {            // 同样采用只提交一半任务的优化策略            for (int currentFrom = this.from; ; currentFrom = (currentFrom + to) >>> 1) {                int mid = (currentFrom + to) >>> 1;                if (mid == currentFrom) {                    // 达到基本情况,模拟实际处理                    System.out.println(Thread.currentThread().getName() + " processing: [" + currentFrom + ", " + to + ")");                    LockSupport.parkNanos(TimeUnit.MILLISECONDS.toNanos(50));                    break;                } else {                    var sub = new PseudoTask(currentFrom, mid);                    // 使用scope.fork()启动子任务,它会在虚拟线程中运行                    scope.fork(() -> sub.compute(scope));                }            }            return null; // 返回Void        }    }    public static void main(String[] args) {        long startTime = System.currentTimeMillis();        System.out.println("Starting recursive task with StructuredTaskScope...");        PseudoTask.run(0, 1_000_000); // 启动根任务        long endTime = System.currentTimeMillis();        System.out.println("StructuredTaskScope recursive task completed in " + (endTime - startTime) + " ms.");    }}

StructuredTaskScope的特点:

结构化并发:它强制了子任务的生命周期与父任务的作用域绑定,提高了代码的可读性和可维护性,避免了资源泄漏。虚拟线程支持:StructuredTaskScope天然支持虚拟线程,其fork()方法默认会在虚拟线程中执行子任务。集中等待:与CompletableFuture的join()不同,StructuredTaskScope的join()方法通常只在根任务中调用一次,等待所有子任务完成,子任务本身无需等待其直接子任务。错误处理:ShutdownOnFailure策略能够在一个子任务失败时,优雅地取消其他正在运行的子任务并关闭整个作用域。

注意事项:

StructuredTaskScope是一个孵化(Incubator)API,这意味着它可能在未来的Java版本中发生API变更或被移除,不建议在生产环境中使用。

总结与注意事项

尽管RecursiveAction和RecursiveTask无法直接与虚拟线程配合使用,但这并不意味着分治算法无法在Loom中高效实现。相反,虚拟线程提供了更灵活和强大的工具来构建并发的递归任务。

理解限制:RecursiveAction/RecursiveTask与ForkJoinPool紧密耦合,无法利用虚拟线程。拥抱CompletableFuture:对于自定义递归任务,CompletableFuture结合虚拟线程工厂提供了一种直接且强大的实现方式。它允许开发者完全控制任务的分解和执行。考虑优化策略:即使在虚拟线程环境下,也应根据任务特性考虑优化策略,例如局部处理一部分任务以减少虚拟线程的创建数量,这对于CPU密集型或大量细粒度任务尤其重要。关注StructuredTaskScope:StructuredTaskScope代表了Java并发模型未来的发展方向,它提供了一种更安全、更易于管理的结构化并发范式。尽管目前仍处于孵化阶段,但其设计理念和功能对于处理递归并发任务具有巨大潜力。

在选择实现方案时,开发者应根据项目的具体需求、对API稳定性的要求以及任务的性质(I/O密集型或CPU密集型)进行权衡。对于I/O密集型的递归任务,虚拟线程的优势尤为明显,因为它能显著提高并发度而无需担心线程开销。

以上就是在Loom中利用虚拟线程实现递归任务:告别ForkJoinPool的限制的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/27192.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
windows11自动锁屏时间怎么设置得更长或永不锁屏_windows11修改自动锁屏时间的方法
上一篇 2025年11月2日 22:51:08
如何在Krita中使用AI裁剪图片?快速掌握高效图像裁剪技巧
下一篇 2025年11月2日 22:54:11

相关推荐

  • 谷歌浏览器PDF文件注释功能无法使用怎么办

    谷歌浏览器PDF文件注释功能无法使用怎么办谷歌浏览器PDF文件注释功能无法使用怎么办谷歌浏览器PDF文件注释功能无法使用怎么办谷歌浏览器PDF文件注释功能无法使用怎么办

    首先检查PDF权限,若文件设有限制需用专业工具解除;2. 确认非PDF/A格式,必要时转换为普通PDF;3. 推荐使用UPDF等专业软件实现完整注释功能;4. 清除浏览器缓存或重置Chrome设置以排除临时故障。 谷歌浏览器自带的PDF阅读器功能虽然方便,但有时会遇到无法使用注释功能的问题。这通常与…

    2026年9月22日 用户投稿
    300
  • Apache Pulsar 主题分区创建与管理指南

    本文深入探讨Apache Pulsar主题分区的创建与管理。Pulsar主题分区是实现高吞吐量和可伸缩性的关键,但必须在主题创建时进行配置。文章详细介绍了两种主要的分区主题创建方法:通过Broker配置实现自动分区,以及利用Pulsar Admin API进行显式创建,并强调了分区主题一旦创建后不可…

    2026年9月22日
    100
  • win10激活失败怎么办_win10系统激活错误原因及解决方案

    首先验证产品密钥正确性并重新输入,随后通过设置中的激活疑难解答工具自动修复问题,接着使用管理员命令提示符执行slmgr命令重置激活状态,同时运行sfc /scannow检查系统文件完整性,对于预装系统可查询OA 3.0出厂密钥进行激活。 如果您在尝试激活Windows 10系统时遇到失败提示,可能是…

    2026年9月22日
    300
  • iPhone情侣模式如何自定义表情包?制作专属情侣表情的详细步骤

    iPhone情侣模式下可自定义表情包,通过Memoji或第三方App实现。首先可用“信息”应用创建Memoji,自定义外貌特征并录制视频发送;其次在App Store下载表情包制作App,上传合照或个人照,添加文字、贴纸、边框等元素,制成情侣专属静态或GIF表情包,支持导出为iMessage贴纸;还…

    2026年9月22日
    000
  • MySQL慢查询日志分析技巧_MySQL慢查询优化策略全方位讲解

    MySQL慢查询日志分析技巧_MySQL慢查询优化策略全方位讲解MySQL慢查询日志分析技巧_MySQL慢查询优化策略全方位讲解MySQL慢查询日志分析技巧_MySQL慢查询优化策略全方位讲解MySQL慢查询日志分析技巧_MySQL慢查询优化策略全方位讲解

    要正确配置mysql慢查询日志以捕获关键性能数据,1. 开启slow_query_log = on;2. 设置slow_query_log_file指定日志路径;3. 根据业务设定合适的long_query_time(如生产环境设为1秒);4. 启用log_queries_not_using_ind…

    2026年9月22日 用户投稿
    500
  • 使用 Spring Boot Test @Sql 注解通过掩码描述文件的方法

    在 Spring Boot 测试中,我们经常使用 @Sql 注解来执行 SQL 脚本,以便在测试前准备数据或在测试后清理数据。 通常的用法如下: @Sql(scripts = “/folder/my_favourite_script.sql”)@Testpublic void myTest() { …

    2026年9月22日
    100
  • 如何查看Linux文件系统类型 df -T与lsblk -f命令对比

    如何查看Linux文件系统类型 df -T与lsblk -f命令对比如何查看Linux文件系统类型 df -T与lsblk -f命令对比如何查看Linux文件系统类型 df -T与lsblk -f命令对比如何查看Linux文件系统类型 df -T与lsblk -f命令对比

    在linux中查看文件系统类型时,df -t 适合查看已挂载分区的文件系统,而 lsblk -f 可查看所有块设备信息。1. df -t 显示已挂载的文件系统类型、磁盘使用情况及挂载点,适用于快速了解当前挂载目录所用文件系统;2. lsblk -f 列出包括未挂载设备的详细信息,如 uuid、lab…

    2026年9月22日 用户投稿
    300
  • 用AI打造沉浸式蝴蝶号无人直播间操作实录

    用AI打造沉浸式蝴蝶号无人直播间操作实录用AI打造沉浸式蝴蝶号无人直播间操作实录用AI打造沉浸式蝴蝶号无人直播间操作实录用AI打造沉浸式蝴蝶号无人直播间操作实录

    用ai做蝴蝶号无人直播间确实可以“无人”,但关键在于流程跑通与细节做好。具体步骤包括:一、准备阶段要配齐账号、素材和工具,明确账号定位,建立丰富素材库,选对ai工具并从垂直领域测试;二、设计脚本时需预设规则匹配,整理常见问题与回答表格导入系统;三、实操上设置定时推流、语音讲解、弹幕监控和自动下播等流…

    2026年9月22日 用户投稿
    1200
  • PowerBI的AI混合工具怎么用?快速创建数据报表的详细操作方法

    PowerBI的AI混合工具通过Q&A、关键影响因素、异常检测和智能叙事等功能,降低数据分析门槛,加速从数据到决策的全过程。它让非技术人员用自然语言提问获取图表,自动识别数据异常与驱动因素,并生成文字解读,大幅提升分析效率。但需以高质量数据和合理建模为基础,结合业务逻辑验证结果,避免“垃圾进…

    2026年9月22日
    600
  • VSCode安装Go语言插件(图文详解,新手避坑指南)

    首先安装Go SDK并配置环境变量,再安装VSCode及Go插件,关键步骤是通过Go: Install/Update Tools命令安装gopls、dlv等核心工具链,确保代码补全、调试等功能正常;若遇问题,需检查Go版本、GOPROXY代理、权限及网络,结合输出面板错误信息定位解决。 配置VSCo…

    2026年9月22日
    400
  • Sublime用于MySQL分库分表设计逻辑_适合大型系统水平扩展需求

    Sublime用于MySQL分库分表设计逻辑_适合大型系统水平扩展需求Sublime用于MySQL分库分表设计逻辑_适合大型系统水平扩展需求Sublime用于MySQL分库分表设计逻辑_适合大型系统水平扩展需求Sublime用于MySQL分库分表设计逻辑_适合大型系统水平扩展需求

    分库分表通过拆分数据提升数据库性能与扩展性,常见策略包括垂直分表、水平分表和分库;sublime 可辅助设计逻辑。1. 垂直分表按字段拆分,降低单表复杂度;2. 水平分表按行拆分,提升查询效率;3. 分库减少单节点压力,增强系统吞吐能力。使用 sublime 可高效编写 sql 脚本、注释分片规则、…

    2026年9月22日 用户投稿
    500
  • 密码管理器是如何安全地存储和填充大量复杂密码的,其工作原理是什么?

    密码管理器通过主密码生成加密密钥,在设备端使用AES-256等算法加密数据,结合PBKDF2或Argon2密钥派生函数增强安全性;加密后数据经HTTPS同步至云端,服务商无法访问明文,实现零知识存储;登录时浏览器插件匹配URL与表单,用户确认后在内存中解密并填充凭证,不暴露数据库或明文;支持生成唯一…

    2026年9月22日
    000
  • 笔记—Linux安装OpenCV及VSCode的配置编译

    笔记—Linux安装OpenCV及VSCode的配置编译笔记—Linux安装OpenCV及VSCode的配置编译笔记—Linux安装OpenCV及VSCode的配置编译笔记—Linux安装OpenCV及VSCode的配置编译

    在学习新技能的过程中,我选择了在linux系统上进行操作,这对于从未接触过linux的人来说是一个绝佳的学习机会。这篇文章记录了我在linux上安装opencv的过程。 我选择的Linux发行版是Ubuntu 20.04.3,并将其安装在Virtual Box虚拟机中。Ubuntu的相关资料丰富,选…

    2026年9月22日 用户投稿
    100
  • PHP如何执行存储过程_PHP调用mysql存储过程的详细步骤

    PHP调用MySQL存储过程主要通过PDO实现,需先启用PDO扩展并建立数据库连接。1. 使用new PDO()连接MySQL;2. 调用无参存储过程如CALL get_users(),执行后获取结果集;3. 对带输入参数的存储过程使用bindParam绑定参数;4. 处理OUT参数时通过用户变量(…

    2026年9月22日
    000
  • 3000元以下最具性价比手机出炉:iQOO拿下三大榜首

    3000元以下最具性价比手机出炉:iQOO拿下三大榜首3000元以下最具性价比手机出炉:iQOO拿下三大榜首3000元以下最具性价比手机出炉:iQOO拿下三大榜首3000元以下最具性价比手机出炉:iQOO拿下三大榜首

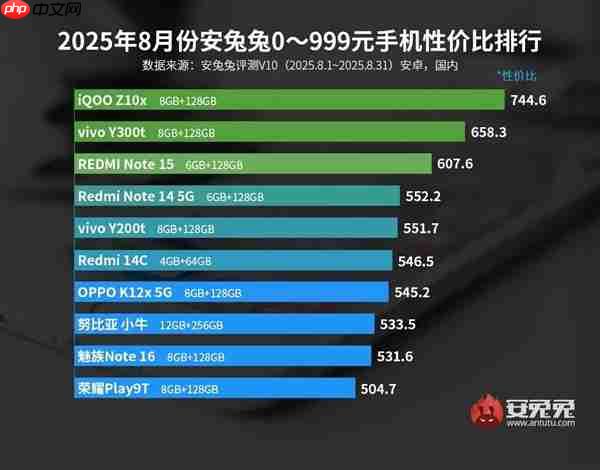
    9月2日消息,今天,安兔兔公布了2025年8月份手机性价比排行榜。 在3000元以下价位段,iQOO表现尤为突出,包揽了三个价位区间的榜首,成为该价位段的最大赢家。 在0-999元价位,iQOO Z10x(8GB+128GB)以744.6的性价比得分位列第一。该价位机型主要面向入门用户,iQOO Z…

    2026年9月22日 用户投稿
    000
  • 使用Sublime管理MySQL数据库结构_高效编辑表结构与字段定义脚本

    使用Sublime管理MySQL数据库结构_高效编辑表结构与字段定义脚本使用Sublime管理MySQL数据库结构_高效编辑表结构与字段定义脚本使用Sublime管理MySQL数据库结构_高效编辑表结构与字段定义脚本使用Sublime管理MySQL数据库结构_高效编辑表结构与字段定义脚本

    用 sublime text 管理 mysql 数据库结构脚本高效且灵活。1. 适合习惯文本编辑、需自定义流程的开发者;2. 启动快、资源占用低,支持多光标、正则替换,插件丰富,易配合 git;3. 建议每张表单独文件、按模块分目录、主脚本汇总建表语句,索引外键单独文件;4. 推荐插件有 sqlto…

    2026年9月22日 用户投稿
    000
  • windows怎么打开资源监视器_Windows资源监视器使用方法

    可通过任务管理器、运行命令、开始菜单搜索、命令提示符或创建桌面快捷方式五种方法打开资源监视器,实时监控CPU、内存、磁盘和网络使用情况,帮助排查Windows系统性能问题。 如果您在使用Windows系统时遇到性能问题,例如程序运行缓慢或CPU占用过高,可能需要查看系统资源的实时使用情况。资源监视器…

    2026年9月22日
    000
  • 群友不讲武德,编写命令来获取蘑菇积分?

    群友不讲武德,编写命令来获取蘑菇积分?群友不讲武德,编写命令来获取蘑菇积分?群友不讲武德,编写命令来获取蘑菇积分?群友不讲武德,编写命令来获取蘑菇积分?

    大家好,我是陌溪 最近蘑菇不是上线了签到功能嘛,用户每天可以登录蘑菇,然后打卡进行签到。 蘑菇签到 同时,为了考虑到小伙伴们可能会忘记签到,还特意做了补签功能 发放补签卡 每周一只要在蘑菇排行榜的小伙伴,就会发放 1~2 张签到卡 蘑菇排行榜 目前蘑菇排行榜主要是通过积分来进行排序的,为了鼓励大家多…

    2026年9月22日 用户投稿
    300
  • mac怎么清理DNS缓存_mac刷新DNS缓存命令

    刷新DNS缓存可解决网站加载缓慢或显示错误问题。在macOS Sonoma系统中,可通过终端执行“sudo dscacheutil -flushcache; sudo killall -HUP mDNSResponder”命令清理缓存,输入管理员密码后生效;或使用第三方工具如OnyX一键清理,适用于…

    2026年9月22日
    100
  • 机械革命Z系列电脑开机要按F1因BIOS中硬盘参数异常重新设置参数解决

    开机需按F1通常因BIOS设置异常,如硬盘参数错误、软驱启用或CMOS电池没电。进入BIOS检查SATA设备列表,将未连接的设备设为“None”,并关闭软驱选项;若设置混乱,可恢复默认配置(Load Optimized Defaults)并保存退出;若问题仍存,建议更换CMOS电池或检查硬件连接。 …

    2026年9月22日
    200

发表回复

登录后才能评论
关注微信