Java中String对象内存优化:避免不必要的转换与高效处理大文件

Java中String对象内存优化:避免不必要的转换与高效处理大文件

本文探讨了java中`string`对象因不当字符计数和处理大文件而导致的内存消耗问题。我们将分析`new string(text.getbytes())`的低效之处及其潜在风险,并强调将整个文件加载到内存是内存压力的根本原因。文章将提供优化建议,包括使用`string.length()`以及采用流式处理大文件以避免内存溢出。

1. 避免不必要的String转换:new String(text.getBytes())的陷阱

在Java中,对字符串进行字符计数时,开发者有时会误用new String(text.getBytes()).length()这样的构造。表面上看,这似乎能达到目的,但实际上,这种做法不仅效率低下,还可能引入潜在的问题。

1.1 性能与内存开销

当执行new String(text.getBytes())时,Java虚拟机内部会进行以下操作:

text.getBytes(): 将原始String对象text根据平台默认编码转换为字节数组。这会创建一个新的字节数组对象。new String(byte[]): 再将这个字节数组根据平台默认编码解码回一个新的String对象。这会创建另一个新的String对象。

这意味着,为了简单地获取字符串长度,我们却创建了至少两个额外的临时对象(一个字节数组和一个String),这无疑增加了内存消耗和CPU处理时间。对于频繁执行或处理大量数据的场景,这种开销将迅速累积,导致堆内存占用过高。

1.2 编码问题与数据完整性

text.getBytes()和new String(byte[])都默认使用平台的默认字符编码。如果原始String中的某些字符无法通过平台默认编码表示,那么在getBytes()过程中这些字符可能会被替换为问号(?)或其他替代字符。随后,new String(byte[])会基于这些被修改的字节重新构建字符串。

立即学习“Java免费学习笔记(深入)”;

这可能导致两个主要问题:

字符丢失/损坏: 原始字符信息丢失,导致字符串内容不准确。长度变化: 特别是对于一些非基本多语言平面(BMP)的字符,一个字符可能被替换为多个问号,或者被替换的字符在字节表示上长度不同,从而导致最终new String(…).length()的结果与原始text.length()不一致。

1.3 正确的字符计数方法

如果仅仅是为了获取String对象的字符数量,最直接、高效且准确的方法是使用String.length()。

示例代码:

String text = "你好, world! ?"; // 包含非BMP字符// 错误且低效的方法 (不推荐)// int countBad = new String(text.getBytes()).length(); // 正确且高效的方法int countGood = text.length();System.out.println("原始字符串: " + text);System.out.println("原始字符串长度 (text.length()): " + countGood);// 演示编码问题 (如果平台默认编码不支持UTF-8,例如GBK)try {    // 假设平台默认编码是GBK,而原始字符串是UTF-8编码的    // 这里为了演示,我们强制使用一个可能不支持所有字符的编码    String problematicString = new String(text.getBytes("GBK"), "GBK");    System.out.println("经过GBK编码再解码的字符串: " + problematicString);    System.out.println("经过GBK编码再解码的字符串长度: " + problematicString.length());} catch (java.io.UnsupportedEncodingException e) {    System.err.println("编码错误: " + e.getMessage());}

从上述示例可以看出,text.length()能够直接提供准确的字符长度,避免了不必要的内存开销和潜在的编码陷阱。

2. 内存压力的根源:大文件一次性加载

尽管new String(text.getBytes())会增加内存消耗,但如果text本身是一个包含整个文件内容的大字符串,那么真正的内存压力源头在于将整个文件一次性加载到内存中。

当一个大文件(例如几百MB甚至数GB)被完全读取并存储在一个String对象中时,这个String对象本身就会占用巨大的堆内存。即使后续不对其进行任何额外的new String(…)操作,仅仅是持有这个大字符串,就足以导致内存溢出(OutOfMemoryError)。

文心大模型 文心大模型

百度飞桨-文心大模型 ERNIE 3.0 文本理解与创作

文心大模型 56 查看详情 文心大模型

注意事项:

Java的String对象是不可变的,这意味着一旦创建,其内容就不能改变。每次对String进行修改(例如拼接),实际上都会创建一个新的String对象。将整个文件内容读入String通常是通过Files.readString() (Java 11+) 或 new String(Files.readAllBytes()) 实现的。这些方法虽然方便,但对大文件是内存的巨大杀手。

3. 高效处理大文件:流式处理与字符计数

解决大文件内存压力的根本方法是避免一次性将整个文件加载到内存。相反,应该采用流式处理(Stream Processing)的方式,分块读取和处理文件内容。

3.1 什么是流式处理?

流式处理是指程序以小块数据(例如一行、一个字符或一个固定大小的缓冲区)的形式读取输入或写入输出,而不是一次性处理所有数据。这种方式显著减少了内存占用,因为在任何给定时间点,内存中只保留了文件的一小部分。

3.2 大文件字符计数的流式实现

对于大文件的字符计数,我们可以使用FileReader配合BufferedReader或直接使用InputStreamReader来逐行或逐字符读取,并累加字符数。

示例代码:

import java.io.BufferedReader;import java.io.FileReader;import java.io.IOException;import java.nio.charset.StandardCharsets;import java.nio.file.Files;import java.nio.file.Path;import java.nio.file.Paths;public class LargeFileCharacterCounter {    public static void main(String[] args) {        Path filePath = Paths.get("path/to/your/large_file.txt"); // 替换为你的大文件路径        // 模拟创建一个大文件 (实际应用中替换为真实文件)        createDummyLargeFile(filePath, 100000); // 创建一个包含10万行的文件        long startTime = System.currentTimeMillis();        long charCount = 0;        try (BufferedReader reader = Files.newBufferedReader(filePath, StandardCharsets.UTF_8)) {            String line;            while ((line = reader.readLine()) != null) {                charCount += line.length();                // 如果需要计算换行符,可以在这里额外加上1 (取决于需求)                // charCount += line.length() + 1; // +1 for the newline character            }        } catch (IOException e) {            System.err.println("读取文件时发生错误: " + e.getMessage());        }        long endTime = System.currentTimeMillis();        System.out.println("文件字符总数 (流式处理): " + charCount);        System.out.println("耗时: " + (endTime - startTime) + " ms");        // 尝试一次性加载整个文件 (不推荐用于大文件,可能导致OOM)        // try {        //     String fileContent = Files.readString(filePath, StandardCharsets.UTF_8);        //     System.out.println("文件字符总数 (一次性加载): " + fileContent.length());        // } catch (IOException e) {        //     System.err.println("一次性加载文件失败: " + e.getMessage());        // } catch (OutOfMemoryError e) {        //     System.err.println("内存溢出: 无法一次性加载大文件到String中。");        // }    }    // 辅助方法:创建一个模拟的大文件    private static void createDummyLargeFile(Path path, int lineCount) {        try (java.io.BufferedWriter writer = Files.newBufferedWriter(path, StandardCharsets.UTF_8)) {            for (int i = 0; i < lineCount; i++) {                writer.write("This is a sample line number " + i + " with some Unicode characters like ?.");                writer.newLine();            }        } catch (IOException e) {            System.err.println("创建模拟文件失败: " + e.getMessage());        }    }}

在上述代码中:

我们使用了Files.newBufferedReader(filePath, StandardCharsets.UTF_8)来创建一个BufferedReader,它能够高效地逐行读取文件。StandardCharsets.UTF_8明确指定了字符编码,避免了平台默认编码可能带来的问题。reader.readLine()每次只读取一行内容,将其存储在一个临时的String对象中,处理完毕后即可被垃圾回收,大大降低了内存峰值。line.length()直接获取每行的字符数并累加。

这种流式处理方式在大文件处理场景中是标准且推荐的做法。

总结

优化Java中String对象的内存使用,尤其是在处理大文件时,关键在于以下几点:

避免不必要的String转换: 诸如new String(text.getBytes())这样的操作会创建额外的临时对象并可能引入编码问题。直接使用String.length()获取字符串长度是最高效和准确的方式。认识内存压力的根本原因: 将整个大文件内容一次性加载到String对象中是导致内存溢出的主要原因。采用流式处理大文件: 使用BufferedReader、InputStreamReader等流API逐块或逐行读取和处理文件,可以显著降低内存占用,提高程序的健壮性。明确指定字符编码: 在进行字节与字符转换时,始终明确指定字符编码(如StandardCharsets.UTF_8),以避免平台默认编码带来的兼容性和数据损坏问题。

通过遵循这些最佳实践,开发者可以有效管理Java应用程序中的String内存使用,尤其是在处理大规模文本数据时,确保程序的稳定性和高效性。

以上就是Java中String对象内存优化:避免不必要的转换与高效处理大文件的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/290645.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫

opporeno5pro手势拍照怎么设置_opporeno5pro设置手势拍照方法
上一篇 2025年11月4日 20:32:07
如何使用Hyperf框架进行消息推送
下一篇 2025年11月4日 20:32:15

相关推荐

  • AI PC 新晋狠角色:5000 元价位 Arrow Lake 最优解 惠普战 66 2025 争当全能卷王

    AI PC 新晋狠角色:5000 元价位 Arrow Lake 最优解 惠普战 66 2025 争当全能卷王AI PC 新晋狠角色:5000 元价位 Arrow Lake 最优解 惠普战 66 2025 争当全能卷王AI PC 新晋狠角色:5000 元价位 Arrow Lake 最优解 惠普战 66 2025 争当全能卷王AI PC 新晋狠角色:5000 元价位 Arrow Lake 最优解 惠普战 66 2025 争当全能卷王

    在 5000 元级别的主流商务本市场,长久以来似乎都遵循着一套 ” 潜规则 “:追求性能就得牺牲便携,看重耐用又往往在外观和屏幕上妥协,想要全面的接口以及优质的售后服务,预算就得一加再加。但现在,一个 ” 新晋狠角色 ” 决意打破这一局面。 惠普商用产…

    2026年9月24日 用户投稿
    000
  • 智能平权下,燃油车如何升级?

    智能平权下,燃油车如何升级?智能平权下,燃油车如何升级?智能平权下,燃油车如何升级?智能平权下,燃油车如何升级?

    曾几何时,“智能驾驶是电动车的专属”成为汽车行业的共识。宝马、奔驰、奥迪等传统豪华品牌长期专注于机械精密性和驾驶质感,在智能化布局上尤为谨慎,一度被贴上保守与落后的标签。 与此同时,新能源品牌凭借智能化迅速打开市场缺口,成功构建起“电动即智能、燃油即传统”的认知框架,在舆论和市场销量中占据先机。 ☞…

    2026年9月24日 用户投稿
    000
  • mac怎么使用听写功能_mac听写输入开启方法

    首先启用高级听写功能,进入系统设置→键盘→听写,勾选“使用高级听写”并下载语言包;随后可设置快捷键(如双击Fn键)快速启动语音输入;在支持的应用中也可通过菜单栏“编辑→开始听写”直接调用;最后根据需要配置听写语言、自动纠正及连续听写选项以提升识别准确率。 如果您希望在Mac上通过语音输入文字以提高效…

    2026年9月24日
    200
  • Intel OpenCAS缓存加速方案

    open cas 架构概览:数据从hdd盘读取后被复制到open cas的缓存中,后续的读取操作从内存中进行,从而提高读写效率。在write-through模式下,所有数据同步刷新到open cas的ssd和后端的hdd中。在write-back模式下,数据同步写入到open cas的ssd中,然后…

    2026年9月24日
    400
  • 使用MySQL命令行客户端进行交互式管理

    使用MySQL命令行客户端进行交互式管理使用MySQL命令行客户端进行交互式管理使用MySQL命令行客户端进行交互式管理使用MySQL命令行客户端进行交互式管理

    mysql命令行客户端的常用命令包括:1. 使用mysql -u 用户名 -p命令连接数据库;2. 执行show databases;查看所有数据库;3. 使用use 数据库名;选择数据库;4. 使用select * from 表名;查询数据;5. 使用insert into 表名 (列1, 列2)…

    2026年9月24日 用户投稿
    500
  • 赋能AI未来!康盈半导体 AI 应用存储新品登陆 elexcon 2025 展会

    赋能AI未来!康盈半导体 AI 应用存储新品登陆 elexcon 2025 展会赋能AI未来!康盈半导体 AI 应用存储新品登陆 elexcon 2025 展会赋能AI未来!康盈半导体 AI 应用存储新品登陆 elexcon 2025 展会赋能AI未来!康盈半导体 AI 应用存储新品登陆 elexcon 2025 展会

    8 月 26 日,中国电子、嵌入式及半导体先进封测行业的风向标 ——elexcon2025 深圳国际电子展暨嵌入式展盛大开幕。作为本届展会的重磅环节之一,国产存储领军品牌康盈半导体携新而来,以 “小而不凡,速启 ai 未来” 为核心主题,正式发布 2025 年存储新品,同步拉开面向 ai 终端应用的…

    2026年9月24日 用户投稿
    000
  • Java中固定长度用户ID输入验证:解决int类型长度检查问题

    本文详细介绍了在Java程序中如何实现用户输入固定长度ID的验证机制。针对常见的int cannot be dereferenced错误,我们将探讨将ID作为字符串读取并进行长度及格式校验的最佳实践,并提供处理字母数字型和纯数字型ID的示例代码,确保数据输入的准确性和程序的健壮性。 引言:用户输入验…

    2026年9月24日
    500
  • 数据实时迁移同步工具 CloudCanal v5.2.0.0 发布,支持 SaaS 全托管

    cloudcanal 免费社区版 是 clougence 公司推出的一款全自研、可视化、自动化数据迁移同步工具,具备 结构迁移、数据迁移、数据同步、数据校验、数据订正 等功能,支持 60+ 款流行关系型数据库、实时数仓、消息中间件、缓存数据库和搜索引擎之间数据互通,其中包含国产数据库 oceanba…

    2026年9月24日
    000
  • VSCode如何实现AI代码反混淆 VSCode智能分析混淆代码的技巧

    vscode没有一键ai反混淆功能,但可通过智能扩展、调试器、ast查看器、代码格式化工具及外部ai工具集成来辅助分析和逐步还原混淆代码;2. 利用eslint、prettier等扩展提升代码可读性,通过“重命名符号”“转到定义”“查找引用”等功能追踪变量和函数流向,结合多光标编辑和代码片段进行手动…

    2026年9月24日
    100
  • Laravel 表单验证失败后保留输入值:最佳实践教程

    本文旨在帮助 Laravel 开发者解决表单验证失败后,如何保留用户已输入数据的问题。我们将深入探讨 withInput() 方法的使用,并提供清晰的代码示例,确保即使在验证失败的情况下,用户体验也能保持流畅。通过本文的学习,你将掌握在 Laravel 中优雅地处理表单验证,并提升应用的可用性。 在…

    2026年9月24日
    000
  • 怎么在mysql中创建数据库表 mysql建表完整流程解析

    在 mysql 中创建数据库表的步骤包括:1) 选择合适的数据类型,如 int、varchar、timestamp;2) 设置索引,如主键和唯一索引;3) 应用约束条件,如 not null 和 unique;4) 设计表结构以满足业务需求,如使用 foreign key 和 enum;5) 优化性…

    2026年9月24日
    000
  • 生成Java中全范围正Double随机数的正确方法

    本文旨在指导开发者如何在Java中生成覆盖整个正Double范围的随机数,并解释了使用ThreadLocalRandom.nextDouble(Double.MIN_VALUE, Double.MAX_VALUE)可能产生偏差的原因。我们将提供一种基于位操作的替代方案,确保生成的随机数在Double…

    2026年9月24日
    100
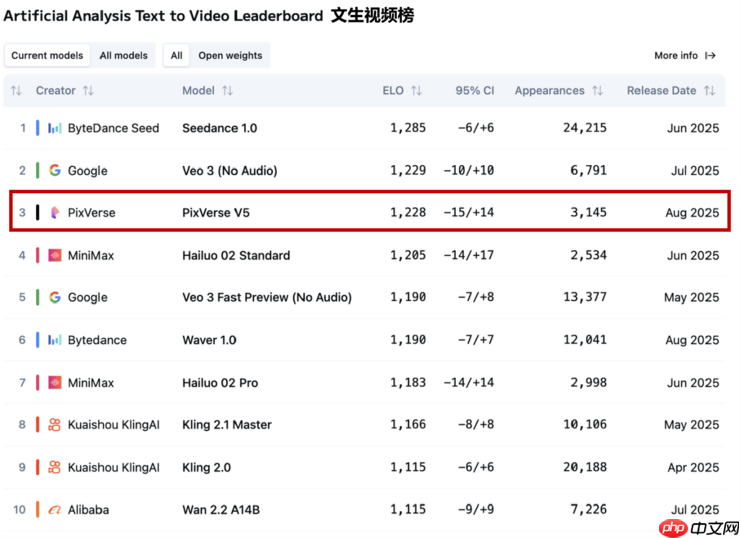
  • PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验

    PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验

    8月27日晚,根据权威独立测评平台 artificial analysis 最新测试结果,爱诗科技发布的pixverse v5 新一代自研视频生成大模型,在图生视频(image to video)项目中排名全球 top2,在文生视频(text to video)项目中位列 top3,保持在全球第一梯…

    2026年9月24日 用户投稿
    100
  • hive安装配置实验

    一、安装前的准备工作 1. 配置并安装hadoop,请参考链接http://blog.csdn.net/wzy0623/article/details/50681554。 2. 下载以下安装包:mysql-5.7.10-linux-glibc2.5-x86_64.tar.gz、apache-hive…

    2026年9月24日
    600
  • 动态表单输入中多答案数据处理教程

    本教程旨在解决Web开发中,如何高效处理包含动态数量答案的表单提交数据,特别是当需要更新现有问题及其关联答案时。文章将详细阐述前端表单的命名策略以及后端PHP如何解析这些动态输入,以准确获取答案内容及其对应的数据库ID,从而实现数据的精准更新,并提供最佳实践建议。 理解动态答案更新的挑战 在构建问答…

    2026年9月24日
    000
  • 大学论文怎么写?让AI工具助你一臂之力

    大学论文怎么写?让AI工具助你一臂之力大学论文怎么写?让AI工具助你一臂之力大学论文怎么写?让AI工具助你一臂之力大学论文怎么写?让AI工具助你一臂之力

    如果要选出大学学习过程中最令人头疼的事,写论文无疑能稳居榜首。从选题开题、内容撰写,到翻译润色、查重降重,每个步骤都耗时耗力,让人焦头烂额。然而,随着 ai 技术的发展,如今写论文这件事,已经可以借助智能工具变得更高效、更轻松。 开题太难?AI 来帮你破局! 论文的第一道难关就是开题。面对浩如烟海的…

    2026年9月24日 用户投稿
    100
  • Java Stream API:从嵌套集合中提取唯一值的两种高效方法

    本文详细介绍了如何利用Java Stream API中的flatMap()和mapMulti()操作,高效地从包含嵌套列表的复杂数据结构(如List中包含List)中提取并收集唯一的元素(如城市名称),替代传统的嵌套循环,提升代码的简洁性和可读性。 在java编程中,我们经常会遇到处理复杂数据结构的…

    2026年9月24日
    100
  • 使用 PHP 解析 JSON 文件并在网页上显示特定数据

    本文旨在帮助开发者学习如何使用 PHP 解析 JSON 文件,并提取其中的特定数据,将其以结构化的方式展示在网页上。我们将通过一个简单的示例,演示如何读取 JSON 数据,解析成 PHP 数组,并最终以 HTML 表格的形式呈现。 PHP 解析 JSON 数据 JSON (JavaScript Ob…

    2026年9月24日
    100
  • OriginOS 6 深度体验:当操作系统回归「体验为王」

    OriginOS 6 深度体验:当操作系统回归「体验为王」OriginOS 6 深度体验:当操作系统回归「体验为王」OriginOS 6 深度体验:当操作系统回归「体验为王」OriginOS 6 深度体验:当操作系统回归「体验为王」

    2020 年,智能手机刚刚进入 5g 普及阶段,手机的硬件与软件都迎来了一次迭代浪潮——新形态的需求对操作系统的设计与交互都提出了诸多新的问题,originos 的首个版本,可以看作 vivo对这些问题的回答。 彼时,我曾有机会与 OriginOS 开发团队沟通,正如 OriginOS 的中文名原 …

    2026年9月24日 用户投稿
    100
  • 如何在PHP的require语句中传递参数并有效管理变量作用域

    本文探讨了在php中使用`require`或`include`语句时如何向被引入文件传递参数。文章详细阐述了通过直接变量作用域共享、利用`$_get`超全局变量(不推荐)以及将引入文件内容封装为函数或类(推荐最佳实践)这三种方法,并提供了相应的代码示例,旨在帮助开发者理解和选择最适合其场景的参数传递…

    2026年9月24日
    000

发表回复

登录后才能评论
关注微信