Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
Kimi Linear 一作张宇:关于模型训练的一些感想_创想鸟

Kimi Linear 一作张宇:关于模型训练的一些感想

月之暗面发布了名为 “kimi linear” 的混合线性注意力架构,据称在短距离、长距离及强化学习(rl)等多种扩展场景中均优于传统全注意力方法。kimi linear 由 3 份 kimi delta attention(kda)和 1 份全局 mla 组成。kda 是对 gated deltanet 的改进,通过细粒度门控来压缩有限状态 rnn 的记忆。

近日,Kimi Linear 核心作者分享了关于他对于该项目的一些感想:

作者:yzhangcs 链接:https://www.zhihu.com/question/1967345030881584585/answer/1967730385816385407

终于忙完了 Kimi Linear 的 Model Card 和 Paper ArXiv 上传,放空了半天。现在稍微分享一下个人感想,顺便做一些澄清。

模型架构

Kimi Linear 一作张宇:关于模型训练的一些感想

模型整体架构设计如图所示,延续了Moonlight的设计思路,别的回答已经有不少优秀的解读了。这次最大的不同在于我们将MoE的稀疏度设置得更激进,从8到32。 而 Kimi Linear 的核心设计原则,第一主要采用Linear Attention,这也是名字的由来,具体来说则是KDA,在GDN的基础上融入了 GLA 的细粒度门控。核心 Recurrent 公式中,关键的 Decay 部分已经标红了。

Kimi Linear 一作张宇:关于模型训练的一些感想

这张图的tikz代码主要修改自delta product,当然也借鉴了RWKV7,如果某些人认为这是抄袭那随便你

其次,这是一个hybrid model,考虑到纯Linear Attention对工业级 LLM 来说风险还是太大,我们最终采用了Hybrid Model的方案,也就是KDA:MLA的层混合比例为3:1。经过Ablation Study,我们发现3:1是兼顾效率和性能的最优比例。

最终成果是,在相同的 5.7T Token 训练量以及相似的 3B 激活参数下,模型效果得到了巨大提升。我们的许多 Benchmark 对比都呈现出「大人打小孩」的态势,说实话有些setting不太 fair,只能说它作为一个小规模模型训出的成果,能够给大家带来一些新的 vibe。

个人体验下来感觉非常棒,在一些野生玩家那里体验也挺好的。(https://www.reddit.com/r/LocalLLaMA/comments/1ojz8pz/kimi_linear_released/)

虽然在 math/code 等一些 benchmark 上由于训练量和参数规模还很不够,比不上其他厂商同参数规模的模型,但模型的 personality非常出色,比较有小K2感。在解码方面,如果考虑到 KDA 的 KV Cache 占用小带来的 Batch Size 补偿,最终加速比能达到 6 倍左右。整体效果完全符合预期。


个人感想

训练过程

这是第一次作为核心成员去 scale 这么大的模型,之前个人 research 玩得最多也就是 7B Dense,训个 100B Token,32 卡跑个几天也就够了。这次则是 scale 到了 48B MoE 的规模,5.7T 的训练量。当然,对真正的大模型来说这还是只小卡拉米,不过对我个人来说算是一次突破。 管理模型训练是一件非常难受的事情。分布式总是会中断,尽管有自动重启,但还是不太放心,因此总是需要人盯。然后本人作息又非常抽象,和 collaborator 们(johnson & momo,名字用代号了)经常是 UTC+8 过湾区时间,湾区过北京时间。

Ablation 也经过了漫长的过程,有不少细节论文中没有提到。比如NoPE 还是 RoPE经过怎样的选择;Forget gate 到底选择是 pure sigmoid 还是 GDN style;output gate 的作用,这些都经过了漫长的探索,我们综合考虑short & long context最终才收敛到了现在的形式。

Scaling Ladder 是 Kimi 内部 scale 模型的一个传统。我们会从一个小的(比如 1B 激活参数)开始做起,逐步在 Benchmark 上要打败 Baseline,与此同时需要监控相应的「内科」。等到每个 scale 的每一关都过了,才会进行到下一阶段。并且由于 Hybrid Linear 是开天辟地头一遭,自然经过了更多的审视。比如长文有很多典型Benchmark,MRCR、RULER、Frames 等等作为拦路虎,当有一个明显差异都要 revert 到上一阶段,无论是查 Bug 还是看推理引擎(对于 MoE 模型,评测时推理引擎的支持是必不可少的,否则速度无法忍受)。这些我都非常理解也很认同,但是当多种因素交织时——到底是推理 Bug 导致掉点,还是「内科」炸了,还是 Linear 本身不行——导致的失败会让人非常沮丧。 最终的5.7T训练过程也是波折不断,比如模型中有两个A_log,bias参数,一开始训的时候是保持的bf16,整个阶段虽然没炸,但一直都在上涨,让人很担心,后来训练中途切到了fp32,发现这两个vector的max value 飞速下降,这才意识到对于这些关键参数保持fp32是非常必要的,但是我们是中途切换,有多大的影响呢?不知道,只能说是对于flagship model的一次derisk了。

好在最后我们交出了一份还算满意的答卷。

关于postrain,之前 Moonlight 级别的 posttrain recipe 还不太成熟,有尝试过直接迁移 K2的方案,发现会遇到一些不太吸收的问题。为此和 fanqing & chengyin,还有 postrain team 的小伙伴进行了长时间的攻坚,期间尝试了几十种不同的数据配方。 我们也观测到许多有意思的现象,特别是对于 Kimi Linear 这种 scale 的小模型而言,榜单成绩和实际使用体验往往是不可兼得的。 如果 Math & Code 分数很高,你往往Vibe起来会非常差(非常 Thinking)。因此,最终我们选择了一个在榜单成绩和实际体验之间平衡得比较好的方案。

Bitter Lesson:这篇 Tech Report 最初的目标是达到类似size模型的SOTA。但事后来看资源限制短时间内没法达成这个目标。 因此最后我们的主战场放到了 1T fair comparisons 上,这些实验本身是 Scaling Ladder 的一部分,也都满足公平比较。后面还是希望释放更多的 Fair Baseline,有一些更丰富的比较。因此这个 Report 的定位是一个技术验证,也是下一代K3的前奏。


其他

这两天看到了非常多关于 model 和 arch 的评价,最大的部分是关于和 RWKV7 的比较,区别是什么 @sonta在另一个回答已经说了,如果你们还是觉得一样那随便你好了。

Kimi 的目标是下一代 flagship models,正如 Moonlight 中致敬了 Muon 的作者,Kimi Linear 也会引用能够aware 的 previous work,不存在刻意忽略的动机,以及我想说,与其整天拉踩别人,还是好好想想怎么 scale 自己的东西吧,整天对线又有啥用呢?

我想说我觉得个人在一个比较恰当的时机加入了 Kimi,恰好在 deepseek R1 开源的时候,促使各家厂商都纷纷转向了开源(因此今年仍然有机会继续维护 FLA,顺手实现了 NSA :)),刚好今年算是 agent 大年,对于动辄 32k + 的推理长度,Linear Attention 刚好可以发挥所长。并且个人作为 FLA 的 core contributors 之一,将之发扬光大给了我最大的驱动力。去年一整年都捐给了 FLA,增加了 scaling 的各种支持,各种配套的 fused kernels,Cache 管理,varlen training,FLA 各种状态都 ready 了,顺风顺水来到了一个关键的时间节点被 scaling。并且我也觉得时间窗口会比较短暂,大家本身就是对 hybrid model 将信将疑,如果 FLA team @sonta @zhiyuan1i 都没法去 scaling 或者 scaling 失败了,那这条技术路线就会受到很大的质疑。好在目前看起来的结果还行。

当前,Linear Attention 的迭代路线正逐渐收敛到 Delta-variants。近期也有很多其他工作浮现,如TTT/Titans,但这些方法在硬件效率方面似乎仍有待提升。与此同时,Sparse Attention 也成为了另一条备受关注的技术路线,尤其是 NSA的设计理念,我个人非常欣赏。然而,究竟哪条技术路线更具优势,目前仍是一个未知数。总的而言,Efficient Attention无疑是当前研究领域的一大聚焦点。希望 Kimi 此次开源的 KDA能够为业界带来更多启发,推动Hybrid models的真正落地!

以上就是Kimi Linear 一作张宇:关于模型训练的一些感想的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/303650.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
怎样使用ThinkPHP6进行多站点管理?
上一篇 2025年11月5日 02:08:35
永劫无间手游左右键振刀怎么取消 左右键振刀取消方法
下一篇 2025年11月5日 02:08:40

相关推荐

  • Meta 将投入数十亿美元研发人形机器人,要做“机器人界的安卓”

    Meta 将投入数十亿美元研发人形机器人,要做“机器人界的安卓”Meta 将投入数十亿美元研发人形机器人,要做“机器人界的安卓”Meta 将投入数十亿美元研发人形机器人,要做“机器人界的安卓”Meta 将投入数十亿美元研发人形机器人,要做“机器人界的安卓”

    Meta公司首席技术官安德鲁·博斯沃思近日透露,公司已将人形机器人研发列为与增强现实(AR)并列的核心战略方向,未来几年将投入数十亿美元资金支持该项目。今年年初,Meta正式组建了专注于人形机器人的研究团队,标志着其全面进军这一前沿科技领域。 博斯沃思强调,当前制约人形机器人发展的主要障碍并非硬件,…

    2026年9月26日 • 用户投稿
    100
  • 《忍者龙剑传4》现已偷跑 玩家称战斗系统非常惊艳!

    《忍者龙剑传4》现已偷跑 玩家称战斗系统非常惊艳!《忍者龙剑传4》现已偷跑 玩家称战斗系统非常惊艳!《忍者龙剑传4》现已偷跑 玩家称战斗系统非常惊艳!《忍者龙剑传4》现已偷跑 玩家称战斗系统非常惊艳!

    《忍者龙剑传4》将于10月21日正式发售,登陆ps5、xsx|s以及pc平台,并将在首发当日加入xgp游戏库。本作支持难度自定义,无论你是系列老将还是初次接触的新手,都有机会通过挑战赢得“超忍”称号。剧情方面,隼龙与八云之间的对立成为核心冲突——八云试图解除暗黑神龙的封印,而这直接违背了神龙教阻止恶…

    2026年9月26日 • 用户投稿
    100
  • VSCode如何实现脑机接口编程 VSCode神经信号分析工具集成

    vscode本身没有内置脑机接口功能,而是通过其扩展性支持bci编程。1. 安装python扩展并配置虚拟环境以管理依赖;2. 使用brainflow采集数据、mne-python处理eeg/meg信号,并通过jupyter notebook在vscode中进行交互式分析;3. 利用vscode调试…

    2026年9月26日
    100
  • 计算循环迭代次数并与其他类中的迭代次数进行比较的教程

    计算循环迭代次数并与其他类中的迭代次数进行比较的教程计算循环迭代次数并与其他类中的迭代次数进行比较的教程计算循环迭代次数并与其他类中的迭代次数进行比较的教程计算循环迭代次数并与其他类中的迭代次数进行比较的教程

    本文旨在解决在Java程序中统计循环迭代次数,并将其与其他方法或类中的迭代次数进行比较的问题。通过示例代码,我们将展示如何创建一个结果对象来同时返回计算结果和迭代次数,避免使用全局计数器变量,确保每次调用都能获得准确的迭代次数统计。 在程序开发中,经常需要统计循环的迭代次数,尤其是在比较不同算法的效…

    2026年9月26日 • 用户投稿
    100
  • 查询本机IP地址指南—实用教程解析本地网络IP方法

    查询本机IP地址指南—实用教程解析本地网络IP方法查询本机IP地址指南—实用教程解析本地网络IP方法查询本机IP地址指南—实用教程解析本地网络IP方法查询本机IP地址指南—实用教程解析本地网络IP方法

    先查内网IP可使用命令提示符输入ipconfig,或通过系统设置查看网络属性;查公网IP则在浏览器搜索“我的IP”或访问ip.cn等网站即可。 想知道自己的电脑IP地址在哪看?其实方法很简单,主要分清你要查的是内网IP还是公网IP。内网IP是你在家庭或公司局域网里的身份标识,而公网IP是你的网络在互…

    2026年9月26日 • 用户投稿
    400
  • debian邮件服务器故障怎么办

    debian邮件服务器故障怎么办debian邮件服务器故障怎么办debian邮件服务器故障怎么办debian邮件服务器故障怎么办

    您的Debian邮件服务器遇到问题?别担心,本文提供逐步指南帮助您诊断并解决常见故障。 第一步:检查服务状态 首先,确认Postfix和Dovecot邮件服务是否正常运行: sudo systemctl status postfixsudo systemctl status dovecot 若服务停…

    2026年9月26日 • 用户投稿
    200
  • 抖音直播间管理员都有什么权限?抖音直播间管理员有哪些权限

    抖音直播间管理员都有什么权限?抖音直播间管理员有哪些权限抖音直播间管理员都有什么权限?抖音直播间管理员有哪些权限抖音直播间管理员都有什么权限?抖音直播间管理员有哪些权限抖音直播间管理员都有什么权限?抖音直播间管理员有哪些权限

    随着抖音直播的火爆,越来越多的人开始关注抖音直播间管理员这个职业。抖音直播间管理员究竟有什么权限呢?下面,我们就来一起揭秘一下。 一、抖音直播间管理员的职责 我们要明确抖音直播间管理员的职责。一般来说,抖音直播间管理员的主要职责包括以下几个方面: 1. 维护直播间秩序:确保直播间内的氛围良好,禁止出…

    2026年9月26日 • 用户投稿
    300
  • 想将 AI 模型推广宣传工具与豆包联用进行推广?操作方法​

    想将 AI 模型推广宣传工具与豆包联用进行推广?操作方法​想将 AI 模型推广宣传工具与豆包联用进行推广?操作方法​想将 AI 模型推广宣传工具与豆包联用进行推广?操作方法​想将 AI 模型推广宣传工具与豆包联用进行推广?操作方法​

    推广 ai 模型可与豆包联用,提升曝光和转化。1. 利用豆包的内容创作功能生成多样化宣传文案,节省时间并适配多平台;2. 在豆包社区嵌入模型链接或试用入口,以实用内容引导用户体验;3. 结合豆包互动功能设计引导式对话,自然推荐模型使用;4. 多平台联动,将豆包作为流量中转站进行跨平台导流。 ☞☞☞A…

    2026年9月26日 • 用户投稿
    200
  • Android Plurals 正确使用指南

    Android Plurals 正确使用指南Android Plurals 正确使用指南Android Plurals 正确使用指南Android Plurals 正确使用指南

    本文旨在详细讲解 Android 中 Plurals 的正确使用方法,避免常见的错误用法。通过示例代码和注意事项,帮助开发者理解如何利用 Plurals 实现应用的多语言支持,从而提升用户体验。本文将重点介绍如何定义和使用 Plurals 资源,以及在不同语言环境下正确显示单复数形式。 Plural…

    2026年9月26日 • 用户投稿
    100
  • 想让豆包和 AI 穿搭建议工具结合打造时尚造型?操作方法​

    想让豆包和 AI 穿搭建议工具结合打造时尚造型?操作方法​想让豆包和 AI 穿搭建议工具结合打造时尚造型?操作方法​想让豆包和 AI 穿搭建议工具结合打造时尚造型?操作方法​想让豆包和 AI 穿搭建议工具结合打造时尚造型?操作方法​

    豆包可辅助打造ai穿搭建议工具,但需结合其他模型与技术。1.明确目标场景:基础搭配推荐、个性化定制或虚拟试穿,决定所需ai类型;2.利用现有ai模型如style dna做搭配引擎,kolors实现虚拟试衣;3.选择api对接或搭建中台实现系统整合;4.收集用户画像与衣柜信息提升推荐精准度;5.通过豆…

    2026年9月26日 • 用户投稿
    100
  • 免费PPT生成支持多人协作吗_免费工具实现PPT协作的指南

    免费PPT生成支持多人协作吗_免费工具实现PPT协作的指南免费PPT生成支持多人协作吗_免费工具实现PPT协作的指南免费PPT生成支持多人协作吗_免费工具实现PPT协作的指南免费PPT生成支持多人协作吗_免费工具实现PPT协作的指南

    选择支持多人协作的免费PPT工具可高效完成演示文稿制作。一、WPS Office在线版:登录官网后新建演示文稿,通过共享链接设置“可编辑”权限,团队成员即可实时协同编辑,光标与修改痕迹同步显示。二、Microsoft PowerPoint Online:使用Microsoft账户登录Office官网…

    2026年9月25日 • 用户投稿
    300
  • 宏碁掠夺者战斧18评测 机械键盘轴体手感分析

    宏碁掠夺者战斧18评测 机械键盘轴体手感分析宏碁掠夺者战斧18评测 机械键盘轴体手感分析宏碁掠夺者战斧18评测 机械键盘轴体手感分析宏碁掠夺者战斧18评测 机械键盘轴体手感分析

    宏碁掠夺者战斧18的机械键盘手感出色,是笔记本键盘中的惊喜之作。1. 它搭载cherry mx ulp超薄机械轴,提供清晰段落感与触发反馈,按键干脆、响应迅速;2. 键程虽短但手感直接,适合游戏与快速输入,长时间使用不易疲劳;3. 声音清脆带“咔哒”声,适合喜欢听觉反馈的用户,但在安静环境可能稍显明…

    2026年9月25日 • 用户投稿
    200
  • 使用正则表达式判断字符串中字符是否全部唯一

    使用正则表达式判断字符串中字符是否全部唯一使用正则表达式判断字符串中字符是否全部唯一使用正则表达式判断字符串中字符是否全部唯一使用正则表达式判断字符串中字符是否全部唯一

    本文介绍如何使用Java正则表达式来判断一个字符串中的所有字符是否都是唯一的。我们将探讨一种使用正则表达式检测字符串中是否存在重复字符的方法,并提供相应的Java代码示例。通过本文,你将学习如何利用正则表达式的强大功能来解决字符串处理中的常见问题。 在字符串处理中,经常需要判断一个字符串中的字符是否…

    2026年9月25日 • 用户投稿
    100
  • 用豆包AI生成Python数据挖掘代码

    用豆包AI生成Python数据挖掘代码用豆包AI生成Python数据挖掘代码用豆包AI生成Python数据挖掘代码用豆包AI生成Python数据挖掘代码

    想用豆包ai生成python数据挖掘代码的关键在于明确任务目标和数据结构。1. 首先明确数据挖掘任务类型,如分类、聚类或回归,并具体描述需求,例如“根据用户年龄、消费金额和购买频率做客户分群”。2. 接着提供清晰的数据格式与来源,比如说明csv文件中的字段信息,以便ai进行数据预处理和建模。3. 要…

    2026年9月25日 • 用户投稿
    900
  • Debian系统OpenSSL漏洞修复

    Debian系统OpenSSL漏洞修复Debian系统OpenSSL漏洞修复Debian系统OpenSSL漏洞修复Debian系统OpenSSL漏洞修复

    确保Debian系统的OpenSSL安全,请遵循以下步骤: 一、系统更新: 首先,更新您的Debian系统至最新版本。使用以下命令更新软件包列表并升级所有已安装软件: sudo apt updatesudo apt upgrade 二、版本确认: 检查当前OpenSSL版本: openssl ver…

    2026年9月25日 • 用户投稿
    100
  • RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启

    RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启

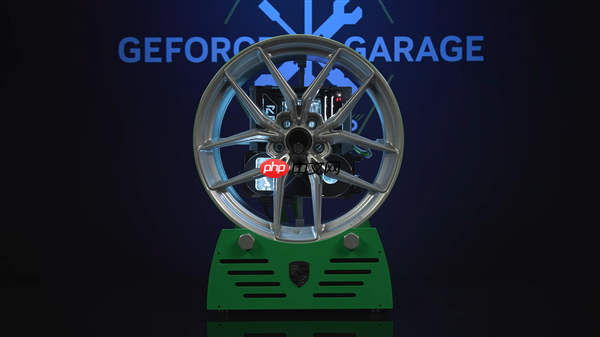
    10月13日,当汽车与高性能计算相遇,会激发出怎样的创意奇迹?nvidia在最新一期geforce garage节目中揭晓了答案。 这一次,他们携手改装界传奇人物JCustom(Justin Chu),将一台完整的RTX 5080游戏主机巧妙植入保时捷911的轮毂之中,实现了汽车工艺与电脑科技的惊艳…

    2026年9月25日 • 用户投稿
    100
  • 亚马逊拟再次向AI创企Anthropic投资数十亿美元

    亚马逊拟再次向AI创企Anthropic投资数十亿美元亚马逊拟再次向AI创企Anthropic投资数十亿美元亚马逊拟再次向AI创企Anthropic投资数十亿美元亚马逊拟再次向AI创企Anthropic投资数十亿美元

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 有消息透露,亚马逊正计划再度向人工智能企业Anthropic注资数十亿美元,旨在深化两家公司的战略合作关系。据悉,此次潜在的投资可能在去年11月承诺的80亿美元基础上进一步加码。 早在2024年…

    2026年9月25日 • 用户投稿
    100
  • Tomcat日志如何帮助排查内存泄漏

    Tomcat日志如何帮助排查内存泄漏Tomcat日志如何帮助排查内存泄漏Tomcat日志如何帮助排查内存泄漏Tomcat日志如何帮助排查内存泄漏

    Tomcat日志是诊断内存泄漏问题的关键。通过分析Tomcat日志,您可以深入了解内存使用情况和垃圾回收(GC)行为,从而有效定位和解决内存泄漏。以下是如何利用Tomcat日志排查内存泄漏: 1. GC日志分析 首先,启用详细的GC日志记录。在Tomcat启动参数中添加以下JVM选项: -XX:+P…

    2026年9月25日 • 用户投稿
    100
  • 尽管投资创纪录,但仅有 12% 的 AI 项目实现全面部署

    尽管投资创纪录,但仅有 12% 的 AI 项目实现全面部署尽管投资创纪录,但仅有 12% 的 AI 项目实现全面部署尽管投资创纪录,但仅有 12% 的 AI 项目实现全面部署尽管投资创纪录,但仅有 12% 的 AI 项目实现全面部署

    根据 Riverbed 最新发布的全球调查报告,企业在人工智能(AI)采用方面展现出强烈承诺,并正在对 IT 运营进行战略性重塑以支撑 AI 发展。尽管整体 AI 投资额几乎翻倍,且高达 87% 的组织表示其 AIOps 项目的投资回报已达到或超出预期,但仅有 12% 的 AI 项目实现了全企业范围…

    2026年9月25日 • 用户投稿
    000
  • Bukkit插件开发:正确处理物品显示名称与玩家识别

    Bukkit插件开发:正确处理物品显示名称与玩家识别Bukkit插件开发:正确处理物品显示名称与玩家识别Bukkit插件开发:正确处理物品显示名称与玩家识别Bukkit插件开发:正确处理物品显示名称与玩家识别

    本文旨在解决Bukkit插件开发中,从BlockPlaceEvent获取物品显示名称并将其用于玩家识别时常见的“乱码”问题。我们将深入探讨Component对象与纯文本字符串的区别,并提供两种核心解决方案:直接获取放置方块的玩家名称,以及如何正确地将Component转换为纯文本字符串,以避免不必要…

    2026年9月25日 • 用户投稿
    300

发表回复

登录后才能评论
关注微信