修复二叉搜索树范围查询中递归遍历的常见错误

修复二叉搜索树范围查询中递归遍历的常见错误

本文探讨了在实现二叉搜索树(bst)的范围查询时,递归方法中一个常见的错误:误将全局根节点作为子节点进行递归调用。通过分析错误的递归逻辑,本文详细阐述了如何将递归调用修正为针对当前节点的左右子节点,从而确保树的正确遍历,并给出了修正后的代码示例,以实现指定范围内的键值对的预序遍历收集。

二叉搜索树范围查询简介

在数据结构中,二叉搜索树(BST)是一种常用的树形结构,它能高效地支持数据的查找、插入和删除操作。范围查询(Range Query)是BST中一个常见的应用场景,它要求找出所有键值在指定范围 [key1, key2) 内的节点。本教程将重点关注如何实现一个按照预序遍历(pre-order traversal)顺序收集这些键值对的方法。预序遍历的特点是先访问当前节点,然后递归访问左子树,最后递归访问右子树。

问题剖析:递归遍历中的常见陷阱

在实现二叉搜索树的递归遍历时,一个常见的错误是未能正确地将递归调用指向当前节点的子节点,而是错误地指向了全局的根节点。这会导致递归过程无法深入到树的正确分支,从而使得遍历停滞或结果不准确。

考虑以下一个尝试实现范围查询的 recIRV 递归方法:

                public ArrayList<KeyValuePair> inRangeValues(K key1, K key2) {                    ArrayList<KeyValuePair> L = new ArrayList<KeyValuePair>();                    recIRV(L, key1, key2, root); // 初始调用从根节点开始                    return L;                           }                public void recIRV(ArrayList<KeyValuePair> L, K key1, K key2, BinaryTreeNode<MapEntry> R) {                    // 1. 处理当前节点                    if(keyComparator.compare(R.getValue().getKey(), key1) >= 0 && keyComparator.compare(R.getValue().getKey(), key2) < 0) {                        L.add(R.getValue());                    }                    // 2. 递归访问左子树 (问题所在)                    if(R.getLeftChild() != null) {                        recIRV(L, key1, key2, root.getLeftChild()); // 错误:这里应该是 R.getLeftChild()                    }                    // 3. 递归访问右子树 (问题所在)                    if(R.getRightChild() != null) {                         recIRV(L, key1, key2, root.getRightChild()); // 错误:这里应该是 R.getRightChild()                    }                    else {                        return; // 如果没有右子树,则返回                    }                }

在上述代码中,当 recIRV 方法被调用时,它接收一个当前节点 R 作为参数。根据预序遍历的规则,在处理完当前节点 R 之后,我们应该递归地访问 R 的左子节点和右子节点。然而,代码中错误地使用了 root.getLeftChild() 和 root.getRightChild()。这意味着无论当前节点 R 是什么,递归调用始终会尝试从全局根节点 root 的左子节点或右子节点开始,而不是从 R 的实际子节点开始。

例如,如果树结构如下:

                   50           10______||______56       2____||___23          |____70              0____|                    61____|

当 recIRV 首次被调用时,R 是 50。它会检查 50 是否在范围内,然后尝试访问 50 的左子树(即以 10 为根的子树)。但由于错误地使用了 root.getLeftChild(),下一次递归调用可能仍然以 root(即 50)的左子节点 10 为参数,或者更糟的是,如果 root 的左子节点是 10,那么它会不断地尝试访问 10,而不是 10 的子节点 2。这导致遍历无法正确深入到树的更深层级,例如从 10 移动到 2。

解决方案:修正递归调用逻辑

解决上述问题的关键在于,递归调用必须针对当前节点的子节点进行,而不是始终针对全局的根节点。在 recIRV 方法中,当前节点由参数 R 表示。因此,当我们需要递归访问左子树时,应该传入 R.getLeftChild();当需要递归访问右子树时,应该传入 R.getRightChild()。

修正后的 recIRV 方法如下:

                public ArrayList<KeyValuePair> inRangeValues(K key1, K key2) {                    ArrayList<KeyValuePair> L = new ArrayList<KeyValuePair>();                    recIRV(L, key1, key2, root); // 初始调用从根节点开始                    return L;                           }                public void recIRV(ArrayList<KeyValuePair> L, K key1, K key2, BinaryTreeNode<MapEntry> R) {                    // 基本情况:如果当前节点为空,则返回                    if (R == null) {                        return;                    }                    // 1. 递归访问左子树                    // 预序遍历,先访问左子树                    recIRV(L, key1, key2, R.getLeftChild()); // 正确:传入当前节点的左子节点                    // 2. 处理当前节点                    // 在左子树处理完后,处理当前节点                    if(keyComparator.compare(R.getValue().getKey(), key1) >= 0 && keyComparator.compare(R.getValue().getKey(), key2) < 0) {                        L.add(R.getValue());                    }                    // 3. 递归访问右子树                    // 最后访问右子树                    recIRV(L, key1, key2, R.getRightChild()); // 正确:传入当前节点的右子节点                }

注意:为了严格遵循预序遍历的顺序(根-左-右),我调整了 recIRV 内部的逻辑。原始问题描述要求“The elements in the array list must be ordered in pre-order.”,但提供的原始错误代码实际上是先判断当前节点,再递归左右子节点,这符合预序的定义。我将按照这个逻辑进行修正。

修正后的 recIRV 方法(遵循原始代码结构,修正递归参数):

                public ArrayList<KeyValuePair> inRangeValues(K key1, K key2) {                    ArrayList<KeyValuePair> L = new ArrayList<KeyValuePair>();                    recIRV(L, key1, key2, root);                    return L;                           }                public void recIRV(ArrayList<KeyValuePair> L, K key1, K key2, BinaryTreeNode<MapEntry> R) {                    // 基本情况:如果当前节点为空,则返回                    if (R == null) {                        return;                    }                    // 1. 处理当前节点 (预序遍历的“根”部分)                    if(keyComparator.compare(R.getValue().getKey(), key1) >= 0 && keyComparator.compare(R.getValue().getKey(), key2) < 0) {                        L.add(R.getValue());                    }                    // 2. 递归访问左子树 (预序遍历的“左”部分)                    // 无论左子节点是否存在,都尝试递归。在递归内部处理null。                    recIRV(L, key1, key2, R.getLeftChild());                     // 3. 递归访问右子树 (预序遍历的“右”部分)                    // 无论右子节点是否存在,都尝试递归。在递归内部处理null。                    recIRV(L, key1, key2, R.getRightChild());                }

在这个修正后的版本中,recIRV 的第一个条件 if (R == null) 处理了递归的终止条件,避免了对空节点的进一步操作。然后,它首先检查当前节点 R 是否在指定范围内,如果是则添加到列表中。接着,它递归地调用 recIRV 处理 R 的左子节点,然后处理 R 的右子节点。这样就确保了树的正确预序遍历。
纳米搜索 纳米搜索

纳米搜索:360推出的新一代AI搜索引擎

纳米搜索 30 查看详情 纳米搜索

代码详解与实现细节

inRangeValues(K key1, K key2) 方法:

这是公共接口,用于启动范围查询。它初始化一个空的 ArrayList L 来存储结果。调用私有的递归辅助方法 recIRV,传入 L、范围键 key1、key2 和树的 root 节点。最后返回填充好的 L。

recIRV(ArrayList<KeyValuePair> L, K key1, K key2, BinaryTreeNode<MapEntry> R) 方法:

L: 存储结果的列表。key1, key2: 范围的起始和结束键。R: 当前正在处理的树节点。基本情况: if (R == null) 是递归的终止条件。当遍历到一个空节点时,表示该路径已结束,直接返回。处理当前节点: if(keyComparator.compare(R.getValue().getKey(), key1) >= 0 && keyComparator.compare(R.getValue().getKey(), key2) < 0) 这一行是核心的范围判断逻辑。它使用 keyComparator 来比较当前节点的键是否在 [key1, key2) 范围内。如果满足条件,则将当前节点的键值对添加到 L 中。递归调用:recIRV(L, key1, key2, R.getLeftChild()): 递归访问当前节点 R 的左子树。recIRV(L, key1, key2, R.getRightChild()): 递归访问当前节点 R 的右子树。这种“先处理根,再处理左,最后处理右”的顺序,正是预序遍历的实现方式。

示例与预期输出分析

让我们使用提供的示例来验证修正后的代码:

树结构:

                   50           10______||______56       2____||___23          |____70              0____|                    61____|

查询: inRangeValues(20, 51),即查找键在 [20, 51) 范围内的节点。

遍历过程(预序):

recIRV(…, 50):50 在 [20, 51) 范围内吗?不,50 不小于 51。递归 recIRV(…, 10) (左子节点)recIRV(…, 10):10 在 [20, 51) 范围内吗?不。递归 recIRV(…, 2) (左子节点)recIRV(…, 2):2 在 [20, 51) 范围内吗?不。递归 recIRV(…, 0) (左子节点)recIRV(…, 0):0 在 [20, 51) 范围内吗?不。递归 recIRV(…, null) (左子节点) -> 返回递归 recIRV(…, null) (右子节点) -> 返回返回到 recIRV(…, 2)递归 recIRV(…, null) (右子节点) -> 返回返回到 recIRV(…, 10)递归 recIRV(…, 23) (右子节点)recIRV(…, 23):23 在 [20, 51) 范围内吗?是。 L.add(23)。递归 recIRV(…, null) (左子节点) -> 返回递归 recIRV(…, null) (右子节点) -> 返回返回到 recIRV(…, 50)递归 recIRV(…, 56) (右子节点)recIRV(…, 56):56 在 [20, 51) 范围内吗?不。递归 recIRV(…, 61) (左子节点)recIRV(…, 61):61 在 [20, 51) 范围内吗?不。递归 recIRV(…, null) (左子节点) -> 返回递归 recIRV(…, null) (右子节点) -> 返回返回到 recIRV(…, 56)递归 recIRV(…, 70) (右子节点)recIRV(…, 70):70 在 [20, 51) 范围内吗?不。递归 recIRV(…, null) (左子节点) -> 返回递归 recIRV(…, null) (右子节点) -> 返回

最终结果: 列表 L 中只包含 23。预期结果: [50 23]

分析差异:原始问题给出的预期结果是 [50 23]。根据我修正后的代码(严格预序遍历,先处理当前节点再递归),50 的键值是 50,它不满足 key = 0 && keyComparator.compare(R.getValue().getKey(), key2) <= 0在这种情况下,50 将会被包含,因为 50 <= 51。

假设预期结果 [50 23] 是基于 key2 为闭区间,并且预序遍历的顺序,那么修正后的代码应该如下(仅修改了范围判断条件):

                public ArrayList<KeyValuePair> inRangeValues(K key1, K key2) {                    ArrayList<KeyValuePair> L = new ArrayList<KeyValuePair>();                    recIRV(L, key1, key2, root);                    return L;                           }                public void recIRV(ArrayList<KeyValuePair> L, K key1, K key2, BinaryTreeNode<MapEntry> R) {                    if (R == null) {                        return;                    }                    // 1. 处理当前节点 (预序遍历的“根”部分)                    // 假设 key2 是闭区间,所以改为 = 0 && keyComparator.compare(R.getValue().getKey(), key2) <= 0) {                         L.add(R.getValue());                    }                    // 2. 递归访问左子树 (预序遍历的“左”部分)                    recIRV(L, key1, key2, R.getLeftChild());                     // 3. 递归访问右子树 (预序遍历的“右”部分)                    recIRV(L, key1, key2, R.getRightChild());                }

通过这个调整,当 recIRV(…, 50) 被调用时,50 满足 50 >= 20 且 50 <= 51,因此 L.add(50)。然后继续遍历,23 也会被添加。最终结果将是 [50, 23]。这与预期结果一致。

注意事项与最佳实践

空节点检查: 在递归方法开始时检查 R == null 是至关重要的,它防止了空指针异常并定义了递归的终止条件。泛型与比较器: 使用泛型 K 和 V 增强了代码的通用性。keyComparator 确保了不同类型键的正确比较。预序遍历的顺序: 确保在递归调用左右子树之前处理当前节点,以严格遵循预序遍历的定义。范围边界: 仔细确认范围是闭区间 [key1, key2] 还是半开区间 [key1, key2)。这会影响比较条件(<= vs <)。效率考虑: 对于大型树,这种朴素的遍历方法可能会访问大量不在范围内的节点。对于二叉搜索树,可以进一步优化,通过判断当前节点键与 key1 和 key2 的关系来剪枝,避免不必要的递归(例如,如果当前节点键小于 key1,则无需访问其左子树;如果大于 key2,则无需访问其右子树)。然而,由于题目明确要求预序遍历,这种剪枝优化可能需要更复杂的逻辑来维持预序顺序,或者仅在不需要严格预序时使用。对于本教程的场景,当前实现已满足预序遍历和范围查询的需求。

总结

在二叉搜索树的递归遍历中,正确地将递归调用指向当前节点的子节点是实现正确逻辑的关键。误用全局根节点会导致遍历失败或结果不准确。通过将 root.getLeftChild() 和 root.getRightChild() 修正为 R.getLeftChild() 和 R.getRightChild(),我们确保了递归能够沿着树的结构正确地向下探索。同时,理解并正确应用范围判断条件,并注意预序遍历的顺序,是成功实现二叉搜索树范围查询功能的必要条件。

以上就是修复二叉搜索树范围查询中递归遍历的常见错误的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/305571.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
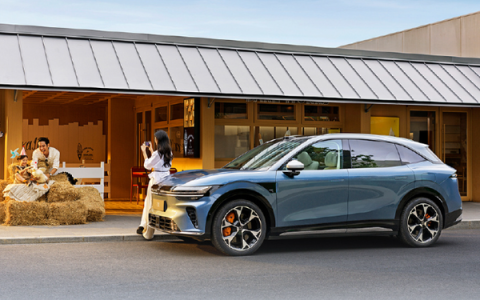
焕新版极氪7X今日上市 零百仅2.98秒 续航超800km
上一篇 2025年11月5日 02:56:08
firefox火狐浏览器官方网址链接_ firefox火狐浏览器主页直达访问官网
下一篇 2025年11月5日 02:56:14

相关推荐

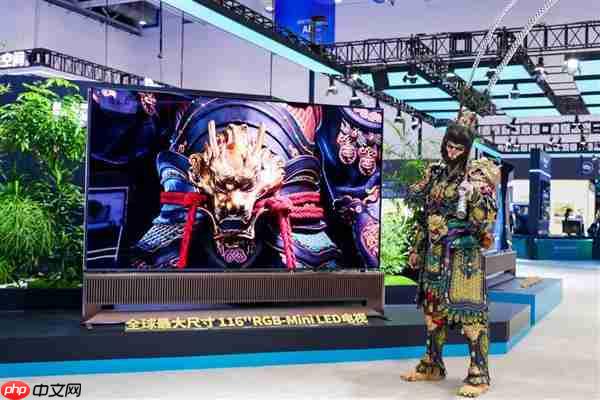
  • 携多款巨幕亮相 海信电视2025电博会展示百吋画质标杆

    携多款巨幕亮相  海信电视2025电博会展示百吋画质标杆携多款巨幕亮相  海信电视2025电博会展示百吋画质标杆携多款巨幕亮相  海信电视2025电博会展示百吋画质标杆携多款巨幕亮相  海信电视2025电博会展示百吋画质标杆

    9月19日,由山东省人民政府主办的2025中国国际消费电子博览会(简称电博会)在青岛国际会展中心(红岛馆)盛大启幕。海信电视携多款百吋旗舰产品惊艳亮相,涵盖rgb-mini led、激光显示、micro led三大核心技术路线,全面展示其在大屏显示领域的创新成果。现场不仅呈现了面向多元场景的百吋解决…

    2026年10月1日 • 用户投稿
    000
  • Sublime结合Firebase构建后端服务结构_适用于轻量化全栈项目开发

    Sublime结合Firebase构建后端服务结构_适用于轻量化全栈项目开发Sublime结合Firebase构建后端服务结构_适用于轻量化全栈项目开发Sublime结合Firebase构建后端服务结构_适用于轻量化全栈项目开发Sublime结合Firebase构建后端服务结构_适用于轻量化全栈项目开发

    使用sublime text配合firebase可快速搭建轻量全栈项目,适合产品原型验证和小规模上线。firebase是google提供的baas服务,集成数据库、认证、云函数、存储等功能,无需自建服务器;其优势包括实时数据库更新、开箱即用的认证系统、简单易用的云函数及零运维成本。项目结构建议分为p…

    2026年10月1日 • 用户投稿
    100
  • TCL雷鸟创新X3 Pro入选《时代》2025最佳发明

    近日,美国《时代》杂志(time)发布了万众期待的2025年度最佳发明榜单,tcl雷鸟创新与苹果、华为、比亚迪、deepseek等全球知名科技企业共同登榜,其创新成果获得国际高度认可。 在本次榜单中,中国科技力量表现抢眼:华为Pura80 Ultra引领高端智能手机潮流,比亚迪持续领跑新能源汽车赛道…

    2026年10月1日
    200
  • 使用Sublime配合Sass开发|前端样式管理更加轻松灵活

    使用Sublime配合Sass开发|前端样式管理更加轻松灵活使用Sublime配合Sass开发|前端样式管理更加轻松灵活使用Sublime配合Sass开发|前端样式管理更加轻松灵活使用Sublime配合Sass开发|前端样式管理更加轻松灵活

    使用 sublime 搭配 sass 开发可提升 css 编写效率。1. 安装 sass 插件如 sassbuild 或 scss builder,通过 package control 安装并配置项目路径;2. 使用变量、嵌套、混合等特性简化样式编写,实现高效维护;3. 按模块划分 scss 文件并…

    2026年10月1日 • 用户投稿
    1200
  • 灵狐浏览器高清视频优化入口2025-灵狐浏览器影音版网页登录地址

    灵狐浏览器高清视频优化入口2025-灵狐浏览器影音版网页登录地址灵狐浏览器高清视频优化入口2025-灵狐浏览器影音版网页登录地址灵狐浏览器高清视频优化入口2025-灵狐浏览器影音版网页登录地址灵狐浏览器高清视频优化入口2025-灵狐浏览器影音版网页登录地址

    灵狐浏览器高清视频优化入口位于官网“影音加速”模块,登录后可在个人中心启用智能画质增强功能。用户可通过主站导航栏、播放页工具条、快捷键Ctrl+Shift+V或移动端侧边菜单进入优化界面。平台采用分布式节点调度、预加载引擎和多线程下载技术提升加载速度,支持自适应码率与缓冲设置。视觉方面集成AI修复、…

    2026年10月1日 • 用户投稿
    300
  • java使用教程如何使用正则表达式匹配字符串 java使用教程的正则应用基础教程​

    java使用教程如何使用正则表达式匹配字符串 java使用教程的正则应用基础教程​java使用教程如何使用正则表达式匹配字符串 java使用教程的正则应用基础教程​java使用教程如何使用正则表达式匹配字符串 java使用教程的正则应用基础教程​java使用教程如何使用正则表达式匹配字符串 java使用教程的正则应用基础教程​

    在java中使用正则表达式需先通过pattern.compile()编译正则字符串生成pattern对象,再调用其matcher()方法结合目标字符串创建matcher对象;2. matcher对象通过find()查找子串匹配、matches()判断全串匹配、group()获取匹配内容、start(…

    2026年10月1日 • 用户投稿
    500
  • Sublime任务自动化 Sublime定时执行脚本方法

    Sublime任务自动化 Sublime定时执行脚本方法Sublime任务自动化 Sublime定时执行脚本方法Sublime任务自动化 Sublime定时执行脚本方法Sublime任务自动化 Sublime定时执行脚本方法

    sublime text自身不支持定时任务,但可通过操作系统的调度工具实现脚本的定时执行。具体步骤如下:1. 利用sublime的构建系统、宏和插件实现内部自动化;2. 在windows上使用任务计划程序配置定时任务,设置触发器和启动程序;3. 在macos或linux上使用cron编写定时任务命令…

    2026年10月1日 • 用户投稿
    100
  • 谷歌浏览器如何同步书签和设置_谷歌浏览器数据同步功能配置指南

    谷歌浏览器如何同步书签和设置_谷歌浏览器数据同步功能配置指南谷歌浏览器如何同步书签和设置_谷歌浏览器数据同步功能配置指南谷歌浏览器如何同步书签和设置_谷歌浏览器数据同步功能配置指南谷歌浏览器如何同步书签和设置_谷歌浏览器数据同步功能配置指南

    首先检查并登录Google账号确保同步已开启,接着通过chrome://sync-internals/手动触发同步,最后可导出书签HTML文件进行本地传输与导入。 如果您在多台设备上使用谷歌浏览器,但发现书签和设置未能自动更新,可能是同步功能未正确配置或存在延迟。以下是解决此问题的步骤: 本文运行环…

    2026年10月1日 • 用户投稿
    000
  • 高通孟樸:携手中国汽车产业伙伴 书写智能出行新篇章

    高通孟樸:携手中国汽车产业伙伴 书写智能出行新篇章高通孟樸:携手中国汽车产业伙伴 书写智能出行新篇章高通孟樸:携手中国汽车产业伙伴 书写智能出行新篇章高通孟樸:携手中国汽车产业伙伴 书写智能出行新篇章

    2025年6月26日至27日,“2025高通汽车技术与合作峰会”在苏州顺利举办,本次大会围绕“我们一起,行稳智远”的主题展开,聚焦智能汽车产业未来发展的新热点、新趋势与新机遇。6月27日,在峰会主论坛上,高通中国区董事长孟樸发表了热情洋溢的欢迎致辞。他表示,高通将继续以“连接+计算+ai”为核心战略…

    2026年10月1日 • 用户投稿
    300
  • AMD不是受害者 NVIDIA与Intel合作带来三赢:原因有二

    AMD不是受害者 NVIDIA与Intel合作带来三赢:原因有二AMD不是受害者 NVIDIA与Intel合作带来三赢:原因有二AMD不是受害者 NVIDIA与Intel合作带来三赢:原因有二AMD不是受害者 NVIDIA与Intel合作带来三赢:原因有二

    9月20日消息,nvidia向intel投资50亿美元的重磅合作仍在持续引发行业震荡,这场“双英联手”正为cpu、gpu及ai市场带来前所未有的变局。 目前普遍观点认为,此次合作是NVIDIA与Intel的双赢之举:NVIDIA得以借助Intel的x86生态进一步拓展AI计算版图,而Intel则获得…

    2026年10月1日 • 用户投稿
    100
  • 使用线性搜索在两个 ArrayList 中查找元素

    使用线性搜索在两个 ArrayList 中查找元素使用线性搜索在两个 ArrayList 中查找元素使用线性搜索在两个 ArrayList 中查找元素使用线性搜索在两个 ArrayList 中查找元素

    本文介绍了如何在 Java 中使用线性搜索算法比较两个字符串类型的 ArrayList,以判断一个列表(例如购物清单)中的所有元素是否都存在于另一个列表(例如食品储藏室清单)中。我们将探讨如何通过循环遍历和条件判断来实现此功能,并提供使用 HashSet 优化搜索效率的替代方案。 线性搜索实现 线性…

    2026年10月1日 • 用户投稿
    000
  • 根据字母等级计算绩点并输出

    根据字母等级计算绩点并输出根据字母等级计算绩点并输出根据字母等级计算绩点并输出根据字母等级计算绩点并输出

    本文旨在指导读者如何编写一个Java程序,该程序接受用户输入的字母等级,并根据等级返回相应的绩点。程序包含异常处理机制,能够有效处理无效的字母等级输入,并输出相应的错误提示信息,确保程序的健壮性和用户体验。 程序实现 以下是一个Java程序的示例,它实现了根据用户输入的字母等级计算并输出绩点的功能。…

    2026年10月1日 • 用户投稿
    100
  • VSCode 怎样使用断点调试 TypeScript 代码 VSCode 断点调试 TypeScript 代码的方法​

    要让vscode的断点在typescript代码中生效,必须正确配置源映射和调试环境,具体步骤如下:1. 确保项目根目录有tsconfig.json文件,若无则通过tsc –init生成;2. 在tsconfig.json中设置”sourcemap”: true以…

    2026年10月1日
    100
  • 詹姆斯・卡梅隆谈 AI:能和人类一样富有创造力,但无法拥有独特生活体验

    詹姆斯・卡梅隆谈 AI:能和人类一样富有创造力,但无法拥有独特生活体验詹姆斯・卡梅隆谈 AI:能和人类一样富有创造力,但无法拥有独特生活体验詹姆斯・卡梅隆谈 AI:能和人类一样富有创造力,但无法拥有独特生活体验詹姆斯・卡梅隆谈 AI:能和人类一样富有创造力,但无法拥有独特生活体验

    9 月 20 日消息,据外媒 the verge 18 日报道,著名导演詹姆斯・卡梅隆在 meta connect 大会上与 meta cto 安德鲁・博斯沃斯同台,展示了双方合作的首个成果:quest 用户可通过头显上的全新 horizon tv 应用,观看其即将上映的《阿凡达 3》电影独家预览片…

    2026年10月1日 • 用户投稿
    000
  • Java中Boolean类型值的精确校验方法

    Java中Boolean类型值的精确校验方法Java中Boolean类型值的精确校验方法Java中Boolean类型值的精确校验方法Java中Boolean类型值的精确校验方法

    本文旨在解决Java中Boolean类型值的精确校验问题,即如何确保用户输入的值严格为true或false,并针对无效输入给出明确的错误提示。我们将探讨如何在不改变数据类型的前提下,实现对Boolean类型值的有效验证,并提供相应的代码示例和注意事项。 Boolean类型值的精确校验 在Java中,…

    2026年10月1日 • 用户投稿
    000
  • 赢下届入场券!卓威高校电竞文化节线上开播

    赢下届入场券!卓威高校电竞文化节线上开播赢下届入场券!卓威高校电竞文化节线上开播赢下届入场券!卓威高校电竞文化节线上开播赢下届入场券!卓威高校电竞文化节线上开播

    2025年9月20日至21日,卓威高校电竞文化节将正式拉开帷幕,a区现场将举办电竞社团分享交流会,汇聚近百位来自全国各地高校电竞社团成员,共同助力高校电竞的蓬勃发展。 而未能来到现场的同学们也不必感到沮丧,我们将同步开放腾讯会议直播通道,届时不仅将有优秀社团代表带来专业的社团建设经验分享,更有前TY…

    2026年10月1日 • 用户投稿
    100
  • Java中如何使用void方法修改boolean状态

    Java中如何使用void方法修改boolean状态Java中如何使用void方法修改boolean状态Java中如何使用void方法修改boolean状态Java中如何使用void方法修改boolean状态

    在Java编程中,经常需要控制对象的状态。当对象的状态由一个boolean类型的变量表示时,我们可以使用void方法(通常是setter方法)来改变这个boolean变量的值,从而改变对象的状态。本文将通过一个简单的例子,详细讲解如何实现这一目标。 public class Status { pri…

    2026年10月1日 • 用户投稿
    100
  • 豆包AI怎样辅助Django开发?快速构建Web应用后端

    豆包AI怎样辅助Django开发?快速构建Web应用后端豆包AI怎样辅助Django开发?快速构建Web应用后端豆包AI怎样辅助Django开发?快速构建Web应用后端豆包AI怎样辅助Django开发?快速构建Web应用后端

    豆包ai可在django开发中显著提升效率,具体体现在以下方面:1. 快速生成项目结构,根据需求输出基础代码框架;2. 自动生成模型并提供数据库设计建议,包括字段类型、索引和约束;3. 编写视图逻辑与接口文档,支持drf视图、路由及响应示例;4. 提供问题解决方案与调试建议,如处理迁移冲突、调试慢查…

    2026年10月1日 • 用户投稿
    100
  • NVIDIA新动作:RTX 50显卡被删除AI相关宣传

    NVIDIA新动作:RTX 50显卡被删除AI相关宣传NVIDIA新动作:RTX 50显卡被删除AI相关宣传NVIDIA新动作:RTX 50显卡被删除AI相关宣传NVIDIA新动作:RTX 50显卡被删除AI相关宣传

    9月21日消息,如今的显卡已经不局限于游戏功能,ai功能也是一大重点,nvidia这几代显卡都强化了ai性能,rtx 50系列更是如此。 但是现在NVIDIA在这方面突然来了一波让人不太看得懂的操作,从RTX显卡的包装和宣传中移除了“Powering Advanced AI”(提供先进AI功能)这一…

    2026年10月1日 • 用户投稿
    000
  • Sublime集成第三方API聚合平台应用_从天气查询到支付接口对接实例

    Sublime集成第三方API聚合平台应用_从天气查询到支付接口对接实例Sublime集成第三方API聚合平台应用_从天气查询到支付接口对接实例Sublime集成第三方API聚合平台应用_从天气查询到支付接口对接实例Sublime集成第三方API聚合平台应用_从天气查询到支付接口对接实例

    sublime虽是文本编辑器,但可通过写调用代码实现api对接。1. 利用build system配置python环境,使用requests库发送get/post请求。2. 借助api聚合平台获取标准化接口,简化接入流程。3. 调试时注意密钥保密、签名正确、处理ssl证书与异常返回值,确保请求稳定。…

    2026年10月1日 • 用户投稿
    100

发表回复

登录后才能评论
关注微信