Ubuntu下MySQL主从同步配置步骤

1)在ubuntu中安装mysql,并使用docker安装另一台mysql

为了确保主从同步时多台MySQL的版本一致,假设Ubuntu中已安装的MySQL版本为5.7.22,以下是获取相同版本的Docker镜像的步骤:

docker image pull mysql:5.7.22 或 docker load -i mysql_docker_5722.tar

运行MySQL Docker镜像时,需要在宿主机中创建一个目录,用于MySQL容器保存数据和读取配置文件。

在家目录(/home/Python)中创建目录,并将MySQL的配置文件放入该目录:

cd ~mkdir mysql_slavecd mysql_slavemkdir datacp /etc/mysql/mysql.conf.d ./

将Docker运行的MySQL作为从服务器(slave)来运行,启动前需要修改配置文件。

编辑 ~/mysql_slave/mysql.conf.d/mysqld.cnf 文件,进行以下修改:

port = 8306general_log = 0server-id = 2

这样,这台MySQL将运行在8306端口上,且MySQL编号为2。

创建Docker容器:

docker run –name mysql-slave -e MYSQL_ROOT_PASSWORD=mysql -d –network=host -v /home/python/mysql_slave/data:/var/lib/mysql -v /home/python/mysql_slave/mysql.conf.d:/etc/mysql/mysql.conf.d mysql:5.7.22

其中,MYSQL_ROOT_PASSWORD 是创建MySQL root用户的密码。

在Ubuntu中使用MySQL命令尝试连接Docker容器中的MySQL:

mysql -uroot -pmysql -h 127.0.0.1 –port=8306

2)将主服务器原有数据备份到从服务器

如果在设置主从同步前,主服务器上已有大量数据,可以使用mysqldump进行数据备份并还原到从服务器以实现数据的复制。

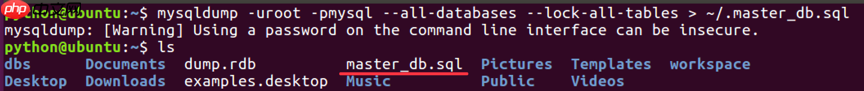
在主服务器Ubuntu上进行备份,执行以下命令:

mysqldump -uroot -pmysql –all-databases –lock-all-tables > ~/master_db.sql
Ubuntu下MySQL主从同步配置步骤

-u:用户名-p:提示密码–all-databases:导出所有数据库–lock-all-tables:执行操作时锁住所有表,防止操作时有数据修改~/master_db.sql:导出的备份数据(SQL文件)位置,可自行指定

在Docker容器中导入数据:

mysql -uroot -pmysql -h127.0.0.1 –port=8306

3)配置主服务器master(Ubuntu中的MySQL)

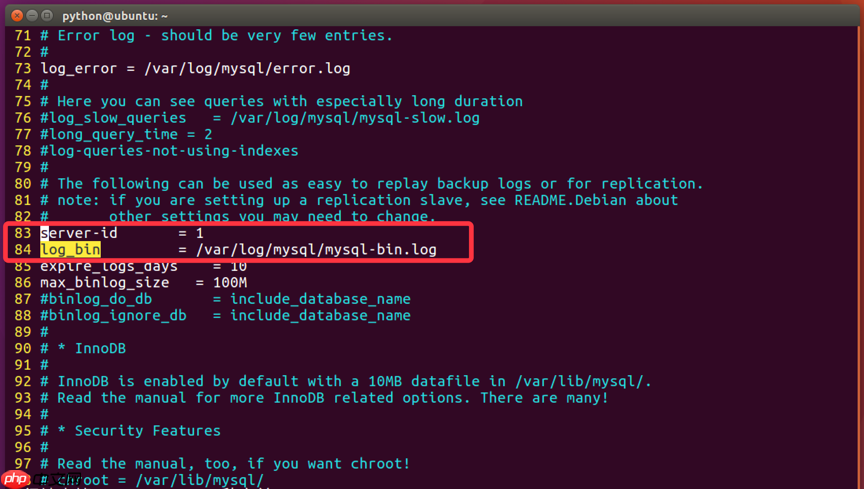
编辑设置mysqld的配置文件,设置log_bin和server-id:

sudo vim /etc/mysql/mysql.conf.d/mysqld.cnf
Ubuntu下MySQL主从同步配置步骤

重启MySQL服务:

sudo service mysql restart

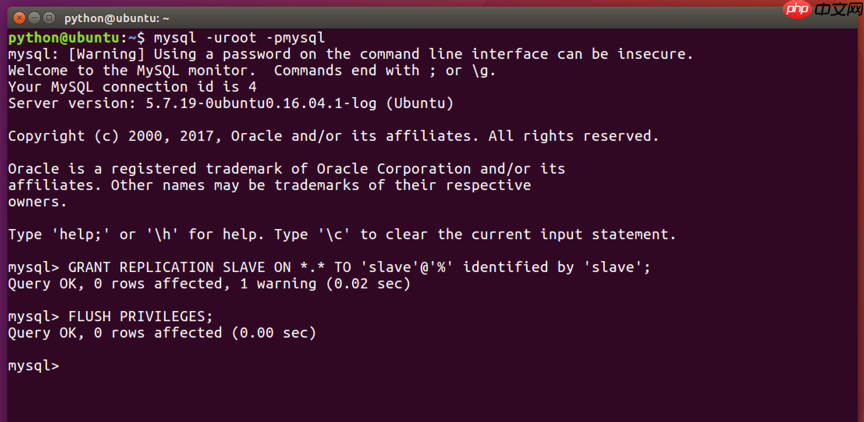
登录到主服务器Ubuntu中的MySQL,创建用于从服务器同步数据的账号:

mysql –uroot –pmysql

GRANT REPLICATION SLAVE ON . TO ‘slave’@’%’ identified by ‘slave’;FLUSH PRIVILEGES;
Ubuntu下MySQL主从同步配置步骤

获取主服务器的二进制日志信息:

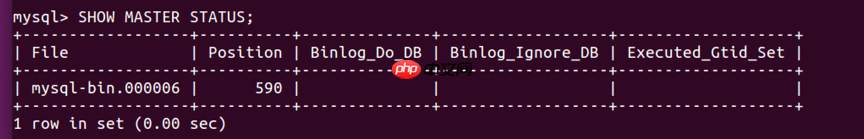
SHOW MASTER STATUS;

Ubuntu下MySQL主从同步配置步骤

File为使用的日志文件名字,Position为使用的文件位置,这两个参数需要记下,配置从服务器时会用到。

4)配置从服务器slave(Docker中的MySQL)

进入Docker中的MySQL:

mysql -uroot -pmysql -h 127.0.0.1 –port=8306

执行以下命令:

change master to master_host=’127.0.0.1′, master_user=’slave’, master_password=’slave’,master_log_file=’mysql-bin.000006′, master_log_pos=590;

master_host:主服务器Ubuntu的IP地址master_log_file:前面查询到的主服务器日志文件名master_log_pos:前面查询到的主服务器日志文件位置

启动slave服务器,并查看同步状态:

start slave;show slave status G

Ubuntu下MySQL主从同步配置步骤

以上就是Ubuntu下MySQL主从同步配置步骤的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/30707.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
防止恶意软件入侵:在Linux服务器上保护您的系统
上一篇 2026年9月30日 13:54:25
Python try 嵌套结构的最佳实践
下一篇 2025年12月14日 22:29:19

相关推荐

  • Sublime宏变量使用 Sublime动态宏命令

    Sublime宏变量使用 Sublime动态宏命令Sublime宏变量使用 Sublime动态宏命令Sublime宏变量使用 Sublime动态宏命令Sublime宏变量使用 Sublime动态宏命令

    在sublime text中使用宏变量和动态宏命令需借助插件实现。1. 使用宏变量时,可通过sendtext等插件调用外部脚本处理选中文本或剪贴板内容,并将结果返回替换原内容,如批量修改markdown图片链接域名。2. 动态宏命令通过插件根据上下文生成不同命令序列,例如编写python插件分析代码…

    2026年9月30日 • 用户投稿
    000
  • Sublime实现文件上传接口模块功能_支持图片文档多类型格式处理

    Sublime实现文件上传接口模块功能_支持图片文档多类型格式处理Sublime实现文件上传接口模块功能_支持图片文档多类型格式处理Sublime实现文件上传接口模块功能_支持图片文档多类型格式处理Sublime实现文件上传接口模块功能_支持图片文档多类型格式处理

    文件上传接口可通过sublime编写后端逻辑实现,关键在于理解流程与格式处理。1. 接口接收文件流并存储,如flask中通过request.files获取文件并保存;2. 支持多类型需检查扩展名、限制大小、安全重命名及返回错误信息;3. 图片可使用pillow库进行压缩预处理;4. 存储策略建议使用…

    2026年9月30日 • 用户投稿
    000
  • sublime如何优化Jupyter笔记本编辑 sublime处理ipynb文件方案

    sublime如何优化Jupyter笔记本编辑 sublime处理ipynb文件方案sublime如何优化Jupyter笔记本编辑 sublime处理ipynb文件方案sublime如何优化Jupyter笔记本编辑 sublime处理ipynb文件方案sublime如何优化Jupyter笔记本编辑 sublime处理ipynb文件方案

    sublime text处理.ipynb文件的核心痛点是交互性缺失和json结构复杂导致的编辑困难。1. 无法在sublime中执行代码、查看输出或管理内核,缺乏jupyter原生的交互功能;2. .ipynb文件为嵌套json结构,手动编辑易破坏语法,尤其在包含大量输出和元数据时,可读性和可维护性…

    2026年9月30日 • 用户投稿
    100
  • MySQL如何压缩数据库 表空间压缩与备份压缩方案

    MySQL如何压缩数据库 表空间压缩与备份压缩方案MySQL如何压缩数据库 表空间压缩与备份压缩方案MySQL如何压缩数据库 表空间压缩与备份压缩方案MySQL如何压缩数据库 表空间压缩与备份压缩方案

    mysql数据库压缩需求评估需先明确数据类型与业务场景。1.文本数据压缩率高,图片、视频等二进制数据压缩效果差;2.频繁读写数据压缩可能影响性能,冷数据压缩收益更高;3.通过查询information_schema分析大表与低频更新表;4.使用监控工具评估压缩前后性能影响。表空间压缩方法包括:1.使…

    2026年9月30日 • 用户投稿
    200
  • sublime如何设置自动缩进规则 sublime代码缩进的个性化配置

    sublime如何设置自动缩进规则 sublime代码缩进的个性化配置sublime如何设置自动缩进规则 sublime代码缩进的个性化配置sublime如何设置自动缩进规则 sublime代码缩进的个性化配置sublime如何设置自动缩进规则 sublime代码缩进的个性化配置

    解决sublime text缩进混乱问题需关闭“detect_indentation”: false以防止自动检测干扰;2. 通过用户设置文件preferences.sublime-settings配置“tab_size”“translate_tabs_to_spaces”等参数统一全局缩进规则;3…

    2026年9月30日 • 用户投稿
    200
  • 怎么用豆包AI帮我生成HTTP客户端代码 HTTP客户端代码的AI生成指南

    怎么用豆包AI帮我生成HTTP客户端代码 HTTP客户端代码的AI生成指南怎么用豆包AI帮我生成HTTP客户端代码 HTTP客户端代码的AI生成指南怎么用豆包AI帮我生成HTTP客户端代码 HTTP客户端代码的AI生成指南怎么用豆包AI帮我生成HTTP客户端代码 HTTP客户端代码的AI生成指南

    使用豆包ai生成http客户端代码的关键在于提供清晰具体的指令。1. 明确请求方式和目标url,例如指定get或post请求及对应地址;2. 提供查询参数、请求头及认证信息,如token或headers;3. 指定编程语言及框架,如python的requests、node.js的axios等;4. …

    2026年9月30日 • 用户投稿
    100
  • Sublime进行数据库索引优化分析_提升数据查询性能与响应速度

    Sublime进行数据库索引优化分析_提升数据查询性能与响应速度Sublime进行数据库索引优化分析_提升数据查询性能与响应速度Sublime进行数据库索引优化分析_提升数据查询性能与响应速度Sublime进行数据库索引优化分析_提升数据查询性能与响应速度

    使用sublime text辅助数据库索引优化分析,一、通过慢查询日志定位瓶颈,利用多行选择和正则表达式筛选耗时sql;二、结合执行计划判断索引使用情况,关注type和extra字段;三、检查表结构与索引定义,优化复合索引顺序及删除冗余索引。 在处理大量数据时,数据库的查询性能直接影响到系统的响应速…

    2026年9月30日 • 用户投稿
    100
  • 豆包AI编程功能介绍 豆包AI自动写代码步骤

    豆包AI编程功能介绍 豆包AI自动写代码步骤豆包AI编程功能介绍 豆包AI自动写代码步骤豆包AI编程功能介绍 豆包AI自动写代码步骤豆包AI编程功能介绍 豆包AI自动写代码步骤

    豆包的#%#$#%@%@%$#%$#%#%#$%@_4921c++0e2d1f6005abe1f9ec2e2041909编程功能具备代码生成、补全、注释添加、错误检查与修复建议等实用能力,支持多语言开发环境。1. 主要功能包括:根据自然语言生成代码、智能推荐下一行代码、自动生成注释、识别语法错误并提…

    2026年9月30日 • 用户投稿
    000
  • Sublime如何创建个人插件工具|扩展功能满足个性化需求

    Sublime如何创建个人插件工具|扩展功能满足个性化需求Sublime如何创建个人插件工具|扩展功能满足个性化需求Sublime如何创建个人插件工具|扩展功能满足个性化需求Sublime如何创建个人插件工具|扩展功能满足个性化需求

    创建sublime插件需四步:一、在packages目录新建文件夹及.py文件;二、编写helloworldcommand类插入文本;三、通过key bindings或main.sublime-menu绑定快捷键或右键菜单;四、扩展功能如自动补全、格式化文本。示例代码实现选中内容加引号功能,提升效率…

    2026年9月30日 • 用户投稿
    000
  • 服务器上安装Mysql8.0

    服务器上安装Mysql8.0服务器上安装Mysql8.0服务器上安装Mysql8.0服务器上安装Mysql8.0

    本教程适用于社区版mysql,供日常学习交流使用,不得用于商业用途。如需商业用途,请通过官方渠道购买正版产品。 第一步,准备好连接工具。我直接使用了控制台的远程连接。如果不是在自己电脑上操作,通常会使用xshell进行连接,操作流程基本相同。 连接到ECS后,需移除默认的MariaDB数据库: yu…

    2026年9月30日 • 用户投稿
    500
  • 怎么用豆包AI帮我理解复杂算法 豆包AI图解算法原理的实用技巧分享

    怎么用豆包AI帮我理解复杂算法 豆包AI图解算法原理的实用技巧分享怎么用豆包AI帮我理解复杂算法 豆包AI图解算法原理的实用技巧分享怎么用豆包AI帮我理解复杂算法 豆包AI图解算法原理的实用技巧分享怎么用豆包AI帮我理解复杂算法 豆包AI图解算法原理的实用技巧分享

    豆包ai在理解复杂算法时能提供多方面帮助,关键在于掌握提问和使用方法。一、用生活例子解释k-means聚类等抽象概念,建议提问方式包括日常场景说明、核心思想总结、与其它算法对比。二、通过生成结构图或流程图辅助理解决策树、神经网络等算法,可逐步细化描述图形内容。三、结合代码片段加深理解,例如梯度下降的…

    2026年9月30日 • 用户投稿
    100
  • sublime如何优化SQL编写体验 sublime数据库查询的高效技巧

    sublime如何优化SQL编写体验 sublime数据库查询的高效技巧sublime如何优化SQL编写体验 sublime数据库查询的高效技巧sublime如何优化SQL编写体验 sublime数据库查询的高效技巧sublime如何优化SQL编写体验 sublime数据库查询的高效技巧

    安装package control后,通过其安装sqltools及对应数据库驱动插件以实现语法高亮、代码片段和数据库连接;2. 配置sqltools用户设置中的数据库连接信息,并利用内置或自定义代码片段快速生成sql语句;3. 安装sql beautifier进行代码格式化,结合sublimelin…

    2026年9月30日 • 用户投稿
    400
  • 如何在本地运行Stable Diffusion 本地部署Stable Diffusion的配置指南

    如何在本地运行Stable Diffusion 本地部署Stable Diffusion的配置指南如何在本地运行Stable Diffusion 本地部署Stable Diffusion的配置指南如何在本地运行Stable Diffusion 本地部署Stable Diffusion的配置指南如何在本地运行Stable Diffusion 本地部署Stable Diffusion的配置指南

    要在本地运行 stable diffusion,其实并不难,只要准备好合适的硬件和软件环境并按照步骤操作即可。1. 硬件方面建议使用 nvidia 显卡(rtx 30 系列或更高,显存至少 6gb),16gb 或以上内存,ssd 存储空间几十 gb,系统可选 windows 10/11 或 linu…

    2026年9月30日 • 用户投稿
    100
  • sublime如何优化XML文件处理 sublime大型XML文档编辑技巧

    sublime如何优化XML文件处理 sublime大型XML文档编辑技巧sublime如何优化XML文件处理 sublime大型XML文档编辑技巧sublime如何优化XML文件处理 sublime大型XML文档编辑技巧sublime如何优化XML文件处理 sublime大型XML文档编辑技巧

    安装“pretty xml”和“xpath”插件以提升xml格式化与元素定位效率;2. 调整sublime text配置,增加index_workers数量并关闭代码折叠与自动完成功能以优化性能;3. 对超大xml文件采用分块加载策略,避免内存溢出;4. 结合xmllint和xmlstarlet等外…

    2026年9月30日 • 用户投稿
    100
  • 苹果用户DeepSeek安装启用保姆级指南

    苹果用户DeepSeek安装启用保姆级指南苹果用户DeepSeek安装启用保姆级指南苹果用户DeepSeek安装启用保姆级指南苹果用户DeepSeek安装启用保姆级指南

    苹果用户安装deepseek需先确认mac配置是否达标,尤其注意芯片型号、内存、磁盘空间及系统版本;接着安装python和git并配置虚拟环境;然后从github克隆代码并安装依赖,注意网络和版本兼容性问题;随后运行程序并访问本地地址打开界面,确保模型路径正确;最后应对常见问题如下载慢可换源,启动失…

    2026年9月30日 • 用户投稿
    100
  • sublime如何实现代码复杂度分析 sublime评估代码质量的科学方法

    sublime如何实现代码复杂度分析 sublime评估代码质量的科学方法sublime如何实现代码复杂度分析 sublime评估代码质量的科学方法sublime如何实现代码复杂度分析 sublime评估代码质量的科学方法sublime如何实现代码复杂度分析 sublime评估代码质量的科学方法

    sublime text本身不内置代码复杂度分析功能,但可通过插件生态系统实现间接支持;2. 利用sublimelinter集成flake8、pylint、eslint等linter插件,可强制执行函数长度、参数数量、嵌套深度等规则,从而在编码阶段预防高复杂度代码;3. 通过构建系统运行radon、…

    2026年9月30日 • 用户投稿
    100
  • Linux下MySQL 8.0 二进制安装

    mysql社区版:开源且免费,但不提供技术支持,需搭配其他开源工具使用。 MySQL企业版:与社区版代码相同,通过插件提供额外功能,如线程插件、审计插件等。 MySQL Cluster CGE集群商业版:实时开源事务数据库,设计用于高吞吐量环境下快速、持久地访问数据。支持并行分布式查询引擎、自动分区…

    2026年9月30日
    100
  • 如何在Red Hat 8上配置MySQL高可用集群的详细步骤?

    如何在Red Hat 8上配置MySQL高可用集群的详细步骤?如何在Red Hat 8上配置MySQL高可用集群的详细步骤?如何在Red Hat 8上配置MySQL高可用集群的详细步骤?如何在Red Hat 8上配置MySQL高可用集群的详细步骤?

    配置MySQL高可用集群,说白了就是让你的数据库扛得住压力,不怕宕机。Red Hat 8上搞这个,其实挺考验运维功底的,但也不是啥高不可攀的事儿。 解决方案 准备环境: 至少三台Red Hat 8服务器。 别想着一台机器玩转高可用,那是耍流氓。确保服务器之间网络互通,防火墙放行MySQL和集群通信端…

    2026年9月30日 • 用户投稿
    100
  • VS Code终端配置:环境变量与信号处理技术指南

    合理配置环境变量和理解信号机制可提升VS Code终端使用效率。1. 项目级变量通过.env文件或launch.json中设置env字段实现,Node.js需手动加载;2. 用户/系统级变量需在操作系统中修改并重启VS Code生效;3. 终端启动时应确保正确shell及配置文件加载;4. Ctrl…

    2026年9月30日
    000
  • MySQL如何实现跨库事务 XA分布式事务处理方案

    MySQL如何实现跨库事务 XA分布式事务处理方案MySQL如何实现跨库事务 XA分布式事务处理方案MySQL如何实现跨库事务 XA分布式事务处理方案MySQL如何实现跨库事务 XA分布式事务处理方案

    有,更轻量级方案包括柔性事务,如1.tcc(try-confirm-cancel)由应用层实现,通过预扣、确认或回滚操作处理分布式事务;2.saga模式将事务拆分为多个本地事务并配有补偿机制;3.基于消息队列实现最终一致性,这些方案以牺牲强一致性换取性能与可用性提升。 MySQL实现跨库事务,通常会…

    2026年9月30日 • 用户投稿
    100

发表回复

登录后才能评论
关注微信