相关免费学习推荐:mysql数据库(视频)
前言
MySQL索引底层数据结构与算法MySQL性能优化原理-前篇MySQL性能优化-实践篇1MySQL性能优化-实践篇2
前面我们讲了mysql数据库底层的数据结构与算法、mysql性能优化篇一些内容。我们再来聊聊mysql的锁与事务隔离级别,分上下两篇,本篇重点讲mysql的行锁与事务隔离级别。
锁定义
锁是计算机协调多个进程或线程并发访问某一资源的机制。
在数据库中,除了传统的计算资源(如CPU、RAM、I/O等)的争用以外,数据也是一种供需要用户共享的资源。如何保证数据并发访问的一致性、有效性是所有数据库必须解决的一个问题,锁冲突也是影响数据库并发访问性能的一个重要因素。
锁分类
从性能上分为乐观锁(用版本对比来实现)和 悲观锁;从数据库操作类型分为:读锁 和 写锁 (都属于悲观锁)读锁(共享锁):针对同一份数据,多个读操作可以同时进行而不会互相影响;写锁(排它锁):当前写操作没有完成之前,它会阻断其它写锁和读锁。从数据库操作的粒度分为:表锁 和 行锁。
对于锁深入的理解,可以查看《关于Java中锁的理解》。
MySQL的锁
行锁(Record Locks)
间隙锁(Gap Locks)
临键锁(Next-key Locks)
共享锁/排他锁(Shared and Exclusive Locks)
意向共享锁/意向排他锁(Intention Shared and Exclusive Locks)
插入意向锁(Insert Intention Locks)
自增锁(Auto-inc Locks)
预测锁,这种锁主要用于存储了空间数据的空间索引。
下篇来分别聊聊,本篇重点是行锁以及事务隔离级别。
表锁
每次操作锁住整张表。
开销小,加锁快;不会出现死锁;锁粒度大,发生锁冲突的概率最高;并发度最低。
基本操作
示例表,如下:
# 建表SQLCREATE TABLE mylock ( id INT(11) NOT NULL AUTO_INCREMENT, NAME VARCHAR(20) DEFAULT NULL, PRIMARY KEY(id)) ENGINE = MyISAM DEFAULT CHARSET = utf8;# 插入数据INSERT INTO`test`.`mylock`(`id`,`NAME`) VALUES ('1','a'); INSERT INTO`test`.`mylock`(`id`,`NAME`) VALUES ('2','b'); INSERT INTO`test`.`mylock`(`id`,`NAME`) VALUES ('3','c'); INSERT INTO`test`.`mylock`(`id`,`NAME`) VALUES ('4','d');复制代码
手动增加表锁
lock table 表名称 read(write), 表名称2 read(write);复制代码
查看表上加过的锁
show open tables;复制代码
删除表锁
unlock tables;复制代码
案例分析 — 加读锁
LOCK TABLE mylock read;复制代码
当前 session 和其他 seesion 都可以读该表;
当前 session 中插入或者更新锁定表都会报错,其他 session 插入或者更新则会等待。

案例分析 — 加写锁
LOCK TABLE mylock WRITE;复制代码
当前 session 对该表的增删改查都没有问题,其他 session 对该表的所有操作都会被阻塞 。
案例结论
MyISAM 在执行查询语句(SELECT)前,会自动给涉及的所有表加读锁;在执行增删改查操作前,会自动给涉及的表加写锁。
对 MyISAM 表的读操作(加读锁),不会阻塞其他进程同一表的读请求,但会阻塞对同一表的写请求。只有当读锁释放后,才会执行其他进程的写操作。对 MyISAM 表的写操作(加写锁),会阻塞其他进程对同一表的读和写操作,只有当写锁释放后,才会执行其他进程的读写操作。
总结:读锁会阻塞写,但不会阻塞读;而写锁则会把读和写都阻塞。
行锁
每次操作锁住一行数据。
开销大,加锁慢;会出现死锁;锁定粒度最小,发生锁冲突的概率最低;并发度最高。
InnoDB 和 MyISAM 的最大不同点:
支持事务(TRANSACTION)支持行级锁
行锁支持事务
事务(Transaction)及其 ACID 属性
事务是由一组 SQL 语句组成的逻辑处理单元,事务具有以下四个属性,通常简称为事务的 ACID属性。
原子性(Atomicity):事务是一个原子操作单元,其对数据的修改,要么全部执行,要么全部不执行。一致性(Consistent):在事务开始和完成时,数据都必须保持一致状态。这意味着所有相关的数据规则都必须应用于事务的修改,以保持数据的完整性;事务结束时,所有的内部数据结构(如B+树索引或双向链表)也都必须是正确的。隔离性(Lsolation):数据库系统提供一定的隔离机制,保障事务在不受外部并发操作影响的“独立”环境执行。这意味着事务处理过程中的中间状态对外部是不可见的,反之亦然。持久性(Durable):事务完成之后,它对于数据的修改是永久性的,即使出现系统故障也能保持。
并发事务处理带来的问题
更新丢失(Lost Update)
当两个或多个事务选择同一行,然后基于最初选定的值更新该行值,由于每个事务都不知道其他事务的存在,就会发生丢失更新问题,最后的更新覆盖来其他事务所做的更新。
脏读(Dirty Reads)
一个事务正在对一条记录做修改,在这个事务完成并提交前,这个条记录的数据就处于不一致的状态;这时另外一个事务也来读取同一条记录,如果不加控制,第二个事务读取来这些“脏”数据,并据此做进一步的处理,就会产生未提交的数据依赖关系。这种现象被形象的叫做“脏读”。
总结:事务A读取到来事务B已经修改但尚未提交的数据,还在这个数据基础上做来操作。此时,如果事务B回滚,事务A读取的数据无效,不符合一致性要求。
不可重复读(Non-Repeatable Reads)
一个事务在读取某些数据后的某个时间,再次读取以前读过的数据,却发现其读出的数据已经发生来改变、或某些记录已经被删除了,这种现象就叫做“不可重复读”。
总结:事务A读取到了事务B已经提交的修改数据,不符合隔离性。
幻读(Phantom Reads)
一个事务按相同的查询条件重新读取以前检索过的数据,却发现其他事务插入了满足其查询条件的新数据,这种现象就称为“幻读”。
总结:事务A读取到了事务B提交的新增数据,不符合隔离性。
事务隔离级别
“脏读”、“不可重复读”、“幻读”,其实都是数据库读一致性问题,必须由数据库提供一定的事务隔离机制来解决。
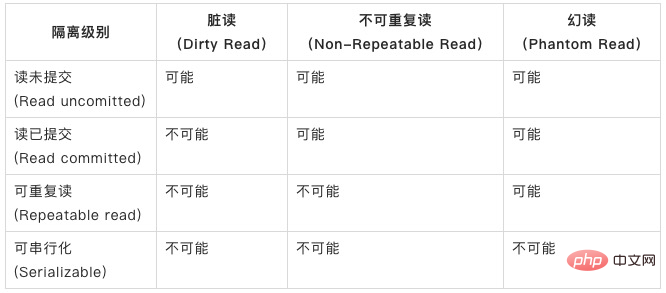
数据库的事务隔离越严格,并发副作用越小,但付出的代价也就越大,因为事务隔离实质上就是使事务在一定程度上“串行化”进行,这显然与“并发”是矛盾的。
同时,不同应用对读一致性和事务隔离程度的要求也是不同的,比如许多应用对“不可重复读”和“幻读” 并不敏感,可能更关系数据并发访问的能力。
查看当前数据库的事务隔离级别
show variables like 'tx_isolation';复制代码
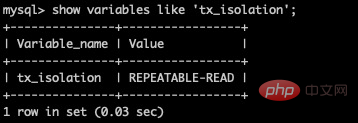
设置事务隔离级别
set tx_isolation='REPEATABLE-READ';复制代码
数据库版本是5.7,隔离级别是Repeatable-Read(可重复读),不同的数据库版本和隔离级别对语句的执行结果影响很大。所以需要说明版本和隔离级别
行锁与隔离级别案例分析
事务控制语句
BEGIN 或 START TRANSACTION;显式地开启一个事务;COMMIT;也可以使用 COMMIT WORK,不过二者是等价的。COMMIT会提交事务,并使已对数据库进行的所有修改称为永久性的;ROLLBACK;有可以使用 ROLLBACK WORK,不过二者是等价的。回滚会结束用户的事务,并撤销正在进行的所有未提交的修改;SAVEPOINT identifier;SAVEPOINT允许在事务中创建一个保存点,一个事务中可以有多个SAVEPOINT;RELEASE SAVEPOINT identifier;删除一个事务的保存点,当没有指定的保存点时,执行该语句会抛出一个异常;ROLLBACK TO identifier;把事务回滚到标记点;SET TRANSACTION;用来设置事务的隔离级别。InnoDB存储引擎提供事务的隔离级别有READ UNCOMMITTED、READ COMMITTED、REPEATABLE READ和SERIALIZABLE。
事务处理方法
MYSQL 事务处理主要有两种方法:
 知我AI·PC客户端
离线运行 AI 大模型,构建你的私有个人知识库,对话式提取文件知识,保证个人文件数据安全
 0 查看详情
 用
BEGIN, ROLLBACK, COMMIT来实现BEGIN 开始一个事务ROLLBACK 事务回滚COMMIT 事务确认直接用 SET 来改变 MySQL 的自动提交模式:SET AUTOCOMMIT=0 禁止自动提交SET AUTOCOMMIT=1`` 开启自动提交
示例表,如下:
CREATE TABLE `user` ( `id` INT (11) NOT NULL AUTO_INCREMENT, `name` VARCHAR (255) DEFAULT NULL, `balance` INT (11) DEFAULT NULL, PRIMARY KEY (`id`)) ENGINE = INNODB DEFAULT CHARSET = utf8;INSERT INTO `test`.`user` (`name`,`balance`) VALUES ('zhangsan','450');INSERT INTO `test`.`user` (`name`,`balance`) VALUES ('lisi', '16000');INSERT INTO `test`.`user` (`name`,`balance`) VALUES ('wangwu','2400');复制代码
行锁演示
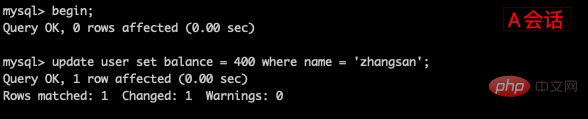
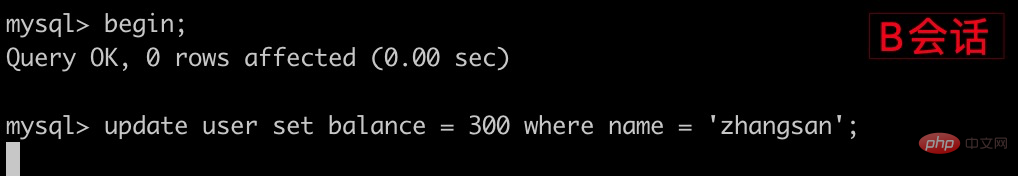
一个 session 开启事务更新不提交,另一个 seesion 更新同一条记录会阻塞,更新不同记录u会阻塞。
读未提交
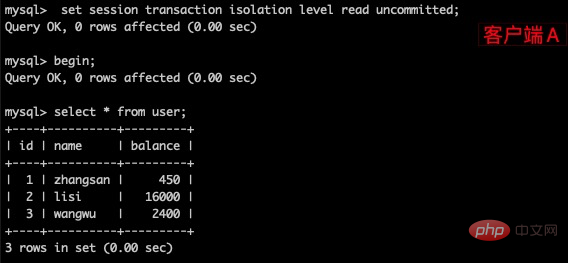
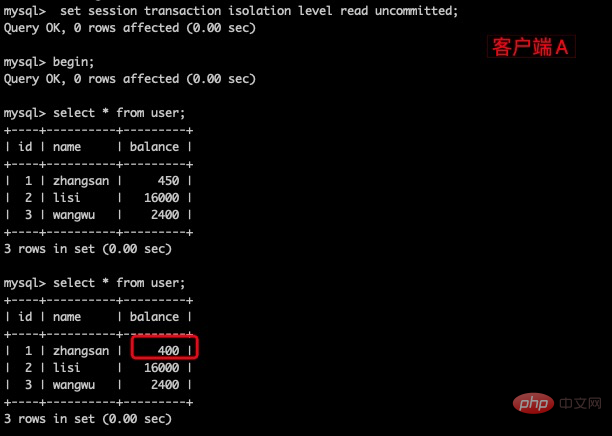
(1)打开一个客户端A,并设置当前事务模式为 read uncommitted (读未提交),查询表 user 的初始化值
set tx_isolation='read-uncommitted';复制代码
(2)在客户端A的事务提交之前,打开另一个客户端B,更新表 user
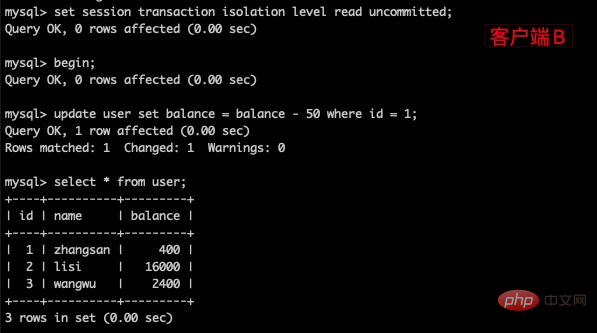
(3)这时,虽然客户端B的事务还没提交,但是在客户端A就可以查询到B已经更新的数据
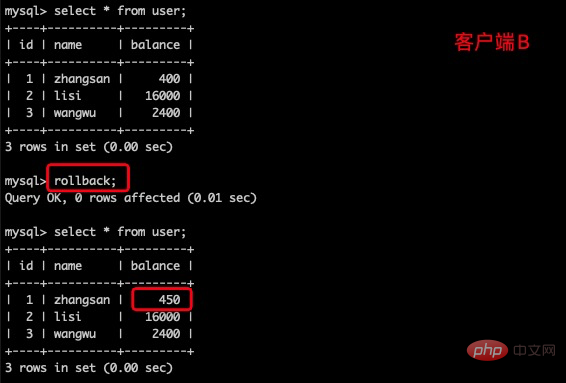
(4)一旦客户端B的事务因为某种原因回滚,所有的操作都将会被撤销,那么客户端A查询到的数据其实就是脏数据。
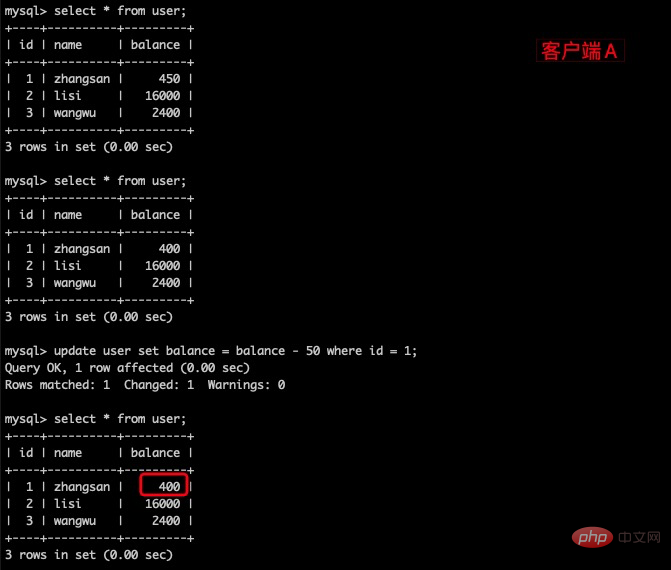
(5)在客户端A执行更新语句 update user set balance = balance - 50 where id = 1; zhangsan 的 balance没有变成350,居然是400,是不是很奇怪,数据不一致啊。如果你这么想就太天真了,在应用程序中,我们会用400-50=350,并不知道其他会话回滚了,要想解决这个问题可以采用读已提交的隔离级别。
读已提交
(1)打开一个客户端A,并设置当前事务模式为 read committed (读已提交),查询表 user 的所有记录
set tx_isolation='read-committed';复制代码
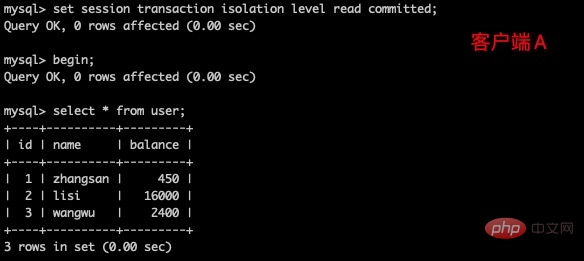
(2)在客户端A的事务提交之前,打开另一个客户端B,更新表 user
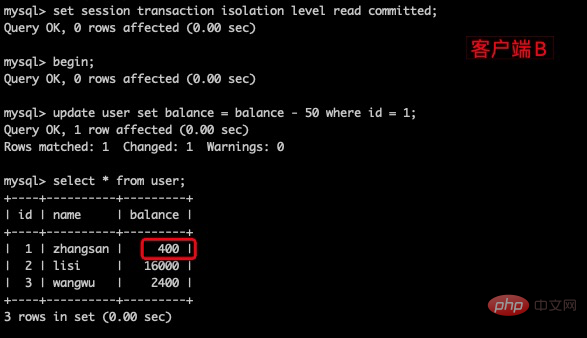
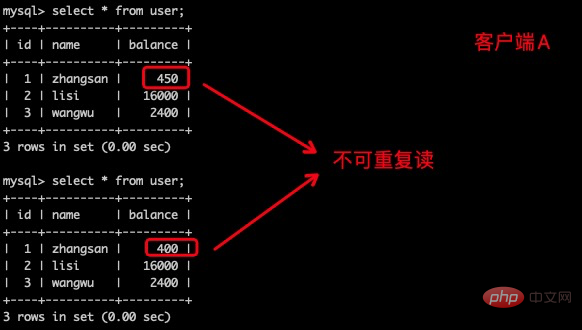
(3)这时,客户端B的事务还没提交,客户端A不能查询到B已经更新的数据,解决了脏读问题。
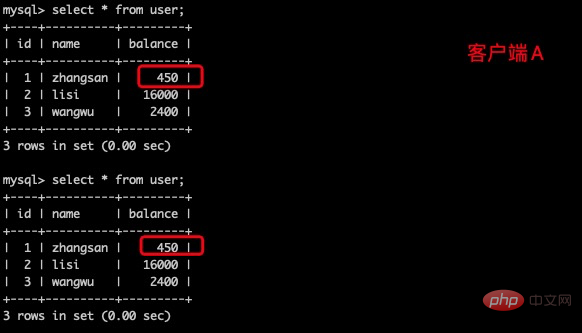
(4)客户端B的事务提交
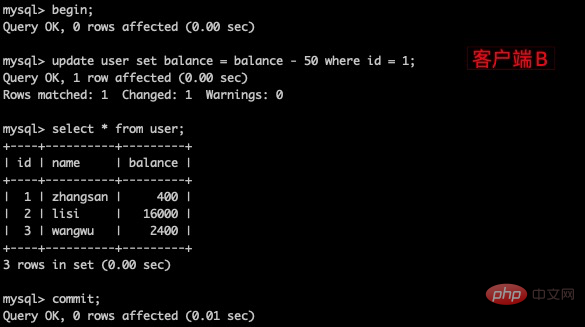
(5)客户端A执行与上一步相同的查询,结果与上一步不一致,即产生了不可重复读的问题。
可重复读
(1)打开一个客户端A,并设置当前的事务模式为 repeatable read ,查询表 user 的所有记录。
set tx_isolation='REPEATABLE-READ';复制代码
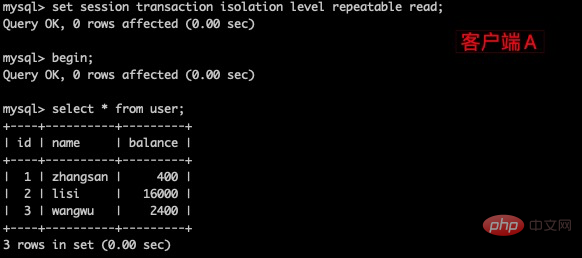
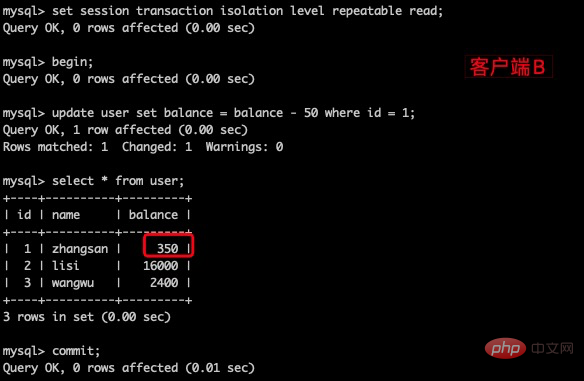
(2)在客户端A的事务提交之前,打开另一个客户端B,更新表 user 并提交。
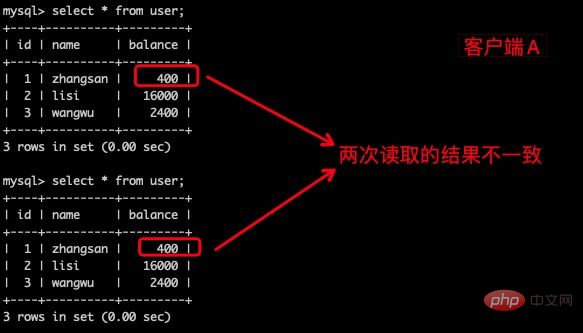
(3)在客户端A查询表 user 的所有记录,与步骤(1)查询结果一直,没有出现不可重复读的问题。
(4)在客户端A,接着执行 update user set balance = balance - 50 where id = 1 , balance 没有变成 400 – 50 = 350, zhangsan 的 balance 的值用的是步骤(2) 中的 350 来计算的,所以是300,数据的一致性倒是没有被破坏。可重复读的隔离级别下使用了 MVCC(multi-version concurrency control)机制,select 操作不会更新版本号,是快照读(历史版本);insert、update、delete 会更新版本号,是当前读(当前版本)。
我们下篇来讲 MVCC。
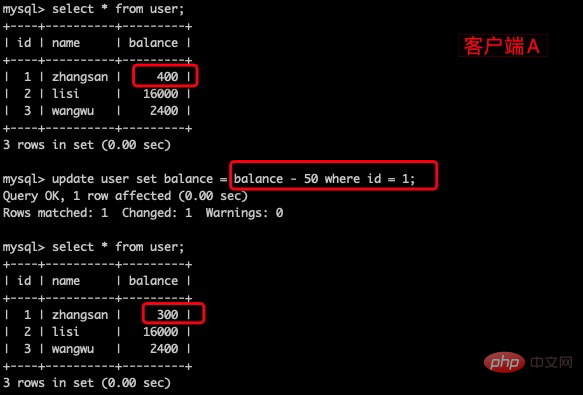
(5)重新打开客户端B,插入一条新数据后提交。
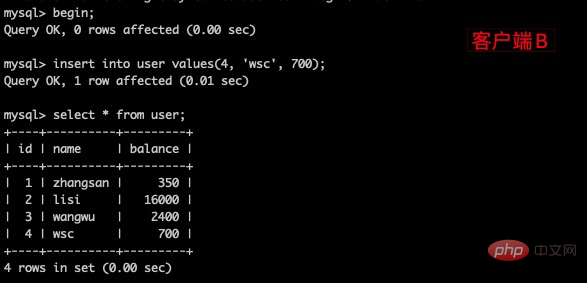
(6)在客户端A查询表user 的所有记录,没有查出新增数据,所以没有出现幻读。
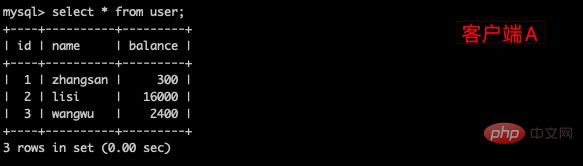
(7)验证幻读在客户端A执行 update user set balance = 8888 where id = 4; ,能更新成功,再次查询到客户端B新增的数据。
串行化
(1)打开一个客户端A,并设置当前事务模式为 serializable ,查询表 user 的初始值
set tx_isolation='serializable';复制代码
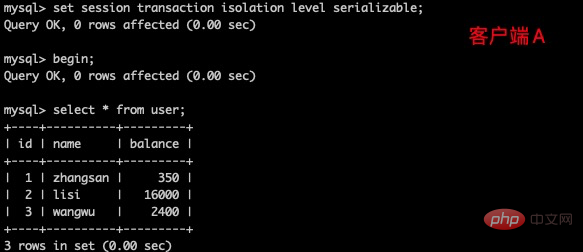
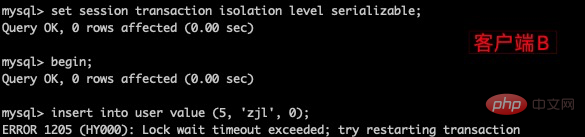
(2)打开一个客户端B,并设置当前事务模式为 serializable ,插入一条记录报错,表被锁了插入失败,MySQL 中事务隔离级别为 serializable 时会锁表,因此不会出现幻读的情况,这种隔离级别并发性极低,开发中很少会用到。
案例结论
InnoDB 存储引擎由于实现了行级锁定,虽然在锁定机制的实现方面所带来的性能损耗可能比表级锁定会更高一下,但是在整体并发处理能力方面要远远优于 MyISAM 的表级锁定的。当系统并发量最高的时候,InnoDB 的整体性能和 MyISAM 相比就会有比较明显的优势。
但是,InnoDB 的行级锁定同样也有其脆弱的一面,当我们使用不当的时候,可能会让 InnoDB 的整体性能表现不仅不能比 MyISAM 高,甚至可能会更差。
行锁分析
通过检查 innodb_row_lock 状态变量来分析系统上的行锁的竞争情况:
show status like 'innodb_row_lock%';复制代码
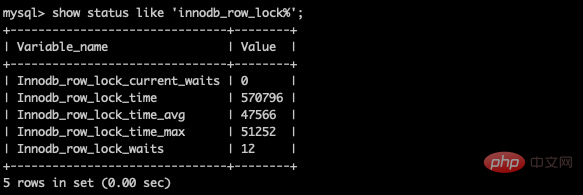
对各个状态量的说明如下:
Innodb_row_lock_current_waits :当前正在等待锁定的数量Innodb_row_lock_time :从系统启动到现在锁定总时间长度Innodb_row_lock_time_avg :每次等待所花平均时间Innodb_row_lock_time_max :从系统启动到现在等待最长的一次所花时间Innodb_row_lock_waits :系统启动后到现在总共等待的次数
对于这5个状态变量,比较重要的主要是:
Innodb_row_lock_time_avg (等待平均时长)Innodb_row_lock_waits (等待总次数)Innodb_row_lock_time(等待总时长)
尤其是当等待次数很高,而且每次等待时长也不小的时候,我们就需要分析系统 中为什么会有如此多的等待,然后根据分析结果着手制定优化计划。
死锁
set tx_isolation='REPEATABLE-READ';复制代码
Session_1执行:select * from user where id=1 for update;Session_2执行:select * from user where id=2 for update;Session_1执行:select * from user where id=2 for update;Session_2执行:select * from user where id=1 for update;复制代码
查看近期死锁日志信息:
show engine innodb statusG;复制代码
大多数情况mysql可以自动检测死锁并回滚产生死锁的那个事务,但是有些情况 mysql没法自动检测死锁
优化建议
尽可能让所有数据检索都通过索引来完成,避免无索引行锁升级为表锁;合理设计索引,尽量缩小锁的范围;尽可能减少检索条件范围,避免间隙锁;尽量控制事务大小,减少锁定资源量和时间长度,涉及事务加锁的sql尽量放在事务最后执行;尽可能低级别事务隔离。
问答
MySQL 默认级别是 repeatable-read,有什么办法可以解决幻读妈?
间隙锁(Gap Lock)在某些情况下可以解决幻读问题,它是 Innodb 在 可重复读 提交下为解决幻读问题时引入的锁机制。要避免幻读可以用间隙锁在Session_1 下面执行 update user set name = 'hjh' where id > 10 and id <= 20; ,则其他 Session 没法在这个范围锁包含的间隙里插入或修改任何数据。
如:user 表有3条数据, id > 2 and id <=3 会把第三条记录锁住,其他会话对则无法对第三条记录做操作。
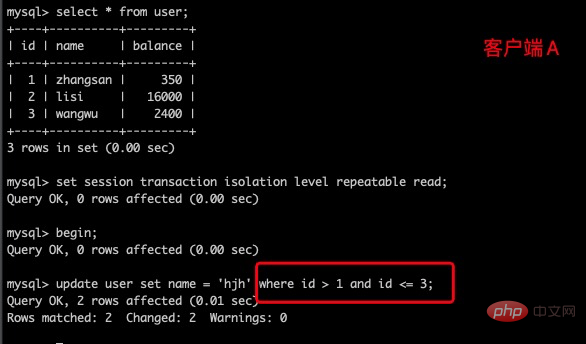
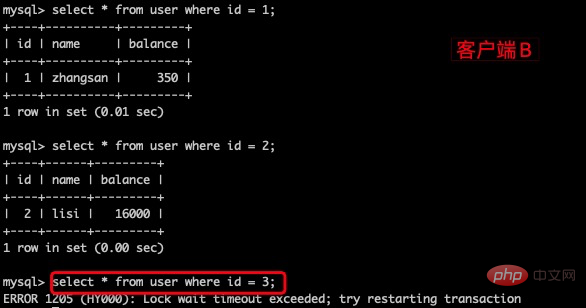
无索引锁会升级为表锁,锁主要是加在索引上,如果对非索引字段更新,行锁可能会变变锁。
客户端A执行: update user set balance = 800 where name = 'zhangsan';
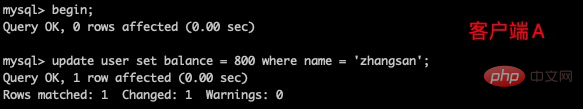
客户端B对该表任一行执行修改、删除操作都会阻塞

InnoDB 的行锁是针对索引加的锁,不是针对记录加的锁。并且该索引不能失效,否则都会从行锁升级为表锁。
锁定某一行还可以用 local in share mode(共享锁) 和 for update(排它锁) ,例如: select * from test_innodb_lock where a = 2 for update; 这样其他 session 只能读这行数据,修改则会被阻塞,直到锁定行的 session 提交。
以上就是你知道MySQL锁与事物隔离级别吗?的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/357993.html
 微信扫一扫
 支付宝扫一扫