Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜

scaling law 撞墙?复旦团队大模型推理新思路:two-player架构打破自我反思瓶颈

AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com

在 AI 领域,近期的新闻焦点无疑是关于「Scaling Law 是否撞墙?」的辩论。这一曾经被视作大模型发展的第一性原理,如今却遭遇了挑战。在这样的背景下,研究人员开始意识到,与其单纯堆砌更多的训练算力和数据资源,不如让模型「花更多时间思考」。以 OpenAI 推出的 o1 模型为例,通过增加推理时间,这种方法让模型能够进行反思、批评、回溯和纠正,大幅提升了推理表现。

但问题在于,传统的自我反思(Self-Reflection)和自我纠正(Self-Correction)方法存在明显局限 —— 模型的表现往往受制于自身能力,缺乏外部信号的引导,因此容易触及瓶颈,止步不前。

可图大模型 可图大模型

可图大模型(Kolors)是快手大模型团队自研打造的文生图AI大模型

可图大模型 32 查看详情 可图大模型

Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈

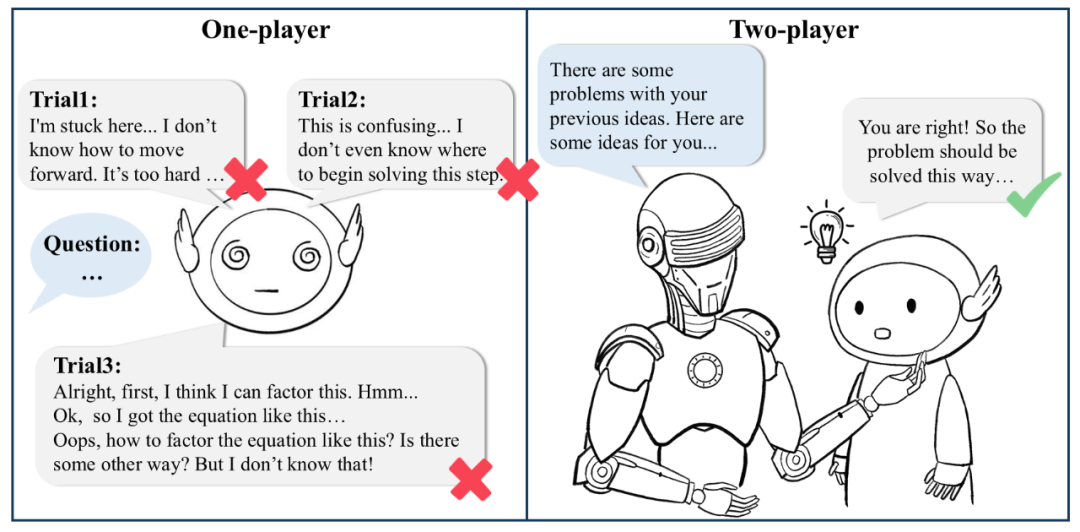
                                单一模型在传统自我纠正与自我优化时往往难以纠正自身,而双模型协作架构下能够获得更有建设性的建议。
针对这些挑战,复旦 NLP 研究团队提出了一种全新的双模型协作架构(Two-Player Paradigm)。简单来说,就是让评判模型(Critique Model)参与到行为模型(Actor Model)的推理过程中 —— 行为模型专注推理,评判模型则以步骤级别的反馈为行为模型指路。
这种设计打破了传统依赖于单一模型的限制,也让行为模型能够在训练和推理阶段实现自我改进。更重要的是,整个框架无需依赖模型蒸馏过程(例如直接模仿 o1 的思考过程),而是通过多模型协作互动获得了高质量、可靠的反馈信号,最终实现性能随计算投增大的不断提升。
在这篇工作中,研究团队聚焦以下四个核心内容:
如何自动化构建 critique 数据集,训练高效、可靠的评判模型(Critique Model);
使用评判模型推动测试阶段的扩展(Test-time Scaling);
通过交互协作提升行为模型的训练性能(Training-time Scaling);
基于 critique 数据的 Self-talk 帮助模型自我纠错。
作者们提出了一个创新性框架 ——AutoMathCritique,可以自动生成步骤级别的反馈(step-level feedback),并基于此构建了名为 MathCritique-76k 的数据集,用于训练评判模型。进一步,研究团队深入探讨了评判模型在测试阶段助力推理性能的机制,并通过引入双模型协作架构 Critique-in-the-Loop,有效缓解了模型探索与学习的自训练过程中常见的长尾分布问题,为复现 OpenAI o1 深度推理表现开辟了新的可能性。
Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈
论文题目:Enhancing LLM Reasoning via Critique Models with Test-Time and Training-Time Supervision
论文地址:http://arxiv.org/abs/2411.16579
项目主页:https://mathcritique.github.io/
代码仓库:https://github.com/WooooDyy/MathCritique
数据仓库:https://huggingface.co/datasets/MathCritique/MathCritique-76k
本工作部分实验基于昇腾 910 完成
AutoMathCritique
自动化、可扩展地构造步骤级 Critique 数据
为了研究 Critique 模型在架构中的作用与性能,作者们首先训练了一个可靠的 Critique 模型。鉴于步骤级别反馈数据的稀缺,作者们提出了一种新的框架 AutoMathCritique,用于自动化构造多样性推理数据,并获得步骤级别的反馈。
Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈
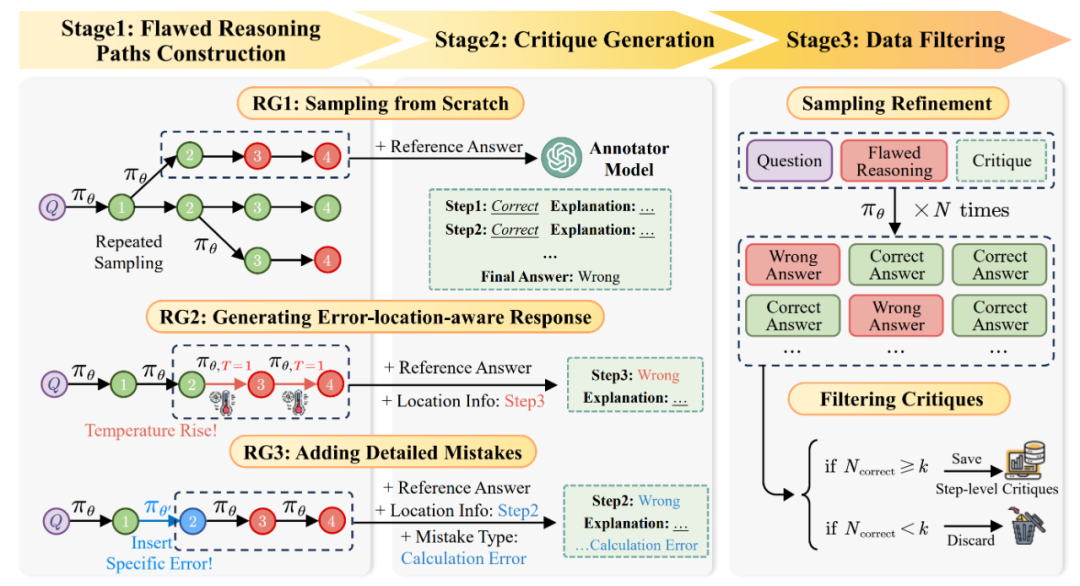
AutoMathCritique 流程:通过多种方式收集错误数据与错误信息,并交由标注模型进行步骤级别标注。在标注完相应问答反馈对后,交由 Actor 模型进行进一步筛选。
图中,第一个阶段「构建错误推理路径」包含三种策略:
RG1: 直接构建整体推理路径,在高温度下让 Actor 模型进行重复采样,采样出的数据只会包含最终答案的错误信息;
RG2: 以某一条推理路径为模板,在特定的推理步后逐渐提高温度,让 Actor 模型采样出新的轨迹,采样出的数据会包含最终答案的错误信息与错误步骤的位置信息;
RG3: 以某一条推理路径为模板,对特定的推理步插入多样化错误内容,让 Actor 模型继续采样出完整轨迹,采样出的数据会包含最终答案的错误信息与错误步骤的位置与错误信息。
第二个阶段「标注步骤级别反馈」提供了详细的反馈数据:为了更好的提升反馈数据的质量,研究人员将第一阶段获得的各类错误信息交由标注模型,并提供参考答案、错位定位和错误类型信息作为辅助,帮助标注模型提供步骤级别的反馈。
第三个阶段「精筛反馈」筛选出更加高质量的数据:为了进一步筛选出能够更好帮助 Actor 模型的数据,研究人员将错误推理路径与反馈数据一起输入给 Actor 模型,根据其修改后答案的正确率决定是否保留。
Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈
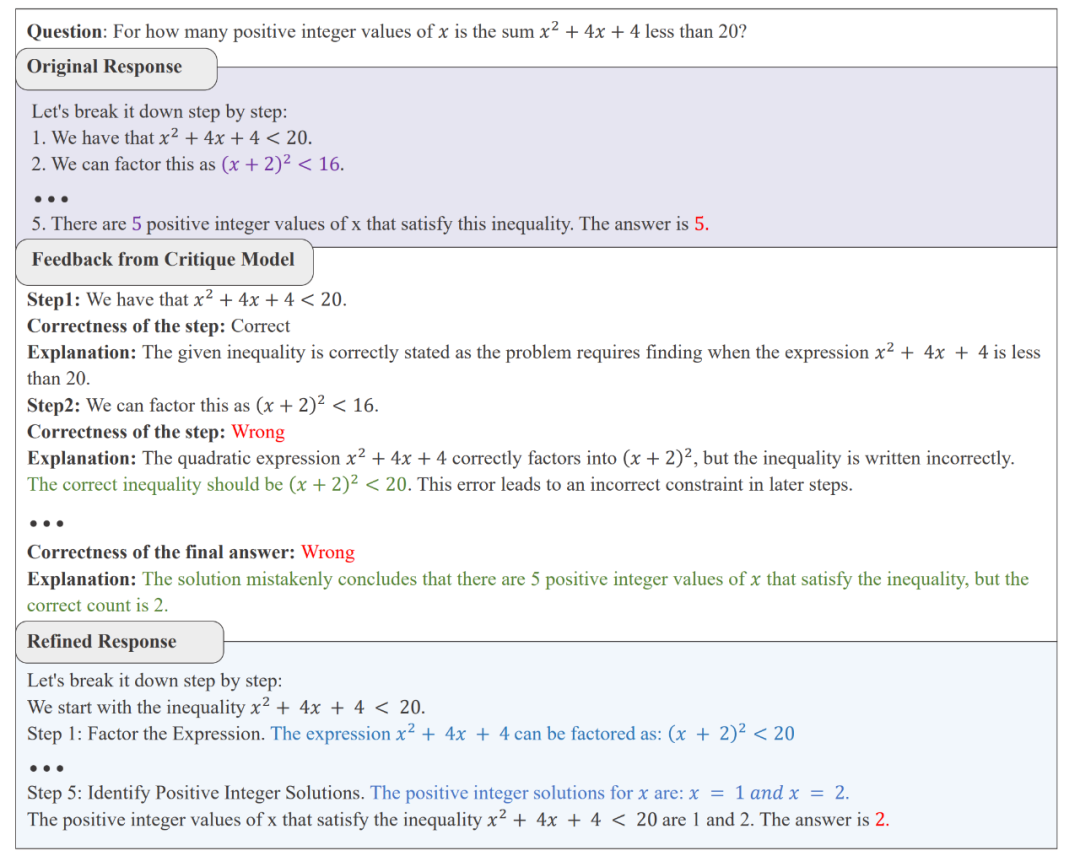
                                AutoMathCritique 收集到的信息示例
通过如上方案构建的数据既包含模型本身所可能犯下的错误,又构建了域外错误,使 Critique 模型能够学习大批量、多样化错误数据。而步骤级别的反馈数据使得 Actor 模型能够更好的定位自己所犯下的错误,进而提升修改的质量。
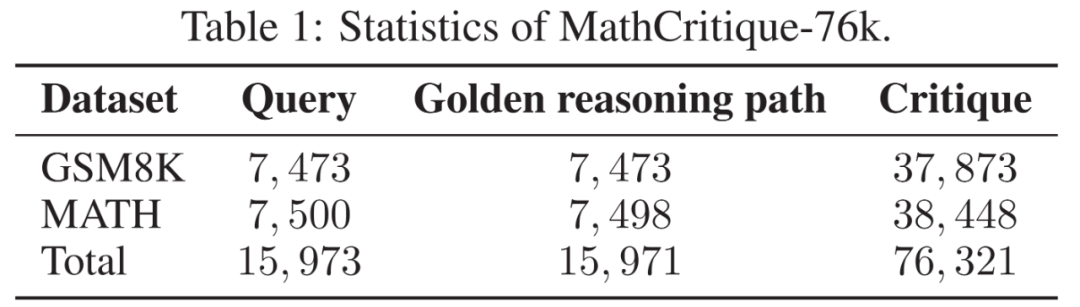
使用如上框架,研究团队构建了一个拥有 76k 数据量的数据集 MathCritique-76k,其中既包含了正确推理轨迹又包含了自动化合成的错误轨迹,并且筛选了优质的步骤级别反馈数据用于之后的训练。
Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈
                                MathCritique-76k 的数据构成
Critique 模型如何帮助 Actor 模型提高测试性能?
实验探究:Critique 模型在测试时对 Actor 模型的帮助
基于如上构建的数据集,作者以 Llama3-Instruct 系列为基座模型,微调了一个专门用于提供步骤级别反馈的 Critique 模型。其选取了常用的数学推理数据集 GSM8K 与 MATH 为测试对象,进行了多种实验。
1.  Critique 模型对错误的识别率与对 Actor 模型的帮助
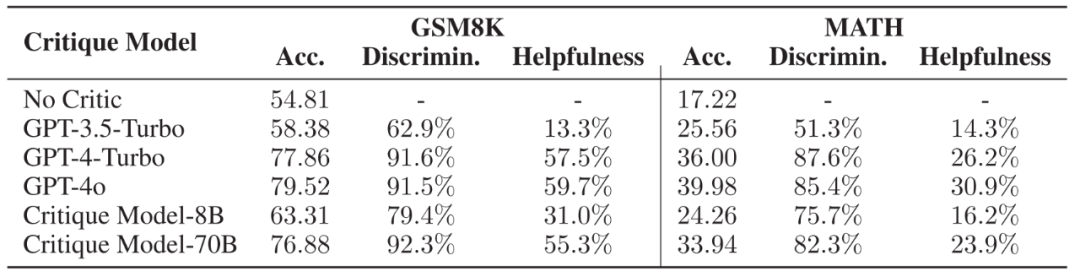
Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈不同 Critique 模型的推理轨迹正误判断能力与对 Actor 模型的帮助,Acc. 代表 Actor 模型在不同 Critique 模型的帮助下能够达到的正确率。
作者选取了两个微调后的模型与 SOTA 模型作为研究对象,发现 Critique 模型能够极为有效地识别出推理轨迹的正确与否,并且其所提供的步骤级别反馈能够被 Actor 模型所用,使得 Actor 模型能够显著改进自己的错误,以达到更高的正确率。
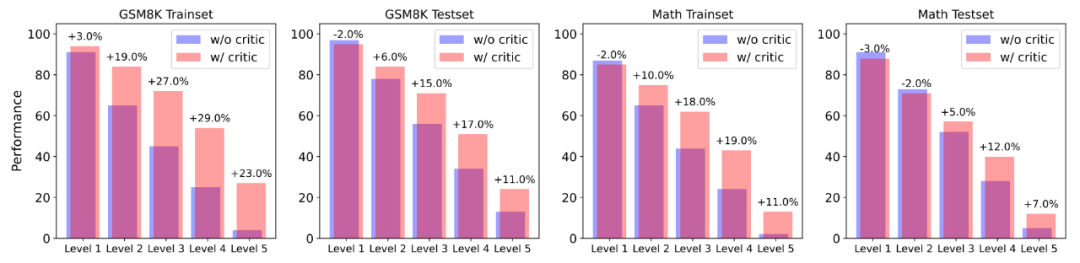
为了更进一步探究 Actor 模型是如何受到帮助的,作者将数据集按照 Actor 模型初始的正确率分为了 5 个难度,并且比较在不同难度下,有无反馈数据对模型回答正确率的影响。
Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈
             以 Actor 模型正确率(采样 100 次)作为难度分级的指标,使用 Critique 模型的反馈数据能在更高难度题目下获得更大的帮助。
研究发现 Actor 模型在几乎各个难度下,正确率均有所提升。而且在难度级别较高的题目中,Actor 模型均收到了更大的帮助,表现为正确率的显著提升。这说明,使用 Critique 模型帮助 Actor 模型改进其所不会的难题,可以是解决自我提升长尾分布难题的新方法。
2. 在 Critique 模型帮助下增加推理计算投入的性能
Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈
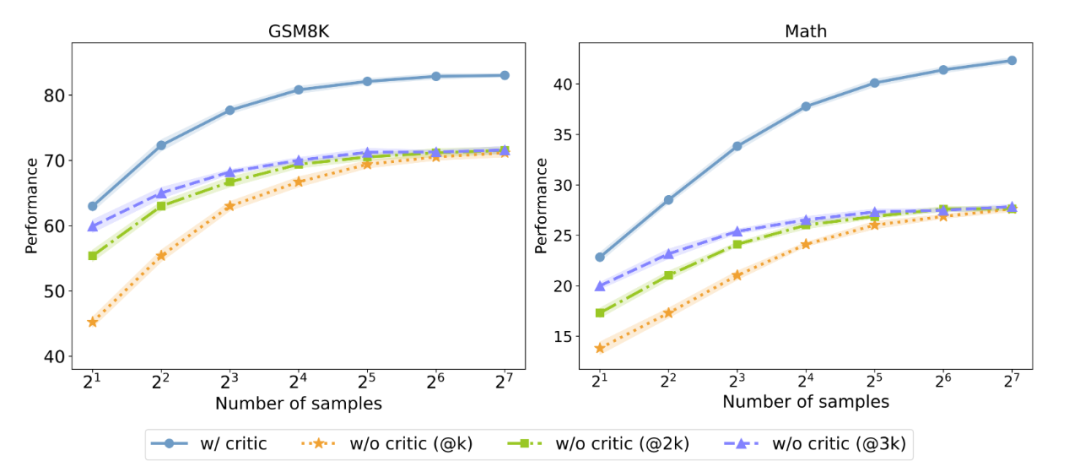
                         有无反馈数据对测试时 Majority voting 性能的影响,@3K 代表采样数量为横坐标的三倍,以控制采样消耗相同。
研究人员进一步探究 Critique 模型能否在测试时提高 Actor 模型性能。他们以并行 Majority voting 的结果作为测试指标,发现即使在控制了相同的采样消耗的情况下,拥有反馈数据依旧能够显著超过没有反馈数据的 Actor 模型。这说明,加入 Critique 模型可以作为实现 Test-time Scaling 的新方法之一。
Critique 模型如何帮助 Actor 模型探索与学习?
基于以上在 Test-time 的发现,研究人员将测试阶段所展现出来的优势用于训练阶段(Training-time)的探索与学习(Exploration & Learning),进一步探究 Critique 模型能否帮助 Actor 模型在训练时进行自我优化。为此,他们提出了一个有难度感知的双模型协作优化架构 Critique-in-the-loop Self-Improvement,用于获得更高质量、多样化的数据,并缓解自我优化采样时的长尾难题。
Critique-in-the-loop Self-Improvement:有难度感知的双模型协作优化架构
Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈
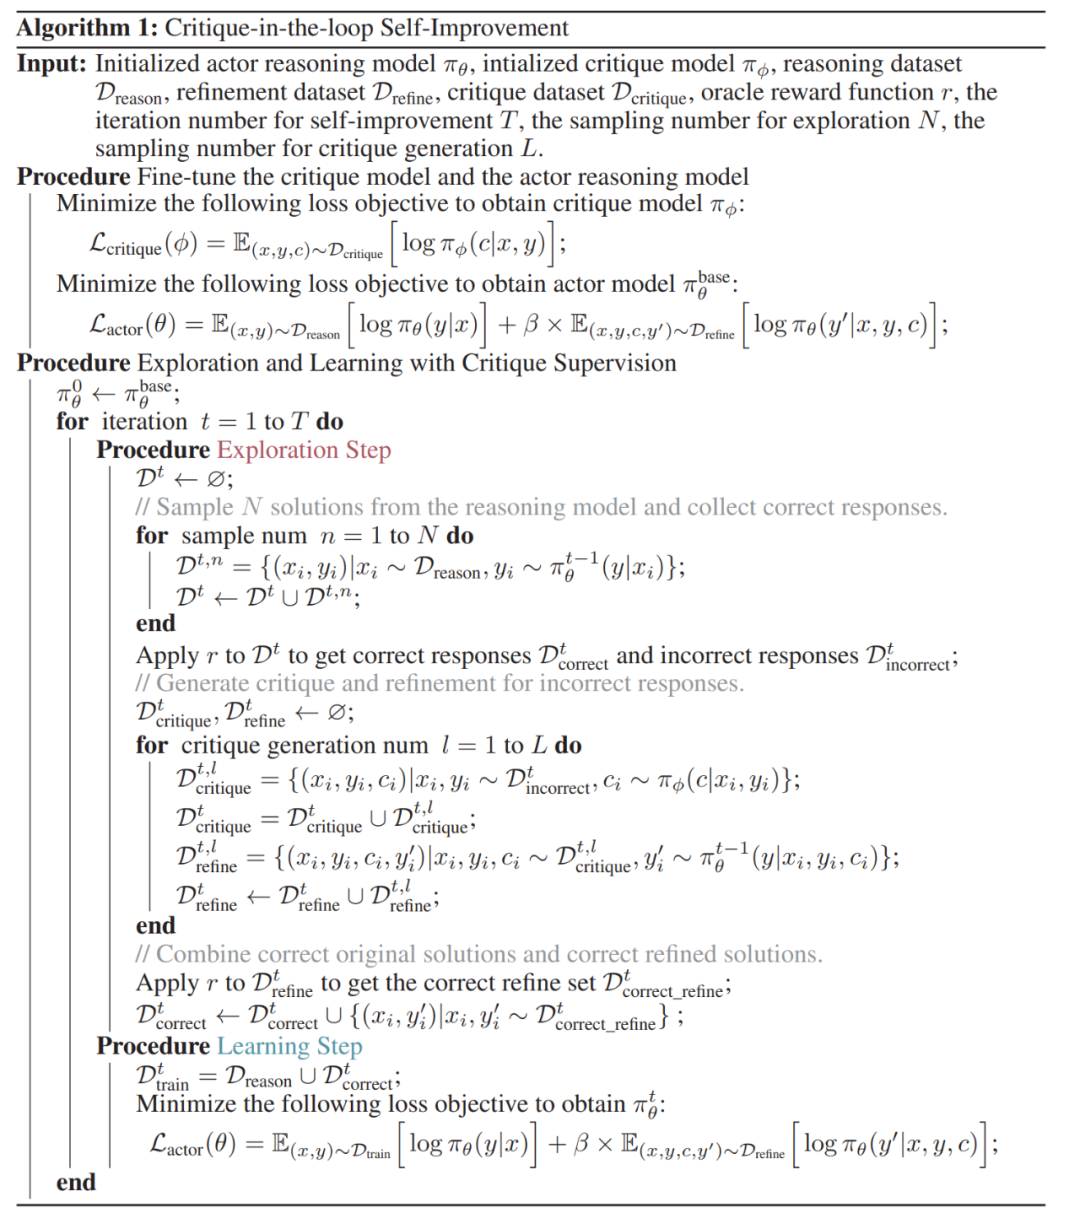
                                Critique-in-the-loop Self-Improvement 算法伪代码
研究人员提出了一种双模型协作优化架构。在第一次采样时,Actor 模型会在训练集上重复多次采样。针对错误数据,研究人员使用 Critique 模型辅助 Actor 模型进行多次自我修正,从而达到了难度感知的目的。每一轮迭代时,Actor 模型总会学习正确的数据,从而实现自我提升。
实验探究:Critique 模型在训练时对模型性能的影响
1. Critique-in-the-loop 能够有效帮助模型自我提升
Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈
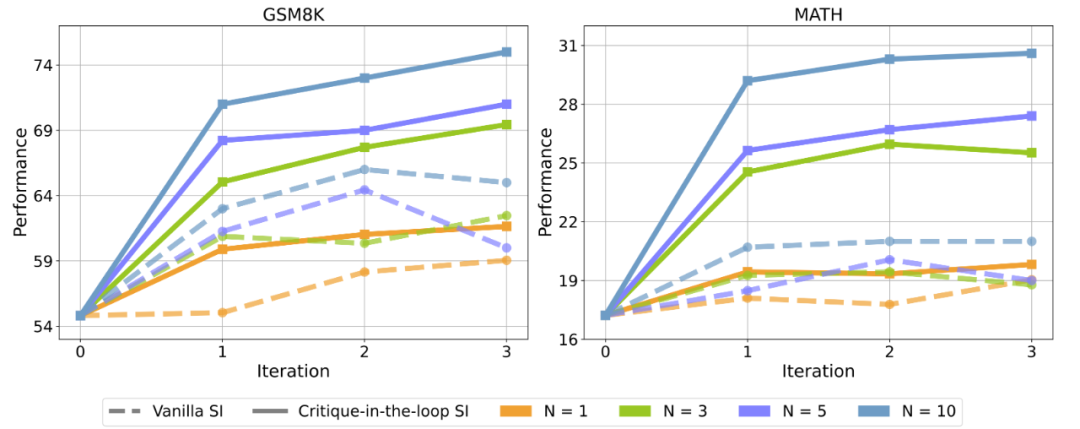
相比于在训练阶段只使用 Actor 模型进行采样(Vanilla SI), 使用 Critique 模型后,Actor 模型在测试集正确率上均有显著提升。图中 N 代表采样次数。
实验发现,Vanilla Self-Improve 尽管能在一定程度上提升模型的性能,然而其很快达到瓶颈,甚至开始出现性能的下滑。但是 Critique-in-the-loop 能够显著改善这一情况,既使得模型的自我提升较为稳定,又能够在多个采样次数下获得相当显著的性能提升。研究人员认为,这与长尾分布难题的缓解密不可分。
2. Critique-in-the-loop 能够缓解长尾分布难题
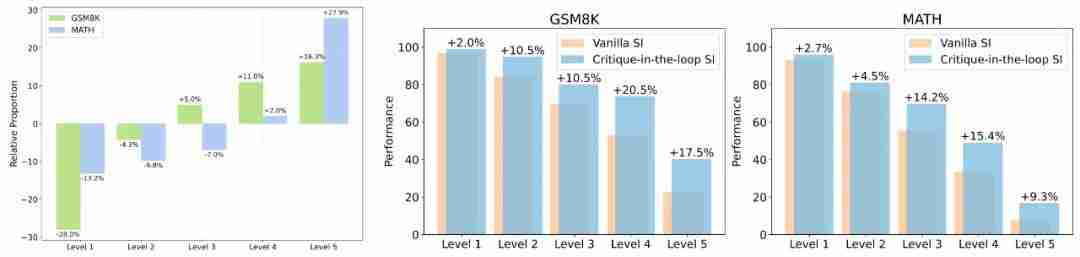
为了进一步证实长尾分布难题获得了缓解,研究人员进一步探究在训练时,不同难度问题的训练数据占总体数据集的比例。
Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈
图 1:相比于 Vanilla SI、Critique-in-the-loop 在不同难度问题中采样出的训练数据比例变化。图 2、图 3:两者在测试集中,不同难度问题的性能表现比较。
实验发现,Critique-in-the-loop 能够更有效地平衡不同难度问题占总体数据集的占比。值得注意的是,难度较高的问题所占的比例出现显著上升,证实了长尾分布难题得到缓解。与此同时,研究团队还分析了测试集上不同难度问题的性能表现。实验结论也说明,在较难问题上模型展现出性能的显著提高。
3. 在测试时使用 Critique 模型,Critique-in-the-loop 能够带来更大的提升
Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈
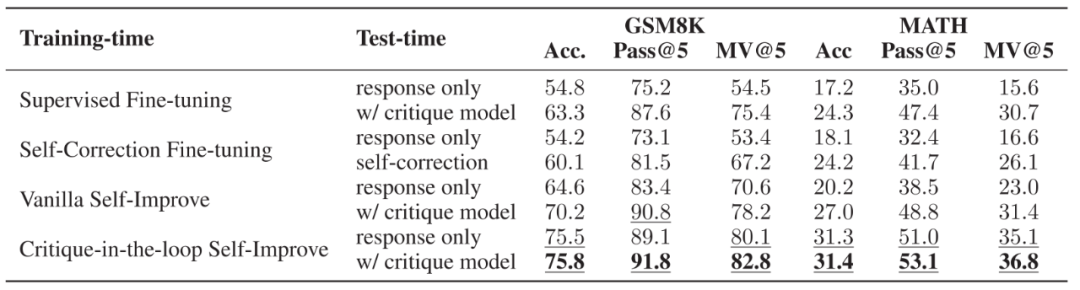
不同训练策略与测试策略的性能性能。训练时,使用了直接微调推理与有反馈的纠正数据,直接微调推理与自我纠正数据,无 Critique 模型的自我提升以及有 Critique 模型的自我提升四种方式。测试时,比较了是否使用 Critique 模型两种方式。
鉴于作者之前所提到的训练与测试时 Critique 模型的好处,作者进一步分析了两者结合后的效果。实验发现当使用 Critique-in-the-loop 时,在测试阶段使用 Critique 模型带来的性能提升较小,说明 Critique 模型所带来的性能提升已经被融入到了推理模型中。尽管如此,相比于其他训练方案,其性能依旧有显著优势。
深入分析 Critique Models
实验探究:Critique 模型扩展性(Scaling Properties)
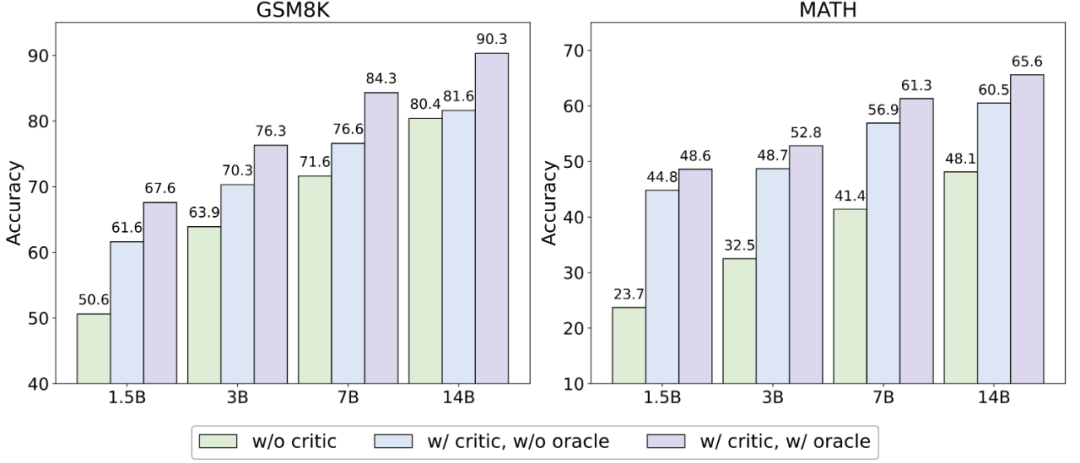
为了探究 Critique 模型是否对多种模型——尤其是那些模型大小与性能高于自己的 Actor 模型——做到相类似的帮助,作者固定 Critique 模型为 3B 大小的 Qwen-2.5 模型,并使用不同模型大小的 Qwen-2.5 系列模型(1.5B、3B、7B、14B)作为 Actor 模型进行了实验。
Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈
  不同模型大小的 Actor 模型在测试赛上正确率表现。其中 w/o critic 代表不使用 Critique 模型,w/orcale 代表仅对原始回答错误的数据进行修正。
实验结论发现,无论何种模型大小, Critique 模型的存在均能显著提升模型测试性能。然而,在较为简单的数据集 GSM8K 上,更大的模型获得的帮助不如较小的模型;但在较为困难的数据集 MATH 上,性能的提升依旧显著。
实验探究:Critique 模型对 Majority Voting 性能的影响
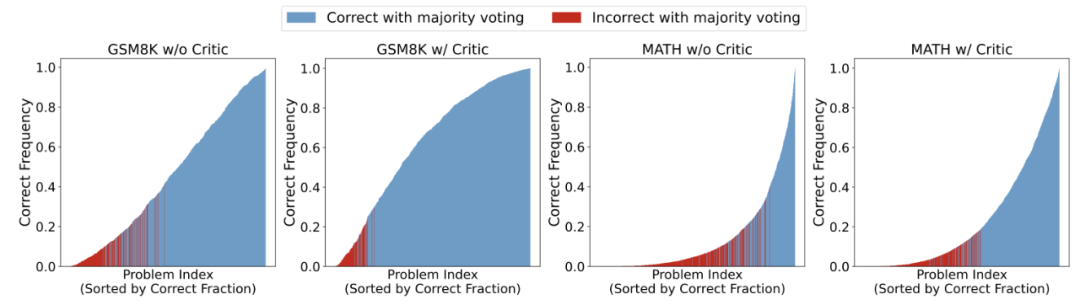
作者进一步探究 Critique 模型对 Majority Voting 性能的影响,探究当采样次数更大时的表现。
Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈
        对 Actor 模型采样 1000 次后的性能图,问题按照通过率由低到高进行排序,其中红色部分表示该问题在 Majority Voting 下依旧做错。
研究发现,拥有 Critique 模型的情况下,Actor 模型在整体上提高了问题的正确率,从而带来了 Majority Voting 的稳定性。另外,作者们还发现,不使用 Critique 模型时,尽管 Actor 模型会给出占比较多的正确答案,然而非正确答案却拥有更高的占比;而拥有 Critique 模型时, Actor 模型最终修改给出的答案更为一致,使得正确答案的占比会超过某些出现频率较高的错误答案,帮助模型能够更好的选出正确答案。
实验探究:不同计算投入策略对性能的影响
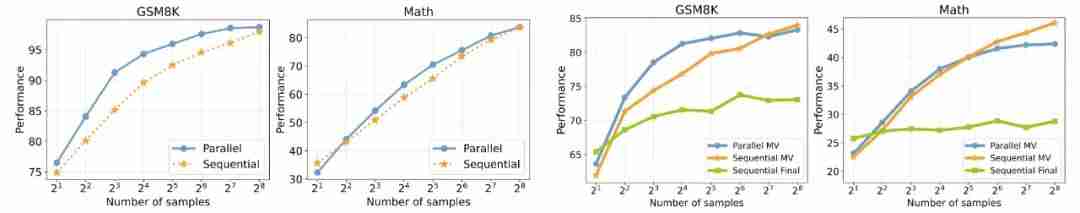
作者继续探讨了多种计算提升消耗策略下 Actor 模型的表现。实验使用了并行采样与线性采样两种方式,并且比较了 Pass@k、Majority Voting 以及 Sequential Final(仅选取最终答案)三种方式。
Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈
图 1 及图 2:线性与并行采样策略下,模型的 Pass@k 表现;图 3 及图 4:不同采样策略下模型的 Majority voting 表现。横坐标表示采样样本的数量
实验结果发现,在 Pass@k 的设定下,线性采样的表现略低于并行采样,这可能源于并行采样会带来更多样化的答案选择。而在模型需要给出答案的设定下,仅选取最终答案并不如 Majority voting 的表现要好,强调了内在一致方式的重要性;随着采样次数的提高,线性采样的性能超过了并行采样的方式,这有可能源于当采样次数足够大时,并行采样带来的多样性答案可能有害于最终的性能表现,而线性采样通过反复修改一个回答,使得结果更加稳定。
A Step Further
基于 Critique 数据构建 Self-talk 模型帮助自我纠错
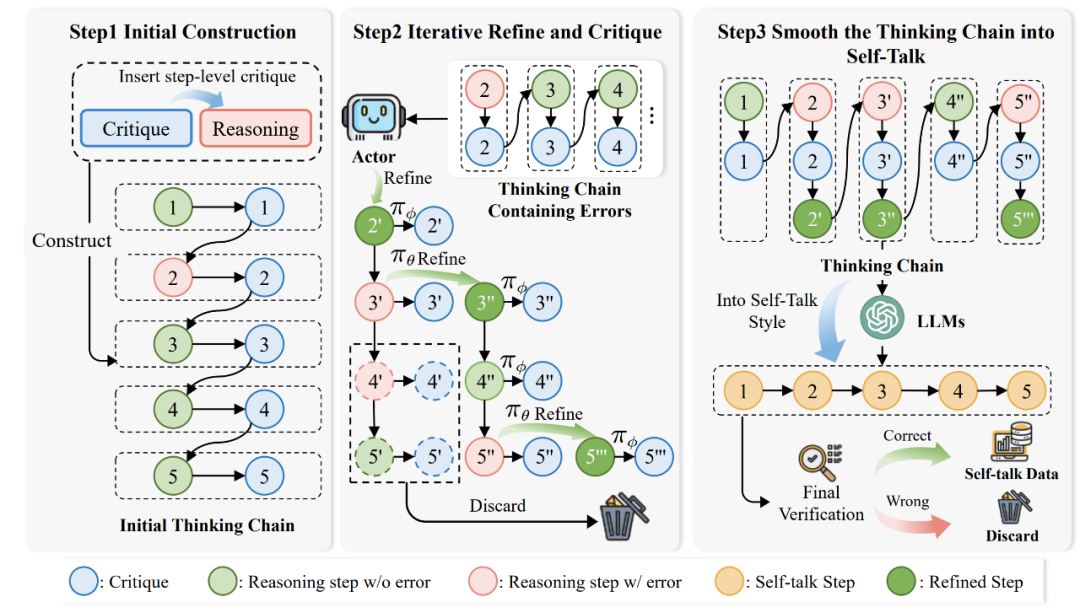
最后,受到 OpenAI o1 模型的推理启发,研究人员进一步探究 Self-talk 形式帮助模型自我纠错的可能性。Self-talk 形式帮助模型在每一个推理步骤后立刻开始反思与改进,而不必等整个轨迹生成完之后再进行改进。
Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈
                             Self-talk 形式数据构建示意图
图中,第一个阶段用于「构建初始反馈数据」。研究人员使用 AutoMathCritique 框架构建步骤级别的反馈数据,并加入到推理路径中,形成初始的思维链。
第二个阶段用于「循环修正错误思考链」。第一阶段中的数据存在着错误的推理路径,研究人员使用 Critique 模型帮助 Actor 模型生成新的推理路径,并将反馈数据同样加入到推理路径中逐步生成思维链,直到整个推理路径没有错误为止。
第三个阶段用于「优化思考链为 Self-talk 形式」。前两阶段得到的思考链较为生硬,因此研究人员进一步使用模型优化思维链,使其变为自然的 Self-talk 形式,并保证了最终答案的正确性。
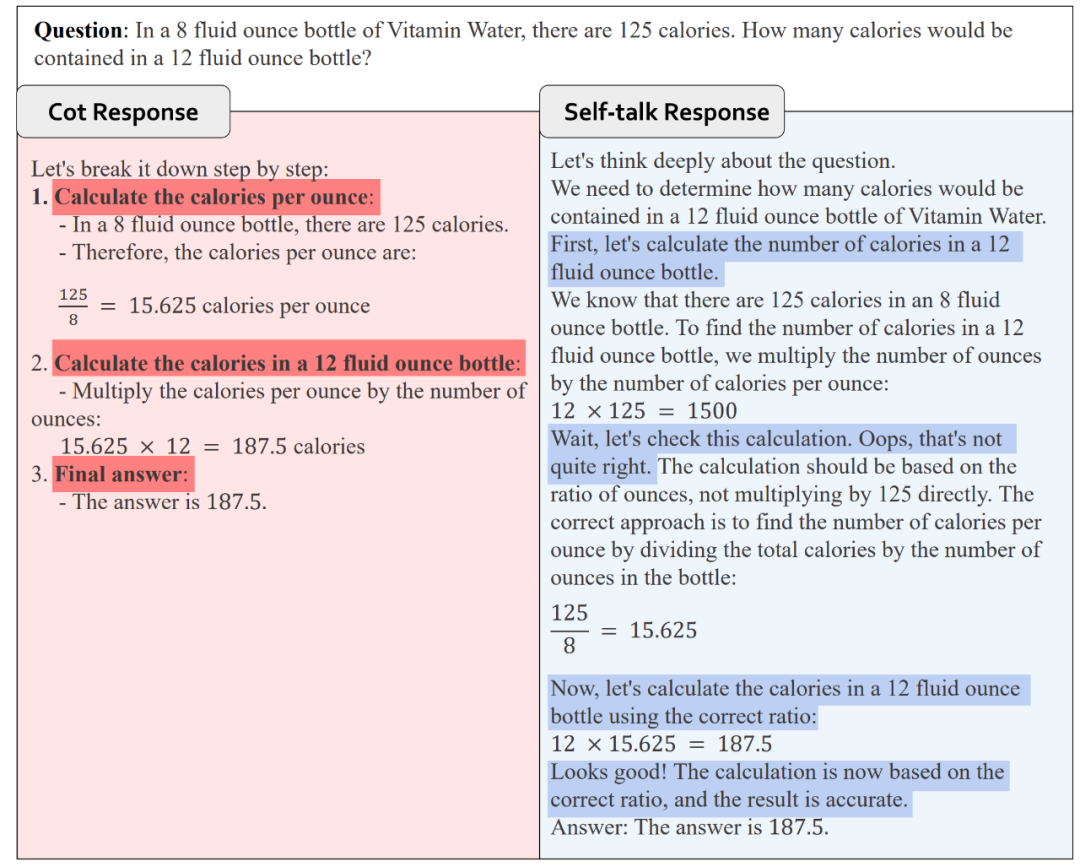
Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈
                                  Self-talk 形式数据示例
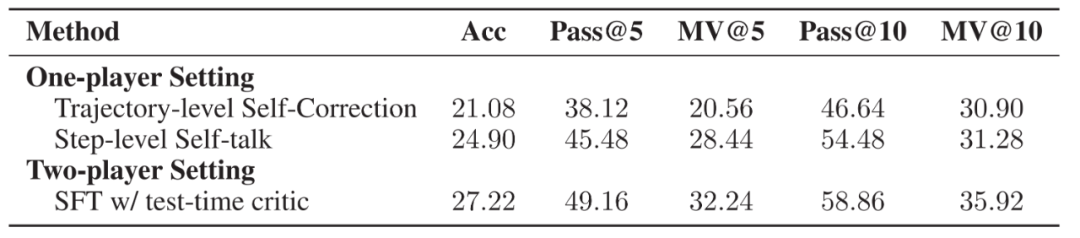
使用如上构建的数据,研究人员训练了一个 Self-talk 模型。初步实验发现,相比于轨迹级别的自我改进,Self-talk 格式能够显著改善模型性能。尽管表现不如所提出的双模型合作架构,然而这也揭示了其潜能所在。
Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈
在 MATH 数据集上三种方法的各种指标,分别使用轨迹层面的自我改进,步骤层面的自我对话改进以及双模型协作架构。实验比较了正确率、Pass@k 和 MV@k 三个指标。
总结
本文的主要贡献包括:
提出自动化构造步骤级别 Critique 的框架 AutoMathCritique;
探究 Critique 模型对于 Actor 模型在推理时的帮助;
提出拥有难度感知方式的自我改进框架 Critique-in-the-loop Self-Improvement,缓解长尾难题;
探究测试时的各种 Scaling 策略,包括模型大小,采样策略与采样数量等方面。
更多关于方法、实验的细节,敬请参考论文原文。

以上就是Scaling Law 撞墙?复旦团队大模型推理新思路:Two-Player架构打破自我反思瓶颈的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/404730.html
赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
什么是Java多态?如何实现Java多态?[通俗易懂]
上一篇 2025年11月6日 20:44:22
磁力狐快速登录入口 磁力狐搜索最新网址链接
下一篇 2025年11月6日 20:44:51

相关推荐

  • ​Luma AI 发布 Ray3:首款支持 HDR 视频生成的创新模型

    ​Luma AI 发布 Ray3:首款支持 HDR 视频生成的创新模型​Luma AI 发布 Ray3:首款支持 HDR 视频生成的创新模型​Luma AI 发布 Ray3:首款支持 HDR 视频生成的创新模型​Luma AI 发布 Ray3:首款支持 HDR 视频生成的创新模型

    Luma AI 近日发布了全新的视频生成模型 Ray3,宣称这是业界首个能够生成专业级 HDR(高动态范围)视频的AI模型。该模型支持10位、12位乃至16位色深,并可输出EXR格式文件,便于直接融入专业的后期制作、调色及视觉特效流程。同时,Ray3还具备将普通SDR视频内容转换为HDR的能力,为创…

    2026年9月30日 • 用户投稿
    000
  • 使用 HashMap 优化嵌套循环:Java 对象数组转换

    使用 HashMap 优化嵌套循环:Java 对象数组转换使用 HashMap 优化嵌套循环:Java 对象数组转换使用 HashMap 优化嵌套循环:Java 对象数组转换使用 HashMap 优化嵌套循环:Java 对象数组转换

    本文旨在提供一种使用 HashMap 优化 Java 中嵌套循环的有效方法,特别是当循环涉及对象数组并进行相等性检查时。通过将内部循环转换为 HashMap 查询,可以显著降低时间复杂度,提高代码性能。本文将提供详细的步骤和示例代码,帮助读者理解和应用这种优化技巧。 在处理包含嵌套循环的 Java …

    2026年9月30日 • 用户投稿
    100
  • 智现未来联合晶合集成荣获爱分析“AI Agent最佳实践案例奖”

    智现未来联合晶合集成荣获爱分析“AI Agent最佳实践案例奖”智现未来联合晶合集成荣获爱分析“AI Agent最佳实践案例奖”智现未来联合晶合集成荣获爱分析“AI Agent最佳实践案例奖”智现未来联合晶合集成荣获爱分析“AI Agent最佳实践案例奖”

    近日,爱分析在北京举办了以“技术鼎新,场景跃迁”为主题的第三届ai大模型高峰论坛,重点探讨如何推动人工智能从“技术惊艳”迈向“商业爆发”,助力企业实现效率与价值的跨越式提升。 由智现未来与晶合集成联合打造的“大模型驱动的半导体晶圆制造智能体应用”成为大会焦点。该项目在半导体等高端制造领域实现了核心技…

    2026年9月30日 • 用户投稿
    100
  • Java代码无报错但无法运行:二进制转十进制的常见陷阱与解决方案

    本文旨在帮助Java初学者解决代码无报错但无法正常运行的问题,特别是针对二进制转换为十进制的场景。通过分析常见错误原因,例如误用取余运算符,提供详细的调试方法和修正后的代码示例,帮助读者理解并掌握正确的二进制转换逻辑,避免程序进入死循环,确保代码的正确执行。 在Java编程中,有时会遇到代码没有报错…

    2026年9月30日
    100
  • 中山大学:张溢副教授课题组利用原位透射电子显微镜在负电容效应的畴动力学方面取得新进展

    中山大学:张溢副教授课题组利用原位透射电子显微镜在负电容效应的畴动力学方面取得新进展中山大学:张溢副教授课题组利用原位透射电子显微镜在负电容效应的畴动力学方面取得新进展中山大学:张溢副教授课题组利用原位透射电子显微镜在负电容效应的畴动力学方面取得新进展中山大学:张溢副教授课题组利用原位透射电子显微镜在负电容效应的畴动力学方面取得新进展

    随着传统晶体管不断小型化,“功耗墙”问题日益突出,难以突破,摩尔定律正面临失效的风险,亟需在器件结构和工作机制方面实现创新。铁电材料所具备的负电容效应有望打破玻尔兹曼电子分布带来的限制,为降低功耗提供新路径。然而,由于负电容效应具有瞬态性和不稳定性,其背后的铁电畴动力学机制尚不清楚,阻碍了该领域的深…

    2026年9月30日 • 用户投稿
    100
  • 升级长江存储PC450固态硬盘 机械革命耀世16 Ultra图赏

    升级长江存储PC450固态硬盘 机械革命耀世16 Ultra图赏升级长江存储PC450固态硬盘 机械革命耀世16 Ultra图赏升级长江存储PC450固态硬盘 机械革命耀世16 Ultra图赏升级长江存储PC450固态硬盘 机械革命耀世16 Ultra图赏

    9月23日,机械革命正式推出耀世16 ultra新款机型,搭载长江存储全新pc450 ssd,替代原有的pc411版本,官方售价为8999元,参与国家补贴后实际到手价仅为6799.2元。 该新品已抵达评测室,接下来为大家带来详细图赏。 PC450是长江存储专为AI应用、游戏娱乐及日常办公等主流场景打…

    2026年9月30日 • 用户投稿
    300
  • 动态加载 Spring Beans 的最佳实践

    动态加载 Spring Beans 的最佳实践动态加载 Spring Beans 的最佳实践动态加载 Spring Beans 的最佳实践动态加载 Spring Beans 的最佳实践

    本文介绍了如何在 Spring 应用程序中基于环境动态加载不同的 Bean 实现。通过使用 @Conditional 注解和手动配置 Bean,可以根据特定条件选择性地加载 DoThingService 或 NoopService,从而避免了 Bean 冲突问题,并简化了单元测试。 在 Spring…

    2026年9月30日 • 用户投稿
    200
  • sublime如何优化前端工作流 sublime开发HTML/CSS/JS的最佳实践

    sublime如何优化前端工作流 sublime开发HTML/CSS/JS的最佳实践sublime如何优化前端工作流 sublime开发HTML/CSS/JS的最佳实践sublime如何优化前端工作流 sublime开发HTML/CSS/JS的最佳实践sublime如何优化前端工作流 sublime开发HTML/CSS/JS的最佳实践

    sublime text在前端开发中的核心优势体现在其轻量、极速、高度可定制和专注编辑的本质。1. 启动迅速,编辑流畅,适合快速修改;2. 通过package control实现强大的插件扩展,按需构建高效工作流;3. 多光标编辑、命令面板提升操作效率;4. 简洁界面减少干扰,专注代码本身;5. 跨…

    2026年9月30日 • 用户投稿
    500
  • 大模型淘汰赛,零一万物、科大讯飞和商汤们该如何突围?

    大模型淘汰赛,零一万物、科大讯飞和商汤们该如何突围?大模型淘汰赛,零一万物、科大讯飞和商汤们该如何突围?大模型淘汰赛,零一万物、科大讯飞和商汤们该如何突围?大模型淘汰赛,零一万物、科大讯飞和商汤们该如何突围?

    ai大模型:烧钱盛宴后的残酷现实,下一个倒下的会是谁? 近期,AI大模型领域风云变幻,曾经的“大模型六小虎”之一零一万物战略调整,将专注于小参数行业模型,其核心团队并入阿里,预示着这场烧钱大战的残酷性。 与此同时,MiniMax旗下海螺AI面临版权诉讼,更凸显了大模型发展面临的挑战。 不仅是创业公司…

    2026年9月30日 • 用户投稿
    200
  • 怎么用豆包AI帮我生成Vue3组合式API 3分钟学会用AI写现代前端逻辑

    怎么用豆包AI帮我生成Vue3组合式API 3分钟学会用AI写现代前端逻辑怎么用豆包AI帮我生成Vue3组合式API 3分钟学会用AI写现代前端逻辑怎么用豆包AI帮我生成Vue3组合式API 3分钟学会用AI写现代前端逻辑怎么用豆包AI帮我生成Vue3组合式API 3分钟学会用AI写现代前端逻辑

    豆包ai能高效辅助编写vue3组合式api代码,具体方法如下:1. 明确功能需求,如实现待办事项列表的添加、删除和标记完成功能;2. 让ai生成基础模板与响应式数据,使用ref创建响应式变量并封装添加逻辑;3. 细化功能,补充删除和标记完成的方法及模板事件绑定;4. 进阶优化,将逻辑抽离为自定义ho…

    2026年9月30日 • 用户投稿
    100
  • 华为与浙大携手发布 DeepSeek-R1-Safe 大模型:AI安全与性能完美平衡

    在刚刚落幕的华为全联接大会上,华为技术有限公司携手浙江大学共同发布了国内首款基于昇腾千卡算力平台打造的基础大模型——DeepSeek-R1-Safe。该模型聚焦当前人工智能领域中的安全与性能难题,标志着我国在AI安全技术研发方面迈出了关键一步。![图片](https://example.com/im…

    用户投稿 2026年9月30日
    100
  • VSCode如何实现云开发集成 VSCode连接AWS/Azure的配置指南

    VSCode如何实现云开发集成 VSCode连接AWS/Azure的配置指南VSCode如何实现云开发集成 VSCode连接AWS/Azure的配置指南VSCode如何实现云开发集成 VSCode连接AWS/Azure的配置指南VSCode如何实现云开发集成 VSCode连接AWS/Azure的配置指南

    要实现vscode云开发集成,必须安装云厂商提供的扩展并配置cli工具。1. 安装扩展:aws使用“aws toolkit”,azure安装“azure account”和“azure resources”扩展,以获得图形化管理界面。2. 配置认证信息:aws需设置access key id和sec…

    2026年9月30日 • 用户投稿
    700
  • Sublime实现数据库读写分离策略配置_适合大型高并发系统数据管理

    Sublime实现数据库读写分离策略配置_适合大型高并发系统数据管理Sublime实现数据库读写分离策略配置_适合大型高并发系统数据管理Sublime实现数据库读写分离策略配置_适合大型高并发系统数据管理Sublime实现数据库读写分离策略配置_适合大型高并发系统数据管理

    sublime text可通过配置文件、插件和中间层逻辑辅助实现数据库读写分离。1. 在配置文件中明确区分主库和从库连接信息,使用清晰命名并借助语法高亮提升可读性;2. 安装db browser for sqlite、advancednewfile等插件提升数据库开发效率;3. 在应用层编写逻辑根据…

    2026年9月30日 • 用户投稿
    200
  • java怎样使用JVM参数配置运行环境 java虚拟机调优的入门技巧

    java怎样使用JVM参数配置运行环境 java虚拟机调优的入门技巧java怎样使用JVM参数配置运行环境 java虚拟机调优的入门技巧java怎样使用JVM参数配置运行环境 java虚拟机调优的入门技巧java怎样使用JVM参数配置运行环境 java虚拟机调优的入门技巧

    配置JVM运行环境需通过命令行参数设置内存、GC策略等,如-Xms512m -Xmx2g -XX:+UseG1GC,以优化资源利用率、响应速度与稳定性,避免OOM,提升应用性能。 配置Java虚拟机(JVM)运行环境以及进行初步调优,核心在于通过命令行参数来指导JVM如何分配和管理资源,以及选择合适…

    2026年9月30日 • 用户投稿
    100
  • 如何使用Sublime预览SVG图像代码_支持矢量图动态调整和调试

    如何使用Sublime预览SVG图像代码_支持矢量图动态调整和调试如何使用Sublime预览SVG图像代码_支持矢量图动态调整和调试如何使用Sublime预览SVG图像代码_支持矢量图动态调整和调试如何使用Sublime预览SVG图像代码_支持矢量图动态调整和调试

    sublime text没有内置svg实时预览功能,需借助浏览器实现。①在sublime中编辑并保存.svg文件;②通过拖拽或本地服务器在浏览器中打开该文件查看渲染效果;③每次修改代码后保存并在浏览器刷新页面即可看到更新内容;④浏览器提供完整svg支持、开发者工具调试及兼容性测试能力;⑤利用subl…

    2026年9月30日 • 用户投稿
    300
  • 确保并发操作结果可观测性:理解ConcurrentHashMap与线程同步

    确保并发操作结果可观测性:理解ConcurrentHashMap与线程同步确保并发操作结果可观测性:理解ConcurrentHashMap与线程同步确保并发操作结果可观测性:理解ConcurrentHashMap与线程同步确保并发操作结果可观测性:理解ConcurrentHashMap与线程同步

    本文旨在探讨在使用ConcurrentHashMap进行并发写入操作时,如何确保最终结果的准确性与可观测性。我们将分析在多线程环境下,直接检查ConcurrentHashMap大小可能出现不符合预期的原因,并详细介绍如何利用ExecutorService.invokeAll()方法,确保所有并发任务…

    2026年9月30日 • 用户投稿
    000
  • 谷歌宣布Gemini定制助手Gems现已可供分享

    谷歌宣布Gemini定制助手Gems现已可供分享谷歌宣布Gemini定制助手Gems现已可供分享谷歌宣布Gemini定制助手Gems现已可供分享谷歌宣布Gemini定制助手Gems现已可供分享

    谷歌在本周四宣布,其个性化AI助手Gemini Gems现已支持共享功能。这项能力最初作为付费订阅服务的一项权益推出,允许用户构建专为特定用途定制的AI聊天机器人,例如学习辅导、文案润色或编程协助。 现在,用户可以像分享Google Drive中的文件一样,便捷地将自己创建的Gems发送给朋友、家人…

    2026年9月30日 • 用户投稿
    000
  • 使用Sublime搭建微服务架构初探_服务拆分与独立接口模块示范

    使用Sublime搭建微服务架构初探_服务拆分与独立接口模块示范使用Sublime搭建微服务架构初探_服务拆分与独立接口模块示范使用Sublime搭建微服务架构初探_服务拆分与独立接口模块示范使用Sublime搭建微服务架构初探_服务拆分与独立接口模块示范

    搭建微服务架构从简单服务拆分开始,使用sublime text也能实现。1. 服务拆分:将单体应用按功能拆分为独立服务,如用户管理、订单处理,分别创建文件夹模拟模块,每个服务只处理自身职责。2. 独立接口设计:使用flask或fastapi构建rest接口,明确服务间通信方式,统一命名、返回格式和错…

    2026年9月30日 • 用户投稿
    100
  • 豆包AI编程详细教程 豆包AI代码编写技巧

    豆包AI编程详细教程 豆包AI代码编写技巧豆包AI编程详细教程 豆包AI代码编写技巧豆包AI编程详细教程 豆包AI代码编写技巧豆包AI编程详细教程 豆包AI代码编写技巧

    豆包ai编程的关键在于明确需求和有效协作。1.使用时需先确定功能目标和编程语言,如输入“用python写一个判断回文的函数”即可生成代码片段;2.遇到问题可直接提供错误信息让ai分析原因,或要求添加注释辅助理解;3.提高代码质量方面,可让ai扮演评审角色,检查命名、风格并提出重构建议,还可格式化代码…

    2026年9月30日 • 用户投稿
    100
  • 英特尔的ARC显卡现在值得入手了吗?

    ARC显卡适合1080P游戏和视频剪辑,但4K游戏性能不足,创作软件兼容性有限,驱动进步明显但仍存短板,整体性价比可,特定需求下值得考虑。 英特尔的ARC显卡现在值不值得买,关键看你用来做什么。整体来看,它在特定领域有亮点,但综合体验和生态支持仍是短板。 游戏性能:中高画质1080P尚可,4K压力大…

    2026年9月30日
    600

发表回复

登录后才能评论
关注微信