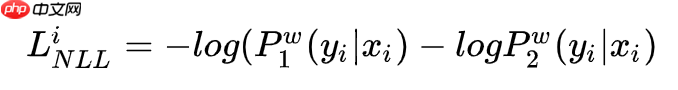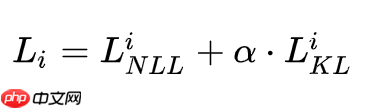R-Drop论文复现

R-Drop是基于Dropout的改进正则化方法,通过对模型输出层施加约束减少过拟合。其让每个样本两次通过带Dropout的同一模型,用KL散度约束两次输出一致,总损失为交叉熵与KL散度之和。代码实现仅增KL项,实验显示能有效提升模型正确率。

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
r-drop论文复现 - 创想鸟

R-Drop: Regularized Dropout for Neural Networks

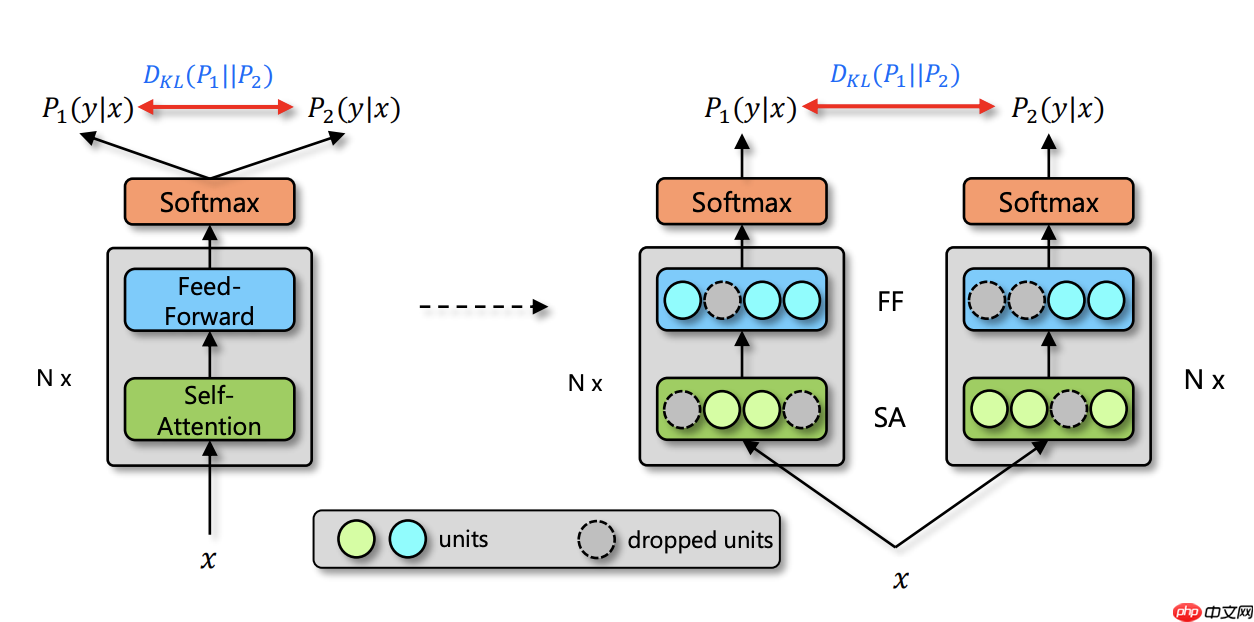
  由于深度神经网络非常容易过拟合,因此 Dropout 方法采用了随机丢弃每层的部分神经元,以此来避免在训练过程中的过拟合问题。正是因为每次随机丢弃部分神经元,导致每次丢弃后产生的子模型都不一样,所以 Dropout 的操作一定程度上使得训练后的模型是一种多个子模型的组合约束。基于 Dropout 的这种特殊方式对网络带来的随机性,研究员们提出了 R-Drop 来进一步对(子模型)网络的输出预测进行了正则约束。论文通过实验得出一种改进的正则化方法R-dropout,简单来说,它通过使用若干次(论文中使用了两次)dropout,定义新的损失函数。实验结果表明,尽管结构非常简单,但是却能很好的防止模型过拟合,进一步提高模型的正确率。模型主体如下图所示。
R-Drop论文复现 - 创想鸟        

论文贡献

  由于深度神经网络非常容易过拟合,因此 Dropout 方法采用了随机丢弃每层的部分神经元,以此来避免在训练过程中的过拟合问题。正是因为每次随机丢弃部分神经元,导致每次丢弃后产生的子模型都不一样,所以 Dropout 的操作一定程度上使得训练后的模型是一种多个子模型的组合约束。基于 Dropout 的这种特殊方式对网络带来的随机性,研究员们提出了 R-Drop 来进一步对(子模型)网络的输出预测进行了正则约束。

实现思路

  与传统作用于神经元(Dropout)或者模型参数(DropConnect)上的约束方法不同,R-Drop 作用于模型的输出层,弥补了 Dropout 在训练和测试时的不一致性。简单来说就是在每个 mini-batch 中,每个数据样本过两次带有 Dropout 的同一个模型,R-Drop 再使用 KL-divergence 约束两次的输出一致。既约束了由于 Dropout 带来的两个随机子模型的输出一致性。
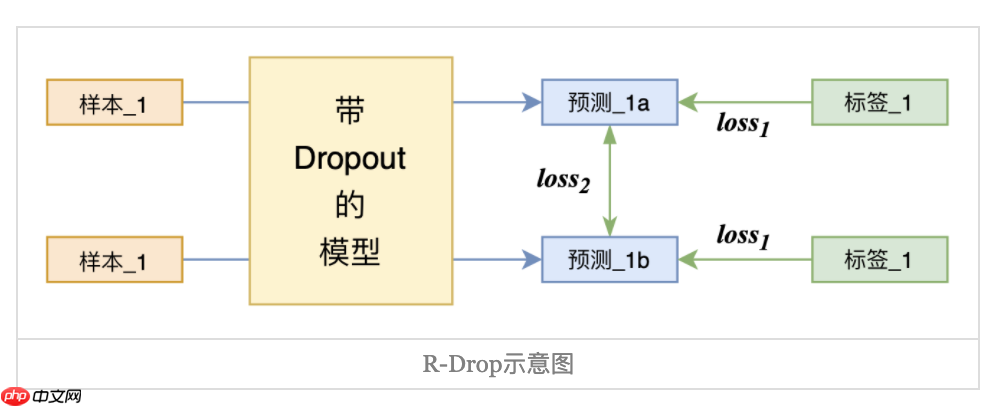
R-Drop论文复现 - 创想鸟        

论文公式

模型的训练目标包含两个部分,一个是两次输出之间的KL散度,如下:
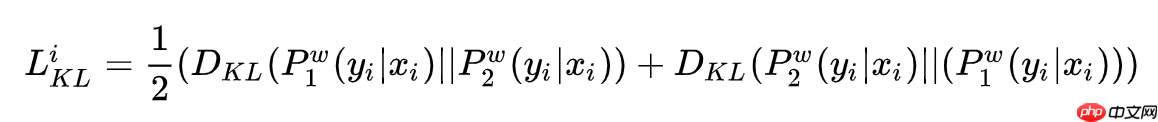
R-Drop论文复现 - 创想鸟        

另一个是模型自有的损失函数交叉熵,如下:

R-Drop论文复现 - 创想鸟        

总损失函数为:

R-Drop论文复现 - 创想鸟        

代码实现

与传统的训练方法相比,R- Drop 只是简单增加了一个 KL-divergence 损失函数项,并没有其他任何改动。其PaddlePaddle版本对应的代码实现如下所示。

散度损失

交叉熵=熵+相对熵(KL散度) 其与交叉熵的关系如下:
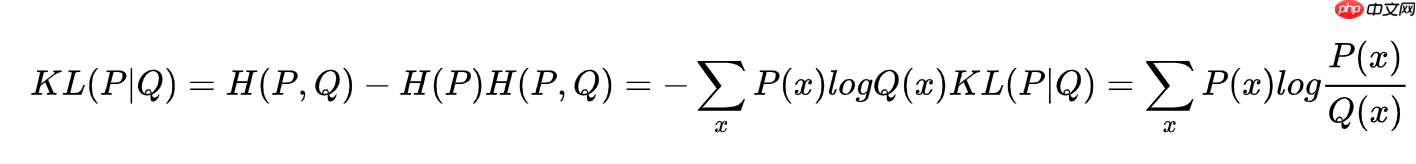
R-Drop论文复现 - 创想鸟        

代码实现示意

import paddle.nn.functional as F# define your task model, which outputs the classifier logitsmodel = TaskModel()def compute_kl_loss(self, p, q, pad_mask=None):        p_loss = F.kl_div(F.log_softmax(p, axis=-1), F.softmax(q, axis=-1), reduction='none')    q_loss = F.kl_div(F.log_softmax(q, axis=-1), F.softmax(p, axis=-1), reduction='none')        # pad_mask is for seq-level tasks    if pad_mask is not None:        p_loss.masked_fill_(pad_mask, 0.)        q_loss.masked_fill_(pad_mask, 0.)    # You can choose whether to use function "sum" and "mean" depending on your task    p_loss = p_loss.sum()    q_loss = q_loss.sum()    loss = (p_loss + q_loss) / 2    return loss# keep dropout and forward twicelogits = model(x)logits2 = model(x)# cross entropy loss for classifierce_loss = 0.5 * (cross_entropy_loss(logits, label) + cross_entropy_loss(logits2, label))kl_loss = compute_kl_loss(logits, logits2)# 论文中对于CV任务的超参数α = 0.6# carefully choose hyper-parametersloss = ce_loss + α * kl_loss


代码实现实战

项目说明

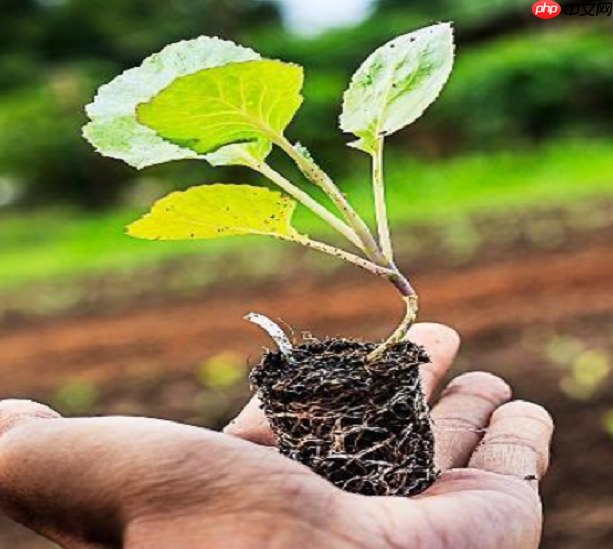
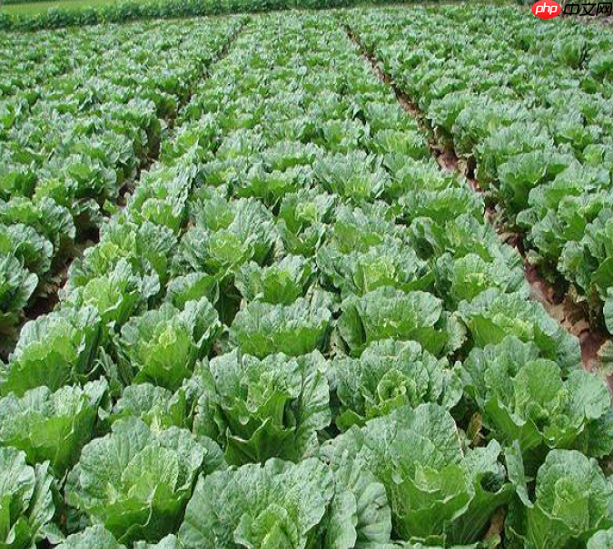
本次实验以白菜生长的四个周期为例,进行生长情况识别实验。数据来自于讯飞的比赛。数据展示如下:发芽期、幼苗期、莲座期、结球期。
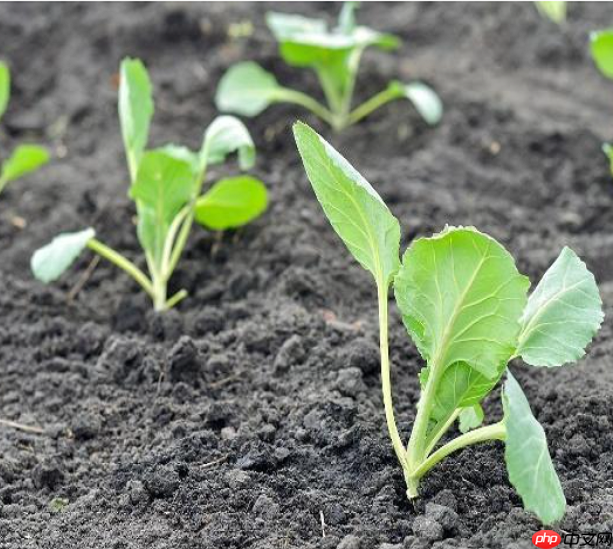
R-Drop论文复现 - 创想鸟 R-Drop论文复现 - 创想鸟R-Drop论文复现 - 创想鸟 R-Drop论文复现 - 创想鸟        

In [ ]

!cd 'data/data107306' && unzip -q img.zip!cd 'data/data106868' && unzip -q pdweights.zip

   In [ ]

# 导入所需要的库from sklearn.utils import shuffleimport osimport pandas as pdimport numpy as npfrom PIL import Imageimport paddleimport paddle.nn as nnfrom paddle.io import Datasetimport paddle.vision.transforms as Timport paddle.nn.functional as Ffrom paddle.metric import Accuracyimport warningswarnings.filterwarnings("ignore")# 读取数据train_images = pd.read_csv('data/data107306/img/df_all.csv')train_images = shuffle(train_images)# 划分训练集和校验集all_size = len(train_images)# print(all_size)train_size = int(all_size * 0.9)train_image_list = train_images[:train_size]val_image_list = train_images[train_size:]train_image_path_list = train_image_list['image'].valueslabel_list = train_image_list['label'].valuestrain_label_list = paddle.to_tensor(label_list, dtype='int64')val_image_path_list = val_image_list['image'].valuesval_label_list1 = val_image_list['label'].valuesval_label_list = paddle.to_tensor(val_label_list1, dtype='int64')# 定义数据预处理data_transforms = T.Compose([    T.Resize(size=(256, 256)),       T.Transpose(),    # HWC -> CHW    T.Normalize(               mean = [0, 0, 0],        std = [255, 255, 255],        to_rgb=True)    ])# 构建Datasetclass MyDataset(paddle.io.Dataset):    """    步骤一:继承paddle.io.Dataset类    """    def __init__(self, train_img_list, val_img_list,train_label_list,val_label_list, mode='train'):        """        步骤二:实现构造函数,定义数据读取方式,划分训练和测试数据集        """        super(MyDataset, self).__init__()        self.img = []        self.label = []        self.valimg = []        self.vallabel = []        # 借助pandas读csv的库        self.train_images = train_img_list        self.test_images = val_img_list        self.train_label = train_label_list        self.test_label = val_label_list        # self.mode = mode        if mode == 'train':             # 读train_images的数据            for img,la in zip(self.train_images, self.train_label):                self.img.append('data/data107306/img/imgV/'+img)                self.label.append(la)        else :            # 读test_images的数据            for img,la in zip(self.test_images, self.test_label):                self.img.append('data/data107306/img/imgV/'+img)                self.label.append(la)    def load_img(self, image_path):        # 实际使用时使用Pillow相关库进行图片读取即可,这里我们对数据先做个模拟        image = Image.open(image_path).convert('RGB')        image = np.array(image).astype('float32')        return image    def __getitem__(self, index):        """        步骤三:实现__getitem__方法,定义指定index时如何获取数据,并返回单条数据(训练数据,对应的标签)        """        image = self.load_img(self.img[index])        label = self.label[index]               return data_transforms(image), label    def __len__(self):        """        步骤四:实现__len__方法,返回数据集总数目        """        return len(self.img)

   In [ ]

#train_loadertrain_dataset = MyDataset(train_img_list=train_image_path_list, val_img_list=val_image_path_list, train_label_list=train_label_list, val_label_list=val_label_list, mode='train')train_loader = paddle.io.DataLoader(train_dataset, places=paddle.CPUPlace(), batch_size=8, shuffle=True, num_workers=0)#val_loaderval_dataset = MyDataset(train_img_list=train_image_path_list, val_img_list=val_image_path_list, train_label_list=train_label_list, val_label_list=val_label_list, mode='test')val_loader = paddle.io.DataLoader(val_dataset, places=paddle.CPUPlace(), batch_size=8, shuffle=True, num_workers=0)

   In [ ]

from work.senet154 import SE_ResNeXt50_vd_32x4dfrom work.res2net import Res2Net50_vd_26w_4sfrom work.se_resnet import SE_ResNet50_vd# 模型封装# model_re2 = SE_ResNeXt50_vd_32x4d(class_num=4)model_re2 = Res2Net50_vd_26w_4s(class_dim=4)model_ss = SE_ResNet50_vd(class_num=4)model_ss.train()model_re2.train()epochs = 2optim1 = paddle.optimizer.Adam(learning_rate=3e-4, parameters=model_re2.parameters())optim2 = paddle.optimizer.Adam(learning_rate=3e-4, parameters=model_ss.parameters())

   In [ ]

import paddle.nn.functional as Fdef compute_kl_loss(p, q, pad_mask=None):    p_loss = F.kl_div(F.log_softmax(p, axis=-1), F.softmax(q, axis=-1), reduction='none')    q_loss = F.kl_div(F.log_softmax(q, axis=-1), F.softmax(p, axis=-1), reduction='none')        # pad_mask is for seq-level tasks    if pad_mask is not None:        p_loss.masked_fill_(pad_mask, 0.)        q_loss.masked_fill_(pad_mask, 0.)    # You can choose whether to use function "sum" and "mean" depending on your task    p_loss = p_loss.sum()    q_loss = q_loss.sum()    loss = (p_loss + q_loss) / 2    return loss

   In [7]

# 用Adam作为优化函数for epoch in range(epochs):    for batch_id, data in enumerate(train_loader()):        x_data = data[0]        y_data = data[1]        predicts1 = model_re2(x_data)        predicts2 = model_ss(x_data)                loss1 = F.cross_entropy(predicts1, y_data, soft_label=False)        loss2 = F.cross_entropy(predicts2, y_data, soft_label=False)                # cross entropy loss for classifier        ce_loss = 0.5 * (loss1 + loss2)        kl_loss = compute_kl_loss(predicts1, predicts2)        # 论文中对于CV任务的超参数        α = 0.6        # carefully choose hyper-parameters        loss = ce_loss + α * kl_loss        # 计算损失        acc1 = paddle.metric.accuracy(predicts1, y_data)        acc2 = paddle.metric.accuracy(predicts2, y_data)                loss.backward()        if batch_id % 50 == 0:            print("epoch: {}, batch_id: {}, loss1 is: {}".format(epoch, batch_id, loss.numpy()))        optim1.step()        optim1.clear_grad()            optim2.step()        optim2.clear_grad()


以上就是R-Drop论文复现的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/42659.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
如何查询vivo手机是否为新机(一键查询vivo手机真伪,轻松辨别新旧)
上一篇 2025年11月6日 20:51:45
MySQL 倒排索引为何在搜索引擎中并不常见?
下一篇 2025年11月6日 20:52:59

相关推荐

  • js怎么获取元素的偏移位置

    js怎么获取元素的偏移位置js怎么获取元素的偏移位置js怎么获取元素的偏移位置js怎么获取元素的偏移位置

    获取元素相对于最近定位父元素的偏移量使用offsettop和offsetleft,它们返回元素相对于其offsetparent的顶部和左侧距离,包含自身margin但不包含父元素的padding或border;2. 获取元素相对于视口的位置应使用getboundingclientrect(),该方法…

    2026年10月1日 • 用户投稿
    000
  • ChatGPT如何用API开发 接入与调试完整流程

    ChatGPT如何用API开发 接入与调试完整流程ChatGPT如何用API开发 接入与调试完整流程ChatGPT如何用API开发 接入与调试完整流程ChatGPT如何用API开发 接入与调试完整流程

    使用chatgpt api开发的关键在于掌握申请流程和调试技巧。1. 申请api权限需注册openai账号,创建项目并绑定支付信息,审核通过后生成api key;2. 调用api时选择gpt-3.5-turbo模型,构造包含角色与内容的消息结构,并在请求头中添加authorization字段;3. …

    2026年10月1日 • 用户投稿
    100
  • Safari浏览器怎么设置成中文显示_Safari界面语言切换为中文

    Safari浏览器怎么设置成中文显示_Safari界面语言切换为中文Safari浏览器怎么设置成中文显示_Safari界面语言切换为中文Safari浏览器怎么设置成中文显示_Safari界面语言切换为中文Safari浏览器怎么设置成中文显示_Safari界面语言切换为中文

    通过系统设置将首选语言更改为简体或繁体中文并置顶,使Safari自动切换界面语言;2. 检查用户账户的登录选项与高级语言偏好是否同步为中文;3. 重置Safari浏览器,清除网站数据与缓存以强制刷新语言显示。 如果您发现Safari浏览器的界面语言不是中文,可能是由于系统语言设置未正确配置。Safa…

    2026年10月1日 • 用户投稿
    100
  • Python 开发环境配置与调试插件推荐

    Python 开发环境配置与调试插件推荐Python 开发环境配置与调试插件推荐Python 开发环境配置与调试插件推荐Python 开发环境配置与调试插件推荐

    选择python开发环境和调试插件需根据个人习惯与项目需求决定。推荐vs code适合新手及轻量级项目,pycharm适合需要高级功能的开发者,jupyter notebook适用于数据分析;常用调试插件包括pdb、vs code python插件、pycharm debugger和ipdb;配置虚…

    2026年10月1日 • 用户投稿
    000
  • 腾讯发布一站式工作平台“混元 3D Studio”

    腾讯发布一站式工作平台“混元 3D Studio”腾讯发布一站式工作平台“混元 3D Studio”腾讯发布一站式工作平台“混元 3D Studio”腾讯发布一站式工作平台“混元 3D Studio”

    腾讯推出专为3d设计师、游戏开发者和建模师打造的ai工作台——混元3d studio,可将3d资产生产周期从”天”级缩短至”分钟”级。 混元3D Studio1.0版本已上线角色和道具创作管线,整合了从概念设计、几何建模到贴图、蒙皮和动画制作的完整流程…

    2026年10月1日 • 用户投稿
    000
  • 参加SublimeText线下技术交流活动的经验

    参加SublimeText线下技术交流活动的经验参加SublimeText线下技术交流活动的经验参加SublimeText线下技术交流活动的经验参加SublimeText线下技术交流活动的经验

    参加sublime text线下技术交流活动让我意识到,最大化活动价值的关键在于带着问题去、勇于分享、保持开放心态并及时实践。1. 带着具体问题参与交流,能更高效筛选和吸收信息;2. 主动提问和分享经验,有助于引发深入讨论并互相启发;3. 保持开放心态,尝试理解他人用法背后的逻辑;4. 活动后立即实…

    2026年10月1日 • 用户投稿
    100
  • 豆包AI怎么处理数据 豆包AI数据处理教程

    豆包AI怎么处理数据 豆包AI数据处理教程豆包AI怎么处理数据 豆包AI数据处理教程豆包AI怎么处理数据 豆包AI数据处理教程豆包AI怎么处理数据 豆包AI数据处理教程

    豆包ai在数据处理方面实用且易用,适合日常办公与学习场景。一、可自动识别并整理表格数据,支持合并单元格、调整列宽等操作,适用于杂乱表格整理;二、能快速提取关键信息,如人名、时间、关键词,适合从文本中挖掘有用内容;三、辅助进行简单数据分析,如求和、分类统计、趋势分析,输出图表描述;四、支持多种文件格式…

    2026年10月1日 • 用户投稿
    000
  • java使用教程怎样实现类之间的继承关系 java使用教程的继承特性应用教程​

    java使用教程怎样实现类之间的继承关系 java使用教程的继承特性应用教程​java使用教程怎样实现类之间的继承关系 java使用教程的继承特性应用教程​java使用教程怎样实现类之间的继承关系 java使用教程的继承特性应用教程​java使用教程怎样实现类之间的继承关系 java使用教程的继承特性应用教程​

    java中类之间的继承通过extends关键字实现,子类可继承父类的属性和方法以实现代码重用;2. 定义父类后,子类使用extends继承父类,并可通过super调用父类构造函数和方法;3. 子类可重写父类方法,使用@override注解确保正确重写;4. 继承的优点包括代码重用、层次结构清晰和多态…

    2026年10月1日 • 用户投稿
    100
  • 如何在CNGBdb快速、批量上传数据?试试Aspera吧~ | CNGBdb-Question Time

    如何在CNGBdb快速、批量上传数据?试试Aspera吧~ | CNGBdb-Question Time如何在CNGBdb快速、批量上传数据?试试Aspera吧~ | CNGBdb-Question Time如何在CNGBdb快速、批量上传数据?试试Aspera吧~ | CNGBdb-Question Time如何在CNGBdb快速、批量上传数据?试试Aspera吧~ | CNGBdb-Question Time

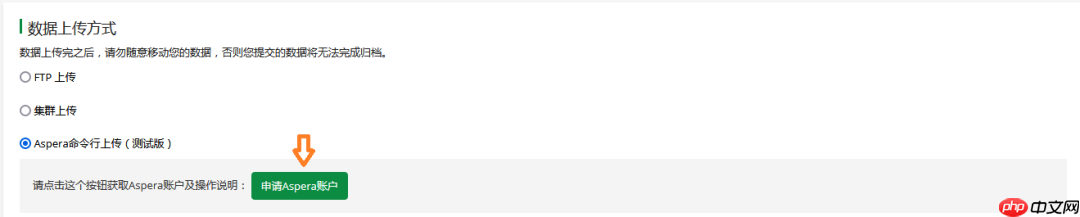
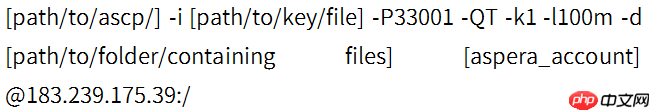
    dr.羊 | 什么是aspera? Aspera是由IBM公司开发的一款高效数据传输软件,引入了全新的传输技术faspTM,能够不受文件大小、类型、传输距离和网络条件的限制,以最快的速度帮助用户在全球范围内迁移数据。其核心技术fasp传输协议是一种突破性的传输方案,充分利用现有的WAN基础设施和普通…

    2026年10月1日 • 用户投稿
    100
  • 从知识图谱到精准决策:基于MCP的招投标货物比对溯源系统实践

    从知识图谱到精准决策:基于MCP的招投标货物比对溯源系统实践从知识图谱到精准决策:基于MCP的招投标货物比对溯源系统实践从知识图谱到精准决策:基于MCP的招投标货物比对溯源系统实践从知识图谱到精准决策:基于MCP的招投标货物比对溯源系统实践

    前言 从最初对人工智能的懵懂认知,到逐渐踏入prompt工程的世界,我们一路探索,从私有化部署的实际场景,到对deepseek技术的全面解读,再逐步深入到nl2sql、知识图谱构建、rag知识库设计,以及chatbi这些高阶应用。一路走来,我们在ai的领域里一步一个脚印,不断拓展视野和能力边界。如果…

    2026年10月1日 • 用户投稿
    100
  • 优化Spring Boot REST API响应:避免JPA不必要关联数据返回

    优化Spring Boot REST API响应:避免JPA不必要关联数据返回优化Spring Boot REST API响应:避免JPA不必要关联数据返回优化Spring Boot REST API响应:避免JPA不必要关联数据返回优化Spring Boot REST API响应:避免JPA不必要关联数据返回

    本文旨在解决Spring Boot应用中REST API返回JPA实体时,因关联关系导致不必要数据泄露或响应过大的问题。我们将探讨两种主要策略:通过@JsonIgnore注解静态排除字段,以及采用数据传输对象(DTO)模式实现更灵活、解耦的响应控制,确保API仅返回前端所需的核心数据,提升性能与安全…

    2026年10月1日 • 用户投稿
    000
  • 豆包AI能否连接智能家居 豆包AI物联网设备控制功能探索

    豆包AI能否连接智能家居 豆包AI物联网设备控制功能探索豆包AI能否连接智能家居 豆包AI物联网设备控制功能探索豆包AI能否连接智能家居 豆包AI物联网设备控制功能探索豆包AI能否连接智能家居 豆包AI物联网设备控制功能探索

    豆包AI作为一款智能助手,其功能不断扩展,许多用户关注它是否具备连接并控制家中的智能家居设备的能力。本文将围绕“豆包AI能否连接智能家居”这一问题展开,探索豆包AI的物联网设备控制功能,并提供实现连接与控制的详细步骤,帮助用户理解和操作,从而更好地利用豆包AI管理智能家居设备。 ☞☞☞AI 智能聊天…

    2026年10月1日 • 用户投稿
    200
  • Sublime写Markdown的正确姿势|支持预览与快捷格式操作

    Sublime写Markdown的正确姿势|支持预览与快捷格式操作Sublime写Markdown的正确姿势|支持预览与快捷格式操作Sublime写Markdown的正确姿势|支持预览与快捷格式操作Sublime写Markdown的正确姿势|支持预览与快捷格式操作

    使用 sublime text 编辑 markdown 需安装插件并配置功能以提升效率。1. 安装 markdown editing 和 markdown preview 插件以增强编辑体验和实现预览功能;2. 通过命令面板安装插件并设置预览方式,支持浏览器内实时预览或使用 github 样式;3.…

    2026年10月1日 • 用户投稿
    600
  • 菜鸟 学注册机编写之 Android app

    菜鸟 学注册机编写之 Android app菜鸟 学注册机编写之 Android app菜鸟 学注册机编写之 Android app菜鸟 学注册机编写之 Android app

    0x00前言 环境及工具: 手机    Nexus 4(己root) 系统版本   Android 5.01 工具    AndroidKiller_V1.2     关于Android平台app注册机的编写网上文章还比较少,而在Windows平台上这方面的教程己经很多了,今天将以一个简单的app为…

    2026年10月1日 • 用户投稿
    100
  • Gemini支持实时协作编辑吗 Gemini多人协同文档处理指南

    Gemini支持实时协作编辑吗 Gemini多人协同文档处理指南Gemini支持实时协作编辑吗 Gemini多人协同文档处理指南Gemini支持实时协作编辑吗 Gemini多人协同文档处理指南Gemini支持实时协作编辑吗 Gemini多人协同文档处理指南

    本文将探讨如何利用Gemini模型的能力来支持和优化多人协同处理文档的过程。尽管Gemini本身并非一个传统的文档编辑工具,但它可以作为一个强大的AI助手,深度参与到文档的创作、修改和完善环节,极大地提升团队协作的效率和质量。我们将详细讲解如何整合Gemini到现有的协同工作流程中,通过具体步骤指导…

    2026年10月1日 • 用户投稿
    100
  • 安卓系统深度清理不常用APP缓存_安卓深度清理不常用缓存

    安卓系统深度清理不常用APP缓存_安卓深度清理不常用缓存安卓系统深度清理不常用APP缓存_安卓深度清理不常用缓存安卓系统深度清理不常用APP缓存_安卓深度清理不常用缓存安卓系统深度清理不常用APP缓存_安卓深度清理不常用缓存

    清理安卓设备缓存可提升运行速度与存储空间,首先使用系统自带存储管理工具扫描并清理不常用应用缓存;其次手动进入应用信息页面精准清除单个应用缓存;再通过可信第三方工具如SD Maid进行深度扫描清理残留文件;最后高级用户可通过ADB命令行强制清除特定应用缓存。 如果您发现安卓设备运行缓慢或存储空间不足,…

    2026年10月1日 • 用户投稿
    1100
  • “扫地僧”进军手机市场,万亿手机市场还能否容下一个追觅?

    “扫地僧”进军手机市场,万亿手机市场还能否容下一个追觅?“扫地僧”进军手机市场,万亿手机市场还能否容下一个追觅?“扫地僧”进军手机市场,万亿手机市场还能否容下一个追觅?“扫地僧”进军手机市场,万亿手机市场还能否容下一个追觅?

    2025年的今天,没想到手机市场还有新故事可讲。 9月19日,追觅正式宣布推出首款深度融合天文科技与智能生态的移动终端——Dreame Space。追觅官方表示,其将采用全球顶级手机硬件配置,搭载天文级摄像系统,深度融合追觅在天文探测与影像算法领域的突破性成果,为用户带来全新的体验。  图源:追觅 …

    2026年10月1日 • 用户投稿
    200
  • 使用服务账户管理Google日历事件:解决403权限问题与最佳实践

    使用服务账户管理Google日历事件:解决403权限问题与最佳实践使用服务账户管理Google日历事件:解决403权限问题与最佳实践使用服务账户管理Google日历事件:解决403权限问题与最佳实践使用服务账户管理Google日历事件:解决403权限问题与最佳实践

    本文深入探讨了如何利用Google服务账户及其域范围授权(Domain-Wide Delegation, DWD)来管理Google日历事件,特别是解决常见的403权限错误。我们将详细解释服务账户与用户授权的区别,提供Java代码示例,并阐明DWD的配置步骤、常见陷阱以及如何确保服务账户在不直接访问…

    2026年10月1日 • 用户投稿
    000
  • java代码怎样实现栈的逆序输出 java代码栈应用的实用编写教程​

    java代码怎样实现栈的逆序输出 java代码栈应用的实用编写教程​java代码怎样实现栈的逆序输出 java代码栈应用的实用编写教程​java代码怎样实现栈的逆序输出 java代码栈应用的实用编写教程​java代码怎样实现栈的逆序输出 java代码栈应用的实用编写教程​

    最经典实现栈逆序的方法是利用递归,1. reverse函数递归弹出栈顶元素直至栈空;2. insertatbottom函数通过递归将元素插入栈底,从而实现原地逆序;该方法不依赖额外数据结构,体现了栈与递归的深层关联,常用于考察算法思维。 栈的逆序输出,在Java里实现起来,最经典也最能体现栈特性的方…

    2026年10月1日 • 用户投稿
    000
  • Sublime结合RESTful与GraphQL混合接口_实现灵活统一的查询与操作方式

    Sublime结合RESTful与GraphQL混合接口_实现灵活统一的查询与操作方式Sublime结合RESTful与GraphQL混合接口_实现灵活统一的查询与操作方式Sublime结合RESTful与GraphQL混合接口_实现灵活统一的查询与操作方式Sublime结合RESTful与GraphQL混合接口_实现灵活统一的查询与操作方式

    在实际开发中,RESTful 和 GraphQL 各有优势。如果我们能在一个工具中同时使用这两种接口风格,并保持操作的一致性与灵活性,那无疑会提升调试和测试效率。Sublime Text 本身虽不是专门的 API 调试工具,但通过合适的插件(如 GraphQL 插件或 REST Client 插件)…

    2026年10月1日 • 用户投稿
    000

发表回复

登录后才能评论
关注微信