1 Introductions
近期,视觉 transformer (vits)成为一项新兴研究,极大地挑战了占主导地位的卷积神经网络(cnns),在诸如分类[9, 13, 18, 22, 44]、目标检测[1, 3, 61]、语义分割[5, 35]等各种图像分析和理解任务上表现出与cnns相当甚至更优的性能,但完全没有了cnns中的卷积机制。尽管在任务性能上取得了成功,正如[54]所指出的,vits架构的一个主要缺点是,与cnns相比,vits在内存占用、计算复杂度以及最终功耗方面的资源效率要低得多。为了使高性能的vits更加环保并普及这项技术,有必要压缩vits模型并降低功耗,以便它们可以被低端计算设备以相同或可比的模型性能访问。
在神经网络压缩的不同分支中,网络剪枝是一种在CNNs上已显示成功的方法,它剪除网络中的冗余神经元或排除计算。在之前的CNN研究中,一些尝试对模型进行非结构化剪枝,移除层权重中的单个神经元;而其他[36, 41]使用结构化剪枝,移除通道方向的神经元。与非结构化剪枝相比,后者的结构化方案具有很高的数据局部性,因此对硬件更友好[2],因为它通过简单地移除权重矩阵中的整行或整列更容易实现计算加速,但由于剪枝粒度较粗,会导致严重的准确度下降,因此它是一种更具挑战性的剪枝方案。
然而,对于主要由线性层(矩阵乘法)组成的 Transformer 架构,块结构化(半结构化)剪枝在准确性和硬件加速之间是一个更好的折中方案,因为GEMM以块对块的方式进行矩阵乘法。因此,在相同的剪枝比例下,与块稀疏矩阵的乘法可以实现比非结构化矩阵更快的加速,同时仍然保持高准确度。各种剪枝方案的定性比较总结在图1中。在NLP领域的先前研究[30, 37]在语言模型(BERT[11],MobileBERT[42]等)上验证了块结构化剪枝,实现了超过的速度提升,且性能下降可以忽略不计。然而,它们的其他剪枝方案相对过时,例如,普通的剪枝标准。在ViTs上进行类似尝试以应对各种视觉任务的研究仍然很少。
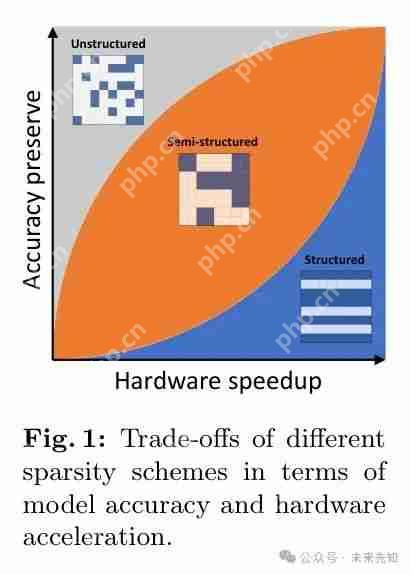
图1:不同稀疏方案在模型准确性和硬件加速方面的折中。
在这项工作中,作者为ViTs提出了一种新颖的块结构化剪枝方法,以块为基础剪除参数,以实现准确性和效率之间的更好折中。作者以一种同时保持剪枝模型准确性和最小化计算操作数量的方式制定学习目标。在目标中融入了硬件感知的约束,以在推理阶段提升加速和降低功耗。此外,作者提出了一种快速的优化方法来利用二阶泰勒近似求解目标函数。经过等价的重新公式化,作者能够非常高效地求解目标(对于经验数据收集,相对于网络大小,二次到三次复杂度,对于方程求解,线性时间复杂度)。据作者所知,这是第一篇介绍块结构化剪枝方案并针对ViTs提出硬件感知的后训练剪枝方法的论文。主要贡献总结如下:
作者系统地制定了在块结构化剪枝方案下针对ViTs模型的最佳硬件感知剪枝目标,它直接优化模型准确性和功耗。功耗完全估计,无需构建任何经验查找表(LUTs),使它成为一种轻量级方法,且优化不需要额外的开销。所提出的剪枝方案仅依赖于减少参数化层的连接,而不操纵跳过配置和标记剪枝。作者接着为提出的硬件感知目标函数提供一个有效的解决方案,通过二阶泰勒近似,并提出了一种经验优化方法,仅具有线性时间复杂度。随着权重的剪枝,从片外内存到片上内存的读写所需参数更少,从而实现内存减少和显著功耗降低。大量实验证明了作者方法的有效性。在包括DeiT-B、DeiT-S、Swin-T、Swin-B等在内的各种深度ViTs架构上的结果表明,与现有技术水平相比,作者的方法明显表现更优,在专用硬件上加速高达,在GPU上高达。在真实世界的GPU上,推理功耗降低。2 Related WorksVision Transformers (ViTs)
在自注意力机制为基础的 Transformer 架构在自然语言处理领域取得成功[46]之后,基于 Transformer 的视觉模型也开始在图像领域取得进展,并在各种场景中成为传统卷积神经网络(CNNs)的有力竞争者,如目标检测[3, 61]、分割[5]等。ViT[12]首次尝试将多头注意力(MHA)架构引入图像模态,并在大规模数据集上的图像分类任务中超越CNN的性能。后来,DeiT[45]采用相同的架构但通过基于token的知识蒸馏来增强表示学习,进一步提升了原始ViTs的性能。MAE[22]引入了一种监督技术,在 Mask 图像重建的预训练任务上训练ViT编码器,并在ImageNet分类任务上取得了最先进的表现。Swin Transformer[35]利用了移位窗口来引入窗口间信息交换并增强局部注意力。Transformer-iN-Transformer(TNT)[19]通过在每个 Transformer 块内的嵌套自注意力来聚合图像的块 Level 和像素 Level 的表示。
Pruning on CNNs
卷积神经网络(CNN)的剪枝研究已经进行了数十年。大量的剪枝方法可以根据稀疏程度被分为非结构化剪枝、半结构化剪枝、结构化(通道/滤波器级)剪枝等。
非结构化剪枝 从卷积核中移除单个连接(神经元),这是由开创性工作[20, 21]最早建立起来的剪枝方案,这些工作尝试对LeNet和AlexNet进行非结构化剪枝。随后,[15, 39, 40, 59]采用基于幅度或泰勒的准则重要性得分来全局地阈值低分连接。[14, 17]利用架构启发式来确定逐层剪枝率。一些努力[31, 32, 39]考虑剪枝对模型输出的影响来确定逐层剪枝率。[24]假设CNN权重的拉普拉斯分布来近似输出失真。[48, 50]利用率失真理论推导出实现最优率失真性能的逐层剪枝比。
结构化剪枝 或通道/滤波器级剪枝方案一次性地剪除卷积层中的整个核或全连接层中的通道。[36]使用特征图重要性作为确定可移除通道的代理。[23]采用基于正则化的结构剪枝方法。[53]通过在最终响应层传播得分来获得通道级重要性得分。[33]利用特征图的排名信息来确定可剪枝通道。[48]利用率失真理论剪除导致模型准确度下降最小的通道。[41]对通道进行一阶重要性评估,并通过解决整个网络中所有通道重要性的背包问题来分配稀疏性。
半结构化剪枝 是一种探索较少的方法,它利用非结构化和结构化剪枝之间的稀疏模式,其中像matmul中的块稀疏性可以通过利用GPU计算的性质极大地提升现实世界的加速[30, 37]。由于稀疏模式比结构化剪枝更为温和,因此移除神经元对模型准确度的影响小于结构化剪枝。然而,半结构化剪枝在新兴的ViTs(主要由大部分全连接层的 Transformer 编码器架构构建)上的探索还不够充分。
Sparsity in ViTs
在见证了CNN剪枝的成功之后,ViT(视觉 Transformer )的剪枝也开始受到越来越多的关注。与CNN剪枝相比,纯权重剪枝的努力较少,而更多关注于 Token 、多头自注意力(MHA)等的剪枝。SViTE [6] 首先提出在结构化剪枝方案下,通过稀疏训练对ViT进行 Token 和自注意力 Head 的剪枝。UVC [55] 推导出一个混合优化目标,统一了针对ViT权重、 Token 和跳跃连接配置的结构化剪枝,以实现ViT的稀疏训练。SPViT [27] 只在注意力头上进行 Token 剪枝,但采用延迟约束以在边缘设备上最大化加速。[51] 采用Nvidia的Ampere 2:4稀疏结构以实现高加速,但需要结构约束确保qkv、前馈和投影层( Head 对齐)的维度匹配,从更大的ViT变体中搜索子网络以匹配较小网络的延迟。与之前的工作 [51, 54] 不同,作者的方法专注于纯权重剪枝方案,并且不需要对不同压缩方案的协调进行繁重的搜索。
一些工作 [49, 56, 26, 47] 通过引入稀疏和局部注意力模式来稀疏化重的自注意力,用于语言模型。[7] 尝试在ViT上应用,但这些稀疏注意力方案仍然需要从头开始训练。
3 MethodologiesPreliminaries
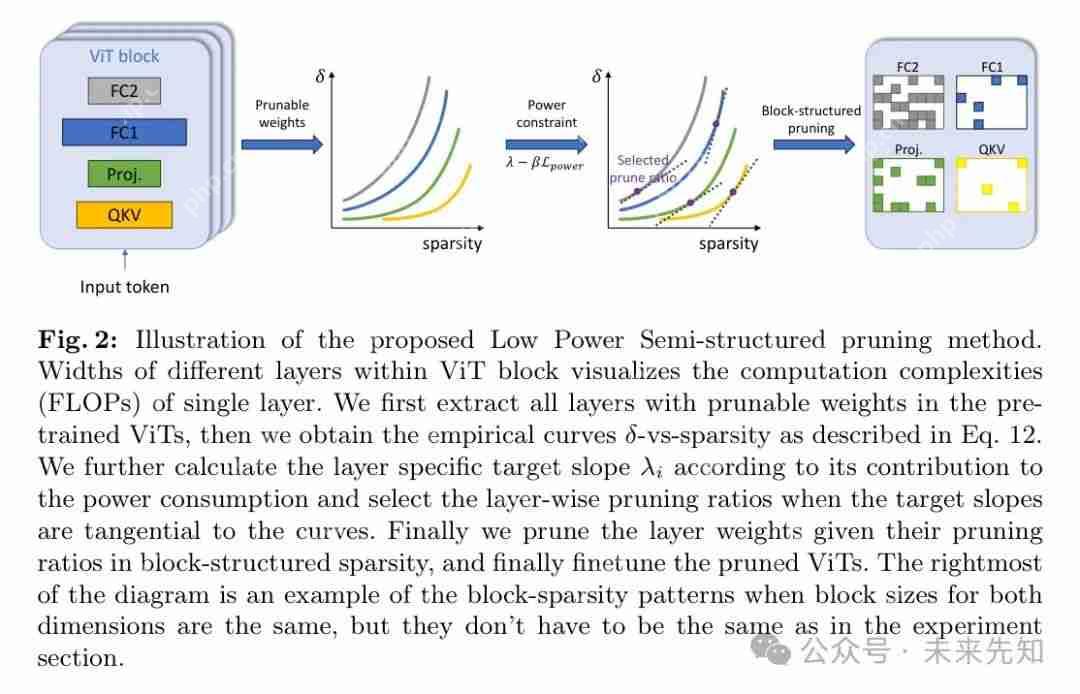
层内块结构剪枝。 作者针对所有线性层权重的块结构剪枝进行了研究,这包括ViTs中的任何参数化线性层,例如qkv层、前馈和投影层。这些权重矩阵中的神经元以2维固定大小的块为单位进行分组,作为剪枝的目标。为了确定哪些块需要被剪枝,给定一个块结构,对于每个矩阵,作者根据每个块内神经元的1阶泰勒展开分数的平均值对块进行排序。从数学上讲,作者首先通过泰勒展开获得神经元分数,类似于[38],然后进行2D平均池化以获得每个块的分数(是非负实数集)。然后,给定每个层的剪枝比例,作者可以根据它们的分数对块进行排序并消除排名靠后的块。图2最右侧部分真实地展示了从ViTs生成的块结构模式。上述剪枝方案可以表示为,其中是在剪枝比例下从前一个块分数矩阵生成的二值 Mask 。
ViTs的剪枝方案。 与之前的工作不同,本文的工作范围仅限于消除模型参数以减少计算量,而不考虑ViTs的其他方面,如 Token 数量、 Token 大小和 Transformer 块跳过[6, 27, 55]。
作者进一步采用了一个关于典型剪枝操作对权重造成的权重扰动的基本假设:
假设1:_各层间独立同分布权重扰动[58]:这意味着联合分布的均值为零:_
forall 0
并且协方差为零:.Hardware-aware pruning objective
由于各层可能对模型性能的贡献不同[16],已提出了各种标准来在给定总预算的情况下分配逐层稀疏性[24, 31, 32, 50]。然而,大多数现有的剪枝目标可以概括为在计算约束下最小化模型输出准确度,而没有明确考虑实际功耗和加速。相比之下,作者的压缩剪枝目标直接优化功耗以达到特定的计算减少目标(FLOPs)。具体来说,给定一个由层及其参数集组成的神经网络,其中是第层的权重,对中的剪枝参数将得到一个新的参数集。作者将剪枝的影响视为网络输出与之间的距离。
图2:所提出的低功耗半结构化剪枝方法的图解。在ViT块内不同层的宽度展示了单层的计算复杂度(FLOPs)。作者首先提取了预训练ViTs中所有具有可剪枝权重的层,然后根据方程12获得经验曲线-与-稀疏性。作者进一步根据各层对功耗的贡献计算特定于层的目标斜率,并在目标斜率与曲线相切时选择逐层剪枝比例。最后,作者根据它们的剪枝比例以块结构化稀疏度剪枝层权重,并对剪枝后的ViTs进行微调。图中右侧是当两个维度的块大小相同时的块稀疏模式示例,但它们在实验部分不必相同。
因此,作者的学习目标如下:
这共同最小化了剪枝引起的输出失真(第一项)以及估计的功耗,在一定的FLOPs减少目标下。
Second-order Approximation of Output Distortion
为了解决剪枝目标,作者将与输出失真相关的第一项分解。首先,作者使用二阶泰勒展开来展开输出失真 :(从现在起为了视觉清晰,省略上标)
其中 是第 层权重的海森矩阵。
然后考虑目标方程 2 中 L2 范数的平方的期望,它可以被重写为向量的内积形式:
当作者进一步展开内积项时,每一对不同层次 的交叉项是:
当作者讨论随机变量 的影响时,一阶和二阶导数 和 可以被视为常数,因此可以移出期望之外。同时,在期望内向量转置是无关紧要的。因此方程式 5 变为:
在上述等式中,四个交叉项可以使用假设1发现它们也都等于零。因此,方程式4的期望值仅包含层内项:
其中,公式部分保持原始输出,文本内容按照要求翻译成了简体中文。
Power consumption under Block-structured Pruning
由于网络推理的大部分功耗归因于矩阵乘法操作,可以通过累加每个线性层的块稀疏矩阵乘法的单个功耗来估计网络功耗。考虑一个矩阵 (通常是输入张量),与具有块结构和剪枝掉-百分比的块稀疏权重矩阵 相乘。当使用在维上配置了 Kernel 网格大小的块稀疏GEMM时,块稀疏矩阵乘法的功耗可以估计为
其中 是单个块内矩阵乘法的功耗。因此,可以通过将所有层的网络功耗相加来获得方程2中的第二项:
其中 和 可以被吸收到权重系数 中,因为它们仅取决于硬件参数和GEMM配置,这些配置在所有层中是统一的。
最终目标。 结合方程7和方程9,最终目标可以重新表述为:
 度加剪辑
度加剪辑(原度咔剪辑),百度旗下AI创作工具
 63 查看详情

约束条件:操作的浮点运算次数比例 。
Finding Solution to Pruning Objective
在这一点上,作者可以通过应用拉格朗日公式[48, 50]进一步解决方程10在逐层剪枝比例集上的优化问题
在实际中,作者可以去掉方程11中的天花板函数,因此:
在 之上成立。
这将给出一个连续的 与原始有天花板函数的解相比,但在实践中,由于权重张量内的块数是有限的,剪枝比例 无论如何都要取整到离散值。求解方程12需要收集所有层的经验曲线(剪枝比例 对 Taylor 二阶项 )。通过设置特定的 ,作者可以为每个层单独求解方程12,通过寻找一个让等式成立的 。通过遍历 ,可以得到剪枝比例的最终解,使得剪枝网络最接近约束 。
从优化解方程12中,作者可以得到一个关键见解:通过控制权重 ,功耗以改变曲线 的目标斜率的形式明确地包含在优化过程中,这表示剪枝一个层对最终模型精度(输出失真)的影响程度。这样,作者实现了模型精度和功耗之间的直接权衡。
Empirical Complexity
Hessian近似。 对于经验网络,作者使用经验Fischer信息矩阵[29]来近似Hessian矩阵 :
其中,表示单位矩阵,表示第个样本的损失函数对权重的梯度。
为了在校准集上获得经验曲线 ,可以遍历不同的剪枝比例(例如实践中 alpha_{k}=frac{k+1}{K},0
以下是不包含公式部分的文本翻译:
… (此处保留原始公式)
将子向量 的维度表示为 ,等于(从 变化到 的值数量,等式14中的乘法计算可以在低维度上进行,其中 是从原始向量和中索引出的子向量和子矩阵。在 时, —— 即没有任何剪枝,这保证了 。由于 线性增加,,因此,复杂度大约为 。因此,计算所有 层的 的总计算复杂度大约为 ,这远低于原始复杂度。
就此,作者提出了一种明确考虑块结构稀疏模型推理中功耗的硬件感知剪枝准则。块结构剪枝方案使得获得的稀疏网络在实际硬件上实现加速的同时,最优地保持了网络精度。该算法极其高效地获得稀疏的ViT模型。
4 ExperimentsDatasets and Benchmarks
作者广泛评估了作者的ViTs剪枝方法在图像分类任务以及下游图像分割任务上的表现。对于分类任务,作者主要在ImageNet数据集[28]上对Deit [45]模型以及Swin Transformers [35]进行实验。作者在ViTs的微调中采用了与UVC [54]相同的训练设置。对于图像分割,作者在Cityscapes数据集[10]上测试了SETR [57]模型中DeiT-Base Backbone 网的迁移性能。更多的实现细节可以在附录材料中找到。
基准方法。在以下实验中,作者遵循UVC [54]的比较设置,并将自己与前期的ViTs压缩方法进行比较,这些方法至少涉及模型权重剪枝,以及混合方法,包括SCOP [43]、VTP [60]、SViTE [6]、X-Pruner [52]和UVC [54]本身。作者还包括了一个针对Deit-Base的均匀剪枝结果,其中为所有层固定一个均匀的剪枝比例。
Main results
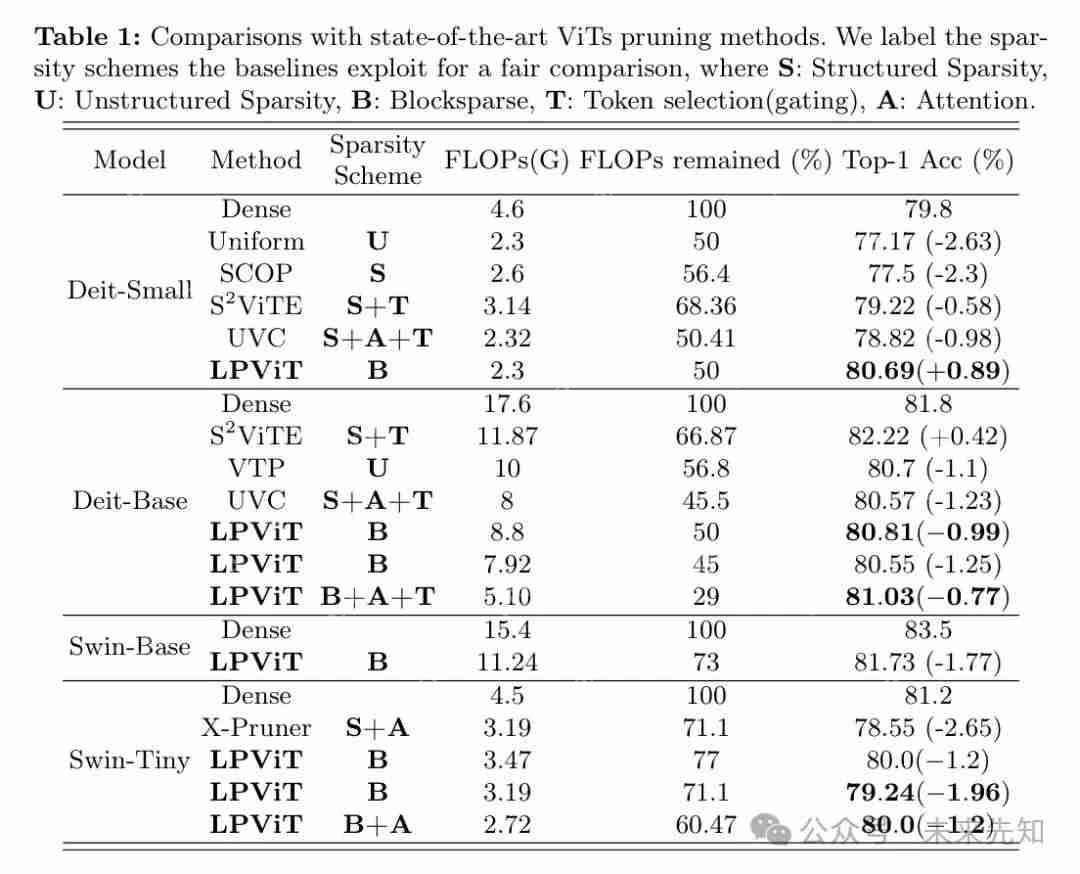
正如表1所示,作者首先注意到,在Deit-Small上的结果表明,作者的方法在不损失性能的情况下,甚至比密集模型高出0.89%,而FLOPs大致相同,大幅超过了现有 Baseline 。在更大的架构DeiT-Base上,作者的方法虽然提升不太明显,但在Top-1准确率上仍然保持了一致,在剩余50% FLOPs时达到80.81%,在大约45% FLOPs时达到80.55%。这是一个直观的观察,因为像结构剪枝这样的更粗糙的剪枝模式会对较小模型性能造成更大的伤害,而对于具有更多冗余权重的大型模型则影响较小,这也是像作者提出的块稀疏性这样的小结构能够在确保比无结构剪枝更快加速的同时保留更多性能的原因。在DeiT-Small上,作者超越了所有现有的混合方法,这些方法利用了 Patch 瘦身或标记选择。在更大的模型DeiT-Base上,作者仍然具有竞争力,同时作者注意到SViTE不能实现与作者相等的FLOPs减少。对于非全局注意力 Transformer ,如Swin Transformer,LPViT与其他ViT剪枝方法相比仍然具有竞争力,在FLOPs 71.7%时,Swin-Tiny上的性能仅下降1.96%。作者在Swin-Base上也仅报告了1.77%的下降。尽管DeiT-B上的参数比DeiT-S多,但作者在这上面的提升较少。尽管这可能看起来违反直觉,但原因可能是在微调阶段,较大的模型更容易过拟合,因此无法完全恢复准确性。这也可能是由于剪枝的正则化效果,有利于OOB数据性能,这在许多先前论文中已被发现[34]。同时,LPViT是一个通用框架,也支持与其他稀疏性集成。当与注意力和标记剪枝结合使用时,LPViT进一步提高了DeiT-Base和Swin-Tiny的准确性,甚至使用更少的FLOPs。
Hardware Performance Benchmarks
作者在三种类型的硬件平台上评估了剪枝模型的推理效率,包括速度提升和功耗降低,并在表2中总结了结果。首先,作者在支持各种块大小的GEMM的RISC-V平台ViTA [4]上模拟了ViTs的统计数据,这使得作者能够实现块稀疏模型的的理论速度提升。通过作者的方法,DeiT-Base和DeiT-Small分别获得了高达和的速度提升。然后,作者在高带宽平台Google TPU-V3 [25]上进行模拟。由于TPU V3只提供了一种固定为块大小的MAC,作者预计其速度提升不如RISC-V。尽管如此,对于DeiT-Base,作者仍然看到了正的速度提升。最后,作者在NVIDIA A100 40GB GPU上部署了模型,并使用CUDA 11.8评估了端到端推理时间和运行时功耗,观察到DeiT-Base的功耗降低了多达71.8%。功耗是通过在足够的时间段内平均nvidia-smi的功率计并减去空闲功耗来测量的。
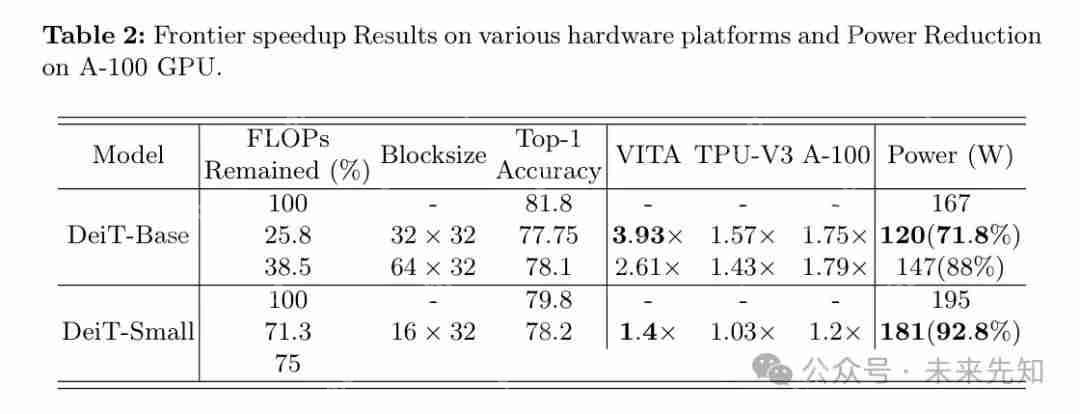
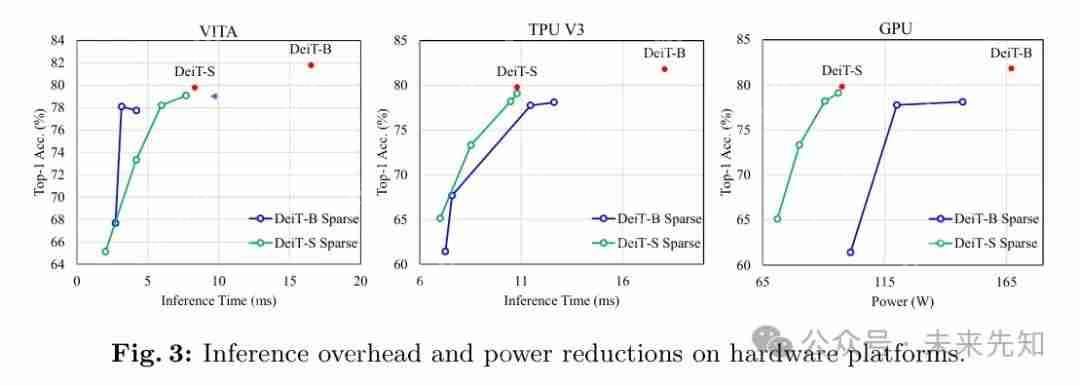
图3显示了将模型剪枝到不同大小时的结果,即不同剪枝水平下的推理时间和准确度。具体来说,每个点代表特定剪枝配置的一个结果。在图3中,作者观察到在VITA上,DeiT-B比DeiT-S获得了更好的权衡,而在TPU和GPU上,DeiT-S表现更好。这表明不同的硬件平台上,模型的表现可能会有所不同。
Ablation Study and Discussions
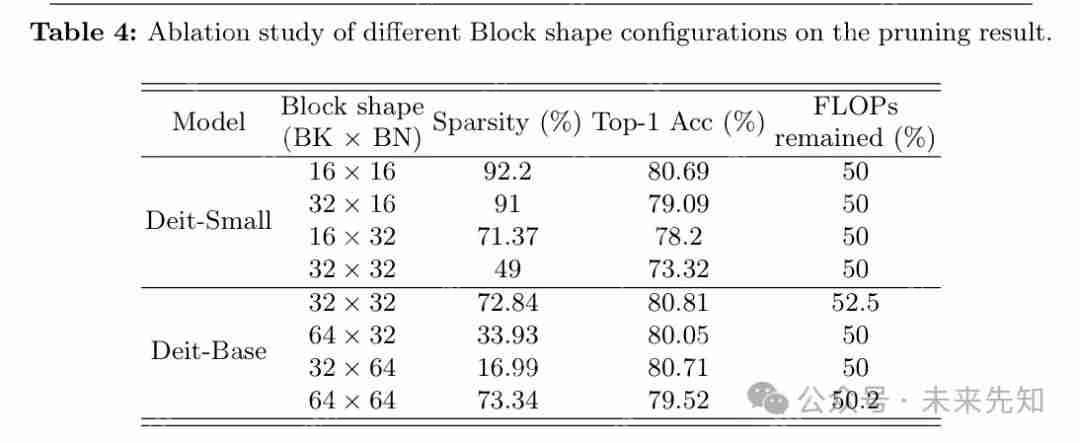
除了主要结果之外,作者还试图发现作者提出的剪枝方案中每个创造性部分如何对最终结果做出贡献,例如基本的-objective约束调节功率消耗和块稀疏结构,并回答诸如功率约束为何有利于性能等重要问题。作者在表3和表4中展示了详细的消融研究。
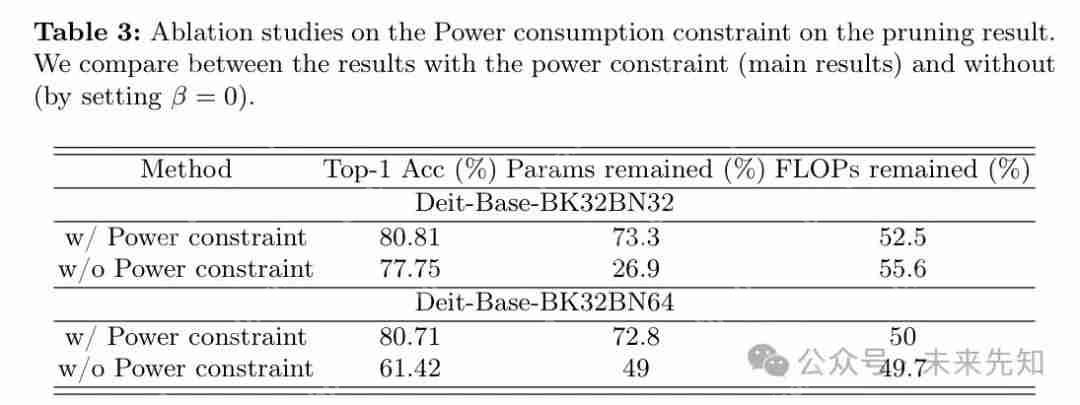
功率约束。作者将带有与不带有方程10中第二项功率消耗的剪枝目标的行为进行了比较。如表3所示,作者注意到在相同的FLOPs降低率50%下,作者最终的剪枝方案(带有功率约束)在不同的块形状下始终给出显著更高的结果。这是一个鼓舞人心的现象,因为功率约束并非旨在首先提高模型准确度。通过检查模型稀疏性,作者了解到提出的功率约束寻找具有更大matmul维度的层,以分配更多的剪枝配额以实现最大程度的计算减少,而且通常更大的层具有更多的参数冗余。因此,这种剪枝比例分配实际上与主要目标协同工作,以最小化输出失真。
块结构配置。作者的优化方案如何适应不同的块大小配置对于在不同的硬件平台上,具有不同并行度的一般化至关重要。因此,作者进行了消融研究,变化不同的块形状组合,如表4所列。首先,作者观察到较小的块大小保留了更多的模型准确度。其次,作者注意到较小的网络对于块形状的变化更为敏感,不同的块大小导致网络中剩余参数数量的剧烈变化。
逐层稀疏性分配。作者如下展示了每个单独设置的优化结果。作者注意到一些有趣的观察。首先,LPViT在DeiT-B和DeiT-S的不同剪枝比例下,在最后的 Transformer 块中保留了更多的连接,包括分类头,并且分类头在所有情况下几乎都未被剪枝。其次,在DeiT-B和DeiT-S上,作者注意到特别是在MHA之后的投影层总是得到高剪枝比例,表明ViTs中的投影层具有更多的冗余,对模型性能的影响最小。上述模式都是自动从作者的二阶剪枝逐层稀疏性分配算法中学习的,显示出作者方法的有效性。
4.2.2 Self-attention Maps.
图4:使用文献[8]中提供的可视化工具,展示了DeiT-Base、SViTE-Base结构化/非结构化剪枝模型以及作者的LSP-DeiT-Base模型(12层和12个注意力头)的注意力概率。
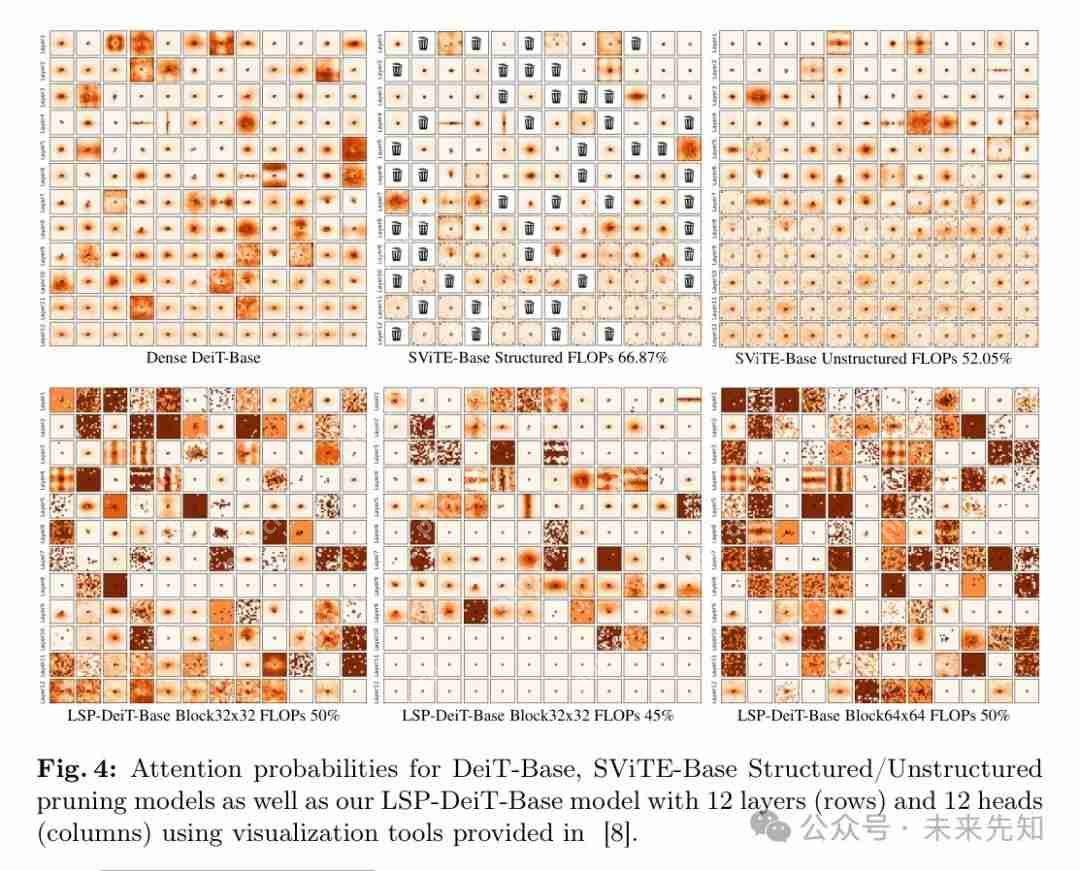
如图4所示,作者遵循文献[6, 8]中采用的相同的自注意力图可视化过程,以展示剪枝对 Transformer 多注意力头中注意力行为潜在影响的。作者观察到,作者的LSP块稀疏剪枝方案在许多 Transformer 块的注意力头中显示出粗糙和离散化的模式,伴随着一些完全不活跃的注意力头,这使得作者可以通过直接跳过这些注意力头来进一步加速推理。与结构化剪枝方案相比,作者的半结构化方案允许在空白注意力和密集模型中的精细模式之间的中间状态,保留了更多对模型精度至关重要的注意力信息。在LSP-DeiT-Base(FLOPs 45%)上,最后两个注意力层没有活跃的注意力头。因此,在计算中可以完全丢弃这些块,这可能会使报告的FLOPs减少更多。
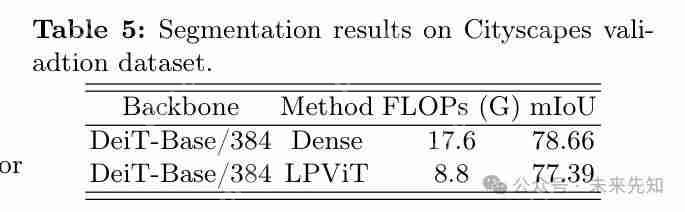
迁移学习到底层任务。 为了评估LPViT在下游任务上的泛化能力,作者进一步评估了作者的方法在下游Cityscapes [10] 分割任务上的迁移学习性能。作者首先在ImageNet上对DeiT-B/384模型进行了50% FLOPS的剪枝预处理,训练了27个周期,然后将其作为最近分割模型SETR [57] 的主干,并在Cityscapes数据集上进行训练。表5比较了剪枝主干和原始性能的验证mIoU。作者只观察到性能降低了1.27 mIoU。
5 Conclusions
在这项工作中,作者提出了一种新的视觉 Transformer (ViTs)权重剪枝算法,旨在降低推理过程中的能源消耗。
利用ViT架构以线性层为中心的结构,作者引入了一种半结构化的剪枝方案,以平衡微调稳定性和硬件效率。尽管采用了基于海森的剪枝准则,但作者的算法仍然非常高效。
在ImageNet上对各种ViTs进行的实验结果表明,该方法能够找到最优的剪枝解决方案,最大限度地提高块稀疏模型的准确性。
此外,作者还展示了作者提出的考虑功率意识的剪枝目标的双重好处,即提高了软件准确性和硬件加速。
参考
[1].LPViT: Low-Power Semi-structured Pruning for Vision Transformers.
以上就是从 DeiT-B 到 DeiT-S,块结构化剪枝在深度 ViTs上 的应用 !的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/462890.html
 微信扫一扫
 支付宝扫一扫