Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
复现篇:Vision Transform复现及讲解_创想鸟

复现篇:Vision Transform复现及讲解

本文介绍Vision Transformer,其不依赖CNN,适用于图像分类与迁移学习。含PatchEmbedding层(图片分块嵌入,加位置和分类token)、多头自注意力层、Encoder层(组合注意力与MLP等),整体结构在大型数据集上表现超SOTA模型。

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
复现篇:vision transform复现及讲解 - 创想鸟

整体介绍

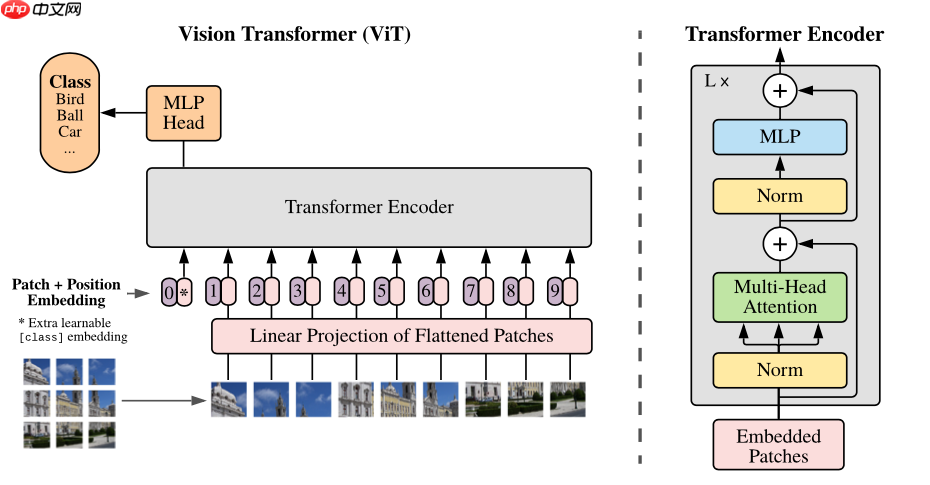
  当前Transformer模型被大量应用在NLP自然语言处理当中,而在计算机视觉领域,Transformer的注意力机制attention也被广泛应用,比如Se模块,CBAM模块等等注意力模块,这些注意力模块能够帮助提升网络性能。而我们的工作展示了不需要依赖CNN的结构,也可以在图像分类任务上达到很好的效果,并且也十分适合用于迁移学习。Vision Transformer将CV和NLP领域知识结合起来,对原始图片进行分块,展平成序列,输入进原始Transformer模型的编码器Encoder部分,最后接入一个全连接层对图片进行分类。在大型数据集上表现超过了当前SOTA模型
   

复现篇:Vision Transform复现及讲解 - 创想鸟        

PatchEmbedding层

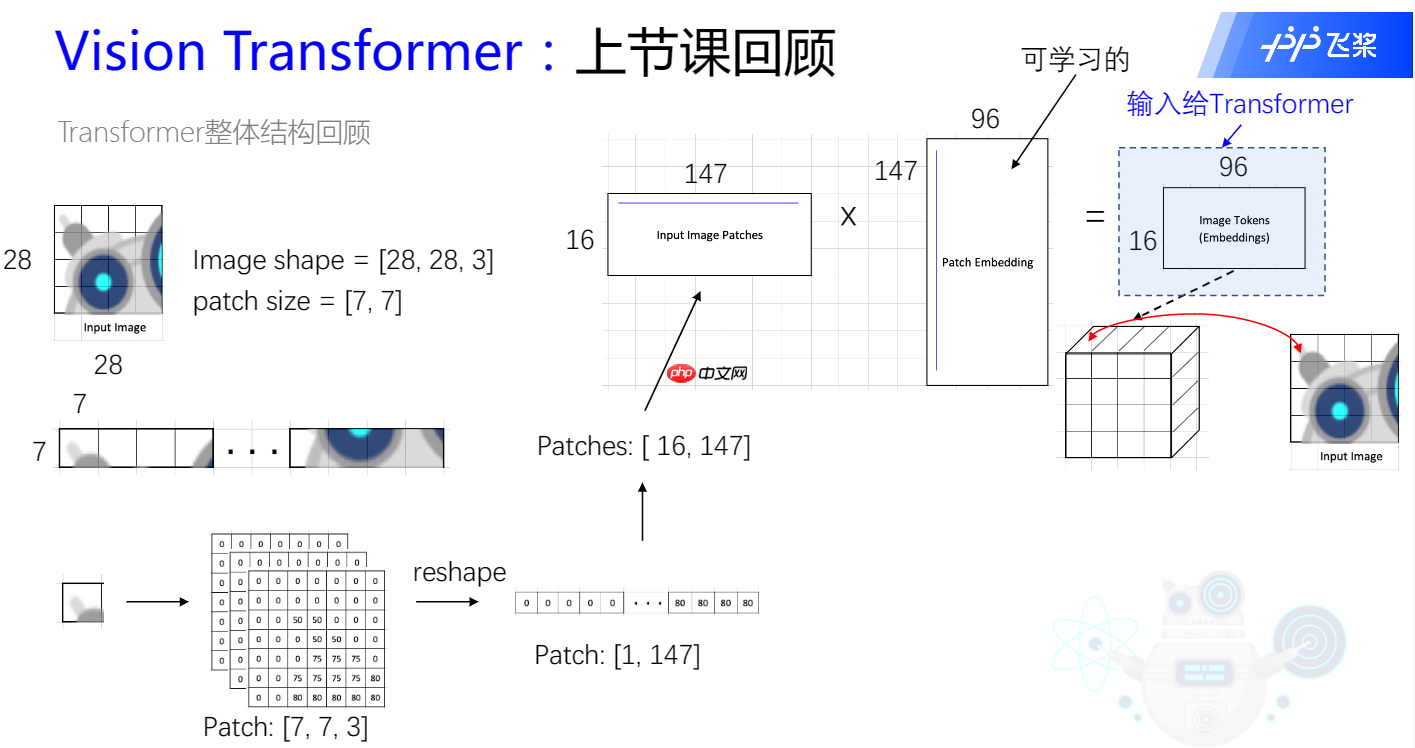
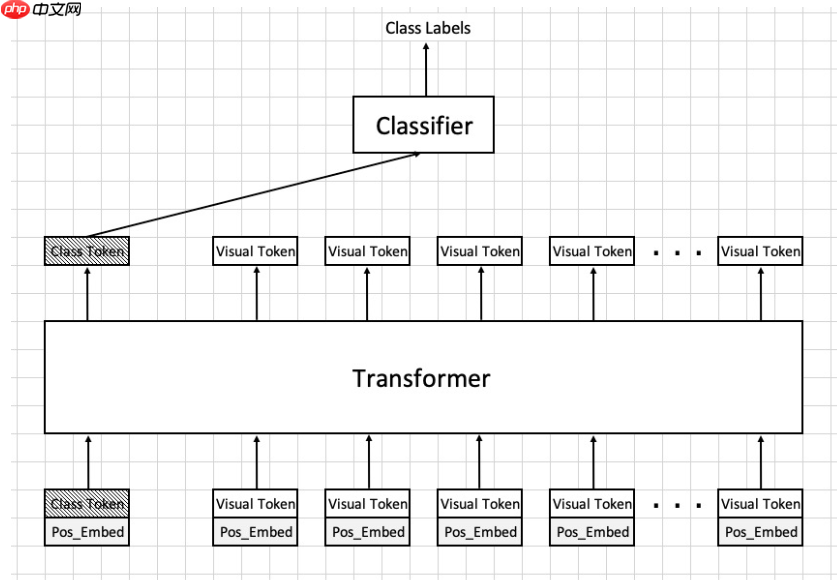
PatchEmbeddingPatchEmbedding主要是将输入的图片进行”分词”,将图片转换成一个一个的小块传入,在NLP里就对应sequencesequence,具体来说,例如下图所示,我们传进去的是(3,28,28)(3,28,28)的图片,经过Embedding层之后就会变成16个7∗716个7∗7 的小块,之后通过flatten将(7,7,3)(7,7,3)打平成147个像素点,于是就变成(16,147)(16,147),16就是我们所说的numpatchsnumpatchs,147147再接上全连接层后对应的就是embeddimembeddim,在传进transformstransforms之前需要将每一个tokentoken附上每一块的位置信息和分类模块,这里叫positionembeddingpositionembedding和classtokenclasstoken,二者值的确定都是可学习的参数,需要经过神经网络的学习进行优化
复现篇:Vision Transform复现及讲解 - 创想鸟        

复现篇:Vision Transform复现及讲解 - 创想鸟        

In [7]

import paddleimport paddle.nn as nnclass PatchEmbedding(nn.Layer):    def __init__(self, image_size=224, patch_size=16, in_channels=3, embed_dim=768, dropout=0.):        super().__init__()        n_patches = (image_size // patch_size) * (image_size // patch_size)        self.patch_embedding = nn.Conv2D(in_channels=in_channels,                                         out_channels=embed_dim,                                         kernel_size=patch_size,                                         stride=patch_size)        self.dropout = nn.Dropout(dropout)        self.class_token = paddle.create_parameter(                shape=[1, 1, embed_dim],                dtype='float32',                default_initializer=nn.initializer.Constant(0.))        self.position_embedding = paddle.create_parameter(                shape=[1, n_patches+1, embed_dim],                dtype='float32',                default_initializer=nn.initializer.TruncatedNormal(std=.02))    def forward(self, x):        # [n, c, h, w]        clss_tokens = self.class_token.expand([x.shape[0], -1, -1]) # for batch,直接在第一个class_token后添加第一个X,之后将其拼接到X后        x = self.patch_embedding(x)  # [n, embed_dim, h', w']        x = x.flatten(2)        x = x.transpose([0, 2, 1])        x = paddle.concat([clss_tokens, x], axis=1)        return x


attention层

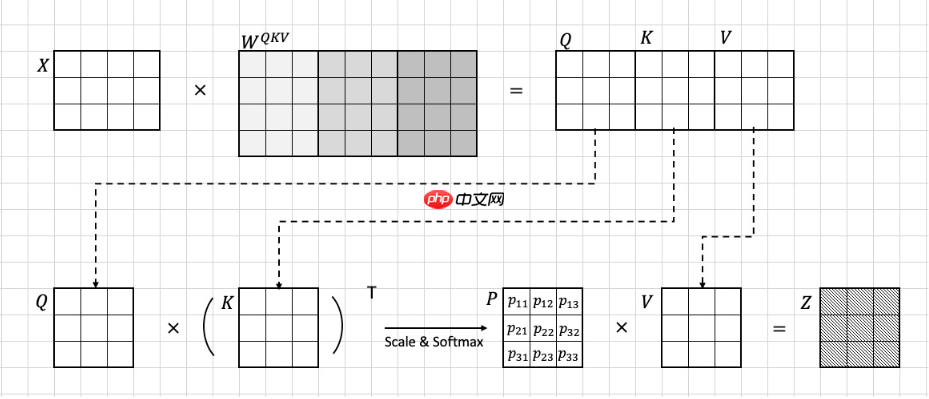
transformtransform里面最重要的部分可以说就是attentionattention层,attentionattention层的思路也是起源于NLP,为了找到每一个patchpatch与它附近的小块的信息,attentionattention的目的就是使每一个tokentoken注意到其他部分的信息,也叫自注意力机制。具体地,如下图所示,X是Embedding的输出,可以看到他的patch数量是3,也就是说有3个token,这里看到图中的WqWkWvWqWkWv和PP都是可学习的参数,其中我们将QKVQKV合成一个大的矩阵,目的是后续直接将该矩阵切成三份,QKQK的作用就是和其他的tokentoken做运算之后经过scaleforsoftmaxscaleforsoftmax,收集它们的信息,之后在和VV增加网络的复杂度
复现篇:Vision Transform复现及讲解 - 创想鸟        

In [8]

class Attention(nn.Layer):    """multi-head self attention"""    def __init__(self, embed_dim, num_heads, qkv_bias=True, dropout=0., attention_dropout=0.):        super().__init__()        self.num_heads = num_heads        self.head_dim = int(embed_dim / num_heads)        self.all_head_dim = self.head_dim * num_heads        self.scales = self.head_dim ** -0.5        self.qkv = nn.Linear(embed_dim,                             self.all_head_dim * 3)        self.proj = nn.Linear(embed_dim, embed_dim)        self.dropout = nn.Dropout(dropout)        self.attention_dropout = nn.Dropout(attention_dropout)        self.softmax = nn.Softmax(axis=-1)    def transpose_multihead(self, x):        # x: [N, num_patches, all_head_dim] -> [N, n_heads, num_patches, head_dim]        new_shape = x.shape[:-1] + [self.num_heads, self.head_dim]        x = x.reshape(new_shape)        x = x.transpose([0, 2, 1, 3])        return x    def forward(self, x):        B, N, _ = x.shape        # x -> [N, num_patches, dim]        # x -> q, k, v        qkv = self.qkv(x).chunk(3, axis=-1)  # 切分qkv        q, k, v = map(self.transpose_multihead, qkv)        attn = paddle.matmul(q, k, transpose_y=True) # q * k'        attn = attn * self.scales        attn = self.softmax(attn)        attn = self.attention_dropout(attn)        out = paddle.matmul(attn, v)         out = out.transpose([0, 2, 1, 3])        out = out.reshape([B, N, -1])        out = self.proj(out)                return out


Encoder层

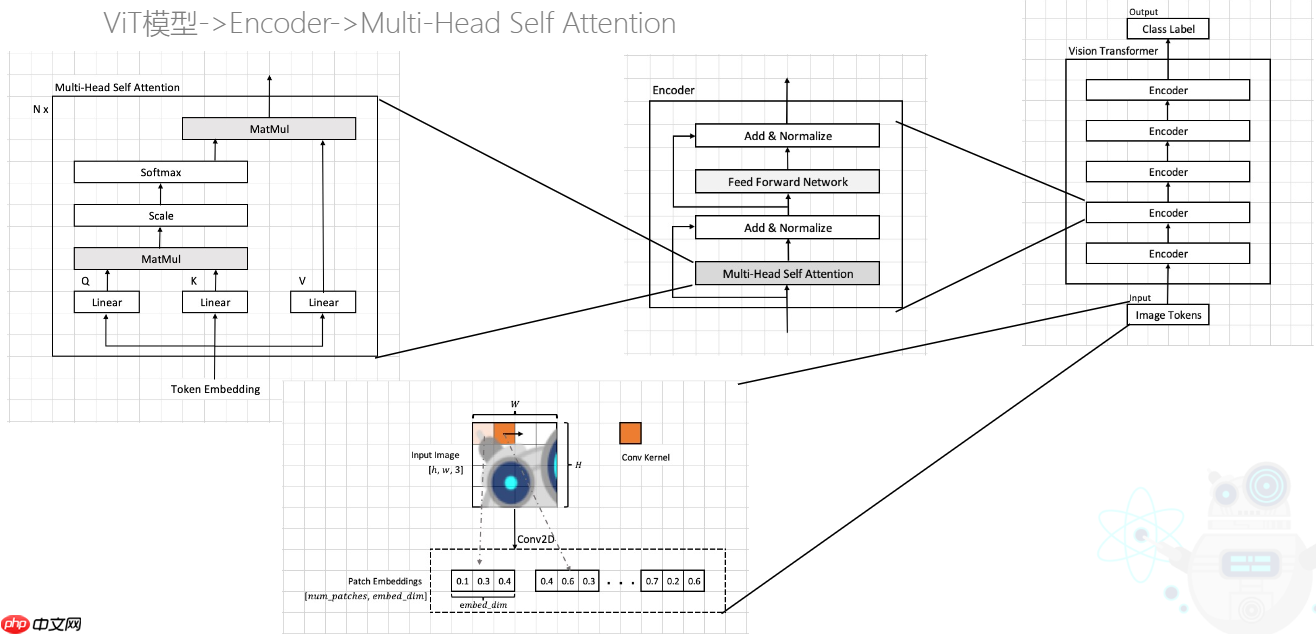
可以看到,在实现最重要的attentionattention之后,还需要实现MLPMLP,layearnormalizelayearnormalize以及残差层链接,组成EncoderEncoder层,五个EncoderEncoder组成一个transformtransform,在每个EncoderEncoder以及每个MLPMLP,layearnormalizelayearnormalize都不会改变数据的维度,目的是我们增加层数时不会变更太多
复现篇:Vision Transform复现及讲解 - 创想鸟        

In [10]

class Identity(nn.Layer):    def __init__(self):        super().__init__()    def forward(self, x):        return xclass Mlp(nn.Layer):    def __init__(self, embed_dim, mlp_ratio, dropout=0.):        super().__init__()        self.fc1 = nn.Linear(embed_dim, int(embed_dim * mlp_ratio))        self.fc2 = nn.Linear(int(embed_dim * mlp_ratio), embed_dim)        self.act = nn.GELU()        self.dropout = nn.Dropout(dropout)    def forward(self, x):        x = self.fc1(x)        x = self.act(x)        x = self.dropout(x)        x = self.fc2(x)        x = self.dropout(x)        return xclass EncoderLayer(nn.Layer):    def __init__(self, embed_dim=768, num_heads=4, qkv_bias=True, mlp_ratio=4.0, dropout=0., attention_dropout=0.):        super().__init__()        self.attn_norm = nn.LayerNorm(embed_dim)        self.attn = Attention(embed_dim, num_heads)        self.mlp_norm = nn.LayerNorm(embed_dim)        self.mlp = Mlp(embed_dim, mlp_ratio)    def forward(self, x):        # TODO        h = x  # residual        x = self.attn_norm(x)        x = self.attn(x)        x = x + h        h = x        x = self.mlp_norm(x)        x = self.mlp(x)        x = x + h        return x        class Encoder(nn.Layer):    def __init__(self, embed_dim, depth):        super().__init__()        layer_list = []        for i in range(depth):            encoder_layer = EncoderLayer()            layer_list.append(encoder_layer)        self.layers = nn.LayerList(layer_list)        self.norm = nn.LayerNorm(embed_dim)    def forward(self, x):        for layer in self.layers:            x = layer(x)        x = self.norm(x)        return x  class VisualTransformer(nn.Layer):    def __init__(self,                 image_size=224,                 patch_size=16,                 in_channels=3,                 num_classes=1000,                 embed_dim=768,                 depth=3,                 num_heads=8,                 mlp_ratio=4,                 qkv_bias=True,                 dropout=0.,                 attention_dropout=0.,                 droppath=0.):        super().__init__()        self.patch_embedding = PatchEmbedding(image_size, patch_size, in_channels, embed_dim)        self.encoder = Encoder(embed_dim, depth)        self.classifier = nn.Linear(embed_dim, num_classes)    def forward(self, x):        # x:[N, C, H, W]        x = self.patch_embedding(x)  # [N, embed_dim, h', w']        # x = x.flatten(2)  # [N, embed_dim, h'*w'] h'*w'=num_patches        # x = x.transpose([0, 2, 1])  # [N, num_patches, embed_dim]        print(x.shape)        x = self.encoder(x)        print(x.shape)        x = self.classifier(x[:, 0])        return xdef main():    t = paddle.randn([4, 3, 224, 224])    vit = VisualTransformer()    out=vit(t)    print('aaaaaaaaaa',out.shape)    paddle.summary(vit, (4, 3, 224, 224)) #查看网络详细信息if __name__ == "__main__":    main()


以上就是复现篇:Vision Transform复现及讲解的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/47271.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
visual studio code 可以运行 javascript 吗
上一篇 2025年11月7日 22:55:21
下一篇 2025年11月7日 22:57:24

相关推荐

  • tk做养生类目起号前期发什么视频?tk表示什么类目?

    在TikTok上运营养生类账号,起号阶段的内容策略尤为关键。优质的内容不仅能快速吸引目标用户,还能为后续发展奠定良好基础。本文将深入解析初期应发布的视频类型,并澄清“TK”所指的平台属性及内容分类体系。 一、养生类目起号初期适合发布哪些视频内容? 刚开始做养生赛道时,重点不在于变现,而在于建立专业形…

    2026年9月22日
    000
  • PHP如何利用缓存优化实时输出_PHP实时输出与缓存结合优化

    PHP实时输出需结合输出缓冲控制与flush()强制推送,同时考虑服务器和浏览器缓存影响;2. 长时间任务应使用APCu或Redis缓存频繁数据,避免重复计算;3. 动态页面可采用分块输出与片段缓存策略,静态内容从缓存读取,动态部分边生成边输出;4. 更优方案是通过异步任务与Redis存储进度,前端…

    2026年9月22日
    000
  • 华为天际通Go将支持eSIM:设备在路上了

    华为天际通Go将支持eSIM:设备在路上了华为天际通Go将支持eSIM:设备在路上了华为天际通Go将支持eSIM:设备在路上了华为天际通Go将支持eSIM:设备在路上了

    9月3日消息,今年的iphone 17 air将仅支持esim,彻底移除实体sim卡槽结构。随着新品发布日期的临近,国内esim政策的进展也愈发引人关注。 然而综合多方信息来看,iPhone 17 Air国行版本可能无法赶上首发,因前期在国内无法使用eSIM服务,导致该机型短期内难以在国内上市。 相…

    2026年9月22日 用户投稿
    000
  • VSCode配置C语言调试环境 从零开始VSCode搭建C开发工具

    要从零开始在#%#$#%@%@%$#%$#%#%#$%@_e2fc++805085e25c9761616c00e065bfe8中搭建c语言开发和调试环境,首先需安装vscode本体、c/c++编译器(如mingw或gcc)并配置系统环境变量,接着安装vscode的c/c++扩展,然后创建项目并编写c…

    2026年9月22日
    000
  • 如何用PhotoLab的AI裁剪图片?快速实现智能图像裁剪教程

    如何用PhotoLab的AI裁剪图片?快速实现智能图像裁剪教程如何用PhotoLab的AI裁剪图片?快速实现智能图像裁剪教程如何用PhotoLab的AI裁剪图片?快速实现智能图像裁剪教程如何用PhotoLab的AI裁剪图片?快速实现智能图像裁剪教程

    PhotoLab的AI裁剪功能通过智能识别主体与构图原则,提供优化裁剪建议,区别于传统手动裁剪的纯物理操作,能自动应用美学法则提升照片视觉吸引力;在人像、社交媒体适配、风景静物等场景中表现突出,尤其擅长保留核心焦点并适配多平台比例;用户可导入图片后使用AI裁剪工具,系统分析画面并生成建议裁剪框,支持…

    2026年9月22日 用户投稿
    000
  • 递归实现列表排序检查与条件移除最大值

    本文详细介绍了如何使用Java递归方法处理整数列表。核心内容包括:首先检查列表是否已排序,如果已排序则直接返回false;如果未排序,则查找列表中的最大值。仅当最大值位于列表的起始或结束位置时,才将其移除并递归地继续处理列表。如果最大值位于列表中间,则打印当前列表并终止递归。 在数据处理和算法设计中…

    2026年9月22日
    000
  • VSCode如何实现代码可视化调试 VSCode执行流程图形化分析方法

    vscode的可视化调试功能通过内置调试器和扩展生态,显著提升代码理解与问题排查效率。1. 首先配置launch.json文件以定义调试环境,支持多种语言如node.js、python等;2. 在代码中设置断点,程序运行至断点时暂停,便于检查变量状态和执行上下文;3. 利用调试面板查看变量、监视表达…

    2026年9月22日
    000
  • MySQL备份压缩与加密技巧_MySQL提升备份安全与效率

    MySQL备份压缩与加密技巧_MySQL提升备份安全与效率MySQL备份压缩与加密技巧_MySQL提升备份安全与效率MySQL备份压缩与加密技巧_MySQL提升备份安全与效率MySQL备份压缩与加密技巧_MySQL提升备份安全与效率

    mysql备份压缩与加密的核心在于减少存储空间并提升数据安全性。1. 压缩能显著降低存储成本,提升传输效率,加快恢复速度,简化备份管理,并有助于满足合规要求;2. 加密则通过防止未授权访问保障数据安全。实现方式主要有:1. 使用mysqldump结合gzip和gpg/openssl进行逻辑备份、压缩…

    2026年9月22日 用户投稿
    100
  • VS Code中Dockerized PHP项目:解决PHP版本冲突的教程

    本教程旨在解决在VS Code中开发Dockerized PHP项目时,VS Code默认识别宿主机PHP版本而非容器内PHP版本的问题。核心解决方案是利用VS Code的Remote – Containers扩展,实现直接在Docker容器内部进行代码开发,从而确保VS Code及其所…

    2026年9月22日
    200
  • 蔡司2亿影像大小王,年度影像旗舰vivo X300系列发布!

    蔡司2亿影像大小王,年度影像旗舰vivo X300系列发布!蔡司2亿影像大小王,年度影像旗舰vivo X300系列发布!蔡司2亿影像大小王,年度影像旗舰vivo X300系列发布!蔡司2亿影像大小王,年度影像旗舰vivo X300系列发布!

    PConline最新资讯,vivo于今晚正式揭晓X300系列新机,定位“全焦段影像旗舰”,起售价为4399元。该系列成为首款搭载联发科天玑9500芯片的智能手机,并携手三星与索尼共同定制多颗影像传感器,在影像能力、屏幕素质及续航表现上力求全面跃升。 产品线涵盖X300与X300 Pro两款机型,价格…

    2026年9月22日 用户投稿
    000
  • 从AI场景搭建到蝴蝶号运营,全流程实战攻略

    从AI场景搭建到蝴蝶号运营,全流程实战攻略从AI场景搭建到蝴蝶号运营,全流程实战攻略从AI场景搭建到蝴蝶号运营,全流程实战攻略从AI场景搭建到蝴蝶号运营,全流程实战攻略

    做ai内容变现需先明确方向再选工具,注册蝴蝶号要模拟真实行为,用ai提升效率但需调整内容细节,流量转化重于播放量。一、先确定内容类型和风格,根据方向选择合适ai工具链搭建流程,用免费api测试效果。二、蝴蝶号注册尽量用企业主体,资料完整,养号阶段关注同类账号,保持每天发布1~2条内容,视频控制在30…

    2026年9月22日 用户投稿
    100
  • GIMP中如何利用AI裁剪图片?一步步完成高效图像裁剪方法

    GIMP虽无“一键AI裁剪”功能,但可通过智能选择工具(如前景选择、智能剪刀)精准选中主体,结合Resynthesizer插件的内容感知填充实现类AI裁剪效果;对于更高要求,可协同Remove.bg等外部AI工具完成自动抠图,再导入GIMP进行裁剪或背景替换,形成高效智能裁剪工作流。 ☞☞☞AI 智…

    2026年9月22日
    100
  • 疑似荣耀500系列入网 代号Merry全系支持80W有线快充

    10月25日,知名数码博主“数码闲聊站”透露,荣耀500系列新机已现身工信部,型号分别为mep-an00和mey-an00,预计代号为merry/merryp,全系支持80w有线快充。该博主还表示,此前上手的样机提供了黑色、银色、粉色和蓝色等多种配色方案,外观设计或将延续前代爆款风格。 据最新消息,…

    2026年9月22日
    000
  • Vision Transformer 必读系列之图像分类综述(三): MLP、ConvMixer 和架构分析

    Vision Transformer 必读系列之图像分类综述(三): MLP、ConvMixer 和架构分析Vision Transformer 必读系列之图像分类综述(三): MLP、ConvMixer 和架构分析Vision Transformer 必读系列之图像分类综述(三): MLP、ConvMixer 和架构分析Vision Transformer 必读系列之图像分类综述(三): MLP、ConvMixer 和架构分析

    号外号外!awesome-vit 上新啦, 欢迎大家 Star Star Star ~ https://github.com/open-mmlab/awesome-vit 前言 在 Vision Transformer 必读系列之图像分类综述(一):概述 一文中对 Vision Transforme…

    2026年9月22日 用户投稿
    200
  • 蝴蝶号无人直播完整流程详解:搭建+开播+引流

    蝴蝶号无人直播完整流程详解:搭建+开播+引流蝴蝶号无人直播完整流程详解:搭建+开播+引流蝴蝶号无人直播完整流程详解:搭建+开播+引流蝴蝶号无人直播完整流程详解:搭建+开播+引流

    蝴蝶号无人直播的完整流程包括前期准备、直播搭建、开播设置、引流推广、监控与维护五个步骤。前期准备需完成账号注册认证、硬件设备配置、软件安装及素材准备;直播搭建涉及场景设置、素材导入、循环播放设定及自动化脚本配置;开播设置包括直播间信息填写、推流配置与测试直播;引流推广可通过平台内工具、社交媒体、内容…

    2026年9月22日 用户投稿
    100
  • 如何在VEED.io中制作AI视频?在线工具快速剪辑AI内容的步骤

    如何在VEED.io中制作AI视频?在线工具快速剪辑AI内容的步骤如何在VEED.io中制作AI视频?在线工具快速剪辑AI内容的步骤如何在VEED.io中制作AI视频?在线工具快速剪辑AI内容的步骤如何在VEED.io中制作AI视频?在线工具快速剪辑AI内容的步骤

    VEED.io通过“文本转视频”和“AI形象”功能,让视频制作变得简单高效。用户只需输入文本,即可生成带AI配音、字幕和匹配素材的视频,或选择AI虚拟人物进行口型同步播报。平台还提供AI语音合成、自动字幕、多语言支持及丰富编辑功能,便于后期精修。优化效果需从高质量文本入手,合理选择声音与形象,并通过…

    2026年9月22日 用户投稿
    000
  • Java中递归处理列表:条件性移除最大值策略与实现

    本教程深入探讨了如何在Java中使用递归方法,根据特定条件(如列表是否已排序、最大值是否位于列表的首尾)来移除列表中的最大值。文章将详细阐述如何设计一个高效的递归算法,包括排序检查、最大值定位以及条件性移除的实现细节,并提供完整的代码示例和注意事项,帮助读者掌握递归在复杂列表操作中的应用。 引言:递…

    2026年9月22日
    000
  • 玩转 Spring Boot 集成篇(定时任务框架Quartz)

    玩转 Spring Boot 集成篇(定时任务框架Quartz)玩转 Spring Boot 集成篇(定时任务框架Quartz)玩转 Spring Boot 集成篇(定时任务框架Quartz)玩转 Spring Boot 集成篇(定时任务框架Quartz)

    在日常项目研发中,定时任务可谓是必不可少的一环,关于 spring boot 如何实现静态定时任务、动态定时任务以及如何开启多线程跑任务,均已在上篇分享过,不再赘述。 虽然 Spring Boot 内置注解方式实现的定时任务,在一定程度上也能解决一定的业务场景问题,但是若做更复杂的动作,例如启停任务…

    2026年9月22日 用户投稿
    100
  • Cortana如何连接邮箱_Cortana邮箱同步配置方法

    首先需将邮箱账户与Cortana连接,可通过Windows设置添加账户或在Cortana应用内手动配置,支持Outlook.com、Gmail及Exchange等类型;完成账户添加后,须在隐私权限中启用邮件读取和同步权限,确保Cortana可访问邮件、日历及联系人数据,从而实现智能提醒与信息同步功能…

    2026年9月22日
    000
  • 如何用Sublime导出MySQL数据表结构_生成Markdown或HTML格式文档

    要使用 sublime text 导出 mysql 数据表结构并生成 markdown 或 html 文档,需通过以下步骤操作:1. 使用 show create table 命令或 mysqldump 工具获取建表语句;2. 在 sublime 中整理字段信息,按字段名、类型、是否为空、键、默认值…

    2026年9月22日
    000

发表回复

登录后才能评论
关注微信