Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
650亿参数,8块GPU就能全参数微调:邱锡鹏团队把大模型门槛打下来了_创想鸟

650亿参数,8块GPU就能全参数微调:邱锡鹏团队把大模型门槛打下来了

在大模型方向上,科技巨头在训更大的模型,学界则在想办法搞优化。最近,优化算力的方法又上升到了新的高度。

大型语言模型(LLM)彻底改变了自然语言处理(NLP)领域,展示了涌现、顿悟等非凡能力。然而,若想构建出具备一定通用能力的模型,就需要数十亿参数,这大幅提高了 NLP 研究的门槛。在 LLM 模型调优过程中通常又需要昂贵的 GPU 资源,例如 8×80GB 的 GPU 设备,这使得小型实验室和公司很难参与这一领域的研究。

最近,人们正在研究参数高效的微调技术(PEFT),例如 LoRA 和 Prefix-tuning,为利用有限资源对 LLM 进行调优提供了解决方案。然而,这些方法并没有为全参数微调提供实用的解决方案,而全参数微调已被公认为是比参数高效微调更强大的方法。

在上周复旦大学邱锡鹏团队提交的论文《Full Parameter Fine-tuning for Large Language Models with Limited Resources》中,研究人员提出了一种新的优化器 LOw-Memory Optimization(LOMO)。

通过将 LOMO 与现有的内存节省技术集成,与标准方法(DeepSpeed 解决方案)相比,新方法将内存使用量减少到了之前的 10.8%。因此,新方法能够在一台具有 8×RTX 3090 的机器上对 65B 模型进行全参数微调,每个 RTX 3090 具有 24GB 内存。

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜

650亿参数,8块GPU就能全参数微调:邱锡鹏团队把大模型门槛打下来了

论文链接:https://arxiv.org/abs/2306.09782

在该工作中,作者分析了 LLM 中内存使用的四个方面:激活、优化器状态、梯度张量和参数,并对训练过程进行了三方面的优化:

从算法的角度重新思考了优化器的功能,发现 SGD 在微调 LLM 完整参数方面是一种很好的替代品。这使得作者可以删除优化器状态的整个部分,因为 SGD 不存储任何中间状态。新提出的优化器 LOMO 将梯度张量的内存使用量减少到 O (1),相当于最大梯度张量的内存使用量。为了使用 LOMO 稳定混合精度训练,作者集成了梯度归一化、损失缩放,并在训练期间将某些计算转换为全精度。

新技术让内存的使用等于参数使用加上激活和最大梯度张量。全参数微调的内存使用被推向了极致,其仅等同于推理的使用。这是因为 forward+backward 过程的内存占用应该不会比单独的 forward 过程少。值得注意的是,在使用 LOMO 节省内存时,新方法确保了微调过程不受影响,因为参数更新过程仍然等同于 SGD。

该研究评估了 LOMO 的内存和吞吐量性能,表明借助 LOMO,研究者在 8 个 RTX 3090 GPU 上就可以训练 65B 参数的模型。此外,为了验证 LOMO 在下游任务上的性能,他们应用 LOMO 来调优 SuperGLUE 数据集集合上 LLM 的全部参数。结果表明了 LOMO 对具有数十亿参数的 LLM 进行优化的有效性。

方法介绍

在方法部分,本文详细介绍了 LOMO(LOW-MEMORY OPTIMIZATION)。一般而言,梯度张量表示一个参数张量的梯度,其大小与参数相同,这样一来内存开销较大。而现有的深度学习框架如 PyTorch 会为所有参数存储梯度张量。现阶段,存储梯度张量有两方面原因:计算优化器状态以及归一化梯度。

由于该研究采用 SGD 作为优化器,因此没有依赖于梯度的优化器状态,并且他们有一些梯度归一化的替代方案。

他们提出了 LOMO,如算法 1 所示,LOMO 将梯度计算与参数更新融合在一个步骤中,从而避免了梯度张量的存储。

下图为 SGD 和 LOMO 在反向传播和参数更新阶段的比较。Pi 为模型参数,Gi 为 Pi 对应的梯度。LOMO 将梯度计算和参数更新融合到一个步骤中,使梯度张量最小。

650亿参数,8块GPU就能全参数微调:邱锡鹏团队把大模型门槛打下来了

LOMO 对应的算法伪代码:

可图大模型 可图大模型

可图大模型(Kolors)是快手大模型团队自研打造的文生图AI大模型

可图大模型 32 查看详情 可图大模型

650亿参数,8块GPU就能全参数微调:邱锡鹏团队把大模型门槛打下来了

具体而言,该研究将 vanilla 梯度下降表示为

650亿参数,8块GPU就能全参数微调:邱锡鹏团队把大模型门槛打下来了

,这是一个两步过程,首先是计算梯度,然后更新参数。融合版本为 

650亿参数,8块GPU就能全参数微调:邱锡鹏团队把大模型门槛打下来了

 该研究的关键思想是在计算梯度时立即更新参数,这样就不会在内存中存储梯度张量。这一步可以通过在向反向传播中注入 hook 函数来实现。PyTorch 提供了注入 hook 函数的相关 API,但却无法用当前的 API 实现精确的即时更新。相反,该研究在内存中最多存储一个参数的梯度,并随着反向传播逐一更新每个参数。本文方法减少了梯度的内存使用,从存储所有参数的梯度到只存储一个参数的梯度。

大部分 LOMO 内存使用与参数高效微调方法的内存使用一致,这表明 LOMO 与这些方法相结合只会导致梯度占用内存的轻微增加。这样就可以为 PEFT 方法调优更多的参数。

实验结果

在实验部分,研究者从三个方面评估了他们提出的方法,即内存使用情况、吞吐量和下游性能。如果不作进一步解释,所有的实验都是用 7B 到 65B 的 LLaMA 模型进行的。

内存使用情况

研究者首先剖析了,在不同设置下,训练期间的模型状态和激活的内存使用情况。如表 1 所示,与 AdamW 优化器相比,LOMO 优化器的使用导致内存占用大幅减少,从 102.20GB 减少到 14.58GB;与 SGD 相比,在训练 LLaMA-7B 模型时,内存占用从 51.99GB 减少到 14.58GB。内存用量的大幅减少主要归因于梯度和优化器状态的内存需求减少。因此,在训练过程中,内存大部分被参数占据,与推理过程中的内存用量相当。

650亿参数,8块GPU就能全参数微调:邱锡鹏团队把大模型门槛打下来了

如图 2 所示,如果采用 AdamW 优化器进行 LLaMA-7B 训练,相当大比例的内存(73.7%)被分配给优化器状态。用 SGD 优化器替换 AdamW 优化器可以有效减少优化器状态占用内存的百分比,从而减轻 GPU 内存使用(从 102.20GB 减少到 51.99GB)。如果使用 LOMO,参数更新和 backward 会被融合到一个步骤中,进一步消除优化器状态对内存的需求。

650亿参数,8块GPU就能全参数微调:邱锡鹏团队把大模型门槛打下来了

吞吐量

研究者比较了 LOMO、AdamW 和 SGD 的吞吐性能。实验是在一台配备了 8 个 RTX 3090 GPU 的服务器上进行的。

对于 7B 的模型,LOMO 的吞吐量呈现显著优势,超过 AdamW 和 SGD 约 11 倍。这一重大改进可归功于 LOMO 在单个 GPU 上训练 7B 模型的能力,这减少了 GPU 间的通信开销。与 AdamW 相比,SGD 的吞吐量略高,这可归因于 SGD 排除了动量和方差的计算。

至于 13B 模型,由于内存的限制,它无法在现有的 8 个 RTX 3090 GPU 上用 AdamW 训练。在这种情况下,模型的并行性对 LOMO 来说是必要的,LOMO 在吞吐量方面仍然优于 SGD。这一优势归功于 LOMO 的内存高效特性,以及只需要两个 GPU 以相同的设置来训练模型,从而降低了通信成本,提高了吞吐量。此外,在训练 30B 模型时,SGD 在 8 个 RTX 3090 GPU 上遇到了内存不足(OOM)的问题,而 LOMO 在只有 4 个 GPU 的情况下表现良好。

最后,研究者使用 8 个 RTX 3090 GPU 成功训练了 65B 模型,实现了 4.93 TGS 的吞吐量。利用这样的服务器配置和 LOMO,模型在 1000 个样本上的训练过程(每个样本包含 512 个 token)大约需要 3.6 小时。

下游性能

为了评估 LOMO 在微调大型语言模型方面的有效性,研究者进行了一系列广泛的实验。他们将 LOMO 与其他两种方法进行比较,一种是不需要微调的 Zero-shot,另一种是目前很流行的参数高效微调技术 LoRA。

650亿参数,8块GPU就能全参数微调:邱锡鹏团队把大模型门槛打下来了

表 3 结果显示:LOMO 的表现明显好于 Zero-shot;在大多数实验中,LOMO 普遍优于 LoRA;LOMO 可以有效扩展至 650 亿参数的模型。

LOMO 和 LoRA 在本质上是相互独立的。为了验证这一说法,研究者使用 LLaMA-13B 在 BoolQ 和 MultiRC 数据集上进行了实验。结果如图 3 所示。

他们发现,LOMO 在持续增强 LoRA 的性能,不管 LoRA 取得的结果有多高。这表明,LOMO 和 LoRA 采用的不同微调方法是互补的。具体来说,LOMO 专注于微调预训练模型的权重,而 LoRA 则调整其他模块。因此,LOMO 不会影响到 LoRA 的性能;相反,它有助于对下游任务进行更好的模型调优。

650亿参数,8块GPU就能全参数微调:邱锡鹏团队把大模型门槛打下来了

更多细节参见原论文。

以上就是650亿参数,8块GPU就能全参数微调:邱锡鹏团队把大模型门槛打下来了的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/518574.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
win10怎么查找共享打印机
上一篇 2025年11月9日 04:23:47
微服务架构中Java框架的优势与局限
下一篇 2025年11月9日 04:23:48

相关推荐

  • 文博会现人工智能热潮 光峰科技激光科技再获关注

    5 月 22 日,为期 5 天的第二十一届中国(深圳)国际文化产业博览交易会(以下简称 ” 文博会 “)在深圳国际会展中心拉开帷幕。本届文博会共吸引了全球 6000 余家文化机构、文化企业和政府单位通过线上线下的方式参展,展出了超 12 万件的文化产品,再现文化产业 &#82…

    2026年9月11日
    100
  • deepseek官方社区网址_加入deepseek官方社区官网交流

    deepseek官方社区网址是https://chat.deepseek.com/,该平台提供互动交流、模型更新、技术文档、多语言支持及开源项目协作,同时支持实时对话、多终端同步与API集成。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ …

    2026年9月10日
    600
  • 特斯拉 FSD 加入大量全新渲染模型 玩滑板的人都能识别

    近日,有汽车领域博主爆料,特斯拉的fsd(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。 这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、…

    2026年9月8日
    100
  • 用慢思考提升模型安全性,北交大、鹏城实验室提出系统2对齐

    用慢思考提升模型安全性,北交大、鹏城实验室提出系统2对齐用慢思考提升模型安全性,北交大、鹏城实验室提出系统2对齐用慢思考提升模型安全性,北交大、鹏城实验室提出系统2对齐用慢思考提升模型安全性,北交大、鹏城实验室提出系统2对齐

    aixiv专栏:北京交通大学adam团队探索系统2对齐,提升大模型安全性 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 北京交通大学ADaM团队长期关注AI安全领域,此前已开源o1复现项目o1-Coder (https://www.php.…

    2026年9月7日 • 用户投稿
    000
  • Meta陷入恐慌?内部爆料:在疯狂分析复制DeepSeek,高预算难以解释

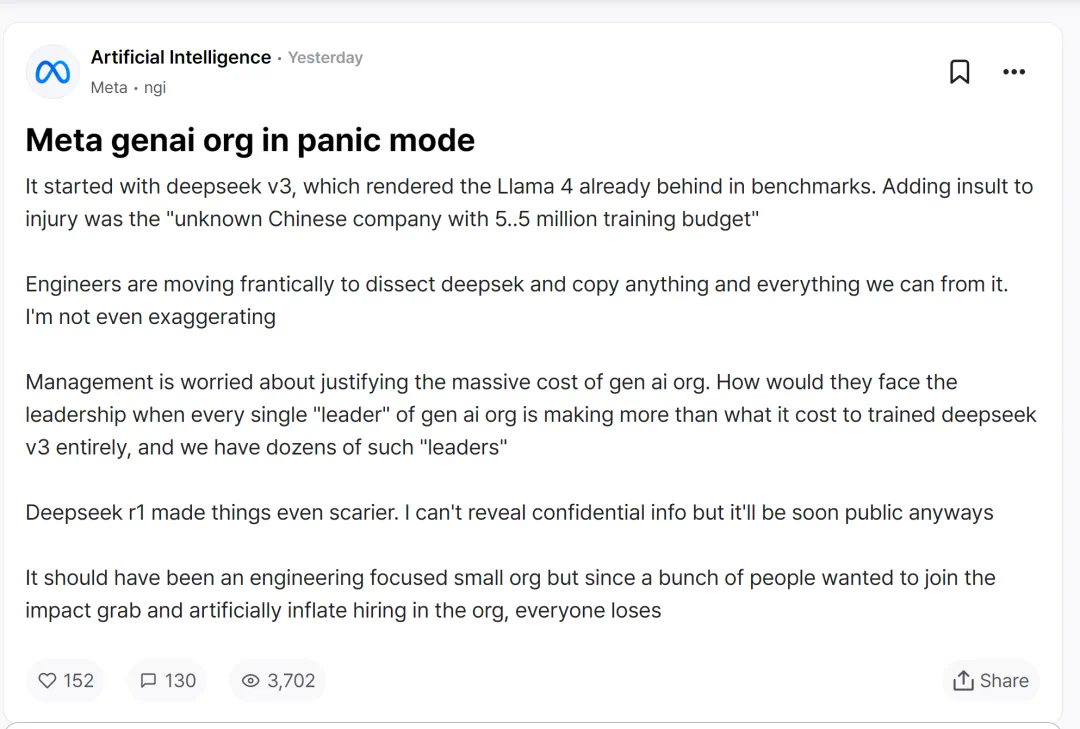
    Meta陷入恐慌?内部爆料:在疯狂分析复制DeepSeek,高预算难以解释Meta陷入恐慌?内部爆料:在疯狂分析复制DeepSeek,高预算难以解释Meta陷入恐慌?内部爆料:在疯狂分析复制DeepSeek,高预算难以解释Meta陷入恐慌?内部爆料:在疯狂分析复制DeepSeek,高预算难以解释

    deepseek开源大模型的横空出世,引发美国ai巨头恐慌,meta首当其冲。 近期,Meta员工在Teamblind匿名论坛爆料,DeepSeek一系列低成本高性能的模型发布,让Meta生成式AI团队面临巨大压力,其高昂预算的合理性受到质疑。 爆料帖原文指出,DeepSeek-V3在基准测试中超越…

    2026年9月7日 • 用户投稿
    000
  • 英洛华2024年度净利润预增167.98%-201.48%

    英洛华2024年度净利润预增167.98%-201.48%英洛华2024年度净利润预增167.98%-201.48%英洛华2024年度净利润预增167.98%-201.48%英洛华2024年度净利润预增167.98%-201.48%

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 华文笔杆 写材料用华文,华文笔杆帮你搞定公文写作 491 查看详情 1月25日,英洛华公布2024年度业绩预告,2024年归属于上市公司股东的净利润盈利2.4亿元~2.7亿元,比上年同期增长16…

    2026年9月7日 • 用户投稿
    900
  • DARWIN 1.5 来啦!材料设计通用大语言模型,刷新多项实验性质预测记录

    DARWIN 1.5 来啦!材料设计通用大语言模型,刷新多项实验性质预测记录DARWIN 1.5 来啦!材料设计通用大语言模型,刷新多项实验性质预测记录DARWIN 1.5 来啦!材料设计通用大语言模型,刷新多项实验性质预测记录DARWIN 1.5 来啦!材料设计通用大语言模型,刷新多项实验性质预测记录

    darwin 1.5:一款基于语言接口的材料发现与设计ai模型 材料科学的核心挑战在于高效地寻找理想的材料成分和结构。传统的计算方法,例如高通量筛选和机器学习,通常依赖于复杂的、特定任务的描述符,这些描述符难以泛化,且与真实材料特性存在偏差,限制了实际应用。为了克服这些局限,GreenDynamic…

    2026年9月6日 • 用户投稿
    000
  • 致敬DeepSeek:以国产GPU为基,燎原中国AI生态之火

    deepseek开源模型(v3、r1系列等)在多语言理解和复杂推理任务中表现出色,极大促进了ai技术发展,为开发者提供了重要资源。deepseek不仅技术领先,更积极回馈开源社区。 摩尔线程高效部署DeepSeek 国产GPU创新企业摩尔线程已高效部署DeepSeek蒸馏模型推理服务,助力开发者基于…

    2026年9月5日
    400
  • 石头洗地机A10 Plus体验:功能全面升级,体验如何?

    石头洗地机A10 Plus体验:功能全面升级,体验如何?石头洗地机A10 Plus体验:功能全面升级,体验如何?石头洗地机A10 Plus体验:功能全面升级,体验如何?石头洗地机A10 Plus体验:功能全面升级,体验如何?

    石头科技在家庭清洁产品的强劲势头有目共睹,自有品牌的扫地机器人不仅站稳了脚跟,做到持续扩大用户群体,并在高端扫地机器人引入集尘、拖地、自清洁等功能的新时期仍有不俗竞争力。这之后,石头更是进入扫地机器人之外的品类,推出了手持吸尘器和洗地机产品。 洗地机是扫地机器人后的又一个家庭清洁热门赛道,早早地涌入…

    2026年9月4日 • 用户投稿
    100
  • OPPO手环2图赏:手环身材、手表实力

    OPPO手环2图赏:手环身材、手表实力OPPO手环2图赏:手环身材、手表实力OPPO手环2图赏:手环身材、手表实力OPPO手环2图赏:手环身材、手表实力

    随着智能手环屏幕尺寸的增大,智能手环和智能手表之间的硬件差距已经越来越小,和刚刚面世时的智能手表相比,现在的智能手环仅在系统功能上有所差异,在产品形态上两者已经高度相似。 尽管这种“缝合”可能让智能手环显得有些不正宗,毕竟最初的智能手环连屏幕都没有。但从另一个角度看,由于智能手环的价格普遍低于智能手…

    2026年9月4日 • 用户投稿
    200
  • K60发布新一代顶级国产2K屏,性价比更上一层楼!

    K60发布新一代顶级国产2K屏,性价比更上一层楼!K60发布新一代顶级国产2K屏,性价比更上一层楼!K60发布新一代顶级国产2K屏,性价比更上一层楼!K60发布新一代顶级国产2K屏,性价比更上一层楼!

    如果你希望在2023年初买到核心性能突出,屏幕显示、充电续航也有领先之处的手机,那么redmi k60系列显然符合此类需求。定价和定位都“全系升杯”,redmi k60系列依然有着相当突出的性能属性,联合研发的顶级国产2k屏、30w无线充等更是给到了独一无二的闪光点。 (图源:雷科技) 就如同过去几…

    2026年9月3日 • 用户投稿
    000
  • 为了让DeepSeek-R1用起来更顺畅,火山引擎将TPM上调到了500万!全网首家

    为了让DeepSeek-R1用起来更顺畅,火山引擎将TPM上调到了500万!全网首家为了让DeepSeek-R1用起来更顺畅,火山引擎将TPM上调到了500万!全网首家为了让DeepSeek-R1用起来更顺畅,火山引擎将TPM上调到了500万!全网首家为了让DeepSeek-R1用起来更顺畅,火山引擎将TPM上调到了500万!全网首家

    deepseek风靡一时,但并非人人可用。 众多ai云服务商抓住机遇,纷纷上线deepseek模型,并推出优惠活动吸引用户。然而,免费token往往难以顺利调用deepseek-r1,可用性堪忧。 这凸显了选择可靠大厂的重要性。 火山引擎上线DeepSeek-R1模型(含完整版及蒸馏版),并赠送50…

    2026年9月2日 • 用户投稿
    100
  • 苹果选择通义,肯定阿里的同时,也否定了阿里

    苹果ai订单尘埃落定:阿里通义千问胜出,生态安全成关键 历时两年的苹果AI订单争夺战最终以阿里巴巴胜出告终。2月11日消息,苹果已选择阿里巴巴为中国版iPhone开发人工智能功能。 自2023年起,苹果便在测试多家中国AI模型,竞争者包括百度、字节跳动等巨头,以及百川智能、月之暗面和DeepSeek…

    2026年9月1日
    000
  • 撞车DeepSeek NSA,Kimi杨植麟署名的新注意力架构MoBA发布,代码也公开

    撞车DeepSeek NSA,Kimi杨植麟署名的新注意力架构MoBA发布,代码也公开撞车DeepSeek NSA,Kimi杨植麟署名的新注意力架构MoBA发布,代码也公开撞车DeepSeek NSA,Kimi杨植麟署名的新注意力架构MoBA发布,代码也公开撞车DeepSeek NSA,Kimi杨植麟署名的新注意力架构MoBA发布,代码也公开

    月之暗面发布moba注意力机制,高效处理超长文本!近日,月之暗面团队公开了一种名为moba(mixture of block attention,块注意力混合)的全新注意力机制,该机制巧妙地将混合专家(moe)原理应用于注意力机制,并在长文本处理方面展现出显著优势。这与deepseek同期发布的ns…

    2026年8月31日 • 用户投稿
    200
  • 流畅阅读— 开源AI浏览器翻译插件,支持双语对照显示

    流畅阅读— 开源AI浏览器翻译插件,支持双语对照显示流畅阅读— 开源AI浏览器翻译插件,支持双语对照显示流畅阅读— 开源AI浏览器翻译插件,支持双语对照显示流畅阅读— 开源AI浏览器翻译插件,支持双语对照显示

    fluentread:你的浏览器翻译利器,助你畅享无障碍阅读体验! FluentRead是一款开源浏览器翻译插件,它利用先进的AI技术,旨在为你提供如同母语般流畅的阅读体验。支持多种翻译引擎,包括传统的机器翻译和强大的AI大模型,并且允许你自定义翻译服务。其核心功能包含智能翻译、便捷的双语对照显示以…

    2026年8月29日 • 用户投稿
    200
  • OpenAI等AI公司竞相利用“蒸馏”技术 构建低成本模型

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 全球领先的人工智能公司,包括OpenAI、微软和Meta,正积极采用“模型蒸馏”技术,致力于打造更经济实惠的AI模型,惠及消费者和企业。 DeepSeek公司在中国利用这项技术,基于Meta和阿…

    2026年8月28日
    100
  • 为什么Qwen能自我改进推理,Llama却不行?斯坦福找到了原理

    为什么Qwen能自我改进推理,Llama却不行?斯坦福找到了原理为什么Qwen能自我改进推理,Llama却不行?斯坦福找到了原理为什么Qwen能自我改进推理,Llama却不行?斯坦福找到了原理为什么Qwen能自我改进推理,Llama却不行?斯坦福找到了原理

    深度解析:大模型的自我改进能力为何参差不齐?斯坦福大学最新研究揭秘 近期,斯坦福大学的一项研究深入探讨了大型语言模型(LLM)自我改进能力背后的机制,解释了为何有些模型能够有效利用额外计算资源提升性能,而另一些则停滞不前。该研究的核心在于模型的初始“认知行为”。 研究人员选取了Qwen-2.5-3B…

    2026年8月27日 • 用户投稿
    200
  • Meta发布AI新模型系列 Llama 4,首次采用“混合专家”架构

    meta发布全新多模态ai模型系列llama 4,引领开源ai发展! 该系列包含llama 4 scout、llama 4 maverick和llama 4 behemoth三个模型,能够处理文本、视频、图像和音频等多种数据类型,并在不同格式间实现内容转换。 ☞☞☞AI 智能聊天, 问答助手, AI…

    2026年8月26日
    000
  • html的盒模型详解

    这次给大家带来html的盒模型详解,使用html盒模型的注意事项有哪些,下面就是实战案例,一起来看一下。 1.1. 盒的内容区的尺寸— content width和content height —取决于几个因素: –生成该盒的元素是否设置了’width’或&#82…

    用户投稿 2025年12月21日
    000
  • HiDream-I1— 智象未来开源的文生图模型

    hidream-i1:一款强大的开源图像生成模型 HiDream-I1是由HiDream.ai团队开发的17亿参数开源图像生成模型,采用MIT许可证,在图像质量和对提示词的理解方面表现卓越。它支持多种风格,包括写实、卡通和艺术风格,广泛应用于艺术创作、商业设计、科研教育以及娱乐媒体等领域。 HiDr…

    2025年12月5日
    500

发表回复

登录后才能评论
关注微信