本文基于中科院自动所磁瓦缺陷公开数据集,采用PaddlePaddle框架构建UNet模型进行分割实验。数据集含1568组图像,分训练、验证、测试集。模型经60轮训练,评价指标为:P=0.955、R=0.737、F1=0.832、ACC=0.973、IOU=0.713,为后续迁移学习至红外热成像无损检测奠定基础。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
Unet模型分割磁瓦缺陷
数据集采用中科院自动所公开数据集,具体内容见:https://aistudio.baidu.com/aistudio/datasetdetail/224907/0本文主要参考:图像分割的打怪升级之路——UNet、PSPNet、Deeplab:https://aistudio.baidu.com/aistudio/projectdetail/2148971?channelType=0&channel=0&sUid=1019401&ts=1687278761304背景:本人为初级炼丹师,目前炼丹领域主要集中在图像分割与生成式模型。目前:正在构建红外热成像的无损检测数据集,该数据集能够为后续无损检测的后处理研究提供一定的帮助。但目前为止正在构建实验设备阶段,所以欲先从磁瓦缺陷分割然后通过迁移学习,完成后续的组合模型的构建。结果: unet评价指标为: P:0.955250726851333, R:0.7372399981794183, F1:0.8322043172342575, ACC:0.973421630859375, IOU:0.7126283557268431
1. 数据集预处理以及参数设置
1.1 导入必要的库函数
值得注意的是paddlepaddle-gpu版本为:2.0.2
In [1]
import osimport shutilimport numpy as npfrom paddle.io import Dataset,DataLoaderfrom paddle.vision import transforms as Tfrom paddle.nn import functional as Fimport cv2import paddleimport matplotlib.pyplot as pltimport paddle.nn as nnfrom tqdm import tqdmfrom PIL import Imagefrom visualdl import LogWriterfrom paddle import nn
/opt/conda/envs/python35-paddle120-env/lib/python3.7/site-packages/matplotlib/__init__.py:107: DeprecationWarning: Using or importing the ABCs from 'collections' instead of from 'collections.abc' is deprecated, and in 3.8 it will stop working from collections import MutableMapping/opt/conda/envs/python35-paddle120-env/lib/python3.7/site-packages/matplotlib/rcsetup.py:20: DeprecationWarning: Using or importing the ABCs from 'collections' instead of from 'collections.abc' is deprecated, and in 3.8 it will stop working from collections import Iterable, Mapping/opt/conda/envs/python35-paddle120-env/lib/python3.7/site-packages/matplotlib/colors.py:53: DeprecationWarning: Using or importing the ABCs from 'collections' instead of from 'collections.abc' is deprecated, and in 3.8 it will stop working from collections import Sized
1.2 定义超参数
训练历史loss与val-loss的数据导出
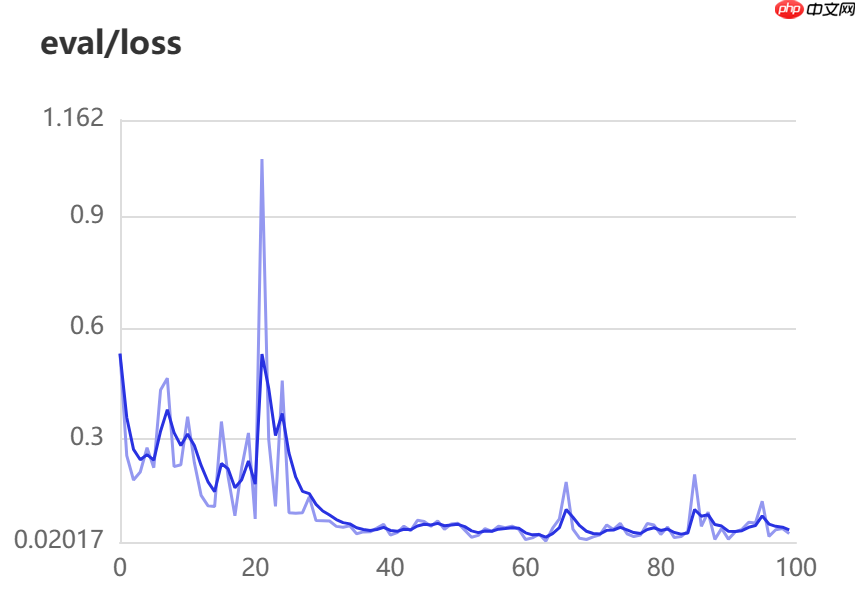
log_path路径为训练中的val-loss,train-loss,val-acc,train-acc储存位置,可以通过左侧的可视化打开,然后通过下载数据为csv,完成后续绘图
其余注释已经写得很清楚,不多作介绍
In [2]
# 训练迭代次数epochs = 60#批量大小batch_size=100#验证集的数量eval_num=150# 测试集的数量test_num=150# 所有图像的大小image_size=(128,128)# 标签图片路径label_images_path="/home/aistudio/data/expansion_annotations"# 输入图像路径input_images_path="/home/aistudio/data/expansion_images"# 保存文件的路径放在work中,每重启项目,都会清空# 存放图片路径filepath = "/home/aistudio/data/"# 模型权重等保存路径modle_and_weight_path = '/home/aistudio/data/modle_weight'# 验证训练效果路径datatest_path = '/home/aistudio/data/pre_test_label'# 训练日志保存log_path = '/home/aistudio/data/train_log'
1.3 解压数据集
将数据从/home/aistudio/data/data224907/解压到data/,这样能够减轻加载时间,因为data文件夹每次启动会重置
In [3]
!unzip -oq /home/aistudio/data/data224907/expansion_annotations.zip -d data/!unzip -oq /home/aistudio/data/data224907/expansion_images.zip -d data/
1.4 获取图片路径+图片名 组成的数组
函数:def get_img_files(directory):将path=directory文件夹下的所有后缀名为png或jpg的文件 获取文件夹下所有文件名称,返回完整路径
输入:
directory: 存放图片的文件夹
输出:
sorted(img_files): 排序后的(地址+名称)
In [4]
def get_img_files(directory): # 获取指定目录下的所有文件名 file_list = os.listdir(directory) # 使用列表推导式筛选出所有后缀名为.png的文件名 img_files = [os.path.join(directory, file) for file in file_list if file.endswith('.png') or file.endswith('.jpg')] # 不排序的话文件名会与标签名混乱 return sorted(img_files)# 获取输入图片(1568,1)images = np.expand_dims(np.array(get_img_files(input_images_path)),axis=1)# 获取输入图片对应得标签(1568,1)labels = np.expand_dims(np.array(get_img_files(label_images_path)),axis=1)# 拼接np ----》(1568,2)data = np.array(np.concatenate((images,labels),axis=1))# 打乱数据集 不影响images与labels的关系np.random.shuffle(data)# 分割数据集train_data=data[:-(eval_num + test_num),:]eval_data=data[-(eval_num + test_num):-test_num,:]test_data=data[-test_num:,:]#打印数据格式,以及图片与对应标签print(train_data.shape, train_data[0])print(eval_data.shape, eval_data[0])print(test_data.shape, test_data[0])
(1268, 2) ['/home/aistudio/data/expansion_images/Imgs-exp6_num_352572.jpg' '/home/aistudio/data/expansion_annotations/Imgs-exp6_num_352572.png'](150, 2) ['/home/aistudio/data/expansion_images/Imgs-exp3_num_322643.jpg' '/home/aistudio/data/expansion_annotations/Imgs-exp3_num_322643.png'](150, 2) ['/home/aistudio/data/expansion_images/Imgs-exp3_num_186885_ud.jpg' '/home/aistudio/data/expansion_annotations/Imgs-exp3_num_186885_ud.png']
2. 数据增强处理与数据提取器的构建
2.1 对图片完成增强处理
In [5]
train_transform=T.Compose([ T.Resize(image_size), #裁剪 T.ColorJitter(0.1,0.1,0.1,0.1), #亮度,对比度,饱和度和色调 T.Transpose(), #CHW T.Normalize(mean=0.,std=255.) #归一化 ])eval_transform=T.Compose([ T.Resize(image_size), T.Transpose(), T.Normalize(mean=0.,std=255.) ])
2.2 定义数据提取器
In [6]
class ImageDataset(Dataset): def __init__(self,path,transform): super(ImageDataset, self).__init__() self.path=path self.transform=transform def _load_image(self,path): ''' 该方法作用为通过路径获取图像 ''' img=cv2.imread(path) img=cv2.resize(img,image_size) return img def __getitem__(self,index): ''' 这里之所以不对label使用transform,因为观察数据集发现label的图像矩阵主要为0或1 但偶尔也有0-255的值,所以要对label分情况处理 而对data都进行transform是因为data都是彩色图片,图像矩阵皆为0-255,所以可以统一处理 ''' path=self.path[index] if len(path)==2: data_path,label_path=path # 获取图片数组 data,label=self._load_image(data_path),self._load_image(label_path) # 对图片数组归一化 data,label=self.transform(data),label # 参数 (2,0,1) 表示将第三维度(channel)作为第一维度,第一维度(height)作为第二维度, # 第二维度(width)作为第三维度 label = label.transpose((2, 0, 1)) # 提取这个数组的第一行,保留该行所有列,也就是将其尺寸从(1, height, width)变为了 # (height, width),即去掉了第一维的维数,并将其赋值给了变量 label。 label = label[0, :, :] label = np.expand_dims(label, axis=0) if True in (label>1): label=label/255. label = label.astype("int64") return data,label # 获取的路径只有一个,那么就是输入图片(用于没有标签的测试集) if len(path)==1: data=self._load_image(path[0]) data=self.transform(data) return data def __len__(self): return len(self.path)# 获取数据读取器train_dataset=ImageDataset(train_data,train_transform)eval_dataset=ImageDataset(eval_data,eval_transform)test_dataset=ImageDataset(test_data,eval_transform)train_dataloader=DataLoader(train_dataset,batch_size=batch_size,shuffle=True,drop_last=True)eval_dataloader=DataLoader(eval_dataset,batch_size=batch_size,shuffle=True,drop_last=True)
2.3 观察训练集
In [7]
def show_images(imgs): #imgs是一个列表,列表里是多个tensor对象 #定义总的方框的大小 plt.figure(figsize=(3*len(imgs),3), dpi=80) for i in range(len(imgs)): #定义小方框 plt.subplot(1, len(imgs), i + 1) #matplotlib库只能识别numpy类型的数据,tensor无法识别 imgs[i]=imgs[i].numpy() #展示取出的数据 plt.imshow(imgs[i][0],cmap="gray",aspect="auto") #设置坐标轴 plt.xticks([]) plt.yticks([])data,label=next(train_dataloader())show_images([data[0],label[0]])
/opt/conda/envs/python35-paddle120-env/lib/python3.7/site-packages/matplotlib/cbook/__init__.py:2349: DeprecationWarning: Using or importing the ABCs from 'collections' instead of from 'collections.abc' is deprecated, and in 3.8 it will stop working if isinstance(obj, collections.Iterator):/opt/conda/envs/python35-paddle120-env/lib/python3.7/site-packages/matplotlib/cbook/__init__.py:2366: DeprecationWarning: Using or importing the ABCs from 'collections' instead of from 'collections.abc' is deprecated, and in 3.8 it will stop working return list(data) if isinstance(data, collections.MappingView) else data/opt/conda/envs/python35-paddle120-env/lib/python3.7/site-packages/matplotlib/image.py:425: DeprecationWarning: np.asscalar(a) is deprecated since NumPy v1.16, use a.item() instead a_min = np.asscalar(a_min.astype(scaled_dtype))/opt/conda/envs/python35-paddle120-env/lib/python3.7/site-packages/matplotlib/image.py:426: DeprecationWarning: np.asscalar(a) is deprecated since NumPy v1.16, use a.item() instead a_max = np.asscalar(a_max.astype(scaled_dtype))
3. 搭建模型
3.1 unet 结构图
 In [8]
import paddlefrom paddle import nnclass Encoder(nn.Layer):# 下采样 def __init__(self, num_channels, num_filters): super(Encoder,self).__init__()#继承父类的初始化 # 图像通道数变为num_filters,长宽不变 self.conv1 = nn.Conv2D(in_channels=num_channels, out_channels=num_filters, kernel_size=3, stride=1, padding=1) self.bn1 = nn.BatchNorm(num_filters,act='relu') self.conv2 = nn.Conv2D(in_channels=num_filters, out_channels=num_filters, kernel_size=3, stride=1, padding=1) self.bn2 = nn.BatchNorm(num_filters,act='relu') self.pool = nn.MaxPool2D(kernel_size=2,stride=2,padding='SAME')# 图像长宽缩小一半,通道数不变 def forward(self, inputs): x = self.conv1(inputs) x = self.bn1(x) x = self.conv2(x) x = self.bn2(x) # 输出1用于拼接 x_conv = x # 输出2用于下采样 x_pool =self.pool(x) return x_conv, x_poolclass Decoder(nn.Layer): def __init__(self, num_channels,num_filters): super(Decoder,self).__init__() self.up = nn.Conv2DTranspose(in_channels=num_channels, out_channels=num_filters, kernel_size=2, stride=2, padding=0)# 图片分辨率变大一倍,通道数不变 self.conv1 = nn.Conv2D(in_channels=num_filters*2, out_channels=num_filters, kernel_size=3, stride=1, padding=1)# 因为拼接的缘故所以是2倍的关系 self.bn1 = nn.BatchNorm(num_filters,act='relu') self.conv2 = nn.Conv2D(in_channels=num_filters, out_channels=num_filters, kernel_size=3, stride=1, padding=1) self.bn2 = nn.BatchNorm(num_filters,act='relu') def forward(self, input_conv, input_pool): x = self.up(input_pool) # 计算上采样后,与input_conv的分辨率差值,然后进行填充 h_diff = (input_conv.shape[2]-x.shape[2]) w_diff = (input_conv.shape[3]-x.shape[3]) # 对上下左右表示填充0 pad = nn.Pad2D(padding=[h_diff//2,h_diff-h_diff//2,w_diff//2,w_diff-w_diff//2]) x = pad(x) x = paddle.concat([input_conv,x],axis=1) x = self.conv1(x) x = self.bn1(x) x = self.conv2(x) x = self.bn2(x) return xclass UNet(nn.Layer): def __init__(self, num_classes=2): super(UNet,self).__init__() self.down1 = Encoder(num_channels=3, num_filters=64) self.down2 = Encoder(num_channels=64, num_filters=128) self.down3 = Encoder(num_channels=128, num_filters=256) self.down4 = Encoder(num_channels= 256, num_filters=512) self.mid_conv1 = nn.Conv2D(512,1024,1) self.mid_bn1 = nn.BatchNorm(1024,act='relu') self.mid_conv2 = nn.Conv2D(1024,1024,1) self.mid_bn2 = nn.BatchNorm(1024,act='relu') self.up4 = Decoder(1024,512) self.up3 = Decoder(512,256) self.up2 = Decoder(256,128) self.up1 = Decoder(128,64) # 使用1*1卷积,softmax做分类 self.last_conv = nn.Conv2D(64,num_classes,1) def forward(self, inputs): x1, x = self.down1(inputs) x2, x = self.down2(x) x3, x = self.down3(x) x4, x = self.down4(x) x = self.mid_conv1(x) x = self.mid_bn1(x) x = self.mid_conv2(x) x = self.mid_bn2(x) x = self.up4(x4, x) x = self.up3(x3, x) x = self.up2(x2, x) x = self.up1(x1, x) x = self.last_conv(x) return x # 打印模型结构,需要不打印模型结构注释下一行即可paddle.summary(UNet(2), (1, 3, 128, 128))
-------------------------------------------------------------------------------------------------------------- Layer (type) Input Shape Output Shape Param # ============================================================================================================== Conv2D-1 [[1, 3, 128, 128]] [1, 64, 128, 128] 1,792 BatchNorm-1 [[1, 64, 128, 128]] [1, 64, 128, 128] 256 Conv2D-2 [[1, 64, 128, 128]] [1, 64, 128, 128] 36,928 BatchNorm-2 [[1, 64, 128, 128]] [1, 64, 128, 128] 256 MaxPool2D-1 [[1, 64, 128, 128]] [1, 64, 64, 64] 0 Encoder-1 [[1, 3, 128, 128]] [[1, 64, 128, 128], [1, 64, 64, 64]] 0 Conv2D-3 [[1, 64, 64, 64]] [1, 128, 64, 64] 73,856 BatchNorm-3 [[1, 128, 64, 64]] [1, 128, 64, 64] 512 Conv2D-4 [[1, 128, 64, 64]] [1, 128, 64, 64] 147,584 BatchNorm-4 [[1, 128, 64, 64]] [1, 128, 64, 64] 512 MaxPool2D-2 [[1, 128, 64, 64]] [1, 128, 32, 32] 0 Encoder-2 [[1, 64, 64, 64]] [[1, 128, 64, 64], [1, 128, 32, 32]] 0 Conv2D-5 [[1, 128, 32, 32]] [1, 256, 32, 32] 295,168 BatchNorm-5 [[1, 256, 32, 32]] [1, 256, 32, 32] 1,024 Conv2D-6 [[1, 256, 32, 32]] [1, 256, 32, 32] 590,080 BatchNorm-6 [[1, 256, 32, 32]] [1, 256, 32, 32] 1,024 MaxPool2D-3 [[1, 256, 32, 32]] [1, 256, 16, 16] 0 Encoder-3 [[1, 128, 32, 32]] [[1, 256, 32, 32], [1, 256, 16, 16]] 0 Conv2D-7 [[1, 256, 16, 16]] [1, 512, 16, 16] 1,180,160 BatchNorm-7 [[1, 512, 16, 16]] [1, 512, 16, 16] 2,048 Conv2D-8 [[1, 512, 16, 16]] [1, 512, 16, 16] 2,359,808 BatchNorm-8 [[1, 512, 16, 16]] [1, 512, 16, 16] 2,048 MaxPool2D-4 [[1, 512, 16, 16]] [1, 512, 8, 8] 0 Encoder-4 [[1, 256, 16, 16]] [[1, 512, 16, 16], [1, 512, 8, 8]] 0 Conv2D-9 [[1, 512, 8, 8]] [1, 1024, 8, 8] 525,312 BatchNorm-9 [[1, 1024, 8, 8]] [1, 1024, 8, 8] 4,096 Conv2D-10 [[1, 1024, 8, 8]] [1, 1024, 8, 8] 1,049,600 BatchNorm-10 [[1, 1024, 8, 8]] [1, 1024, 8, 8] 4,096 Conv2DTranspose-1 [[1, 1024, 8, 8]] [1, 512, 16, 16] 2,097,664 Conv2D-11 [[1, 1024, 16, 16]] [1, 512, 16, 16] 4,719,104 BatchNorm-11 [[1, 512, 16, 16]] [1, 512, 16, 16] 2,048 Conv2D-12 [[1, 512, 16, 16]] [1, 512, 16, 16] 2,359,808 BatchNorm-12 [[1, 512, 16, 16]] [1, 512, 16, 16] 2,048 Decoder-1 [[1, 512, 16, 16], [1, 1024, 8, 8]] [1, 512, 16, 16] 0 Conv2DTranspose-2 [[1, 512, 16, 16]] [1, 256, 32, 32] 524,544 Conv2D-13 [[1, 512, 32, 32]] [1, 256, 32, 32] 1,179,904 BatchNorm-13 [[1, 256, 32, 32]] [1, 256, 32, 32] 1,024 Conv2D-14 [[1, 256, 32, 32]] [1, 256, 32, 32] 590,080 BatchNorm-14 [[1, 256, 32, 32]] [1, 256, 32, 32] 1,024 Decoder-2 [[1, 256, 32, 32], [1, 512, 16, 16]] [1, 256, 32, 32] 0 Conv2DTranspose-3 [[1, 256, 32, 32]] [1, 128, 64, 64] 131,200 Conv2D-15 [[1, 256, 64, 64]] [1, 128, 64, 64] 295,040 BatchNorm-15 [[1, 128, 64, 64]] [1, 128, 64, 64] 512 Conv2D-16 [[1, 128, 64, 64]] [1, 128, 64, 64] 147,584 BatchNorm-16 [[1, 128, 64, 64]] [1, 128, 64, 64] 512 Decoder-3 [[1, 128, 64, 64], [1, 256, 32, 32]] [1, 128, 64, 64] 0 Conv2DTranspose-4 [[1, 128, 64, 64]] [1, 64, 128, 128] 32,832 Conv2D-17 [[1, 128, 128, 128]] [1, 64, 128, 128] 73,792 BatchNorm-17 [[1, 64, 128, 128]] [1, 64, 128, 128] 256 Conv2D-18 [[1, 64, 128, 128]] [1, 64, 128, 128] 36,928 BatchNorm-18 [[1, 64, 128, 128]] [1, 64, 128, 128] 256 Decoder-4 [[1, 64, 128, 128], [1, 128, 64, 64]] [1, 64, 128, 128] 0 Conv2D-19 [[1, 64, 128, 128]] [1, 2, 128, 128] 130 ==============================================================================================================Total params: 18,472,450Trainable params: 18,460,674Non-trainable params: 11,776--------------------------------------------------------------------------------------------------------------Input size (MB): 0.19Forward/backward pass size (MB): 174.75Params size (MB): 70.47Estimated Total Size (MB): 245.40--------------------------------------------------------------------------------------------------------------
{'total_params': 18472450, 'trainable_params': 18460674}
3.2 采用高层API训练模型
注意:本段落的运行会清空之前的所有数据文件,并重新创建空的文件夹!同时该段落的训练时长与epochs的大小高度相关,请耐心等待训练完成!
若需要查看的loss,acc需要,打开左侧的可视化,路径设置为/home/aistudio/data/train_log,即可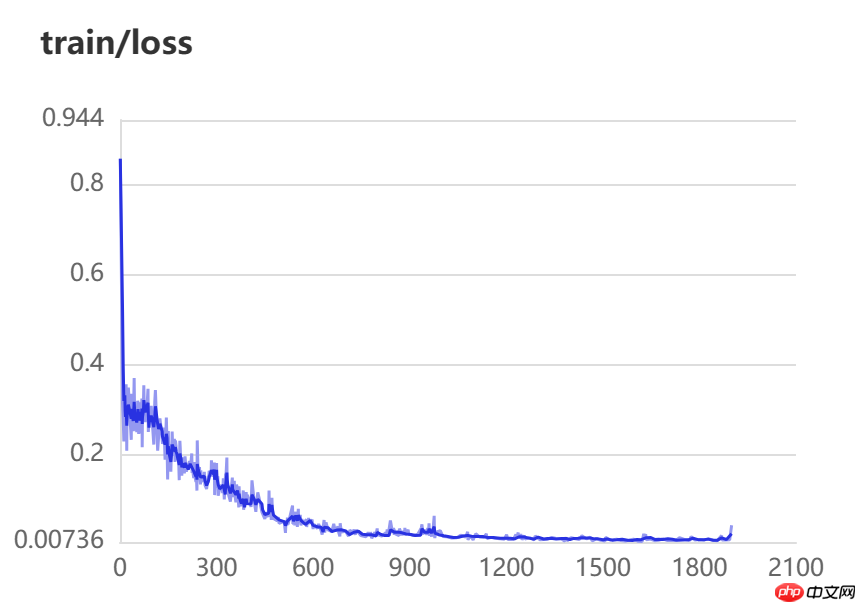
In [9]
# 判断日志文件是否存在,存在就删除,然后创建空的文件夹用于存log文件def del_file(path): if os.path.exists(path): shutil.rmtree(path) os.mkdir(path)del_file(log_path)del_file(modle_and_weight_path)del_file(test_path)print(paddle.device.get_device())paddle.device.set_device('gpu:0')# 创建调用模型modle = paddle.Model(UNet(2))# opt = paddle.optimizer.Momentum(learning_rate=1e-3,parameters=modle.parameters(),weight_decay=1e-2)opt = paddle.optimizer.AdamW(learning_rate=1e-3,parameters=modle.parameters(),weight_decay=1e-2)modle.prepare(opt, paddle.nn.CrossEntropyLoss(axis=1),metrics=paddle.metric.Accuracy())# 创建回调,将训练过程中的val_loss,train_loss,val_acc,train_acc,保存到文件夹/home/aistudio/data/train_log中callback = paddle.callbacks.VisualDL(log_dir = log_path)# 请耐心等待它训练完成,若需要观察每次训练的acc与loss,可以将verbose设置为1,(申请精品项目输出不能太长,所以就默认为0,也就是不打印)# save_freq=5,每训练5次,保存一次模型# 模型的权重文件保存在/home/aistudio/data/modle_weight# 训练log_freq次打印一次结果modle.fit(train_dataloader, eval_dataloader, epochs=epochs, verbose=0, save_dir = modle_and_weight_path, save_freq=5, log_freq=1, callbacks=callback)
cpu
—————————————————————————ValueError Traceback (most recent call last)/tmp/ipykernel_1308/2477755552.py in 12 13 print(paddle.device.get_device()) —> 14paddle.device.set_device(‘gpu:0’) 15 16 /opt/conda/envs/python35-paddle120-env/lib/python3.7/site-packages/paddle/device/__init__.py in set_device(device) 314 data = paddle.stack([x1,x2], axis=1) 315 “”” –> 316 place =_convert_to_place(device) 317 framework._set_expected_place(place) 318 return place /opt/conda/envs/python35-paddle120-env/lib/python3.7/site-packages/paddle/device/__init__.py in _convert_to_place(device) 257 raise ValueError( 258 “The device should not be {}, since PaddlePaddle is ” –> 259 “not compiled with CUDA”.format(avaliable_gpu_device)) 260 device_info_list = device.split(‘:’, 1) 261 device_id = device_info_list[1] ValueError: The device should not be , since PaddlePaddle is not compiled with CUDA
3.3 预测图象
将测试集预测后的数据放入地址为:test——path中。
预测图片为:  In [ ]
# 预测图像保存绝对路径if os.path.exists(test_path): shutil.rmtree(test_path)os.mkdir(test_path)#读取模型参数文件路径save_dir = test_pathcheckpoint_path = modle_and_weight_path + "/final"#实例化,U-Netmodel = paddle.Model(UNet(2)) # 加载最后训练的模型model.load(checkpoint_path)# 生成预测图片到文件夹/home/aistudio/data/pre_test_label# img格式为:【3,128,128】for i,img in tqdm(enumerate(test_dataset)): #print(paddle.to_tensor(img[0]).shape) img=paddle.to_tensor(img[0]).unsqueeze(0) predict=np.array(model.predict_batch(img)).squeeze(0).squeeze(0) predict=predict.argmax(axis=0) image_path=test_dataset.path[i] path_lst=image_path[0].split("/") save_path=os.path.join(save_dir,path_lst[-1][:-5])+"p.jpg" cv2.imwrite(save_path,predict*255)
3.4 评估指标计算
包含常用指标:
precision: 预测结果的平均精度recall: 预测结果的平均召回率f1score: 预测结果的平均 F1 值accuracy: 预测结果的整体准确率IOU:预测结果的平均交并比**In [ ]
# # 评价网络模型结果#########################################################################def evaluate_segmentation_performance(pred_masks, true_masks): """ 计算图像分割性能评估指标 参数: - pred_masks: numpy 数组,表示预测的掩码图像,形状为 (N, H, W, 1),取值为 0 或 1 - true_masks: numpy 数组,表示真实的掩码图像,形状为 (N, H, W, 1),取值为 0 或 1 返回值: - precision: 预测结果的平均精度 - recall: 预测结果的平均召回率 - f1score: 预测结果的平均 F1 值 - accuracy: 预测结果的整体准确率 - IOU:预测结果的平均交并比 """ # 将预测结果和真实结果转换为 int 类型,以避免出现数据类型错误 pred_masks = np.round(pred_masks).astype(np.int32) true_masks = np.round(true_masks).astype(np.int32) # 计算 TP,FP 和 FN TP = np.sum((pred_masks == 1) & (true_masks == 1)) FP = np.sum((pred_masks == 1) & (true_masks == 0)) FN = np.sum((pred_masks == 0) & (true_masks == 1)) print(TP, FP, FN) # 计算准确率、召回率和 F1 值 precision = TP / (TP + FP) recall = TP / (TP + FN) f1score = 2 * precision * recall / (precision + recall) # 计算整体准确率 accuracy = np.mean(pred_masks == true_masks) # 计算 IOU intersection = np.sum(pred_masks & true_masks) union = np.sum(pred_masks | true_masks) iou = intersection / union return precision, recall, f1score, accuracy, iou
In [ ]
# 提取经过(resize,标签二值化)处理的图片列表eval_img_list = [test_dataset.__getitem__(i)[0] for i in range(len(test_dataset))]eval_label_list = [test_dataset.__getitem__(i)[1] for i in range(len(test_dataset))]# img灰度--->[150,3,128,128]img = paddle.to_tensor(eval_img_list)# label二值--->[150,1,128,128]label = np.array(paddle.to_tensor(eval_label_list))# predict其中2代表两通道预测各类别的概率--->[150,2,128,128]predict = np.array(model.predict_batch(img)).squeeze(0)# pre_img_list-->[150,128,128,1]pre_img_list = paddle.to_tensor([predict[i].argmax(axis=0) for i in range(len(predict))]).unsqueeze(-1)# pre_img_list-->[150,1,128,128]pre_img_list = np.array(pre_img_list.transpose((0, 3, 1, 2)))# 计算指标precision, recall, f1score, accuracy, iou = evaluate_segmentation_performance(pre_img_list, label)print('unet评价指标为:nP:{},nR:{},nF1:{},nACC:{},nIOU:{}'.format(precision, recall, f1score, accuracy, iou))
In [ ]
以上就是采用UNet完成磁瓦图片分割的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/52932.html
 微信扫一扫
 支付宝扫一扫