怎么利用node进行图片压缩?下面本篇文章以png图片为例给大家介绍一下进行图片压缩的方法,希望对大家有所帮助!

最近要搞图像处理服务,其中一个是要实现图片压缩功能。以前前端开发的时候只要利用canvas现成的API处理下就能实现,后端可能也有现成的API但我并不知道。仔细想想,我从来没有详细了解过图片压缩原理,那刚好趁这次去调研学习下,所以有了这篇文章来记录。老样子,如有不对的地方,DDDD(带带弟弟)。
我们先把图片上传到后端,看看后端接收了什么样的参数。这里后端我用的是Node.js(Nest),图片我以PNG图片为例。
接口和参数打印如下:
@Post('/compression')
@UseInterceptors(FileInterceptor('file'))
async imageCompression(@UploadedFile() file: Express.Multer.File) {

  return {
    file
  }
}

要进行压缩,我们就需要拿到图像数据。可以看到,唯一能藏匿图像数据的就是这串buffer。那这串buffer描述了什么,就需要先弄清什么是PNG。【相关教程推荐:nodejs视频教程、编程教学】
PNG
这里是PNG的WIKI地址。
阅读之后,我了解到PNG是由一个8 byte的文件头加上多个的块(chunk)组成。示意图如下:

其中:
文件头是由一个被称为magic number的组成。值为 89 50 4e 47 0d 0a 1a 0a(16进制)。它标记了这串数据是PNG格式。
块分为两种,一种叫关键块(Critical chunks),一种叫辅助块(Ancillary chunks)。关键块是必不可少的,没有关键块,解码器将不能正确识别并展示图片。辅助块是可选的,部分软件在处理图片之后就有可能携带辅助块。每个块都是四部分组成:4 byte 描述这个块的内容有多长,4 byte 描述这个块的类型是什么,n byte 描述块的内容(n 就是前面4 byte 值的大小,也就是说,一个块最大长度为28*4),4 byte CRC校验检查块的数据,标记着一个块的结束。其中,块类型的4 byte 的值为4个acsii码,第一个字母大写表示是关键块,小写表示是辅助块;第二个字母大写表示是公有,小写表示是私有;第三个字母必须是大写,用于PNG后续的扩展;第四个字母表示该块不识别时,能否安全复制,大写表示未修改关键块时才能安全复制,小写表示都能安全复制。PNG官方提供很多定义的块类型,这里只需要知道关键块的类型即可,分别是IHDR,PLTE,IDAT,IEND。
IHDR
PNG要求第一个块必须是IHDR。IHDR的块内容是固定的13 byte,包含了图片的以下信息:
宽度 width (4 byte) & 高度 height (4 byte)
位深 bit depth (1 byte,值为1,2,4,8或者16) & 颜色类型 color type (1 byte,值为0,2,3,4或者6)
压缩方法 compression method (1 byte,值为0) & 过滤方式 filter method (1 byte,值为0)
交错方式 interlace method (1 byte,值为0或者1)
宽度和高度很容易理解,剩下的几个好像都很陌生,接下来我将进行说明。
在说明位深之前,我们先来看颜色类型,颜色类型有5种值:
0 表示灰度(grayscale)它只有一个通道(channel),看成rgb的话,可以理解它的三色通道值是相等的,所以不需要多余两个通道表示。
2 表示真实色彩(rgb)它有三个通道,分别是R(红色),G(绿色),B(蓝色)。
3 表示颜色索引(indexed)它也只有一个通道,表示颜色的索引值。该类型往往配备一组颜色列表,具体的颜色是根据索引值和颜色列表查询得到的。
4 表示灰度和alpha 它有两个通道,除了灰度的通道外,多了一个alpha通道,可以控制透明度。
6 表示真实色彩和alpha 它有四个通道。
之所以要说到通道,是因为它和这里的位深有关。位深的值就定义了每个通道所占的位数(bit)。位深跟颜色类型组合,就能知道图片的颜色格式类型和每个像素所占的内存大小。PNG官方支持的组合如下表:

过滤和压缩是因为PNG中存储的不是图像的原始数据,而是处理后的数据,这也是为什么PNG图片所占内存较小的原因。PNG使用了两步进行了图片数据的压缩转换。
第一步,过滤。过滤的目的是为了让原始图片数据经过该规则后,能进行更大的压缩比。举个例子,如果有一张渐变图片,从左往右,颜色依次为[#000000, #000001, #000002, …, #ffffff],那么我们就可以约定一条规则,右边的像素总是和它前一个左边的像素进行比较,那么处理完的数据就变成了[1, 1, 1, …, 1],这样是不是就能进行更好的压缩。PNG目前只有一种过滤方式,就是基于相邻像素作为预测值,用当前像素减去预测值。过滤的类型一共有五种,(目前我还不知道这个类型值在哪里存储,有可能在IDAT里,找到了再来删除这条括号里的已确定该类型值储存在IDAT数据中)如下表所示:
0None不做任何处理1Sub左侧相邻像素2Up上方相邻像素3AverageMath.floor((左侧相邻像素 + 上方相邻像素) / 2)4Paeth取(左侧相邻像素 + 上方相邻像素 – 左上方像素)最接近的值
第二步,压缩。PNG也只有一种压缩算法,使用的是DEFLATE算法。这里不细说,具体看下面的章节。
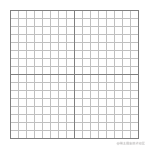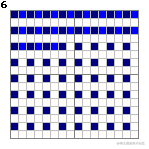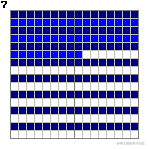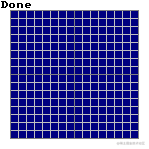
交错方式,有两种值。0表示不处理,1表示使用Adam7 算法进行处理。我没有去详细了解该算法,简单来说,当值为0时,图片需要所有数据都加载完毕时,图片才会显示。而值为1时,Adam7会把图片划分多个区域,每个区域逐级加载,显示效果会有所优化,但通常会降低压缩效率。加载过程可以看下面这张gif图。
PLTE
PLTE的块内容为一组颜色列表,当颜色类型为颜色索引时需要配置。值得注意的是,颜色列表中的颜色一定是每个通道8bit,每个像素24bit的真实色彩列表。列表的长度,可以比位深约定的少,但不能多。比如位深是2,那么22,最多4种颜色,列表长度可以为3,但不能为5。
IDAT
IDAT的块内容是图片原始数据经过PNG压缩转换后的数据,它可能有多个重复的块,但必须是连续的,并且只有当上一个块填充满时,才会有下一个块。
IEND
IEND的块内容为0 byte,它表示图片的结束。
 行者AI
行者AI绘图创作,唤醒新的灵感,创造更多可能
 100 查看详情

阅读到这里,我们把上面的接口改造一下,解析这串buffer。
@Post('/compression')
@UseInterceptors(FileInterceptor('file'))
async imageCompression(@UploadedFile() file: Express.Multer.File) {
  const buffer = file.buffer;

  const result = {
    header: buffer.subarray(0, 8).toString('hex'),
    chunks: [],
    size: file.size,
  };

  let pointer = 8;
  while (pointer < buffer.length) {
    let chunk = {};
    const length = parseInt(buffer.subarray(pointer, pointer + 4).toString('hex'), 16);
    const chunkType = buffer.subarray(pointer + 4, pointer + 8).toString('ascii');
    const crc = buffer.subarray(pointer + length, pointer + length + 4).toString('hex');
    chunk = {
      ...chunk,
      length,
      chunkType,
      crc,
    };

    switch (chunkType) {
      case 'IHDR':
        const width = parseInt(buffer.subarray(pointer + 8, pointer + 12).toString('hex'), 16);
        const height = parseInt(buffer.subarray(pointer + 12, pointer + 16).toString('hex'), 16);
        const bitDepth = parseInt(
          buffer.subarray(pointer + 16, pointer + 17).toString('hex'),
          16,
        );
        const colorType = parseInt(
          buffer.subarray(pointer + 17, pointer + 18).toString('hex'),
          16,
        );
        const compressionMethod = parseInt(
          buffer.subarray(pointer + 18, pointer + 19).toString('hex'),
          16,
        );
        const filterMethod = parseInt(
          buffer.subarray(pointer + 19, pointer + 20).toString('hex'),
          16,
        );
        const interlaceMethod = parseInt(
          buffer.subarray(pointer + 20, pointer + 21).toString('hex'),
          16,
        );

        chunk = {
          ...chunk,
          width,
          height,
          bitDepth,
          colorType,
          compressionMethod,
          filterMethod,
          interlaceMethod,
        };
        break;
      case 'PLTE':
        const colorList = [];
        const colorListStr = buffer.subarray(pointer + 8, pointer + 8 + length).toString('hex');
        for (let i = 0; i < colorListStr.length; i += 6) {
          colorList.push(colorListStr.slice(i, i + 6));
        }
        chunk = {
          ...chunk,
          colorList,
        };
        break;
      default:
        break;
    }
    result.chunks.push(chunk);
    pointer = pointer + 4 + 4 + length + 4;
  }

  return result;
}
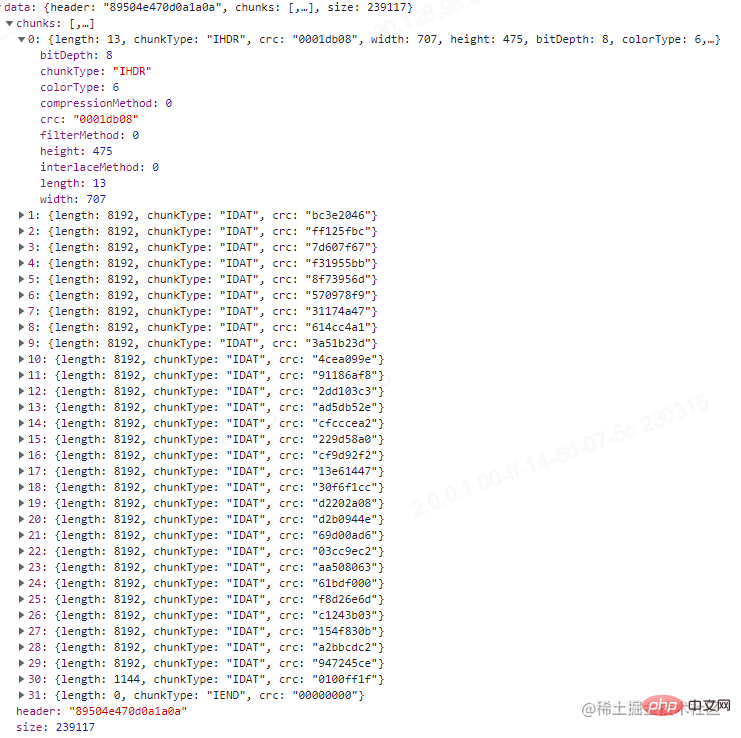
这里我测试用的图没有PLTE,刚好我去TinyPNG压缩我那张测试图之后进行上传,发现有PLTE块,可以看一下,结果如下图。
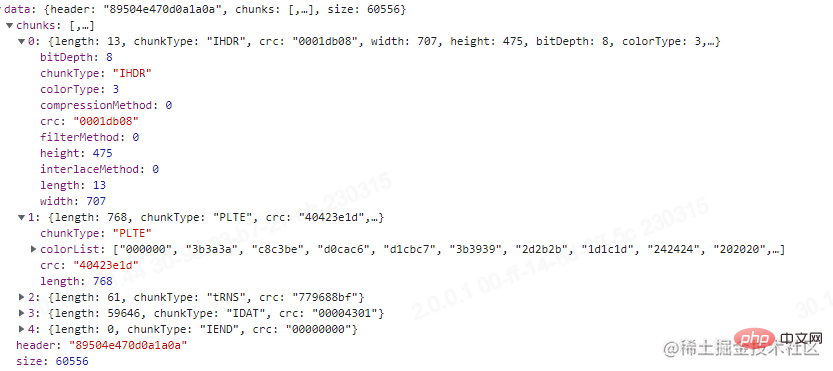
通过比对这两张图,压缩图片的方式我们也能窥探一二。
PNG的压缩
前面说过,PNG使用的是一种叫DEFLATE的无损压缩算法,它是Huffman Coding跟LZ77的结合。除了PNG,我们经常使用的压缩文件,.zip,.gzip也是使用的这种算法(7zip算法有更高的压缩比,也可以了解下)。要了解DEFLATE,我们首先要了解Huffman Coding和LZ77。
Huffman Coding
哈夫曼编码忘记在大学的哪门课接触过了,它是一种根据字符出现频率,用最少的字符替换出现频率最高的字符,最终降低平均字符长度的算法。
举个例子,有字符串”ABCBCABABADA”,如果按照正常空间存储,所占内存大小为12 * 8bit = 96bit,现对它进行哈夫曼编码。
1.统计每个字符出现的频率,得到A 5次 B 4次 C 2次 D 1次
2.对字符按照频率从小到大排序,将得到一个队列D1,C2,B4,A5
3.按顺序构造哈夫曼树,先构造一个空节点,最小频率的字符分给该节点的左侧,倒数第二频率的字符分给右侧,然后将频率相加的值赋值给该节点。接着用赋值后节点的值和倒数第三频率的字符进行比较,较小的值总是分配在左侧,较大的值总是分配在右侧,依次类推,直到队列结束,最后把最大频率和前面的所有值相加赋值给根节点,得到一棵完整的哈夫曼树。
4.对每条路径进行赋值,左侧路径赋值为0,右侧路径赋值为1。从根节点到叶子节点,进行遍历,遍历的结果就是该字符编码后的二进制表示,得到:A(0)B(11)C(101)D(100)。
完整的哈夫曼树如下(忽略箭头,没找到连线- -!):
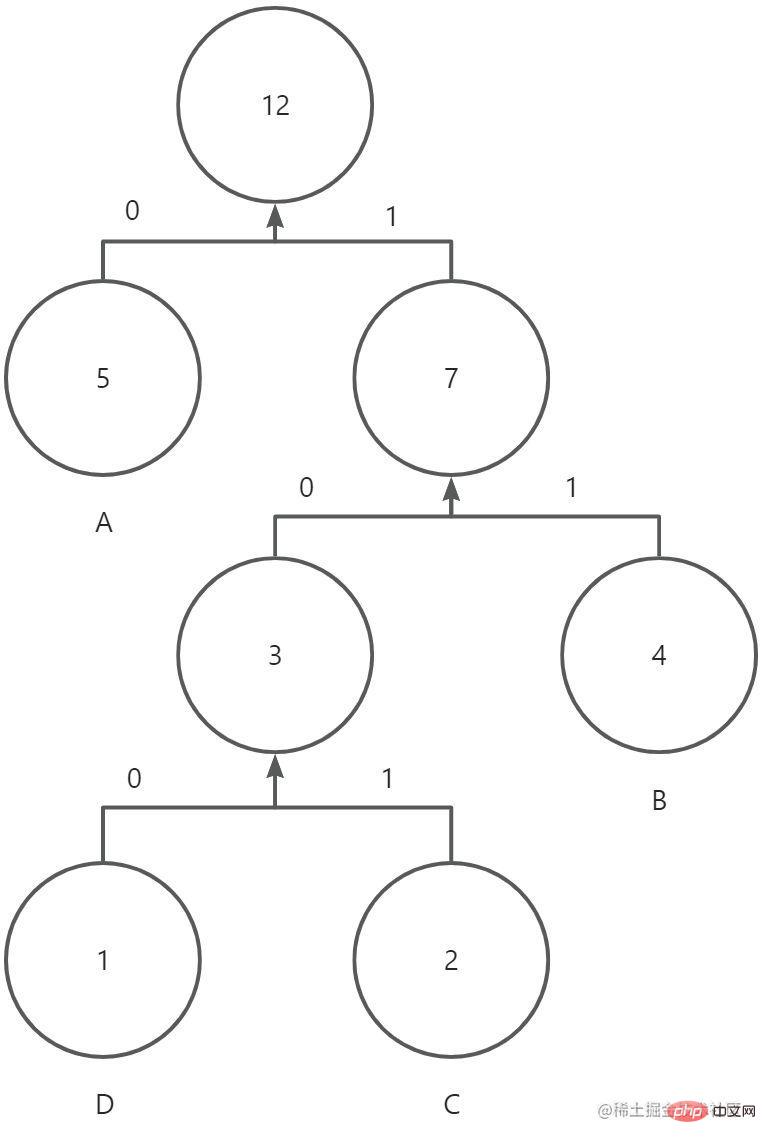
压缩后的字符串,所占内存大小为5 * 1bit + 4 * 2bit + 2 * 3bit + 1 * 3bit = 22bit。当然在实际传输过程中,还需要把编码表的信息(原始字符和出现频率)带上。因此最终占比大小为 4 * 8bit + 4 * 3bit(频率最大值为5,3bit可以表示)+ 22bit = 66bit(理想状态),小于原有的96bit。
LZ77
LZ77算法还是第一次知道,查了一下是一种基于字典和滑动窗的无所压缩算法。(题外话:因为Lempel和Ziv在1977年提出的算法,所以叫LZ77,哈哈哈?)
我们还是以上面这个字符串”ABCBCABABADA”为例,现假设有一个4 byte的动态窗口和一个2byte的预读缓冲区,然后对它进行LZ77算法压缩,过程顺序从上往下,示意图如下:
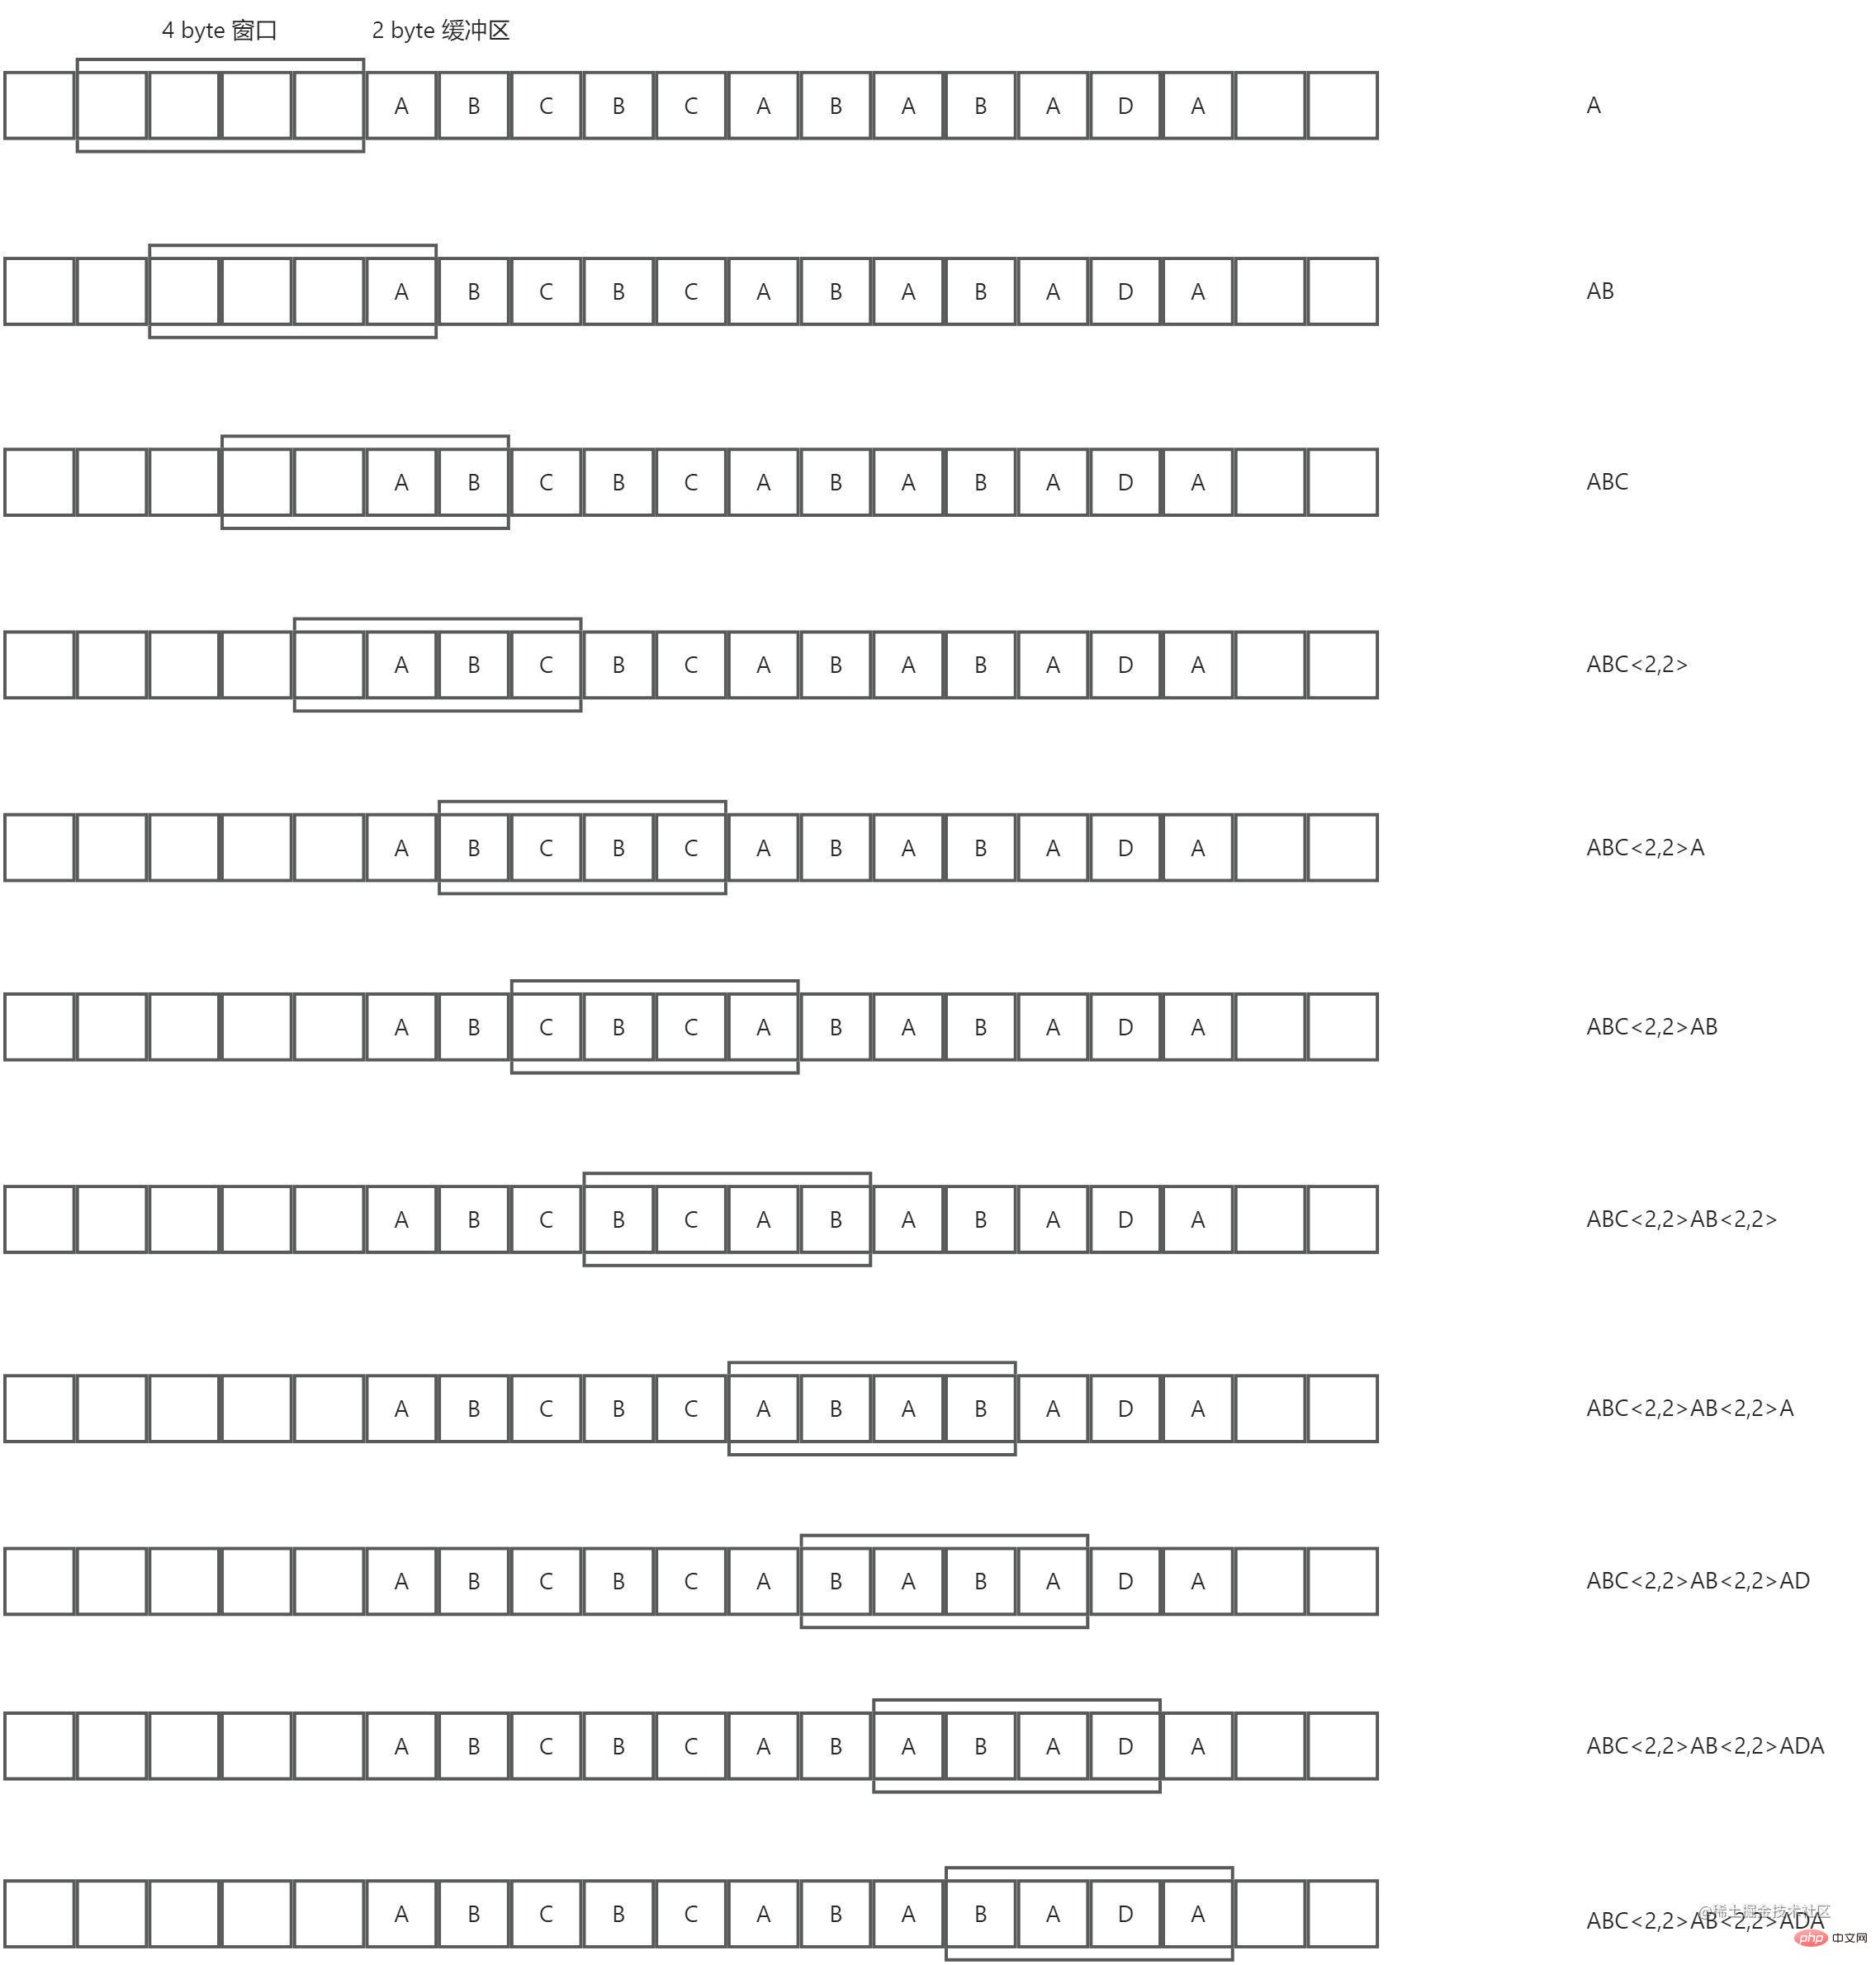
总结下来,就是预读缓冲区在动态窗口中找到最长相同项,然后用长度较短的标记来替代这个相同项,从而实现压缩。从上图也可以看出,压缩比跟动态窗口的大小,预读缓冲区的大小和被压缩数据的重复度有关。
DEFLATE
DEFLATE【RFC 1951】是先使用LZ77编码,对编码后的结果在进行哈夫曼编码。我们这里不去讨论具体的实现方法,直接使用其推荐库Zlib,刚好Node.js内置了对Zlib的支持。接下来我们继续改造上面那个接口,如下:
import * as zlib from 'zlib';

@Post('/compression')
@UseInterceptors(FileInterceptor('file'))
async imageCompression(@UploadedFile() file: Express.Multer.File) {
  const buffer = file.buffer;

  const result = {
    header: buffer.subarray(0, 8).toString('hex'),
    chunks: [],
    size: file.size,
  };

  // 因为可能有多个IDAT的块 需要个数组缓存最后拼接起来
  const fileChunkDatas = [];
  let pointer = 8;
  while (pointer < buffer.length) {
    let chunk = {};
    const length = parseInt(buffer.subarray(pointer, pointer + 4).toString('hex'), 16);
    const chunkType = buffer.subarray(pointer + 4, pointer + 8).toString('ascii');
    const crc = buffer.subarray(pointer + length, pointer + length + 4).toString('hex');
    chunk = {
      ...chunk,
      length,
      chunkType,
      crc,
    };

    switch (chunkType) {
      case 'IHDR':
        const width = parseInt(buffer.subarray(pointer + 8, pointer + 12).toString('hex'), 16);
        const height = parseInt(buffer.subarray(pointer + 12, pointer + 16).toString('hex'), 16);
        const bitDepth = parseInt(
          buffer.subarray(pointer + 16, pointer + 17).toString('hex'),
          16,
        );
        const colorType = parseInt(
          buffer.subarray(pointer + 17, pointer + 18).toString('hex'),
          16,
        );
        const compressionMethod = parseInt(
          buffer.subarray(pointer + 18, pointer + 19).toString('hex'),
          16,
        );
        const filterMethod = parseInt(
          buffer.subarray(pointer + 19, pointer + 20).toString('hex'),
          16,
        );
        const interlaceMethod = parseInt(
          buffer.subarray(pointer + 20, pointer + 21).toString('hex'),
          16,
        );

        chunk = {
          ...chunk,
          width,
          height,
          bitDepth,
          colorType,
          compressionMethod,
          filterMethod,
          interlaceMethod,
        };
        break;
      case 'PLTE':
        const colorList = [];
        const colorListStr = buffer.subarray(pointer + 8, pointer + 8 + length).toString('hex');
        for (let i = 0; i < colorListStr.length; i += 6) {
          colorList.push(colorListStr.slice(i, i + 6));
        }
        chunk = {
          ...chunk,
          colorList,
        };
        break;
      case 'IDAT':
        fileChunkDatas.push(buffer.subarray(pointer + 8, pointer + 8 + length));
        break;
      default:
        break;
    }
    result.chunks.push(chunk);
    pointer = pointer + 4 + 4 + length + 4;
  }

  const originFileData = zlib.unzipSync(Buffer.concat(fileChunkDatas));

  // 这里原图片数据太长了 我就只打印了长度
  return {
    ...result,
    originFileData: originFileData.length,
  };
}
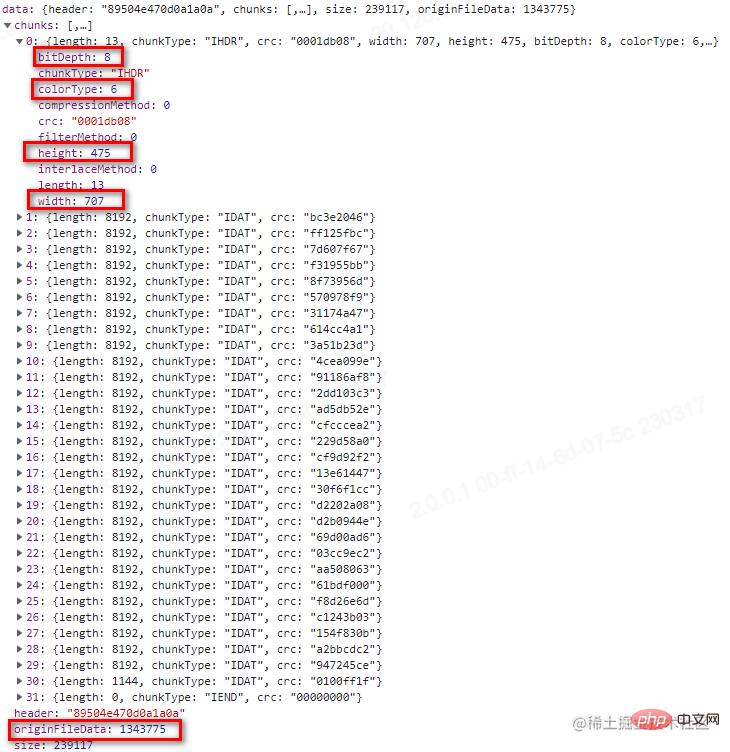
最终打印的结果,我们需要注意红框的那几个部分。可以看到上图,位深和颜色类型决定了每个像素由4 byte组成,然后由于过滤方式的存在,会在每行的第一个字节进行标记。因此该图的原始数据所占大小为:707 * 475 * 4 byte + 475 * 1 byte = 1343775 byte。正好是我们打印的结果。
我们也可以试试之前TinyPNG压缩后的图,如下:
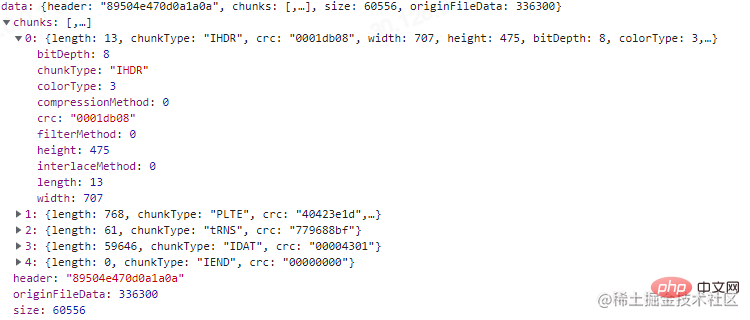
可以看到位深为8,索引颜色类型的图每像素占1 byte。计算得到:707 * 475 * 1 byte + 475 * 1 byte = 336300 byte。结果也正确。
总结
现在再看如何进行图片压缩,你可能很容易得到下面几个结论:
1.减少不必要的辅助块信息,因为辅助块对PNG图片而言并不是必须的。
2.减少IDAT的块数,因为每多一个IDAT的块,就多余了12 byte。
3.降低每个像素所占的内存大小,比如当前是4通道8位深的图片,可以统计整个图片色域,得到色阶表,设置索引颜色类型,降低通道从而降低每个像素的内存大小。
4.等等….
至于JPEG,WEBP等等格式图片,有机会再看。溜了溜了~(还是使用现成的库处理压缩吧)。
好久没写文章,写完才发现语雀不能免费共享,发在这里吧。
更多node相关知识,请访问:nodejs 教程!
以上就是怎么利用Node进行图片压缩的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/542566.html
 微信扫一扫
 支付宝扫一扫