【第六期论文复现赛-语义分割】DDRNet

本文介绍DDRNet语义分割模型,其属双路径结构,含高低分辨率两个分支,分别保存细节与提取上下文信息,通过Bilateral fusion模块融合特征,引入DAPPM模块和辅助损失。复现的DDRNet – 23在Cityscapes验证集mIoU达79.85%,优于目标值,已被paddleseg收录。

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
【第六期论文复现赛-语义分割】ddrnet - 创想鸟

【第六期论文复现赛-语义分割】Deep Dual-resolution Networks for Real-time and Accurate Semantic Segmentation of Road Scenes

paper:Deep Dual-resolution Networks for Real-time and Accurate Semantic Segmentation of Road Scenes
github:https://github.com/ydhongHIT/DDRNet
复现地址:https://github.com/justld/DDRNet_paddle

轻量级语义分割模型大致分为2类:Encoder-Decoder结构(如ESPNet)和two-pathway(如BiSeNet)。类似two-pathway结构,DDRNet使用Dual-resolution,并引入DAPPM( Deep Aggregation Pyramid Pooling Module)模块。在Cityscapes测试集、GPU 2080Ti,DDRNet-23-slim达到102FPS,miou77.4%。本项目复现了DDRNet_23,在cityscapes val miou 为79.85%,该算法已被paddleseg收录。

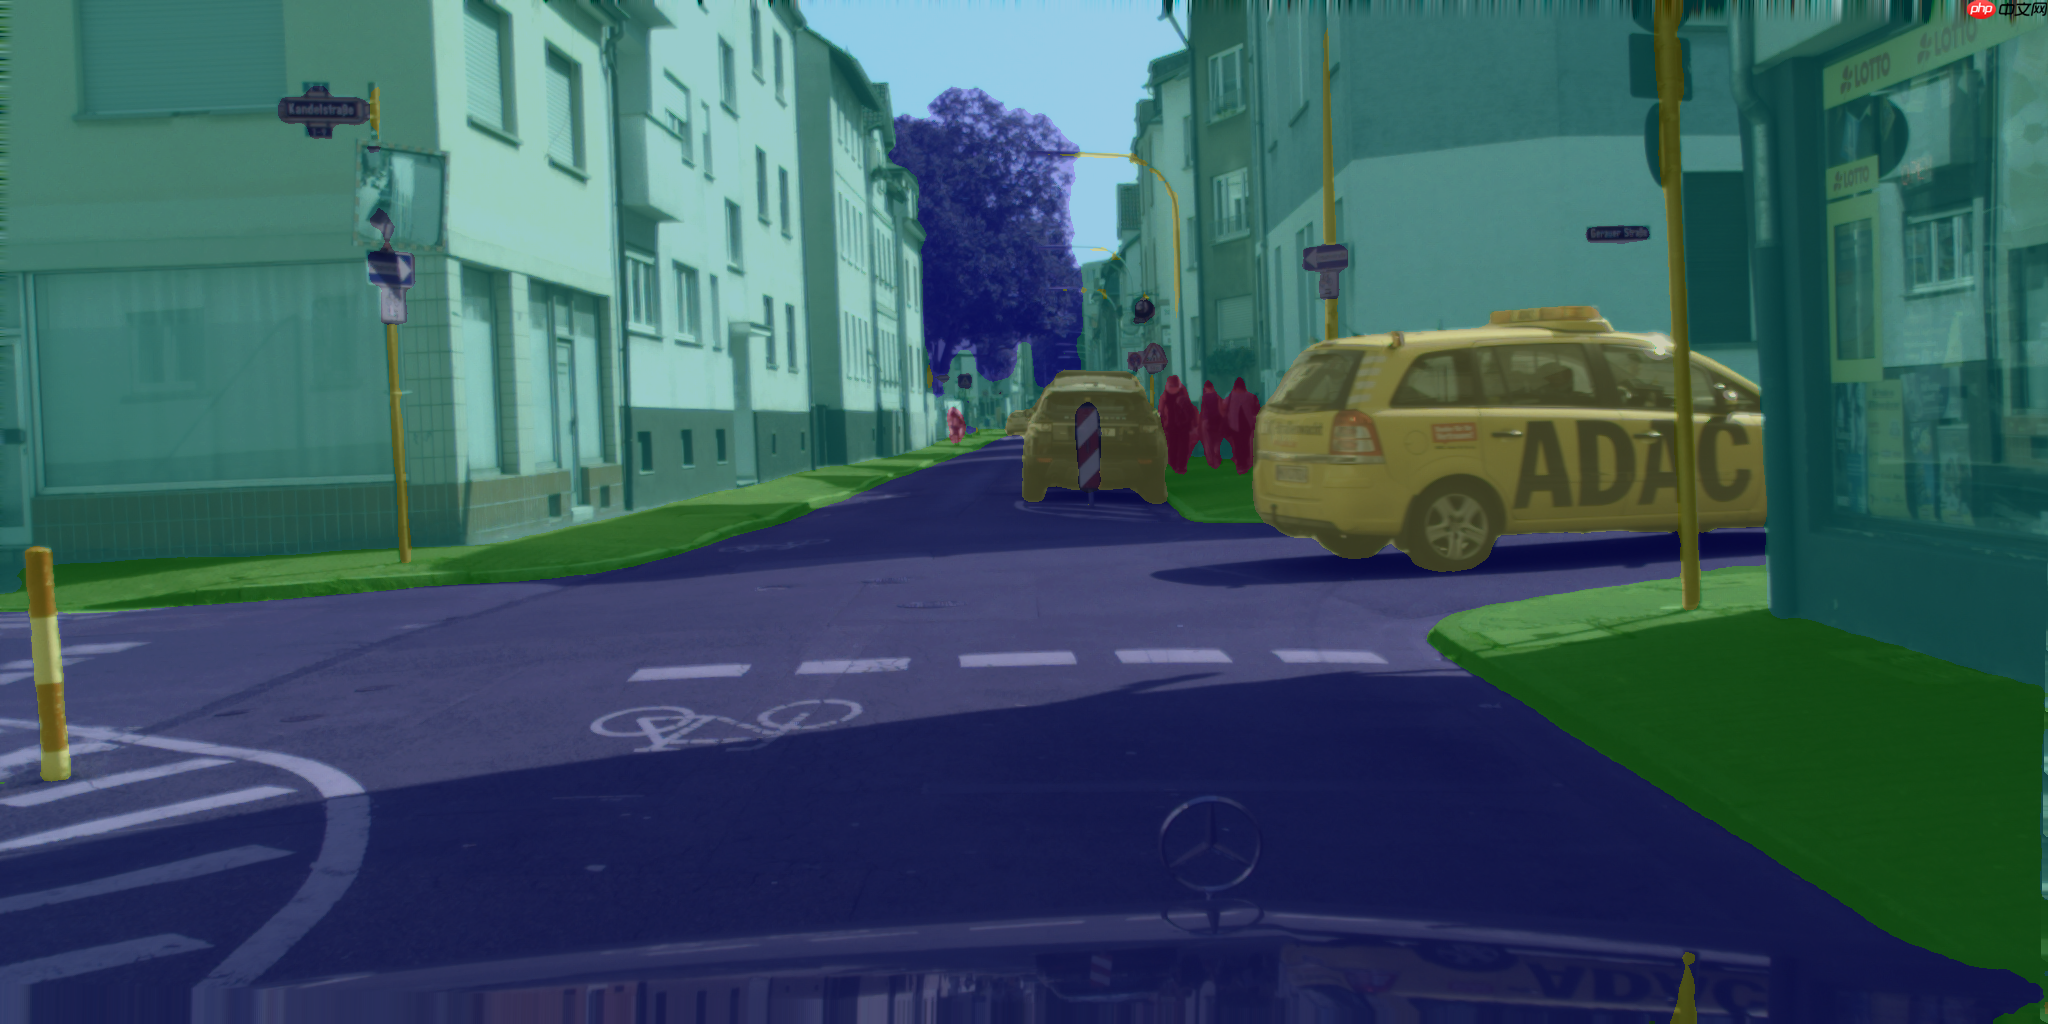
模型预测效果(来自cityscapes val):【第六期论文复现赛-语义分割】DDRNet - 创想鸟        
一、几种语义分割模型结构

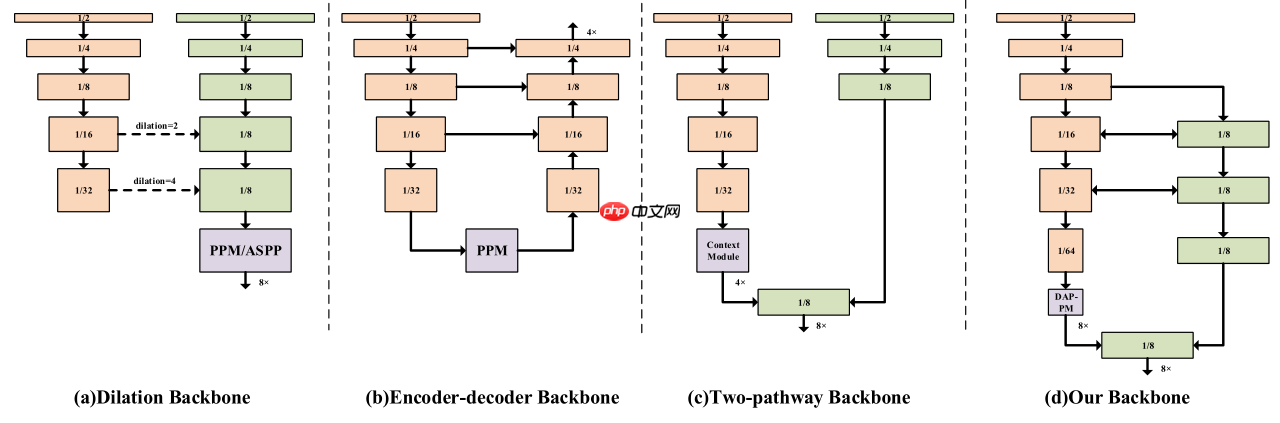
下图为语义分割模型的几种结构:

(a)空洞卷积:通过空洞卷积增加模型的感受野,保留高分辨率的特征图降低信息损失;(Deeplab系列)

(b)Encoder-Decoder:通过Encoder(backbone)提取不同分辨率的特征图,然后将不同分辨率的特征图上采样融合,可以通过更换backbone来控制模型的大小;(UNet、ESPNet)

(c)Two-pathway:模型包含2个path,一个path负责提取上下文语义信息,一个path保留细节信息,然后将2个path输出融合。(BiSeNetV1、V2)

(d)DDRNet结构,具体见下文。【第六期论文复现赛-语义分割】DDRNet - 创想鸟        
二、网络结构

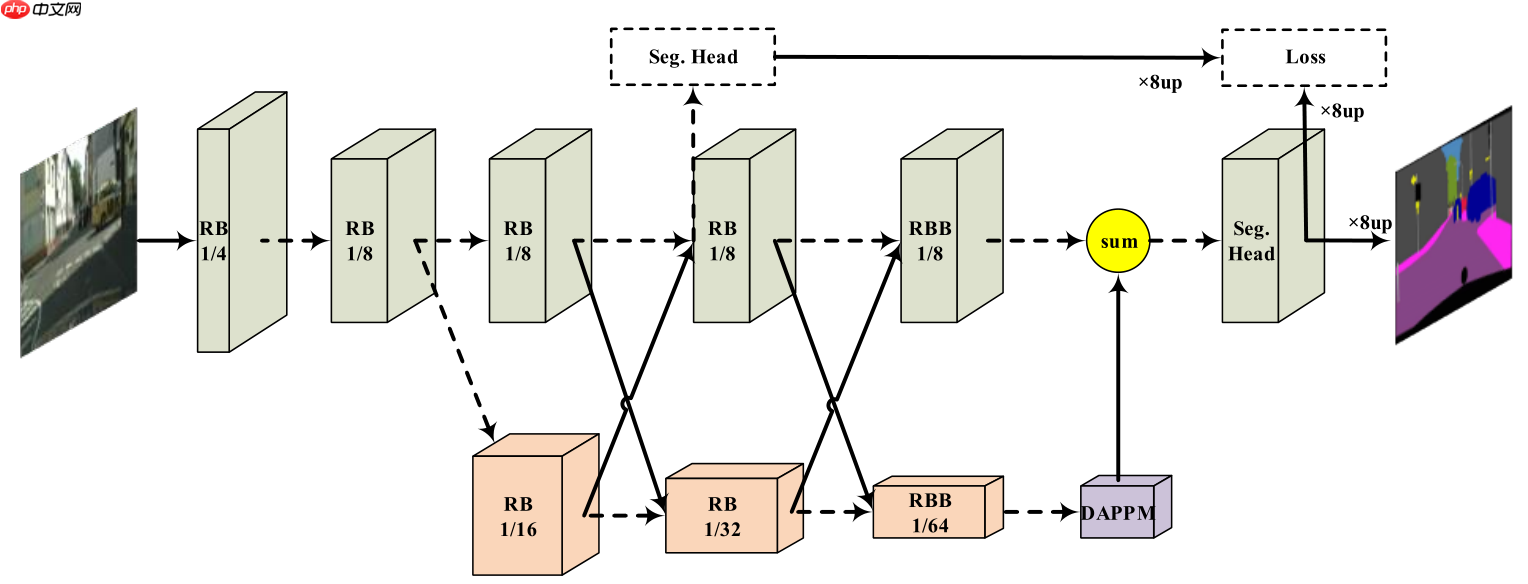
DDRNet网络结构如下图所示,模型包含2个分支,上面的分支分辨率较高,保存细节信息,下面的分支分辨率较低,用来提取上下文信息(使用了DAPPM模块增加其感受野),分支间特征融合使用Bilateral fusion模块,另外引入辅助损失函数。【第六期论文复现赛-语义分割】DDRNet - 创想鸟        
三、Bilateral fusion

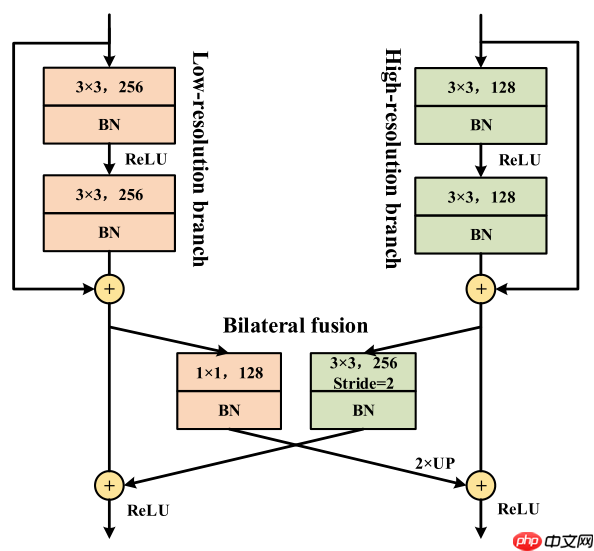
DDRNet为了结合不同分辨率的特征图,使用了Bilateral fusion模块,不同分支不同分辨率的特征图分别通过上采样下采样后相加,保持自身分辨率不变的同时融合了另一分支的信息。【第六期论文复现赛-语义分割】DDRNet - 创想鸟        
四、 Deep Aggregation Pyramid Pooling Module(DAPPM)

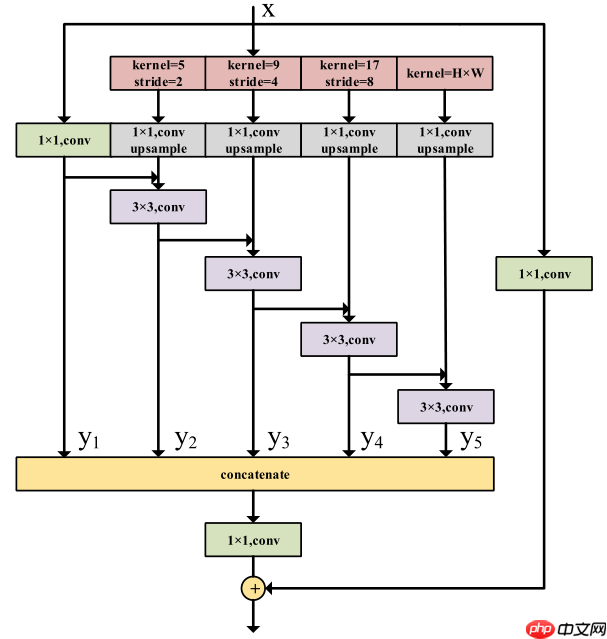
DAPPM为了获得多尺度信息,对输入特征图进行池化(核大小和步长不同),然后将不同大小的特征图上采样融合。

PS:池化部分类似PSPNet提出的Pyramid Pooling Module,整体结构类似ESPNetV2提出的EESP模块,具体可参考相关论文。 【第六期论文复现赛-语义分割】DDRNet - 创想鸟        
pytorch源码:

class DAPPM(nn.Module):    def __init__(self, inplanes, branch_planes, outplanes):        super(DAPPM, self).__init__()        self.scale1 = nn.Sequential(nn.AvgPool2d(kernel_size=5, stride=2, padding=2),                                    BatchNorm2d(inplanes, momentum=bn_mom),                                    nn.ReLU(inplace=True),                                    nn.Conv2d(inplanes, branch_planes, kernel_size=1, bias=False),                                    )        self.scale2 = nn.Sequential(nn.AvgPool2d(kernel_size=9, stride=4, padding=4),                                    BatchNorm2d(inplanes, momentum=bn_mom),                                    nn.ReLU(inplace=True),                                    nn.Conv2d(inplanes, branch_planes, kernel_size=1, bias=False),                                    )        self.scale3 = nn.Sequential(nn.AvgPool2d(kernel_size=17, stride=8, padding=8),                                    BatchNorm2d(inplanes, momentum=bn_mom),                                    nn.ReLU(inplace=True),                                    nn.Conv2d(inplanes, branch_planes, kernel_size=1, bias=False),                                    )        self.scale4 = nn.Sequential(nn.AdaptiveAvgPool2d((1, 1)),                                    BatchNorm2d(inplanes, momentum=bn_mom),                                    nn.ReLU(inplace=True),                                    nn.Conv2d(inplanes, branch_planes, kernel_size=1, bias=False),                                    )        self.scale0 = nn.Sequential(                                    BatchNorm2d(inplanes, momentum=bn_mom),                                    nn.ReLU(inplace=True),                                    nn.Conv2d(inplanes, branch_planes, kernel_size=1, bias=False),                                    )        self.process1 = nn.Sequential(                                    BatchNorm2d(branch_planes, momentum=bn_mom),                                    nn.ReLU(inplace=True),                                    nn.Conv2d(branch_planes, branch_planes, kernel_size=3, padding=1, bias=False),                                    )        self.process2 = nn.Sequential(                                    BatchNorm2d(branch_planes, momentum=bn_mom),                                    nn.ReLU(inplace=True),                                    nn.Conv2d(branch_planes, branch_planes, kernel_size=3, padding=1, bias=False),                                    )        self.process3 = nn.Sequential(                                    BatchNorm2d(branch_planes, momentum=bn_mom),                                    nn.ReLU(inplace=True),                                    nn.Conv2d(branch_planes, branch_planes, kernel_size=3, padding=1, bias=False),                                    )        self.process4 = nn.Sequential(                                    BatchNorm2d(branch_planes, momentum=bn_mom),                                    nn.ReLU(inplace=True),                                    nn.Conv2d(branch_planes, branch_planes, kernel_size=3, padding=1, bias=False),                                    )                self.compression = nn.Sequential(                                    BatchNorm2d(branch_planes * 5, momentum=bn_mom),                                    nn.ReLU(inplace=True),                                    nn.Conv2d(branch_planes * 5, outplanes, kernel_size=1, bias=False),                                    )        self.shortcut = nn.Sequential(                                    BatchNorm2d(inplanes, momentum=bn_mom),                                    nn.ReLU(inplace=True),                                    nn.Conv2d(inplanes, outplanes, kernel_size=1, bias=False),                                    )    def forward(self, x):        #x = self.downsample(x)        width = x.shape[-1]        height = x.shape[-2]                x_list = []        x_list.append(self.scale0(x))        x_list.append(self.process1((F.interpolate(self.scale1(x),                        size=[height, width],                        mode='bilinear')+x_list[0])))        x_list.append((self.process2((F.interpolate(self.scale2(x),                        size=[height, width],                        mode='bilinear')+x_list[1]))))        x_list.append(self.process3((F.interpolate(self.scale3(x),                        size=[height, width],                        mode='bilinear')+x_list[2])))        x_list.append(self.process4((F.interpolate(self.scale4(x),                        size=[height, width],                        mode='bilinear')+x_list[3])))               out = self.compression(torch.cat(x_list, 1)) + self.shortcut(x)        return out


五、实验结果

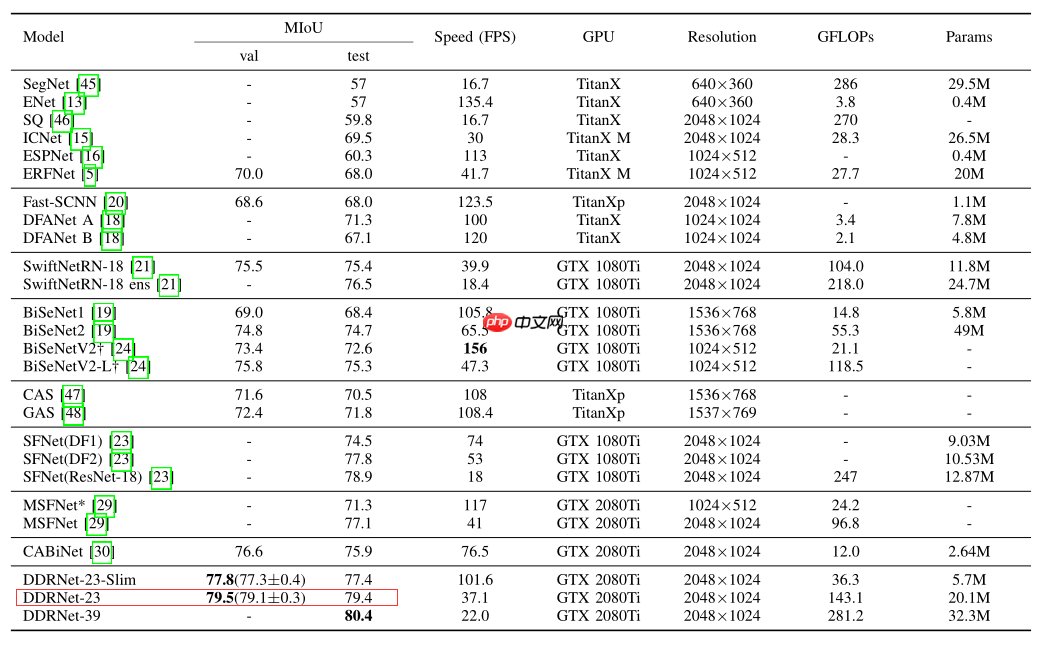
cityscapes在cityscapes验证集和测试集上的表现如下: 【第六期论文复现赛-语义分割】DDRNet - 创想鸟        
六、复现结果

本次复现的目标是DDRNet-23 在cityscapes验证集 mIOU= 79.5%,复现的miou为79.85%。详情见下表:

Model Backbone Resolution Training Iters mIoU mIoU (flip) mIoU (ms+flip) Links

DDRNet_23-1024×102412000079.85%80.11%80.44%model|log|vdl

七、快速体验

运行以下cell,快速体验DDRNet-23。

In [ ]

# step 1: unzip data%cd ~/PaddleSeg/!mkdir data!tar -xf ~/data/data64550/cityscapes.tar -C data/%cd ~/

   In [ ]

# step 2: 训练%cd ~/PaddleSeg!python train.py --config configs/ddrnet/ddrnet23_cityscapes_1024x1024_120k.yml     --do_eval --use_vdl --log_iter 100 --save_interval 4000 --save_dir output

   In [ ]

# step 3: val%cd ~/PaddleSeg/!python val.py        --config configs/ddrnet/ddrnet23_cityscapes_1024x1024_120k.yml        --model_path output/best_model/model.pdparams

   In [ ]

# step 4: val flip%cd ~/PaddleSeg/!python val.py        --config configs/ddrnet/ddrnet23_cityscapes_1024x1024_120k.yml        --model_path output/best_model/model.pdparams        --aug_eval        --flip_horizontal

   In [ ]

# step 5: val ms flip %cd ~/PaddleSeg/!python val.py        --config configs/ddrnet/ddrnet23_cityscapes_1024x1024_120k.yml        --model_path output/best_model/model.pdparams        --aug_eval        --scales 0.75 1.0 1.25        --flip_horizontal

   In [ ]

# step 6: 预测, 预测结果在~/PaddleSeg/output/result文件夹内%cd ~/PaddleSeg/!python predict.py        --config configs/ddrnet/ddrnet23_cityscapes_1024x1024_120k.yml        --model_path output/best_model/model.pdparams        --image_path data/cityscapes/leftImg8bit/val/frankfurt/frankfurt_000000_000294_leftImg8bit.png        --save_dir output/result

   In [ ]

# step 7: export%cd ~/PaddleSeg!python export.py        --config configs/ddrnet/ddrnet23_cityscapes_1024x1024_120k.yml        --model_path output/best_model/model.pdparams        --save_dir output

   In [ ]

# test tipc 1: prepare data%cd ~/PaddleSeg/!bash test_tipc/prepare.sh ./test_tipc/configs/ddrnet/train_infer_python.txt 'lite_train_lite_infer'

   In [ ]

# test tipc 2: pip install%cd ~/PaddleSeg/test_tipc/!pip install -r requirements.txt

   In [ ]

# test tipc 3: 安装auto_log%cd ~/!git clone https://github.com/LDOUBLEV/AutoLog           %cd AutoLog/!pip3 install -r requirements.txt!python3 setup.py bdist_wheel!pip3 install ./dist/auto_log-1.2.0-py3-none-any.whl

   In [ ]

# test tipc 4: test train inference%cd ~/PaddleSeg/!bash test_tipc/test_train_inference_python.sh ./test_tipc/configs/ddrnet/train_infer_python.txt 'lite_train_lite_infer'


以上就是【第六期论文复现赛-语义分割】DDRNet的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/55256.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
华为手机摄像头怎么设置才能拍出清晰照片?详细调整技巧全解析
上一篇 2025年11月9日 20:03:24
就等发布了!有铁杆米粉预定小米15 Ultra:直接上1TB顶配版
下一篇 2025年11月9日 20:03:27

相关推荐

  • Chrome浏览器怎么开启数据同步功能_Chrome浏览器跨设备数据同步设置教程

    首先登录Google账户启用Chrome同步功能,确保书签、历史记录、密码等数据跨设备一致;接着在设置中自定义同步内容类型以满足隐私需求;然后通过Google账户密钥或自定义密码加密同步数据,提升安全性;最后在新设备登录同一账户,自动接收已同步的浏览数据,实现无缝体验。 如果您希望在不同设备间无缝使…

    2026年9月21日
    000
  • 如何使用XGBoost训练AI大模型?优化机器学习模型的步骤

    XGBoost并非用于训练GPT类大模型,而是擅长处理结构化数据的高效梯度提升算法,其优势在于速度快、准确性高、支持并行计算、内置正则化与缺失值处理,适用于表格数据建模;通过分阶段超参数调优(如学习率、树深度、采样策略)、结合贝叶斯优化与交叉验证,并配合特征工程、数据预处理和集成学习等关键步骤,可显…

    2026年9月21日
    000
  • VSCode代码编辑器在线使用_VSCode网页版免安装直接进入编辑

    答案:无需安装即可在浏览器使用VSCode,主要方式包括GitHub Codespaces、Gitpod、StackBlitz、CodeSandbox和自托管code-server,适用于不同场景,如GitHub集成、前端开发或完全控制环境;但存在网络依赖、性能限制、插件兼容性、文件访问和安全等局限…

    2026年9月21日
    100
  • VSCode远程开发:配置容器与SSH连接的最佳实践解析

    使用VSCode远程开发提升效率,通过Remote-Containers和Remote-SSH实现环境标准化。1. 配置.devcontainer文件夹,用devcontainer.json定义容器环境,推荐自定义Dockerfile并预装工具;2. SSH连接需配置公钥认证、~/.ssh/conf…

    2026年9月21日
    100
  • VSCode怎么运行全部代码_VSCode批量执行代码教程

    在VSCode里“运行全部代码”或“批量执行代码”,其实很少是一个单一的、所有语言通用的按钮。它更多的是指根据你项目的具体需求,通过配置任务(Tasks)、使用集成终端(Integrated Terminal)配合脚本,或者利用特定语言的运行/调试配置(Launch Configurations)来…

    2026年9月21日
    100
  • TuxPaint的AI工具怎么裁剪图片?教你轻松完成图片裁剪步骤

    TuxPaint的AI工具怎么裁剪图片?教你轻松完成图片裁剪步骤TuxPaint的AI工具怎么裁剪图片?教你轻松完成图片裁剪步骤TuxPaint的AI工具怎么裁剪图片?教你轻松完成图片裁剪步骤TuxPaint的AI工具怎么裁剪图片?教你轻松完成图片裁剪步骤

    TuxPaint没有AI裁剪工具,只能通过橡皮擦或填充工具手动模拟裁剪效果,适合儿童创意绘画但不适合精确图像编辑。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ TuxPaint作为一个面向儿童的绘画软件,其实并没有专门的“AI工具”来执行…

    2026年9月21日 用户投稿
    100
  • Windows&Linux双系统安装流程

    Windows&Linux双系统安装流程Windows&Linux双系统安装流程Windows&Linux双系统安装流程Windows&Linux双系统安装流程

    大家好,很高兴再次见到大家,我是你们的朋友全栈君。 注意事项:在安装Windows与Linux双系统时,建议先安装Windows系统,否则可能会导致grub引导被覆盖的问题。 Windows 10系统安装 制作启动盘(优启通链接)https://www.php.cn/link/219b87ff108…

    2026年9月21日 用户投稿
    200
  • VSCode中怎么使用REM_VSCode移动端REM布局编写与换算教程

    答案:REM_VSCode插件可自动将像素转换为REM,需配置rootFontSize和precision,支持自动与手动转换,确保与html的font-size一致,配合media query适配不同屏幕,若插件异常可检查配置、重启或重装,替代工具有postcss-pxtorem、在线转换工具及浏…

    2026年9月21日
    100
  • MySQL性能模式监控资源_MySQL瓶颈定位精确工具

    MySQL性能模式监控资源_MySQL瓶颈定位精确工具MySQL性能模式监控资源_MySQL瓶颈定位精确工具MySQL性能模式监控资源_MySQL瓶颈定位精确工具MySQL性能模式监控资源_MySQL瓶颈定位精确工具

    mysql性能模式通过事件记录精准定位瓶颈,核心步骤包括:1.启用并配置performance schema,选择性开启消费者和仪器;2.监控等待事件、sql语句、阶段、i/o、内存及锁等关键指标;3.分析events_waits_summary_global_by_event_name等表识别资源…

    2026年9月21日 用户投稿
    000
  • 三星在电视端首发Perplexity AI应用程序,带来更具创新性AI体验

    10 月 23 日消息,三星电子于美国当地时间 21 日宣布,率先在电视终端推出 perplexity ai 应用程序,为三星电视用户带来更富创新的 ai 使用体验。 借助该应用程序,用户在安排日常生活、查找特定影视内容、创建梦幻体育联赛阵容或策划万圣节活动等场景中,可获得 AI 以卡片式回复框形式…

    2026年9月21日
    500
  • 帕鲁高管回应《幻兽帕鲁:帕鲁农场》疑似碰瓷《宝可梦 pokopia》:乱讲阴谋论

    帕鲁高管回应《幻兽帕鲁:帕鲁农场》疑似碰瓷《宝可梦 pokopia》:乱讲阴谋论帕鲁高管回应《幻兽帕鲁:帕鲁农场》疑似碰瓷《宝可梦 pokopia》:乱讲阴谋论帕鲁高管回应《幻兽帕鲁:帕鲁农场》疑似碰瓷《宝可梦 pokopia》:乱讲阴谋论帕鲁高管回应《幻兽帕鲁:帕鲁农场》疑似碰瓷《宝可梦 pokopia》:乱讲阴谋论

    在不久前的任天堂直面会上,官方公布了一款宝可梦ip的衍生新作——《宝可梦 pokopia》。这款作品让玩家化身一只能够变身成人类训练家的百变怪,主打种田与建造玩法,属于模拟经营类游戏。 视频欣赏: 无独有偶,几天后,《幻兽帕鲁》的开发商PocketPair也正式公布了他们的全新衍生作《幻兽帕鲁:帕鲁…

    2026年9月21日 用户投稿
    000
  • 如何使用mysql设计客户信息管理项目

    答案:设计客户信息管理系统需先明确功能需求,再合理规划数据库结构。1. 根据客户需求划分模块,包括客户基本信息、分类、状态、跟进记录等;2. 创建核心表如customers、company_info、follow_ups和users,确保字段完整且符合业务逻辑;3. 在关键字段上建立索引以提升查询效…

    2026年9月21日
    400
  • VSCode怎么新建ipynb文件_VSCode创建和编辑Jupyter笔记本文件教程

    答案:在VSCode中运行Jupyter笔记本需准备Python环境、安装Python扩展并确保安装ipykernel;通过命令面板或文件菜单新建笔记本,编辑时可添加代码或Markdown单元格,运行代码后结果实时显示;通过右上角内核选择器切换Python环境,推荐为不同项目配置独立虚拟环境以避免依…

    2026年9月21日
    100
  • Windows 10功能更新1909版错误0xc19001e1怎么解决?

    0xc19001e1错误可通过禁用第三方安全软件、清理磁盘空间、运行Windows更新疑难解答及重置更新组件解决。首先卸载非微软安全软件并重启;确保C盘有20GB以上可用空间,通过设置清理临时文件;使用内置疑难解答工具修复更新问题;最后以管理员身份运行命令提示符,停止wuauserv、cryptSv…

    2026年9月21日
    000
  • 夸克Ai搜索如何设置默认_夸克Ai搜索默认引擎更改

    首先在夸克APP中将默认搜索引擎设为AI引擎,再开启相关AI功能开关以启用AI搜索服务。具体步骤:1、打开夸克APP,点击右下角菜单进入设置;2、选择“通用”选项,点击“搜索引擎”;3、选择“AI引擎”或“夸克AI搜索”作为默认服务;4、返回主界面测试搜索关键词,确认AI结果是否展示;5、进入“AI…

    2026年9月21日
    400
  • mysql如何实现后台管理系统

    答案:基于MySQL的%ignore_a_1%需设计用户、权限、日志等表结构,通过后端语言实现安全的CRUD接口与JWT认证,前端展示数据并控制权限,确保系统安全稳定。 实现一个基于 MySQL 的后台管理系统,核心是构建一个安全、稳定、可扩展的系统架构,将数据库作为数据存储层,配合后端语言和前端界…

    2026年9月21日
    000
  • Workerman服务启动失败的排查步骤

    workerman服务启动失败的排查步骤如下:1. 检查配置文件,确保无语法错误;2. 查看系统日志,寻找错误线索;3. 检查端口占用情况,确保端口未被占用;4. 调整文件权限,确保workerman有足够权限;5. 检查php环境,确保版本兼容且扩展已安装。 关于Workerman服务启动失败的排…

    2026年9月21日
    200
  • 百度浏览器自动跳转怎么办 百度浏览器页面跳转广告拦截方法

    百度浏览器自动跳转通常由恶意软件或设置被篡改引起,需检查浏览器设置、清除异常插件、修复快捷方式与注册表,并使用安全软件扫描清理,同时启用广告拦截与隐私保护功能以彻底解决问题。 百度浏览器出现自动跳转,通常不是浏览器本身的问题,而是由恶意软件、插件或设置被篡改导致的。解决这个问题需要从多个方面入手,检…

    2026年9月21日
    100
  • 压力测试(Benchmark)Swoole服务的工具与方法

    进行swoole服务的压力测试是为了确保服务在高负载下稳定运行。1. 选择工具:apache jmeter、wrk、locust。2. 使用方法:jmeter通过脚本配置,wrk通过命令行,locust通过python脚本。3. 注意事项:环境隔离、数据监控、脚本设计。4. 优化点:内存泄漏、连接池…

    2026年9月21日
    000
  • Windows11内存占用率过高怎么解决_Windows11内存占用过高修复方法

    1、通过任务管理器结束高内存占用进程;2、禁用Superfetch(SysMain)服务以降低内存负担;3、优化启动项减少后台负载;4、升级物理内存条提升系统性能。 如果您发现Windows 11系统运行缓慢,并且任务管理器显示内存占用率持续处于高位,这可能是由于后台进程过多、系统服务占用资源或硬件…

    2026年9月21日
    100

发表回复

登录后才能评论
关注微信