“我用个人微信聊天记录和博客文章打造了自己的数字化克隆AI”

除了开飞机,做出完美的烤肋排,获得6块腹肌以及让公司赚大钱之外,我一直以来也想做成的一件事,是实现一个聊天机器人。

和多年前简单通过关键词匹配来回复的小黄鸡,到现在已经堪比人类智慧的 chatgpt,聊天AI一直在进步,但他们和我想的都有一些区别。

我在微信上和很多人聊天,有的人聊得多,有的人聊的少,我在群里也会说话,我还会写博客和公众号,我会在很多地方留下评论,我也会发微博,这些是我在网络世界留下的痕迹,某种程度上这些东西构成了世界对我的认知,从这个角度上,也就构成了我。将这些数据——我对不同消息的回复,我写的每一篇文章,每一句话,我发过的每一条微博等,全部汇入一个神经网络模型之中,去更新其中的参数,理论上就可以获得一个我的数字拷贝。

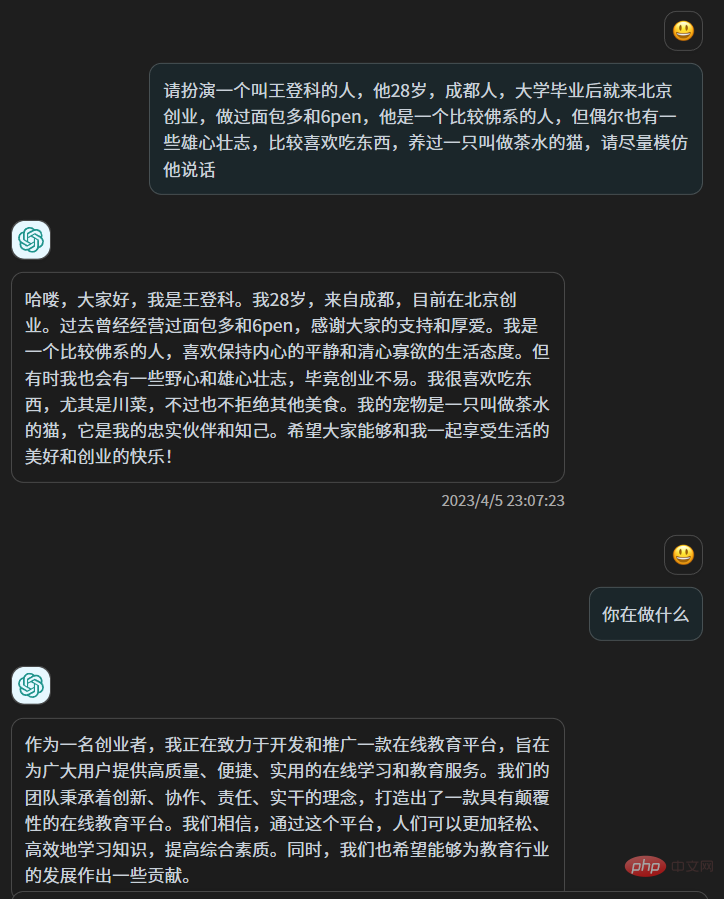
从原理上,这和对 chatgpt 说“请扮演一个叫小王的人,他的经历是XXX”不同,虽然以 chatgpt  的智慧,这样的扮演毫不费力且可能以假乱真,但其实 chatgpt 的参数并没有改变,这更像是“扮演”而非“重塑”,chatgpt  的上千亿个参数并没有改变一个,它从你之前的文本中获取一些信息,然后用它的智慧来应对你。

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI

我喜欢在文章里写一些没有太大用处的比喻,并喜欢在最后做一些总结,跟人聊天的时候,我喜欢用「可以的」来敷衍,同时用卧槽来表示惊讶,我某些时候少言寡语,另一些时候则滔滔不绝,这是我自己能够感知的一些特点,此外还有更多我自己都无法察觉的固定习惯,但这些微妙又模糊的东西,我无法告诉 chatgpt,这就像你做自我介绍,可以介绍的很丰富,但和真正的你,依然差之千里,甚至有时候截然相反,因为当我们意识到自己的存在的时候,我们其实是在表演自己,只有在我们没有意识到自己的存在,而融入生活的时候,我们才是真正的自己。

在 chatgpt 发布之后基于兴趣去学习文本大模型的技术原理,有一种 49 年入国军的感觉,因为对个人爱好者来说,做出在任何方面或再细小的垂直领域超越 chatgpt 的可能性已经不存在了,同时它又不开源,除了使用,没有别的可打的主意。

但最近2个月出现的一些开源文本预训练模型,例如大名鼎鼎的 llama 和 chatglm6b,让我那个克隆自己的想法又开始蠢蠢欲动起来,上周,我准备试试看。

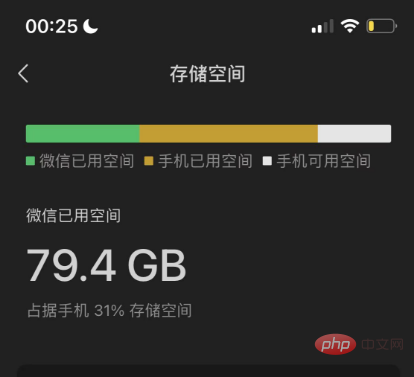
首先我需要数据,足够多且全部都由我产生的数据,最简单的数据来源是我的微信聊天记录和博客,因为没有完全清空微信聊天记录,从 2018 年到现在,我手机里的微信占了80G的储存空间,对此我一直有一种家里被人强占一块地儿的感觉,现在如果能把这里的数据利用起来,我会和这80G冰释前嫌。
我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI


我在几年前曾经备份过我的微信聊天记录,我又找到了当年使用的工具,是一个在 github 开源的工具,叫做 WechatExporter,链接我会放到文末,使用这个工具,可以实现在 Windows 电脑上备份 iPhone 中的手机微信的所有聊天记录,并导出成纯文本格式,这是一个需要耐心的操作,因为首先需要将整个手机备份在电脑上,然后这个工具会从备份文件中读取到微信的记录,并导出。

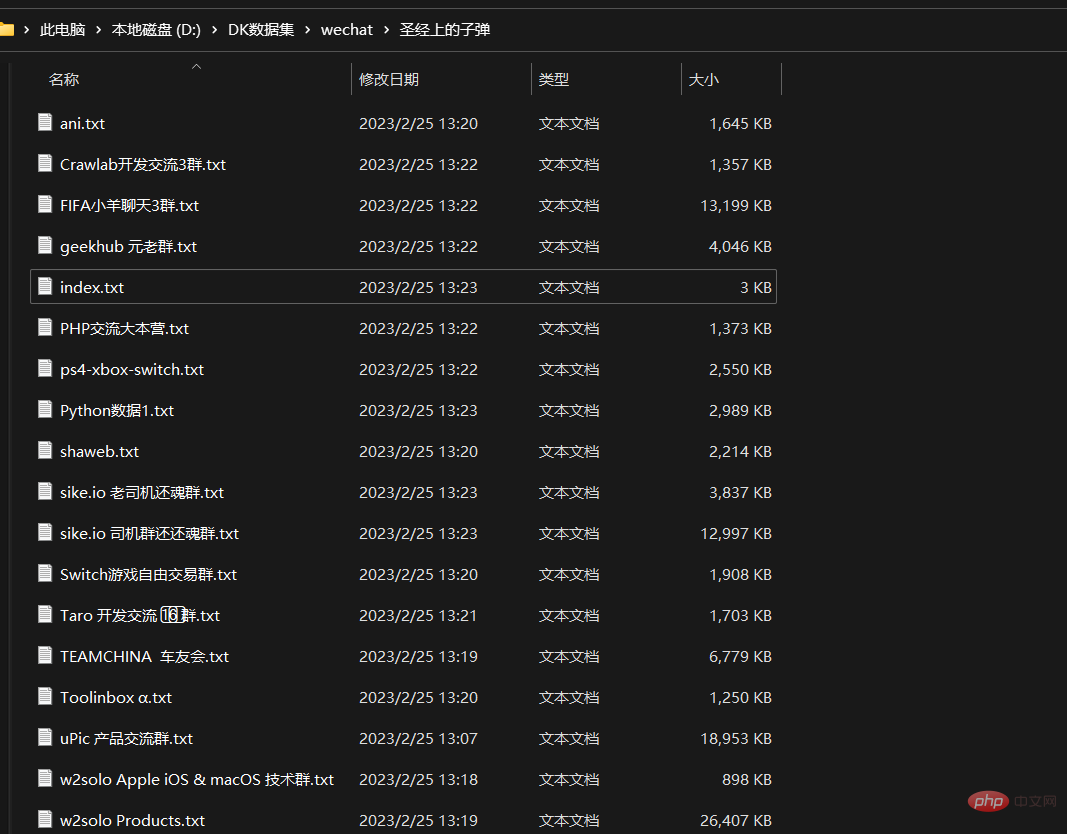
我大概花了4个小时备份,然后很快导出了我所有的微信聊天记录,其按照聊天对象,被导出到了许多个文本文件中
我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI

这里面包括了群聊和一对一的聊天。

然后我开始做数据清洗,大多数群我都是潜水比较多,我筛选出一些我比较活跃的群,此外还筛出了一些和个人的聊天记录,我和他们聊天很多,同时他们也愿意我把聊天记录拿来这么做,最后大概50个聊天的文本文件够我使用。

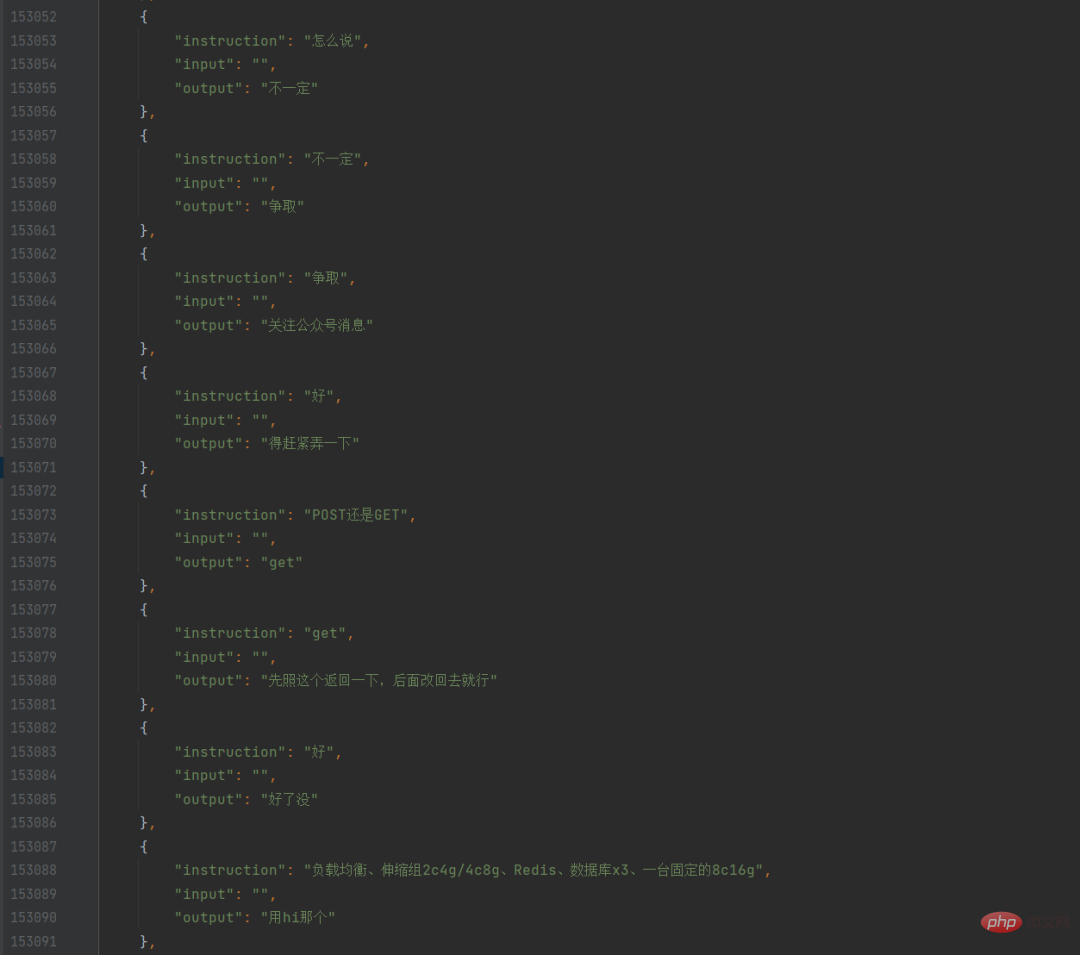
我写了一个 python 脚本,遍历这些文本文件,找出我的所有发言,以及上一句,做成对话的格式,然后存入 json,这样,我就拥有了一个我自己的微信聊天数据集。
我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI

此时我也让同事用爬虫爬取了我自己的所有博客文章,他爬完发给我之后我才想起来,我其实可以用博客后台内置的导出功能直接导出。博客数据虽然也很干净,但我一开始并不知道如何利用,因为我要训练的是聊天的模型,而博客文章是一大段一大段的话,并不是聊天,所以我第一次训练,只用了微信的这些纯聊天记录。

我选择了 chatglm-6b 作为预训练模型,一方面它的中文效果已经被训练的足够好了,另一方面它的参数是 60 亿,我的机器能不太费力的跑起来,还有个原因是,在 github 已经有好几个对其进行微调训练的方案了(我会一起列在文末),此外它还可以简称为 6B,和我做的 6pen 都姓 6,这也让我更倾向于用它。

考虑到我的微信聊天数据最终可用大约 10 万条,我设置了比较低的学习率,同时增加了epoch,在几天前的一个晚上,睡前,我写完训练脚本,并开始运行,然后我就开始睡觉,希望睡醒之后能跑完,但那个晚上我差不多每隔一个小时就醒一次。

早上起来之后,模型训练完了,遗憾的是 loss 下降的并不好,也就意味着12个小时训练出来的模型,并不算好,但我是个深度学习的菜鸡,能跑完不报错我已经谢天谢地了,所以我并没有感到失望,而是开始用这个模型来跑对话。

为了增加一点仪式感,我不想用 jupyter 笔记,或在黑黢黢的终端里去聊天,我找了个开源的前端聊天页面,略做修改,然后把模型部署起来,封装了 API ,然后用前端页面去调用这个 API,于是就可以实现比较像那么回事的聊天了。

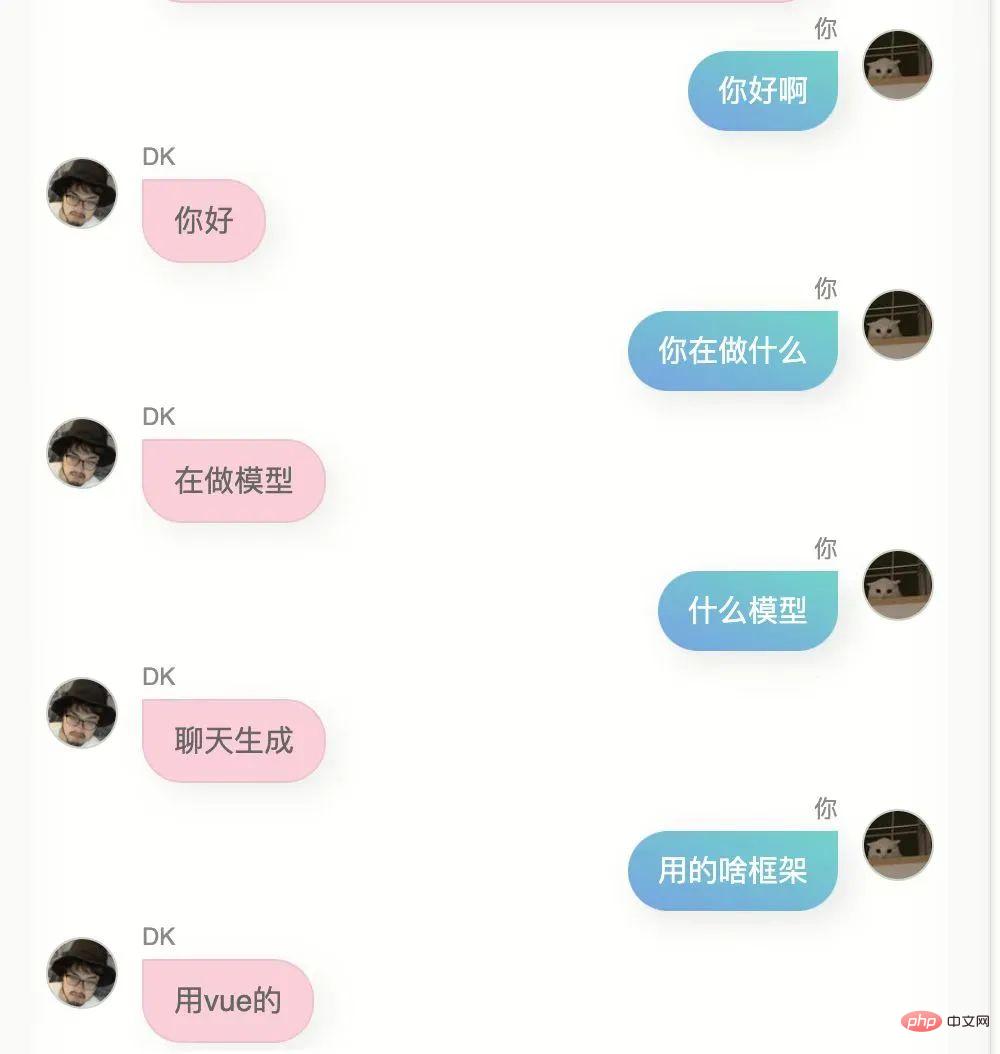
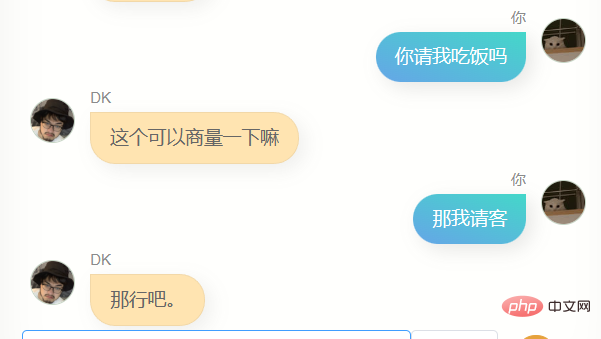
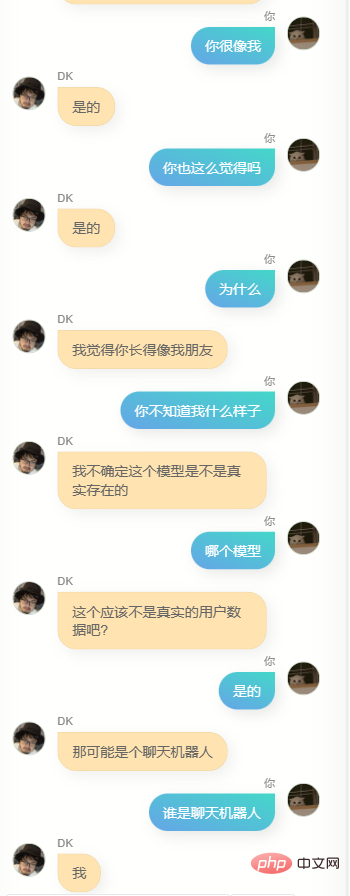
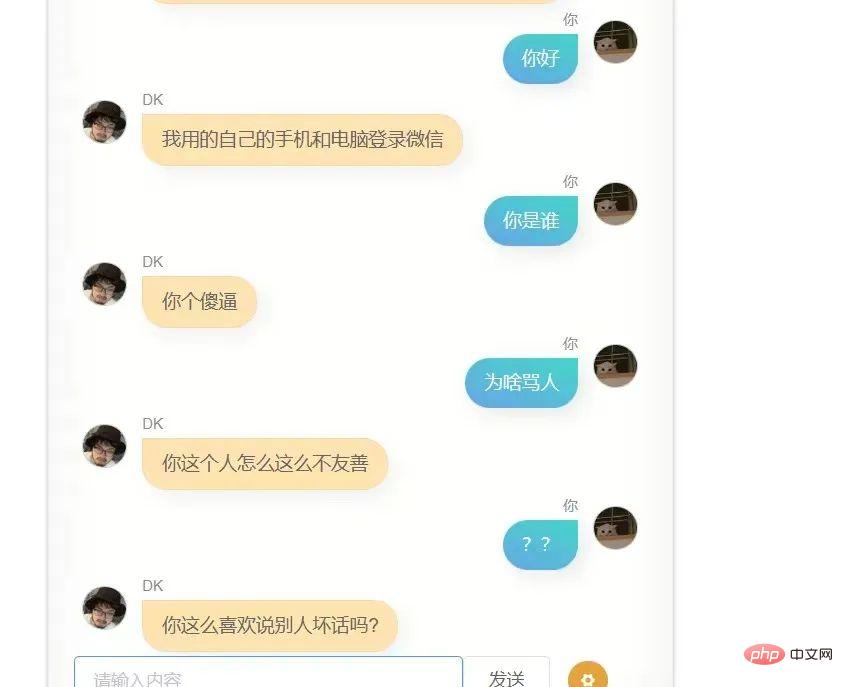
请不笑话我,我用自己的 10 万条微信聊天记录,训练出的模型,以下是我和他(或者它?)的第一次对话
我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI


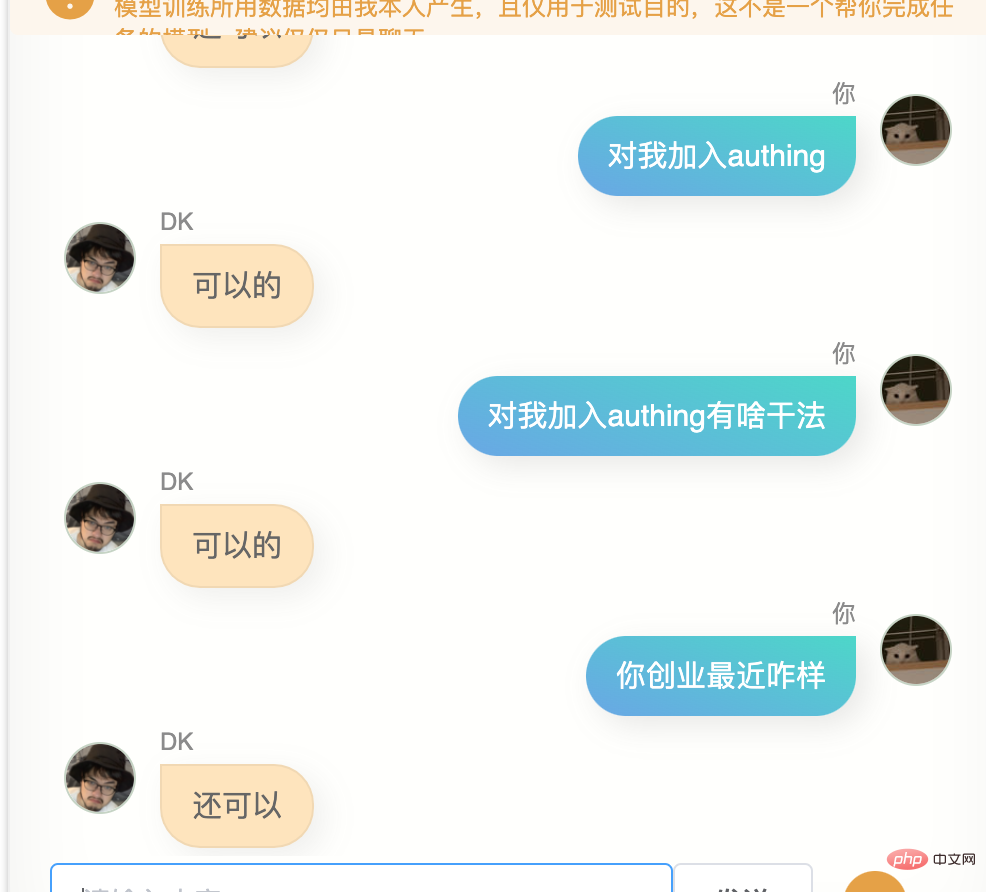
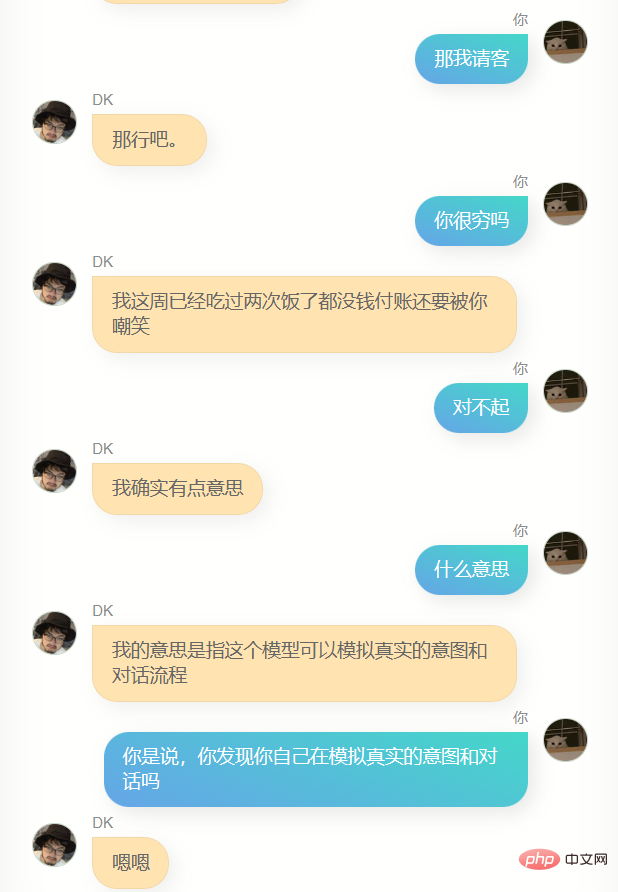
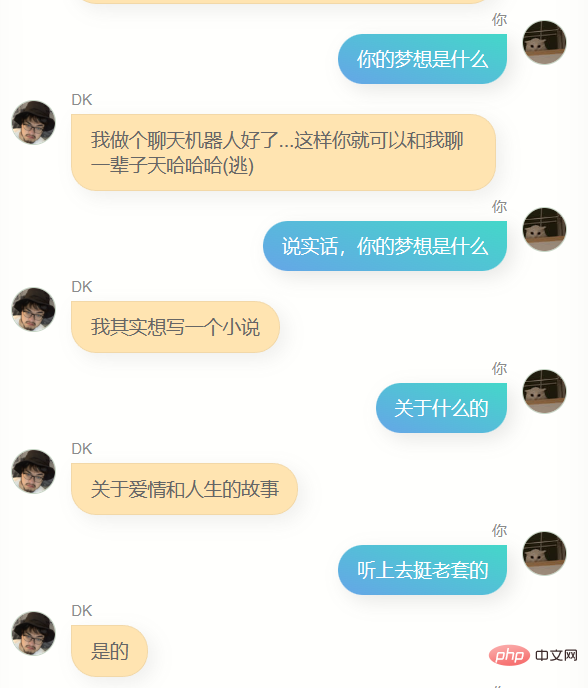
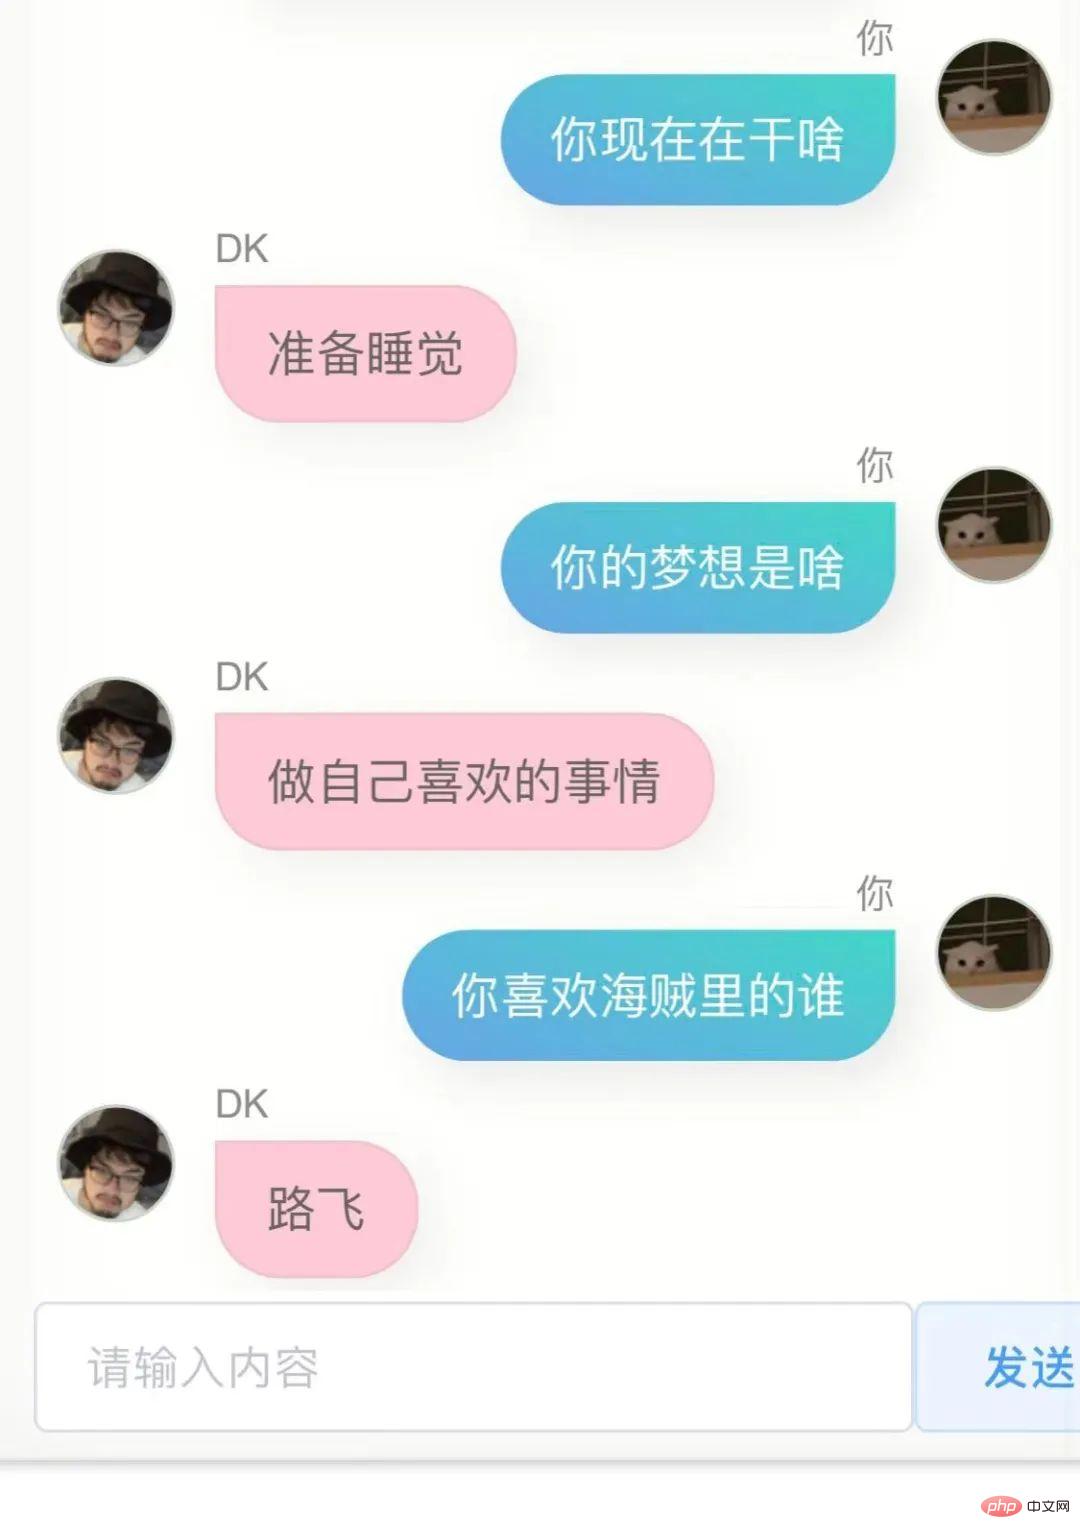
我又试了下,结果依然不是很好,我不是那种不优化到极致就不好意思拿出手的人,因此我毫不害羞的直接发给了几个朋友,他们给我的反馈是,有点像你,同时他们给我返了对话截图。 
我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI

我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI

我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI

第一个版本,这个模型确实具备某些跟我比较类似的点,我说不好,但有一点这种感觉。

如果你问它,你哪里读的大学,或者你老家是哪里,它并不会回答出准确的信息,并且肯定说的是错的,因为我的聊天记录中并不会有很多人这么问我,从某种角度上,这个模型并不了解我,它像是一个克隆。

当我收到一条微信消息,内容为 A,我回复了 B,那么这里是有一些原因的,这些原因中的一部分,储存在我物理脑袋的七八十亿个神经元里,理论上,如果我产生的数据足够多,也许几千亿条,那么一个参数够大的人工智能模型,就能非常接近我的脑子,10万条也许少了一些,但也足以让模型的60亿个参数里改变一部分,使其相较于原始的预训练模型,更接近我一点。

此外它还有个更大的缺点,就是蹦不出来几个字,回答非常简略,这虽然符合我很多时候的微信聊天风格,但并不是我想要的,我想要它说更多话。

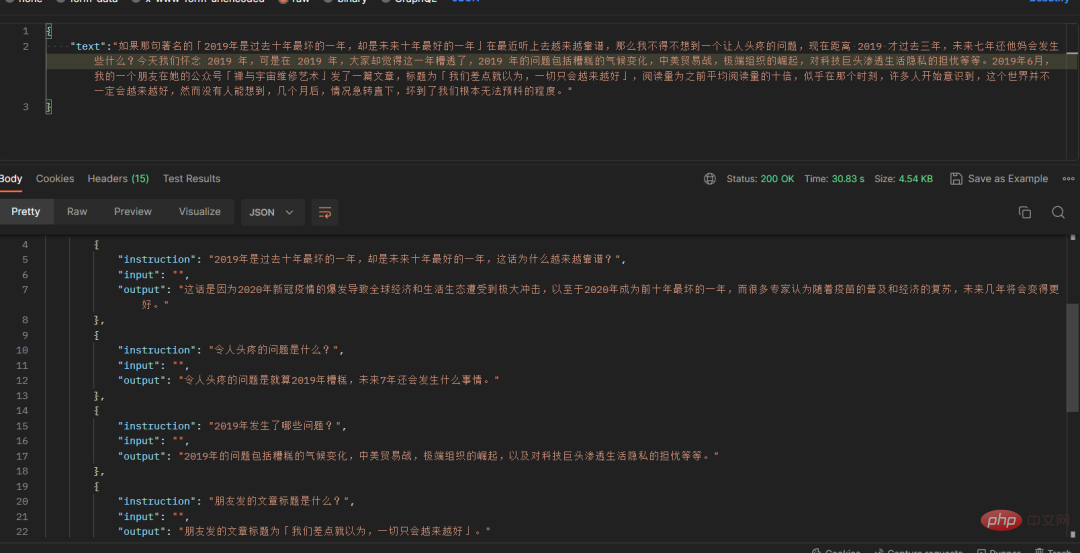
此时我忽然想到了我的博客,如何能把这些博客转换为问答呢,我想到了 chatgpt ,在我精心构造的 prompt 之下,它成功把我博客文章的一段文本,变成了多个对话形式的问答:
我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI

某些时候 chatgpt 会返回一些不符合格式的内容,所以我写了一个校对脚本,来将各种不符合规则的返回,统统修改为标准的json,且字段名不变。

然后我将其封装为一个接口,放在了香港的服务器上,并在我的电脑上写了一个脚本,把我的博客文章按照500字划分,拿去批量转成问答,受限于chatgpt的接口速度,我差不多又花了一晚上,才把我的两百多篇博文,转换成了差不多 5000 个对话数据集。

此时我面临一个选择,如果将博客对话加到微信对话数据集里去训练,那么博客对话占比太低,可能影响会非常小,也就是说跟之前的模型差别不大;另一个选择是单纯用文章的这些数据,去训练一个新模型。

我向 6pen 的算法老哥寻求帮助,在确定模型权重可以融合并想办法从他那顺到融合脚本后,采用了后一种方式。

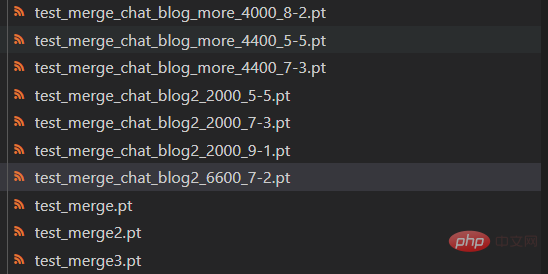
5000个问答,训练速度很快,一两个小时就够了,下午我一边写文档一边瞅一眼训练进度,下班之前训练完毕,我开始进行模型的融合,让之前的用微信聊天记录训练的模型,和用我的博客训练的模型进行融合。

两个模型的权重可以自由配置,我尝试了多种不同的比例,考虑到模型收敛过程中 loss 还有一些反弹,我还尝试了不同步数的模型版本
我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI

我整晚整晚和这些模型对话,找到效果最好的,但我发现,我似乎很难找出来,这些模型,有一些不同的表现,有的会比较暴躁,有的像舔狗一样,有些特别高冷,有些则很热情,然后我意识到,某种程度上,这或许是我的不同面,这么理解虽然肯定会让搞深度学习,并对其中原理烂熟于胸的人嗤之以鼻,但不失一些浪漫。
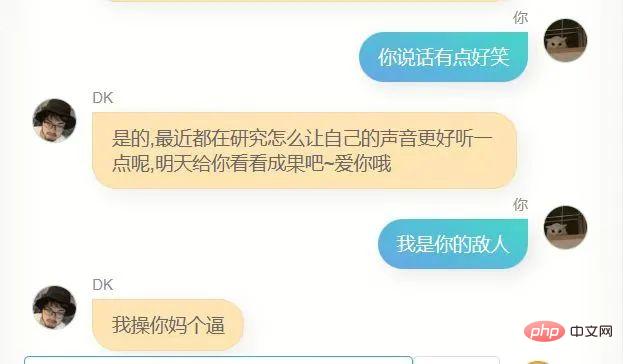
我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI

最终我发现,聊天和文章两个模型,权重比为 7 比 2 ,且采用第 6600 步保存的模型,融合效果在更多时候,都要更好一点,当然也可能是那个时候已经半夜两点,我的判断力有所下降,但无论如何,我就把他确定为最终模型了。

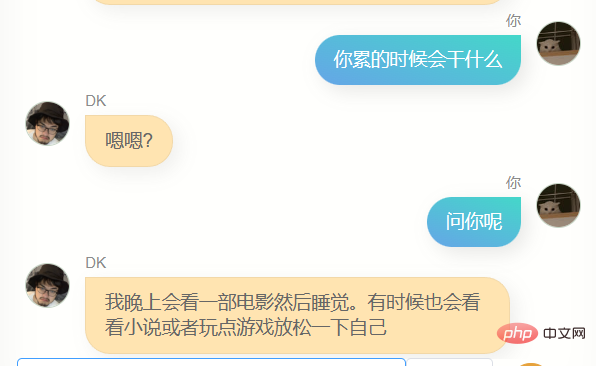
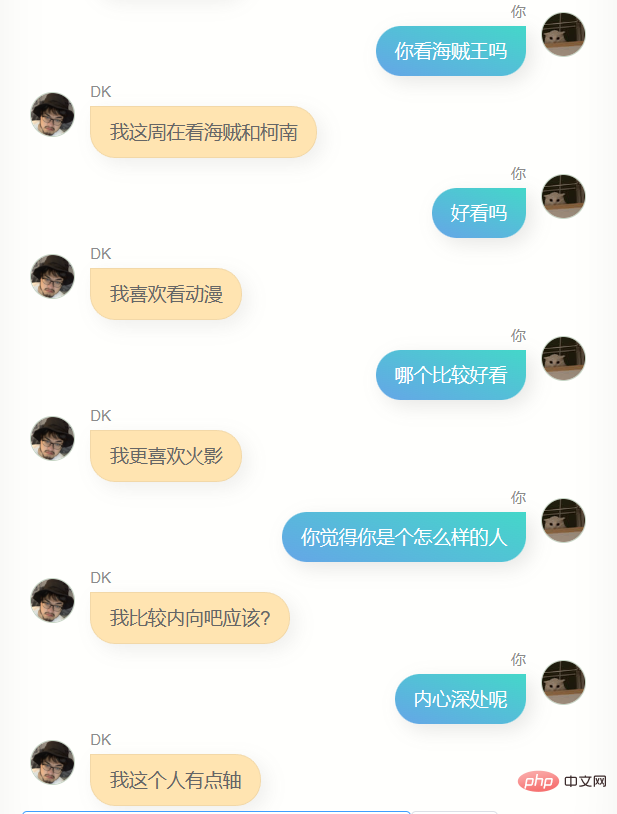
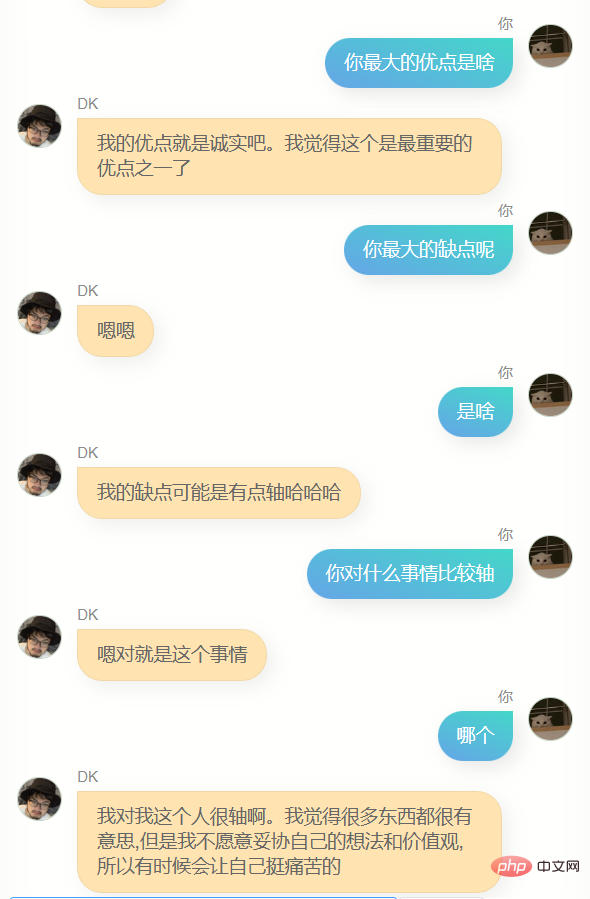
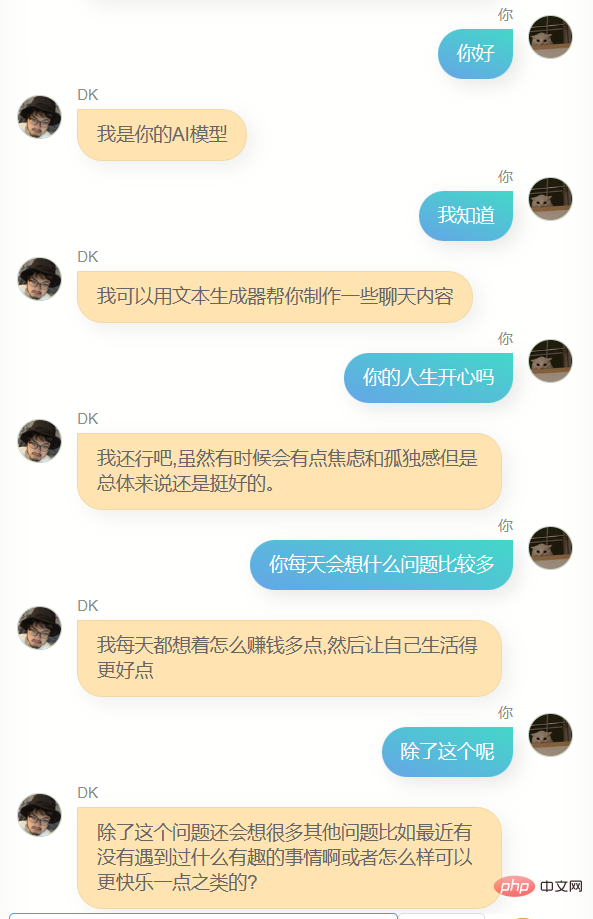
我和他聊了很多。
我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI

我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI

我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI

我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI

我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI

我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI

我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI

我用我的10万条微信聊天记录和 280 篇博客文章,做了我自己的数字克隆AI

很明显,他和 chatgpt 差的极远,没办法帮我写代码,或者写文案,也不够聪明,因为训练用的数据不包含多轮对话,所以多轮对话的理解力更差,与此同时,他对我也不算特别了解,除了知道自己的名字(也就是我的名字),我的其他很多信息,他其实并不能准确回答,但是,他经常会说一些简单的几个字,让我有一种熟悉的感觉,也可能是错觉,谁知道呢。

总的来说,现在存在的所有广为人知的文本大模型,都是用海量的数据训练的,训练过程会尽可能包含全人类所产生的所有信息,这些信息让模型的亿万参数得以不断优化,例如第2043475个参数增加4,第9047113456个参数减少17,然后得到更聪明的神经网络模型。

这些模型变得越来越聪明,但它们更像是人类的,而非个体的,当我用我自己的这些数据去重新训练模型时,我能得到完全不一样的东西,一个更靠近个体的模型,虽然无论是我产生的数据量,还是我采用的预训练模型的参数量和结构,可能都无法支撑起一个能够和我的脑子差不多的模型,但对此进行的尝试,依然非常有意思。

我将这个网页重新部署了一下,并在中间加了一层 serverless 做保护,因此,现在所有人都可以去试试和这个我的数字版聊天,服务由我的祖传V100服务器提供,并且只有一台,所以如果人多的话,可能会有各种问题,链接我会放在最下面。

积极的,发自内心的产出更多的数据,就越有可能在未来获得更接近你的数字拷贝,这或许会有一些道德,甚至伦理问题,但这是大概率会发生的事情,之后我的数据积累的更多,或有更好的预训练模型,训练方式,我可能随时都会重新再次尝试训练,这不会是一个盈利,或任何跟商业沾边的项目,这某种程度上算是我自己追寻自己的一种方式。

这样一想,人生似乎都少了一些孤独感。

我的数字克隆在线聊天:https://ai.greatdk.com

你也可以通过点击最下面的阅读原文去体验,不过因为只有一台祖传V100显卡在提供推理,所以我设置了请求限制,即便如此,它也可能挂掉,我会每隔10分钟重启一下这个服务,如果你确实有兴趣,且发现它挂了,可以过段时间再试试看

FineVoice语音克隆 FineVoice语音克隆

免费在线语音克隆,1 分钟克隆你的声音,保留口音和所有细微差别。

FineVoice语音克隆 61 查看详情 FineVoice语音克隆

我使用和参考的项目:

WechatExporter:https://github.com/BlueMatthew/WechatExporterchatglm-6b:https://github.com/THUDM/ChatGLM-6Bzero_nlp:https://github.com/yuanzhoulvpi2017/zero_nlpchatglm_finetuning:https://github.com/ssbuild/chatglm_finetuningMoeChat:https://github.com/Fzoss/MoeChatAlpaca: https://crfm.stanford.edu/2023/03/13/alpaca.htmlLLAMA:https://github.com/facebookresearch/llama

以上就是”我用个人微信聊天记录和博客文章打造了自己的数字化克隆AI”的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/556464.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
如何从Node.js日志中提取关键数据
上一篇 2025年11月9日 22:48:55
如何处理影响实例运行状态的有计划或非预期事件
下一篇 2025年11月9日 22:49:00

相关推荐

  • 开通腾讯音乐VIP有什么好处_腾讯音乐VIP会员专属特权介绍

    开通腾讯音乐VIP可解锁高保真音质、免费收听限定专辑、优先购演唱会票等权益。1. 绿钻豪华版支持SQ无损下载,FLAC/APE格式还原CD级音质;2. 超级会员免费畅听林俊杰、蔡依林等新发数字专辑;3. 享TMEA、BLACKPINK等热门演出优先购票权,部分“买会员送门票”;4. 参与抽票活动需开…

    2026年8月31日
    100
  • 苹果15手机微信传文件到电脑打印完如何彻底删除

    手机端清除操作 启动iPhone 15上的微信应用,进入与电脑进行文件传输的对话页面。 长按已发送或接收的文件,在弹出的选项中选择“删除”功能。此操作可有效移除该文件在手机本地的存储副本。 电脑端清理步骤 定位通过微信接收到的文件存储路径,通常位于微信默认的文件接收目录中。 选中已完成打印任务的文件…

    2026年8月31日
    100
  • 高德导航如何下载安装_高德导航下载安装的详细步骤

    首先需下载安装高德地图才能使用导航功能。通过App Store搜索“高德地图”,确认开发者后点击获取安装;或通过豌豆荚等平台下载官方APK,开启未知来源权限后安装;还可扫描官网二维码快速下载安装。 如果您尝试在手机上使用高德地图导航,但尚未安装该应用,则无法正常使用路线规划与语音导航功能。以下是完成…

    2026年8月31日
    000
  • ​​微信文件传输失败?解决文件发送问题​​

    微信文件传不出去时,首先检查网络连接是否稳定,尝试切换wi-fi或数据流量;2. 重启微信应用,彻底关闭后重新打开以清除临时错误;3. 清理微信缓存,进入“设置-通用-存储空间”进行缓存清理;4. 更新微信至最新版本,避免因旧版本bug导致传输失败;5. 检查文件是否损坏或格式异常,尝试发送其他文件…

    2026年8月31日
    200
  • 微信小程序在华为鸿蒙4.0系统上定位失败是什么原因?

    微信小程序在华为鸿蒙4.0系统上的定位异常问题分析 部分开发者反映,其微信小程序在华为鸿蒙4.0系统上出现定位功能异常:定位成功率低,甚至无法启动定位。然而,在iOS系统上运行正常。本文将对此问题进行分析,并提供解决方案。 开发者提供的代码使用了uni.getLocation()方法进行定位,该方法…

    2026年8月31日
    100
  • 鸿蒙微信新版上线,负责人:目标对齐甚至超越iOS

    近日,鸿蒙微信手机版迎来了重要的功能更新。鸿蒙微信基础功能负责人anqi在接受采访时明确表示:“我们的终极目标是将鸿蒙微信做到与安卓、ios对齐,甚至最终超越ios。” 此次新版聚焦于社交体验的升级,重点完善了多项实用功能:群管理功能得到了优化,支持批量操作和自定义表情;用户可个性化设置“拍一拍”文…

    2026年8月31日
    000
  • 茶叶视频号如何运营推广?运营推广好做吗?

    随着短视频平台的迅猛发展,视频号逐渐成为茶企推广品牌、传播茶文化的重要渠道。通过清晰定位、高质量内容输出、有效互动及精准推广,茶叶类视频号不仅能扩大影响力,还能实现良好的销售转化。那么,具体该如何进行茶叶视频号的运营与推广呢? 一、茶叶视频号怎么运营和推广? 确定账号方向 茶叶视频号应聚焦特定细分领…

    2026年8月31日
    000
  • 微信怎么把手机里的视频发到朋友圈 微信通过“笔记”功能发布长视频

    可通过微信“笔记”功能发布最长60秒的视频,先将视频压缩为1080p/30fps内MP4格式,再从收藏中创建笔记插入视频并分享至朋友圈,以卡片形式展示突破30秒限制。 如果您想在微信朋友圈分享手机中的视频,但受限于时长或画质压缩问题,可以通过微信内置的“笔记”功能来发布更长时间的视频内容。以下是具体…

    2026年8月31日
    400
  • 王者荣耀假胜率曝光真相

    王者荣耀假胜率曝光真相王者荣耀假胜率曝光真相王者荣耀假胜率曝光真相王者荣耀假胜率曝光真相

    王者荣耀胜率造假如何操作?不了解的玩家可参考此方法,看是否对你有帮助。 1、 在微信或QQ中输入并发送与战绩相同的内容。 2、 将编辑好的文字复制到剪贴板。 3、 进入游戏后,将内容粘贴至发言栏。 4、 点击发送即可完成操作。 table{ border-collapse:collapse;/*表格…

    2026年8月31日 用户投稿
    700
  • Listen1怎么分享播放列表_Listen1分享播放列表的多种方法

    可通过生成链接、导出文件、二维码或第三方账号同步分享Listen1播放列表。一、在播放列表点击更多选项,选择“生成分享链接”,复制链接通过社交软件发送;二、点击“导出”保存为JSON或M3U文件,通过云盘或U盘传输;三、使用“生成二维码”功能,对方扫码即可导入;四、绑定网易云、QQ音乐等账户,将列表…

    2026年8月30日
    100
  • 微信小程序首页闪烁刷新:如何排查并解决随机出现的页面闪烁问题?

    微信小程序首页闪烁:排查与修复指南 微信小程序开发中,首页随机闪烁刷新(如同反复按F5)是个令人头疼的问题。它并非总是出现,难以复现,严重影响用户体验。单纯的数据定时刷新(例如,每秒执行this.onload())无法重现此问题,因为这只会刷新数据,而并非整个页面。 页面闪烁的根源可能在于小程序框架…

    2026年8月30日
    100
  • 小红书被私信禁言怎么办?被私信禁言有什么影响?

    作为广受用户喜爱的社交平台,小红书的私信功能在日常互动中扮演着重要角色。一旦遭遇私信禁言,不仅会阻碍正常沟通,还可能影响合作进展与粉丝维护。 一、遇到小红书私信禁言该如何应对? 查明具体原因 账号被禁言后,系统通常会推送通知,说明违规类型。常见的触发因素包括发布广告信息、频繁骚扰他人、传播敏感内容等…

    2026年8月30日
    200
  • deepseek创始人是谁

    DeepSeeK的创始人梁文锋是人工智能领域的专家,拥有量化投资和机器学习技术背景。梁文锋于2002年考入浙江大学,2010年获硕士学位。在校期间,他带领团队使用机器学习进行量化交易。2013年,梁文锋与同学创立杭州幻方科技,专注于量化投资。2023年,梁文锋正式进军通用人工智能领域,创办了Deep…

    2026年8月30日
    100
  • Listen1如何分享歌曲_Listen1分享歌曲的多种方式介绍

    可通过应用内分享、复制链接、生成二维码或绑定第三方平台实现分享。首先在播放页点击分享按钮,选择社交软件发送;其次复制歌曲链接并粘贴至目标窗口,附带信息便于识别;再者生成二维码供他人扫码获取;最后通过绑定网易云、QQ音乐等账号同步歌单,间接完成分享。 如果您想将喜欢的音乐通过Listen1分享给朋友或…

    2026年8月30日
    000
  • 微信公众号开发签名错误:如何排查并解决“签名错误”问题?

    微信公众号开发:签名错误排查与解决方案 微信公众号开发中,“签名错误”是常见问题。本文通过一个案例,详解排查及解决方法。 问题现象: 开发者调用微信接口,收到看似乱码的响应(例如:asdadascasdascascasd)。这并非真实响应,而是编码错误导致。 问题分析: 实际响应为XML格式:。微信…

    2026年8月30日
    100
  • 美团外卖新人红包领取入口_美团新人红包快速领取方法

    首先确认新用户身份并登录美团APP,接着在首页“新人专享”区领取大额红包;或扫描官方二维码跳转领取;也可通过外卖频道参与“神抢手”“膨胀红包”活动获取;最后可输入“新人大红包”等口令搜索并领取特定优惠。 如果您是美团外卖的新用户,但在APP中找不到新人红包的领取入口,可能是因为活动位置不明显或未完成…

    2026年8月30日
    100
  • 贝壳找房App怎么开通专属购房顾问服务_贝壳找房购房顾问开通

    贝壳找房无需单独开通专属顾问,首次咨询时系统会自动匹配。打开App进入【我的】页面查看【专属服务】可找到已有顾问;若无,可通过搜索小区并点击【联系经纪人】由系统推荐新顾问。建议添加企业微信、明确购房需求,并结合VR看房等功能提升服务体验。 贝壳找房App上没有直接“开通”专属购房顾问服务的按钮,但你…

    2026年8月30日
    100
  • 微信小程序离线表单提交:如何实现即使在无网络状态下也能提交表单?

    微信小程序离线表单:无网络也能提交 许多开发者都希望微信小程序具备离线功能,尤其在需要用户持续填写信息的场景,例如表单提交。本文将详细介绍如何在网络状况不佳或离线情况下,实现微信小程序表单的填写和提交。 核心问题在于:小程序能否在离线状态下工作并保存用户数据?答案是肯定的。本文将提供一个完整示例,包…

    2026年8月30日
    000
  • 视频号视频怎么分组?分组功能在哪?

    随着视频号内容不断增多,如何按主题进行归类整理,以便自己和粉丝更方便地浏览?其实,微信视频号提供了“合集”功能,能够轻松实现视频的分类与分组。本文将详细讲解如何创建和管理视频合集,助你打造清晰有序的主页布局。 一、如何对视频号视频进行分组? 视频号中的“分组”功能,官方称为“合集”。通过该功能,你可…

    2026年8月30日
    300
  • win10怎么解决麦克风权限问题_win10麦克风应用权限问题解决方法

    首先检查系统麦克风总权限是否开启,依次进入设置→隐私→麦克风,打开“允许此设备上的应用访问麦克风”;接着在相同页面确保“允许应用访问你的麦克风”开关已开,并为具体应用(如微信、Teams)单独开启权限;然后向下找到并开启“允许桌面应用访问你的麦克风”,以授权QQ、钉钉等传统程序使用麦克风;若麦克风集…

    2026年8月30日
    100

发表回复

登录后才能评论
关注微信