Pandas中基于分组字段生成重置序列ID的实用教程

Pandas中基于分组字段生成重置序列ID的实用教程

本教程详细介绍了如何在pandas dataframe中,根据指定的分组字段(如城市),为每组数据生成一个独立的、从1开始递增的序列id。通过结合使用groupby.cumcount()函数和字符串操作,可以高效地构建出符合业务逻辑的复合id,确保序列计数在每个分组内自动重置,从而满足复杂的数据标识需求。

引言:理解分组内序列ID的需求

在数据处理和分析中,我们经常需要为数据记录生成唯一的标识符(ID)。这些ID有时是复合型的,由多个字段的信息组合而成。一个常见的需求是,ID的一部分包含某个分组字段的简写(例如,城市名称的前缀),另一部分则是该分组内部的序列号。关键在于,这个序列号必须在每个新分组开始时重新从1开始计数,而不是在整个数据集中全局递增。

例如,我们有一个包含城市(City)和姓名(Name)的DataFrame,期望生成的ID格式为 城市前缀-姓名前缀-分组内序列号。

原始数据示例:

   City       Name0  Paris       John1  Paris       Paul2  Paris     Pierre3  Paris      Paula4   Rome   Riccardo5   Rome  Jean-Paul6   Rome      Franc

期望的ID生成结果:

   City       Name         Id0  Paris       John  Par-Joh-11  Paris       Paul  Par-Pau-22  Paris     Pierre  Par-Pie-33  Paris      Paula  Par-Pau-44   Rome   Riccardo  Rom-Ric-15   Rome  Jean-Paul  Rom-Jea-26   Rome      Franc  Rom-Fra-3

如果仅仅使用全局索引或全局计数器,当城市从“Paris”变为“Rome”时,序列号会继续递增(例如“Rom-Ric-5”),这不符合我们的分组内重置计数的预期。

核心工具:GroupBy.cumcount()函数

Pandas库为解决这类问题提供了强大的工具,其中GroupBy.cumcount()函数是实现分组内序列号重置的关键。

GroupBy.cumcount()函数的作用是:对于通过groupby()方法创建的每个分组,它会为该分组内的每一行生成一个从0开始递增的累积计数。这意味着,当一个新分组开始时,计数器会自动重置为0。

这与groupby().size()或groupby().count()等聚合函数不同,后者会返回每个分组的聚合结果(如分组大小),而cumcount()则会为原始DataFrame的每一行返回一个对应其分组内顺序的计数。

实现步骤与示例代码

现在,我们将逐步演示如何利用GroupBy.cumcount()来生成符合要求的复合ID。

1. 准备示例数据

首先,创建一个Pandas DataFrame来模拟我们的场景:

import pandas as pddata = {    'City': ['Paris', 'Paris', 'Paris', 'Paris', 'Rome', 'Rome', 'Rome'],    'Name': ['John', 'Paul', 'Pierre', 'Paula', 'Riccardo', 'Jean-Paul', 'Franc']}df = pd.DataFrame(data)print("原始DataFrame:")print(df)

输出:

原始DataFrame:    City       Name0  Paris       John1  Paris       Paul2  Paris     Pierre3  Paris      Paula4   Rome   Riccardo5   Rome  Jean-Paul6   Rome      Franc

2. 错误示范:使用全局计数

如果直接使用DataFrame的索引作为序列号,或者生成一个全局递增的序列,ID的计数将不会在城市变化时重置:

# 错误示范:使用全局索引df['id_global'] = df.City.str[:3] + '-' + df.Name.str[:3] + '-' + df.index.astype(str)print("n使用全局索引生成的ID (错误示范):")print(df)

输出:

使用全局索引生成的ID (错误示范):    City       Name    id_global0  Paris       John    Par-Joh-01  Paris       Paul    Par-Pau-12  Paris     Pierre    Par-Pie-23  Paris      Paula    Par-Pau-34   Rome   Riccardo    Rom-Ric-45   Rome  Jean-Paul    Rom-Jea-56   Rome      Franc    Rom-Fra-6

可以看到,当城市从Paris变为Rome时,序列号从4开始,而不是我们期望的1。

3. 应用GroupBy.cumcount()生成分组内序列号
硅基智能 硅基智能

基于Web3.0的元宇宙,去中心化的互联网,高质量、沉浸式元宇宙直播平台,用数字化重新定义直播

硅基智能 62 查看详情 硅基智能

现在,我们使用groupby(‘City’).cumcount()来生成分组内序列号。

# 生成分组内累积计数df['city_sequence'] = df.groupby('City').cumcount()print("n应用groupby('City').cumcount()后的DataFrame:")print(df)

输出:

应用groupby('City').cumcount()后的DataFrame:    City       Name  city_sequence0  Paris       John              01  Paris       Paul              12  Paris     Pierre              23  Paris      Paula              34   Rome   Riccardo              05   Rome  Jean-Paul              16   Rome      Franc              2

可以看到,city_sequence列在“Paris”分组内从0递增到3,然后在“Rome”分组开始时重置为0,并再次递增。

4. 调整计数并转换为字符串

cumcount()默认从0开始计数。为了使其从1开始,我们需要对结果加上1。同时,为了将这个数字与字符串拼接,需要将其转换为字符串类型。

df['city_sequence_adjusted'] = df.groupby('City').cumcount().add(1).astype(str)print("n调整并转换为字符串后的分组内序列号:")print(df)

输出:

调整并转换为字符串后的分组内序列号:    City       Name  city_sequence  city_sequence_adjusted0  Paris       John              0                      11  Paris       Paul              1                      22  Paris     Pierre              2                      33  Paris      Paula              3                      44   Rome   Riccardo              0                      15   Rome  Jean-Paul              1                      26   Rome      Franc              2                      3

5. 构建最终的复合ID

最后,我们将城市前缀、姓名前缀和调整后的分组内序列号拼接起来,生成最终的ID。

df['Id'] = (df.City.str[:3] + '-' +             df.Name.str[:3] + '-' +             df.groupby('City').cumcount().add(1).astype(str))# 清理辅助列以展示最终结果df = df[['City', 'Name', 'Id']]print("n最终生成的ID:")print(df)

输出:

最终生成的ID:    City       Name         Id0  Paris       John  Par-Joh-11  Paris       Paul  Par-Pau-22  Paris     Pierre  Par-Pie-34   Rome   Riccardo  Rom-Ric-15   Rome  Jean-Paul  Rom-Jea-26   Rome      Franc  Rom-Fra-3

现在,Id列已经完全符合我们的预期,序列号在每个城市分组内都从1开始重置。

注意事项与扩展

多字段分组: 如果需要根据多个字段进行分组并重置序列,只需在groupby()中传入一个列名列表即可。例如:df.groupby([‘City’, ‘Country’]).cumcount()。

序列号格式化(零填充): 如果希望序列号具有固定长度,例如“01”、“02”而不是“1”、“2”,可以使用字符串的zfill()方法。

df['Id_padded'] = (df.City.str[:3] + '-' +                    df.Name.str[:3] + '-' +                    df.groupby('City').cumcount().add(1).astype(str).str.zfill(2))print("n带零填充的ID:")print(df[['City', 'Name', 'Id_padded']])

输出示例:

带零填充的ID:    City       Name  Id_padded0  Paris       John  Par-Joh-011  Paris       Paul  Par-Pau-022  Paris     Pierre  Par-Pie-033  Paris      Paula  Par-Pau-044   Rome   Riccardo  Rom-Ric-015   Rome  Jean-Paul  Rom-Jea-026   Rome      Franc  Rom-Fra-03

性能考量: 对于大型数据集,Pandas的groupby()操作通常是高度优化的,因此这种方法在处理性能方面表现良好。

总结

通过本教程,我们学习了如何利用Pandas的groupby().cumcount()函数来解决在DataFrame中生成分组内重置序列ID的问题。这个方法简洁高效,能够灵活应对各种需要根据特定分组逻辑生成唯一标识符的场景。掌握这一技巧,将有助于更有效地进行数据清洗、数据标识和特征工程。

以上就是Pandas中基于分组字段生成重置序列ID的实用教程的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/569864.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Windows文件共享设置_局域网共享文件夹教程
上一篇 2025年11月10日 05:32:30
soul怎么把souler推荐给好友_Soul好友推荐方法
下一篇 2025年11月10日 05:32:36

相关推荐

  • uc浏览器如何清除指定的网站数据_UC浏览器定点清除网站Cookie与缓存

    可针对特定网站清理缓存或Cookie解决UC浏览器访问异常。1、进入设置→隐私与安全→管理网站数据,搜索目标网站并清除其数据;2、使用无痕浏览模式访问网站,避免数据残留;3、通过文件管理器手动删除UC浏览器缓存目录下对应域名的缓存文件夹。 如果您在使用UC浏览器访问某些网站时遇到加载异常、登录状态失…

    2026年9月24日
    000
  • MAC系统怎么开启防火墙_MAC开启防火墙教程

    1、建议在Mac系统中开启防火墙以提升网络安全,可通过“系统设置”中的“网络-防火墙”选项启用;2、高级用户可使用终端命令sudo /usr/libexec/ApplicationFirewall/socketfilterfw –setglobalstate on开启服务;3、启用后可在…

    2026年9月24日
    100
  • APM开发阅读

    APM开发阅读APM开发阅读APM开发阅读APM开发阅读

    我阅读apm的源码有两个主要目的:一是学习,了解飞控系统和大型项目的组织结构;二是为了移植的需要,满足项目需求。近年来,少儿编程市场非常火热,许多厂商推出了相关的产品,但这些产品大多使用空心杯电机,导致动力不足,且扩展性有限。许多任务需要io或图像识别的支持。 因此,我在考虑使用APM裁剪版的飞控系…

    2026年9月24日 用户投稿
    1600
  • MySQL中SQL注入防范 SQL注入攻击的预防与应对措施

    sql注入的防范核心在于参数化查询。具体措施包括:1.始终使用参数化查询,将用户输入视为数据而非可执行代码;2.对输入进行过滤与校验,如验证格式、转义特殊字符;3.遵循最小权限原则,限制数据库账号权限;4.控制错误信息输出,避免暴露敏感细节;5.定期更新框架与插件,及时修补漏洞。这些方法结合使用能有…

    2026年9月24日
    000
  • 如何在Linux中切换用户身份?

    Linux中切换用户主要用su和sudo命令;2. su切换用户需密码,su -可加载完整环境;3. sudo允许授权用户以root等身份执行命令而无需对方密码;4. 推荐使用sudo -i或sudo su -切换到root;5. 普通用户需加入sudo组或配置/etc/sudoers文件;6. 编…

    2026年9月24日
    100
  • VSCode的扩展设置是全局的还是局部的?

    VSCode扩展设置默认全局生效,存储于用户配置文件中,但部分扩展如ESLint、Prettier和Python支持项目级局部配置,通过在项目根目录的.vscode/settings.json文件中定义,可覆盖全局设置;在设置界面中,齿轮图标表示可被工作区覆盖,锁图标表示仅限全局修改,用户可根据需求…

    2026年9月24日
    200
  • PHP如何批量处理图片_PHP实现多张图片自动化处理

    批量处理图片时需循环读取并逐个处理,核心是使用scandir()获取文件列表,通过GD库或Imagick处理图像,每处理完一张用imagedestroy()释放内存以避免内存溢出;为提升效率可分批处理、优化算法、使用多进程或异步队列,并选用Intervention Image等高效第三方库。 批量处…

    2026年9月24日
    100
  • MySQL怎样处理SQL注入风险 参数化查询与特殊字符过滤方案

    MySQL怎样处理SQL注入风险 参数化查询与特殊字符过滤方案MySQL怎样处理SQL注入风险 参数化查询与特殊字符过滤方案MySQL怎样处理SQL注入风险 参数化查询与特殊字符过滤方案MySQL怎样处理SQL注入风险 参数化查询与特殊字符过滤方案

    参数化查询和特殊字符过滤是防止sql注入的有效方法。1. 参数化查询通过预处理语句将sql结构与数据分离,用户输入被视为参数,不会被解释为sql命令;2. 特殊字符过滤通过转义或拒绝单引号、双引号等危险字符来阻止攻击;3. 定期审查mysql安全配置,包括更新版本、限制权限、启用日志、使用防火墙和扫…

    2026年9月24日 用户投稿
    000
  • win8如何禁用usb端口_Win8 USB端口禁用教程

    1、通过组策略禁用USB存储:使用gpedit.msc进入可移动存储访问,启用“拒绝所有权限”并重启生效;2、修改注册表阻止驱动加载:将USBSTOR下的Start值设为4以禁用U盘等设备;3、设备管理器中手动禁用USB根集线器:逐一右键禁用各USB Root Hub实现端口封锁。 如果您希望在Wi…

    2026年9月24日
    300
  • 如何查找大文件 find命令按大小搜索技巧

    如何查找大文件 find命令按大小搜索技巧如何查找大文件 find命令按大小搜索技巧如何查找大文件 find命令按大小搜索技巧如何查找大文件 find命令按大小搜索技巧

    要在linux中查找大文件,首先使用find命令配合-size参数定位指定大小以上的文件,例如:find /path/to/search -type f -size +5m。其次结合-exec和du、sort等命令可对结果排序并显示详细信息。最后也可用du与sort组合快速列出最大文件,或安装ncd…

    2026年9月24日 用户投稿
    1600
  • win10开机后黑屏只有鼠标怎么办_win10黑屏无桌面修复方案

    首先重启Windows资源管理器,若无效则更新显卡驱动,进入安全模式禁用启动项与服务,运行sfc和DISM修复系统文件,并检查User Profile Service等关键服务状态。 如果您成功启动Windows 10系统,但桌面无法正常加载,仅显示黑色屏幕和可移动的鼠标光标,这通常是由于系统关键进…

    2026年9月24日
    600
  • 讯维解决KVM鼠标不同步

    讯维解决KVM鼠标不同步讯维解决KVM鼠标不同步讯维解决KVM鼠标不同步讯维解决KVM鼠标不同步

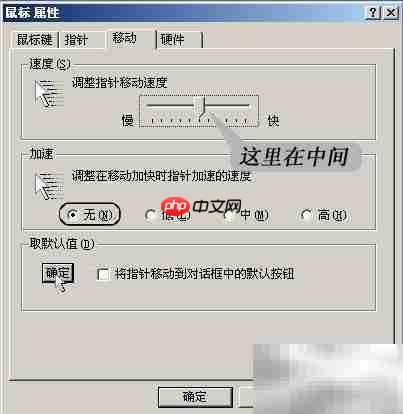
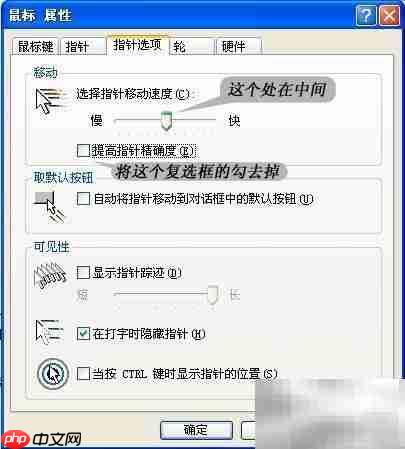
    使用网络kvm时,常遇到本地鼠标与远程界面光标位置不一致的问题,即鼠标不同步现象,严重影响操作流畅性。可通过优化鼠标同步设置、更新驱动程序或选用兼容性更强的设备来有效改善。 1、配置运行Windows 2000操作系统的服务器环境 2、调整鼠标相关参数 3、点击开始菜单,进入控制面板,选择“鼠标”进…

    2026年9月24日 用户投稿
    900
  • 三星手机微信收款语音播报怎么开启?详细教程助你设置成功

    要让三星手机微信收款语音播报正常工作,需先检查微信内“收款到账语音提醒”是否开启,再确保手机系统中微信的通知权限完整开启、电池优化设为“不受限制”,同时确认媒体音量未静音、勿扰模式未启用;此外,定期清理缓存、保持应用与系统更新、避免第三方清理软件误杀后台,可保障通知长期稳定。 三星手机要开启微信收款…

    2026年9月24日
    300
  • 俄罗斯搜索引擎入口 俄罗斯Yandex浏览器官网在线进入

    俄罗斯搜索引擎Yandex的官网入口是https://yandex.com/,该平台提供多语言搜索、地图、新闻聚合和翻译工具,其浏览器以轻量、快速、广告过滤和高兼容性为优势,搜索支持多类型内容精准查找与安全防护。 俄罗斯搜索引擎入口在哪里?这是不少网友都关注的,接下来由PHP小编为大家带来俄罗斯Ya…

    2026年9月24日
    200
  • 如何监控Linux命令执行时间 time命令性能分析技巧

    如何监控Linux命令执行时间 time命令性能分析技巧如何监控Linux命令执行时间 time命令性能分析技巧如何监控Linux命令执行时间 time命令性能分析技巧如何监控Linux命令执行时间 time命令性能分析技巧

    要查看linux命令执行耗时及分析程序性能,可使用time命令。1. time命令基础用法:在命令前加time,输出包含real(实际时间)、user(用户态时间)、sys(内核态时间),用于初步判断性能瓶颈。2. 精确计时:使用/usr/bin/time获取更详细信息,如内存使用、上下文切换、退出…

    2026年9月24日 用户投稿
    800
  • 抖音水印怎么去掉?抖音水印在哪里关闭

    随着抖音的广泛使用,越来越多的人选择在这个平台上分享生活点滴。然而,在保存或转发视频时,常常会遇到水印问题,这不仅影响了视频的整体观感,也可能带来隐私风险。本文将为您详细讲解几种去除抖音视频水印的方法,帮助您轻松还原视频原本面貌。 一、常见的去水印方式 借助第三方工具软件 目前市面上有不少专门用于去…

    2026年9月24日
    600
  • 2025最新Yandex俄罗斯官网 Yandex免注册版官方入口地址

    2025最新Yandex俄罗斯官网免注册入口为https://yandex.ru/,该平台提供深度优化俄语搜索、实时导航、多语言翻译、新闻聚合,并涵盖地图、云存储、语音助手及教育等特色服务,支持极简界面与隐私保护模式。 1、立即进入“☞☞☞☞点击俄罗斯yandex搜索引擎入口☜☜☜☜”; 2、立即进…

    2026年9月24日
    300
  • 如何分析Linux进程内存 pmap内存映射检查方法

    如何分析Linux进程内存 pmap内存映射检查方法如何分析Linux进程内存 pmap内存映射检查方法如何分析Linux进程内存 pmap内存映射检查方法如何分析Linux进程内存 pmap内存映射检查方法

    要分析linux进程的内存,特别是利用pmap工具,核心操作是获取目标进程pid后执行pmap -x 。1. 获取pid可通过ps aux | grep your_process_name;2. 执行pmap -x 命令查看扩展格式信息,包括address、kbytes、rss、dirty、mode…

    2026年9月24日 用户投稿
    200
  • 解决MySQL事件event定义中文乱码的方法

    mysql的event事件处理中文乱码问题主要由字符集设置不当引起,解决方法包括以下步骤:1. 统一数据库、表和字段的字符集为utf8mb4,创建或修改时显式指定字符集;2. 设置连接层字符集,在连接后执行set names ‘utf8mb4’或在程序连接参数中指定chars…

    2026年9月24日
    300
  • 如何实现Linux与Windows双系统引导管理?

    答案是先安装Windows再安装Linux,使用GRUB引导;需注意引导模式(UEFI/Legacy)与分区策略(ESP、/、swap、/home),并可通过Live USB修复GRUB。 实现Linux与Windows双系统引导管理,核心在于一个可靠的引导加载器,通常是Linux在安装时提供的GR…

    2026年9月24日
    300

发表回复

登录后才能评论
关注微信