Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
深度解析:8位量化对GPU上Whisper模型推理速度的影响及应用场景_创想鸟

深度解析:8位量化对GPU上Whisper模型推理速度的影响及应用场景

深度解析:8位量化对GPU上Whisper模型推理速度的影响及应用场景

8位量化技术旨在降低大型模型内存占用,使其能在有限硬件上运行,但通常会引入额外的计算开销,导致gpu推理速度下降。本文将深入探讨8位量化在hugging face transformers中对whisper模型推理性能的影响,解释其背后的机制,并提供实践代码示例及使用注意事项。

在深度学习领域,模型量化是一种常用的优化技术,旨在通过降低模型参数的数值精度来减少模型大小和计算需求。其中,8位(Int8)量化因其在内存节省方面的显著优势而广受欢迎,尤其是在部署大型模型如Whisper-large-v3时。然而,一个常见的误解是,量化必然会带来推理速度的提升。实际上,在某些场景下,特别是在使用bitsandbytes库进行8位量化时,模型推理速度反而可能下降。

8位量化:内存优化而非普适性速度提升

当我们在Hugging Face Transformers中使用load_in_8bit=True参数加载模型时,底层通常会利用bitsandbytes库实现8位量化。这项技术的核心目标是显著减少模型在GPU内存中的占用。例如,一个原本需要数十GB显存的模型,在8位量化后可能只需要几GB,这使得在显存有限的GPU(如NVIDIA T4)上运行大型模型成为可能。

然而,这种内存优化并非没有代价。为了在8位精度下进行计算,模型在执行前向传播时,需要将8位量度的权重动态地反量化(dequantize)回更高精度(通常是FP16或BF16),进行计算,然后再可能重新量化(requantize)结果。这些额外的反量化和重新量化操作本身就需要计算资源和时间。因此,虽然模型参数存储在更小的8位空间中,但实际的计算过程却引入了额外的开销,这可能导致推理速度的下降。

对于NVIDIA T4这类GPU,其Tensor Core虽然支持FP16和INT8混合精度计算,但bitsandbytes实现的8位量化主要侧重于内存效率。当这些额外的量化/反量化操作成为瓶颈时,即使GPU的原始计算能力(如nvidia-smi中显示的33%利用率)未被完全压榨,整体推理时间也会显著增加。这解释了为何Whisper-large-v3在8位模式下推理速度可能比非量化模式慢5倍的现象。

百度GBI 百度GBI

百度GBI-你的大模型商业分析助手

百度GBI 104 查看详情 百度GBI

实践代码示例

以下代码展示了如何在Hugging Face Transformers中加载Whisper-large-v3模型并进行8位量化推理。请注意,即使加载了8位模型,输入特征通常仍以浮点精度处理,并在模型内部进行必要的精度转换。

import torchfrom transformers import WhisperFeatureExtractor, WhisperTokenizerFast, AutoModelForSpeechSeq2Seqfrom transformers.pipelines.audio_classification import ffmpeg_readimport time # 引入time模块用于计时# 模型名称MODEL_NAME = "openai/whisper-large-v3"# 初始化特征提取器和分词器tokenizer = WhisperTokenizerFast.from_pretrained(MODEL_NAME)feature_extractor = WhisperFeatureExtractor.from_pretrained(MODEL_NAME)print("加载8位量化模型...")# 加载8位量化模型# device_map='auto' 会自动将模型分配到可用设备,load_in_8bit=True 启用8位量化model_8bit = AutoModelForSpeechSeq2Seq.from_pretrained(    MODEL_NAME,    device_map='auto',    load_in_8bit=True)print("8位量化模型加载完成。")# 示例音频文件路径 (请替换为您的实际文件)sample_file = "sample.mp3" # 假设这是一个27秒长的音频文件print(f"开始对文件 '{sample_file}' 进行推理...")with torch.inference_mode(): # 禁用梯度计算,节省内存并加速推理    with open(sample_file, "rb") as f:        inputs_bytes = f.read()        # 使用ffmpeg_read读取音频数据并重采样        audio_data = ffmpeg_read(inputs_bytes, feature_extractor.sampling_rate)        # 提取音频特征        input_features = feature_extractor(            audio_data,            sampling_rate=feature_extractor.sampling_rate,            return_tensors='pt'        )['input_features']        # 将输入特征移动到GPU并转换为float16精度        # 注意:即使模型是8位,输入特征通常仍以更高精度处理        input_features = input_features.to(dtype=torch.float16, device='cuda')        start_time = time.time() # 记录推理开始时间        # 进行模型推理        forced_decoder_ids_output = model_8bit.generate(            input_features=input_features,            return_timestamps=False # 根据需求设置是否返回时间戳        )        end_time = time.time() # 记录推理结束时间        inference_time = end_time - start_time        print(f"推理完成,耗时: {inference_time:.2f} 秒")        # 解码输出        out_text = tokenizer.decode(forced_decoder_ids_output.squeeze())        print("识别结果:", out_text)

注意事项与最佳实践

明确量化目的: 使用8位量化的主要目的是降低内存占用,以在资源受限的环境中运行更大的模型。如果您的首要目标是推理速度,并且显存充足,那么全精度(FP32)或半精度(FP16/BF16)可能提供更好的性能。性能权衡: 8位量化通常涉及速度与内存之间的权衡。在评估是否使用8位量化时,务必进行全面的基准测试,比较不同精度下的推理速度和内存消耗。硬件兼容性: 不同的GPU架构对量化操作的支持程度不同。较新的GPU可能拥有更优化的INT8计算单元,但在某些旧型号或特定配置下,量化带来的额外开销可能更为明显。量化方案选择: bitsandbytes是一种流行的动态8位量化方案,主要侧重于内存优化。除了它,还有其他量化方法,例如PyTorch原生支持的静态量化或动态量化,它们可能提供不同的性能特征,有些可能更注重速度提升。精度损失: 8位量化可能会导致轻微的精度损失。对于某些对精度要求极高的任务,需要仔细评估量化对模型性能的影响。GPU利用率: 如果GPU利用率较低,但推理时间较长,这通常表明瓶颈不在于原始计算能力,而在于数据传输、内存访问或量化/反量化等辅助操作。

总结

8位量化,尤其是通过bitsandbytes实现的方案,是解决大型模型显存瓶颈的有效手段。它允许开发者在有限的硬件资源上部署和运行更复杂的模型,从而拓宽了应用场景。然而,我们必须认识到,这种内存优化通常伴随着额外的计算开销,可能导致推理速度的下降。因此,在决定是否采用8位量化时,应根据具体的应用需求、硬件条件和性能目标,进行全面的考量和基准测试。理解其背后的机制和权衡,是有效利用这项技术的关键。

以上就是深度解析:8位量化对GPU上Whisper模型推理速度的影响及应用场景的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/590897.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
光遇5月24日季节蜡烛在哪儿-5月24日季节蜡烛位置一览
上一篇 2025年11月10日 15:52:54
电脑蓝屏并显示错误代码0xc000007b无法启动怎么解决?
下一篇 2025年11月10日 15:52:57

相关推荐

  • mac怎么使用听写功能_mac听写输入开启方法

    首先启用高级听写功能,进入系统设置→键盘→听写,勾选“使用高级听写”并下载语言包;随后可设置快捷键(如双击Fn键)快速启动语音输入;在支持的应用中也可通过菜单栏“编辑→开始听写”直接调用;最后根据需要配置听写语言、自动纠正及连续听写选项以提升识别准确率。 如果您希望在Mac上通过语音输入文字以提高效…

    2026年9月24日
    200
  • 使用MySQL命令行客户端进行交互式管理

    使用MySQL命令行客户端进行交互式管理使用MySQL命令行客户端进行交互式管理使用MySQL命令行客户端进行交互式管理使用MySQL命令行客户端进行交互式管理

    mysql命令行客户端的常用命令包括:1. 使用mysql -u 用户名 -p命令连接数据库;2. 执行show databases;查看所有数据库;3. 使用use 数据库名;选择数据库;4. 使用select * from 表名;查询数据;5. 使用insert into 表名 (列1, 列2)…

    2026年9月24日 • 用户投稿
    500
  • 赋能AI未来!康盈半导体 AI 应用存储新品登陆 elexcon 2025 展会

    赋能AI未来!康盈半导体 AI 应用存储新品登陆 elexcon 2025 展会赋能AI未来!康盈半导体 AI 应用存储新品登陆 elexcon 2025 展会赋能AI未来!康盈半导体 AI 应用存储新品登陆 elexcon 2025 展会赋能AI未来!康盈半导体 AI 应用存储新品登陆 elexcon 2025 展会

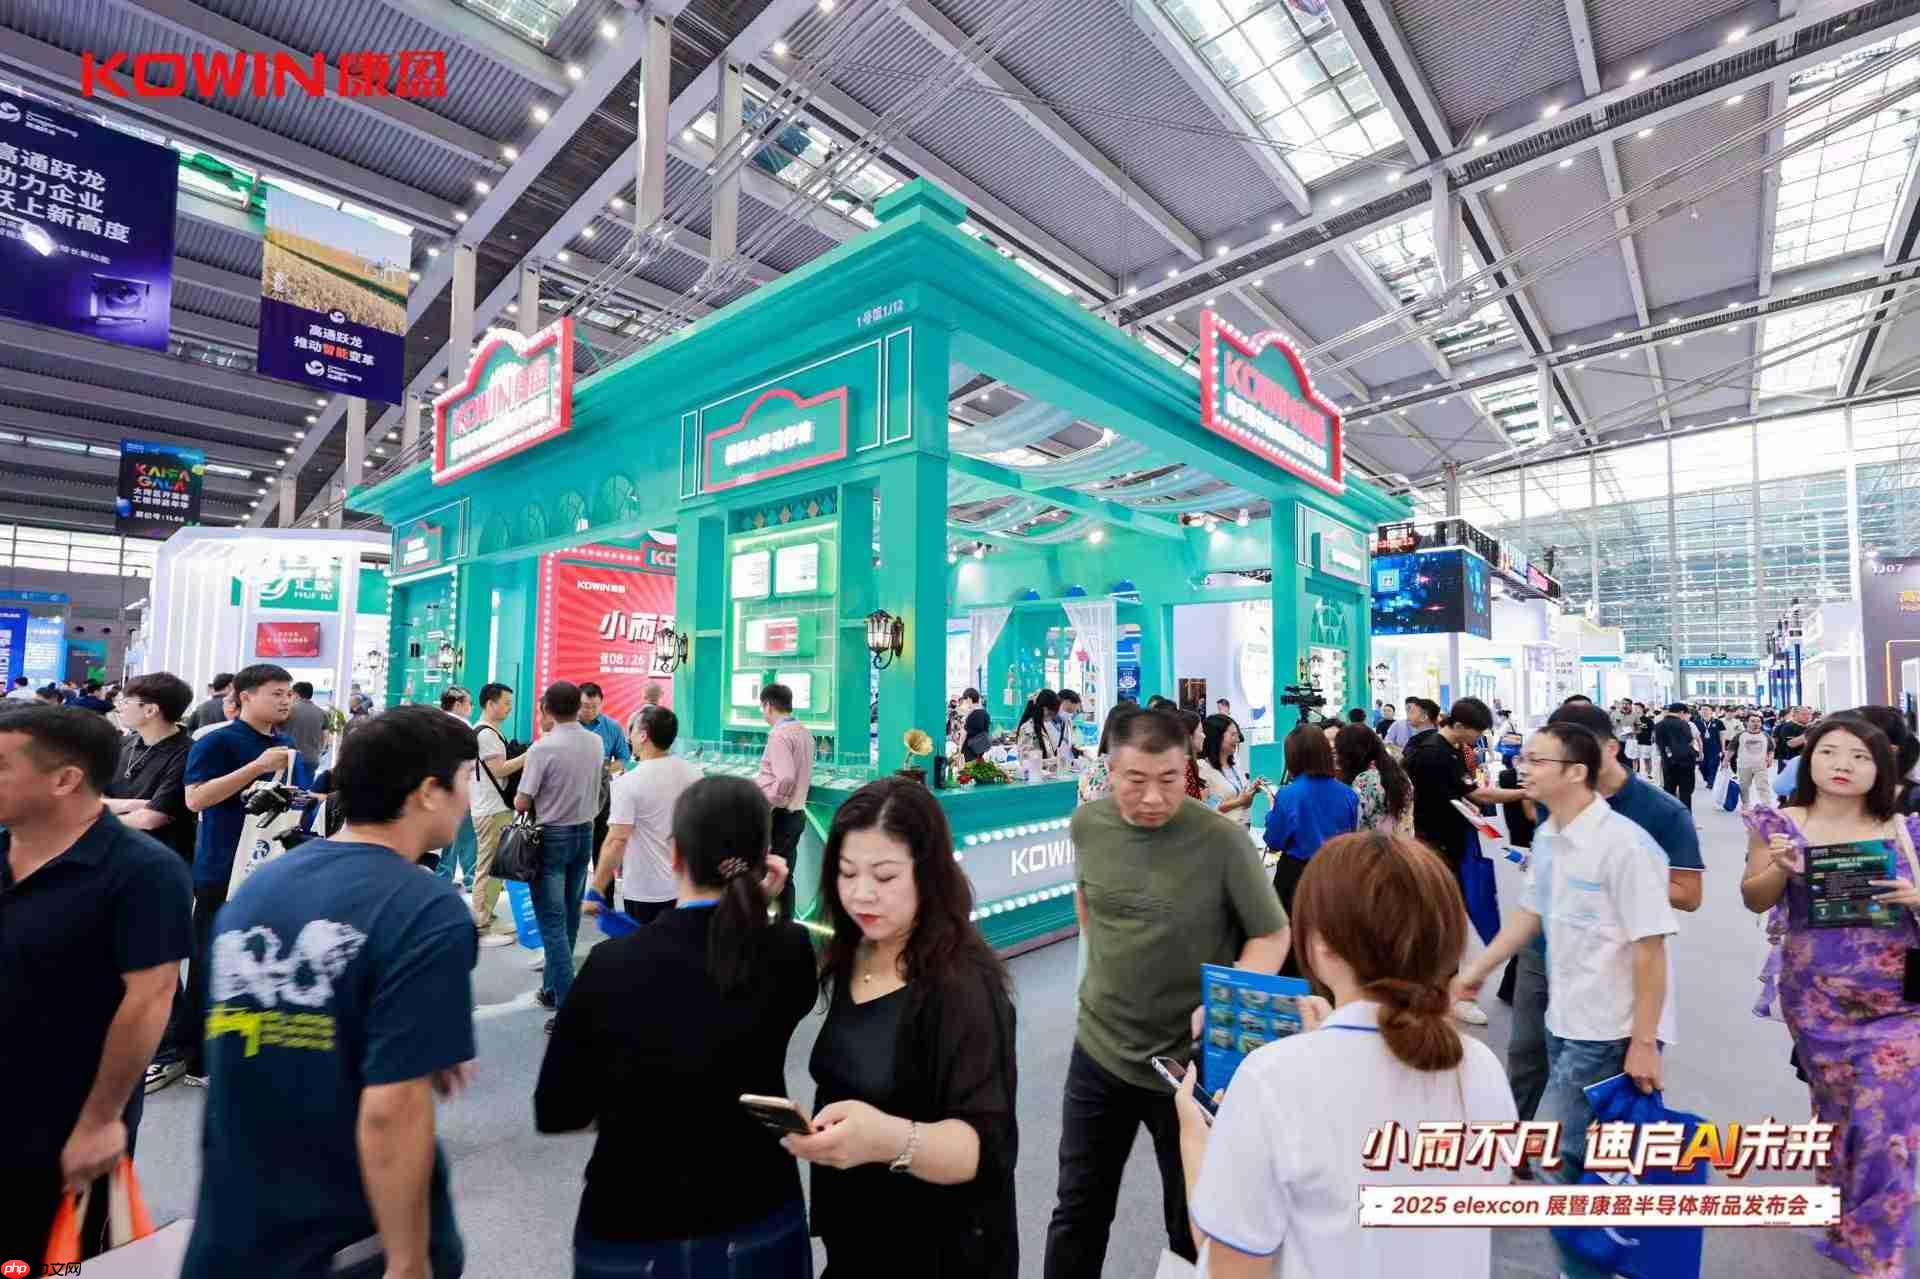
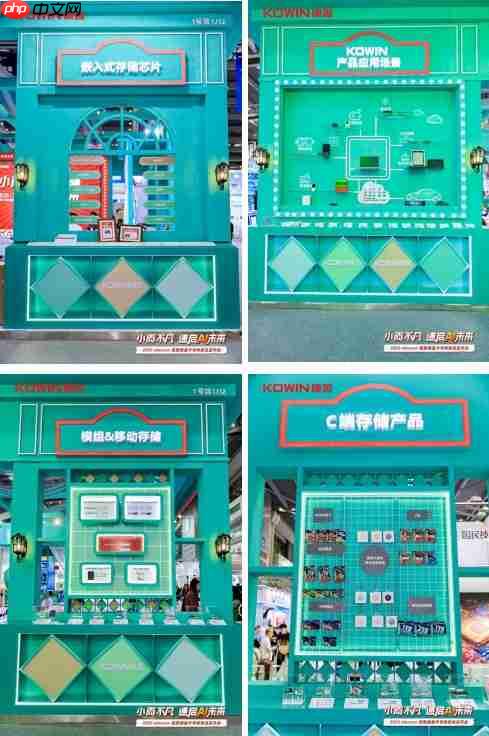
    8 月 26 日,中国电子、嵌入式及半导体先进封测行业的风向标 ——elexcon2025 深圳国际电子展暨嵌入式展盛大开幕。作为本届展会的重磅环节之一,国产存储领军品牌康盈半导体携新而来,以 “小而不凡,速启 ai 未来” 为核心主题,正式发布 2025 年存储新品,同步拉开面向 ai 终端应用的…

    2026年9月24日 • 用户投稿
    000
  • Java中固定长度用户ID输入验证:解决int类型长度检查问题

    本文详细介绍了在Java程序中如何实现用户输入固定长度ID的验证机制。针对常见的int cannot be dereferenced错误,我们将探讨将ID作为字符串读取并进行长度及格式校验的最佳实践,并提供处理字母数字型和纯数字型ID的示例代码,确保数据输入的准确性和程序的健壮性。 引言:用户输入验…

    2026年9月24日
    500
  • 数据实时迁移同步工具 CloudCanal v5.2.0.0 发布,支持 SaaS 全托管

    cloudcanal 免费社区版 是 clougence 公司推出的一款全自研、可视化、自动化数据迁移同步工具,具备 结构迁移、数据迁移、数据同步、数据校验、数据订正 等功能,支持 60+ 款流行关系型数据库、实时数仓、消息中间件、缓存数据库和搜索引擎之间数据互通,其中包含国产数据库 oceanba…

    2026年9月24日
    000
  • VSCode如何实现AI代码反混淆 VSCode智能分析混淆代码的技巧

    vscode没有一键ai反混淆功能,但可通过智能扩展、调试器、ast查看器、代码格式化工具及外部ai工具集成来辅助分析和逐步还原混淆代码;2. 利用eslint、prettier等扩展提升代码可读性,通过“重命名符号”“转到定义”“查找引用”等功能追踪变量和函数流向,结合多光标编辑和代码片段进行手动…

    2026年9月24日
    100
  • Laravel 表单验证失败后保留输入值:最佳实践教程

    本文旨在帮助 Laravel 开发者解决表单验证失败后,如何保留用户已输入数据的问题。我们将深入探讨 withInput() 方法的使用,并提供清晰的代码示例,确保即使在验证失败的情况下,用户体验也能保持流畅。通过本文的学习,你将掌握在 Laravel 中优雅地处理表单验证,并提升应用的可用性。 在…

    2026年9月24日
    000
  • 怎么在mysql中创建数据库表 mysql建表完整流程解析

    在 mysql 中创建数据库表的步骤包括:1) 选择合适的数据类型,如 int、varchar、timestamp;2) 设置索引,如主键和唯一索引;3) 应用约束条件,如 not null 和 unique;4) 设计表结构以满足业务需求,如使用 foreign key 和 enum;5) 优化性…

    2026年9月24日
    000
  • 生成Java中全范围正Double随机数的正确方法

    本文旨在指导开发者如何在Java中生成覆盖整个正Double范围的随机数,并解释了使用ThreadLocalRandom.nextDouble(Double.MIN_VALUE, Double.MAX_VALUE)可能产生偏差的原因。我们将提供一种基于位操作的替代方案,确保生成的随机数在Double…

    2026年9月24日
    100
  • PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验

    PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验

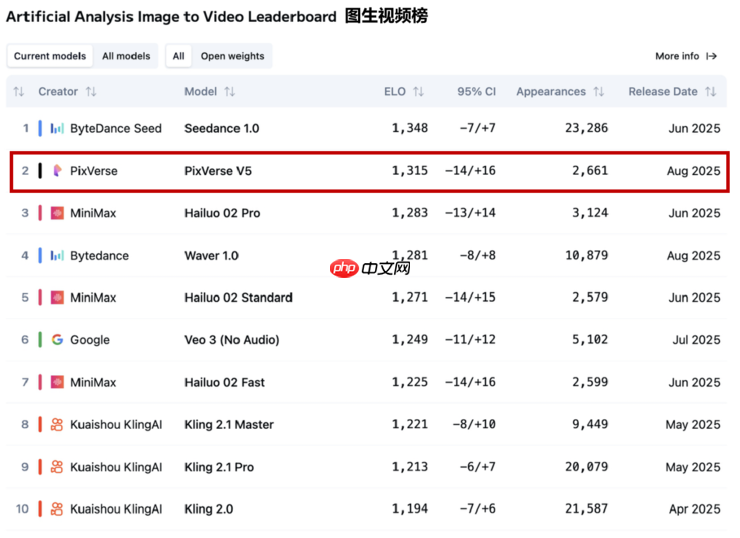
    8月27日晚,根据权威独立测评平台 artificial analysis 最新测试结果,爱诗科技发布的pixverse v5 新一代自研视频生成大模型,在图生视频(image to video)项目中排名全球 top2,在文生视频(text to video)项目中位列 top3,保持在全球第一梯…

    2026年9月24日 • 用户投稿
    100
  • hive安装配置实验

    一、安装前的准备工作 1. 配置并安装hadoop,请参考链接http://blog.csdn.net/wzy0623/article/details/50681554。 2. 下载以下安装包:mysql-5.7.10-linux-glibc2.5-x86_64.tar.gz、apache-hive…

    2026年9月24日
    600
  • 大学论文怎么写?让AI工具助你一臂之力

    大学论文怎么写?让AI工具助你一臂之力大学论文怎么写?让AI工具助你一臂之力大学论文怎么写?让AI工具助你一臂之力大学论文怎么写?让AI工具助你一臂之力

    如果要选出大学学习过程中最令人头疼的事,写论文无疑能稳居榜首。从选题开题、内容撰写,到翻译润色、查重降重,每个步骤都耗时耗力,让人焦头烂额。然而,随着 ai 技术的发展,如今写论文这件事,已经可以借助智能工具变得更高效、更轻松。 开题太难?AI 来帮你破局! 论文的第一道难关就是开题。面对浩如烟海的…

    2026年9月24日 • 用户投稿
    100
  • 使用 PHP 解析 JSON 文件并在网页上显示特定数据

    本文旨在帮助开发者学习如何使用 PHP 解析 JSON 文件,并提取其中的特定数据,将其以结构化的方式展示在网页上。我们将通过一个简单的示例,演示如何读取 JSON 数据,解析成 PHP 数组,并最终以 HTML 表格的形式呈现。 PHP 解析 JSON 数据 JSON (JavaScript Ob…

    2026年9月24日
    100
  • OriginOS 6 深度体验:当操作系统回归「体验为王」

    OriginOS 6 深度体验:当操作系统回归「体验为王」OriginOS 6 深度体验:当操作系统回归「体验为王」OriginOS 6 深度体验:当操作系统回归「体验为王」OriginOS 6 深度体验:当操作系统回归「体验为王」

    2020 年,智能手机刚刚进入 5g 普及阶段,手机的硬件与软件都迎来了一次迭代浪潮——新形态的需求对操作系统的设计与交互都提出了诸多新的问题,originos 的首个版本,可以看作 vivo对这些问题的回答。 彼时,我曾有机会与 OriginOS 开发团队沟通,正如 OriginOS 的中文名原 …

    2026年9月24日 • 用户投稿
    100
  • 如何在PHP的require语句中传递参数并有效管理变量作用域

    本文探讨了在php中使用`require`或`include`语句时如何向被引入文件传递参数。文章详细阐述了通过直接变量作用域共享、利用`$_get`超全局变量(不推荐)以及将引入文件内容封装为函数或类(推荐最佳实践)这三种方法,并提供了相应的代码示例,旨在帮助开发者理解和选择最适合其场景的参数传递…

    2026年9月24日
    000
  • DeepArt的AI混合工具怎么操作?快速生成艺术风格图像的方法

    使用DeepArt类工具时,先选匹配的风格图与内容图,调节风格强度避免失真,推荐尝试Artbreeder、RunwayML、NightCafe等多元平台以提升创作效果。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ DeepArt的AI混合…

    2026年9月24日
    000
  • 如何用COUNT函数统计行数?处理NULL值时SUM/AVG函数的注意事项

    如何用COUNT函数统计行数?处理NULL值时SUM/AVG函数的注意事项如何用COUNT函数统计行数?处理NULL值时SUM/AVG函数的注意事项如何用COUNT函数统计行数?处理NULL值时SUM/AVG函数的注意事项如何用COUNT函数统计行数?处理NULL值时SUM/AVG函数的注意事项

    count函数统计行数时需注意使用方式,count(*)统计所有行包括null值,count(column_name)仅统计非null值。sum和avg函数均忽略null值,可能导致计算偏差,可通过coalesce或case语句处理。明确需求后选择合适方法,并注意数据类型与测试验证以避免错误。 CO…

    2026年9月24日 • 用户投稿
    000
  • Pages如何协作修改文档 Pages跟踪修改和建议的用法

    使用Pages的协作与修订功能可高效编辑文档,先启用共享邀请协作者,再通过建议模式提出修改,所有更改以标记形式显示,经审查后接受或拒绝,最终关闭修订模式保存定稿。 如果您正在与团队成员共同编辑一份文档,但希望保留原始内容并记录所有更改建议,可以使用 Pages 的协作与修订功能来实现高效沟通。通过这…

    2026年9月24日
    100
  • Polarr的AI工具怎么裁剪图片?教你轻松实现高效图像裁剪

    Polarr的AI工具怎么裁剪图片?教你轻松实现高效图像裁剪Polarr的AI工具怎么裁剪图片?教你轻松实现高效图像裁剪Polarr的AI工具怎么裁剪图片?教你轻松实现高效图像裁剪Polarr的AI工具怎么裁剪图片?教你轻松实现高效图像裁剪

    Polarr的AI裁剪通过内容感知智能识别主体与构图焦点,提供如主体居中、构图优化和比例推荐等方案,操作上先导入图片,选择裁剪工具后AI即分析画面并生成多个推荐预设,用户可直接应用或手动微调,相比传统裁剪显著提升效率、辅助构图决策,尤其适用于社交媒体多平台比例适配,帮助保持视觉一致性并避免关键信息被…

    2026年9月24日 • 用户投稿
    600
  • qq浏览器怎么看3d网页效果_QQ浏览器体验WebGL 3D网页效果指南

    首先启用QQ浏览器的高速渲染组件并确保其已安装开启,然后将页面切换至极速模式以支持WebGL,接着更新显卡驱动以保障图形渲染正常,最后清除浏览器缓存与重置设置排除故障,按此步骤可解决3D网页黑屏、白屏问题。 如果您尝试在QQ浏览器中查看3D网页效果,但页面无法正常显示或出现黑屏、白屏,可能是由于浏览…

    2026年9月24日
    100

发表回复

登录后才能评论
关注微信