Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
Python Kafka流连接:策略、工具与实践_创想鸟

Python Kafka流连接:策略、工具与实践

Python Kafka流连接:策略、工具与实践

本文深入探讨了在python环境中实现kafka流连接的挑战与解决方案。针对faust在流连接功能上的现状,我们介绍了quix streams作为一个现代且功能丰富的替代方案。文章详细阐述了如何通过窗口化和有状态处理手动实现流连接,并提供了示例代码,旨在帮助开发者理解并实践高效、可靠的kafka流数据关联。

在实时数据处理领域,将来自不同Kafka主题的流数据进行关联(Join)是一项核心需求。例如,您可能需要将用户点击事件流与用户个人资料流进行关联,以便实时分析用户行为。然而,在Python生态系统中,寻找一个功能完备且易于使用的流处理库来高效实现这一目标,可能需要一番探索。

Faust在流连接方面的考量

Faust作为Python中一个流行的Kafka流处理库,以其简洁的API和对asyncio的支持而受到青睐。然而,当涉及到流连接(Joins)功能时,开发者可能会遇到一些挑战。尽管Faust的文档和源代码中存在对连接(Join)的定义和相关引用,但根据社区观察,其核心连接功能在实际实现上可能并未完全到位或处于早期阶段。这意味着,如果您的项目严重依赖于复杂的流连接操作,直接使用Faust可能需要您自行实现底层逻辑,或者寻找其他解决方案。

Quix Streams:一个现代的Python流处理框架

面对Faust在连接功能上的局限,Quix Streams提供了一个强大的纯Python替代方案。Quix Streams专注于提升Python开发者的体验,并定期发布新功能。它无需额外的服务器端集群,完全基于Python构建,并已获得良好的社区采纳。

Quix Streams提供了一系列开箱即用的高级功能,这些功能对于实现复杂的流处理逻辑,包括间接的流连接,至关重要:

立即学习“Python免费学习笔记(深入)”;

窗口化 (Windowing):允许您定义时间窗口,以便在特定时间范围内聚合或处理数据。这对于基于时间戳的流连接至关重要。有状态函数 (Stateful Functions):支持在流处理过程中维护状态,例如存储来自一个流的数据,以便与来自另一个流的数据进行匹配。精确一次语义 (Exactly-Once Semantics):确保数据在处理过程中不会丢失或重复,这对于数据一致性至关重要的应用场景至关重要。

虽然Quix Streams的路线图上明确包含了未来对专用连接API的支持,但其现有的窗口化和有状态处理能力已经足以让开发者通过手动实现的方式来完成流连接任务。

手动实现流连接的策略

在缺乏直接的join()方法时,可以通过结合窗口化和有状态处理来模拟流连接。这种方法的核心思想是,在一个流处理器中维护另一个流的数据作为状态,并在特定窗口内进行匹配。

基于窗口和状态的范式

实现手动连接的一种常见范式是使用跳跃窗口(Hopping Window)配合归约步骤(Reducing Step)。具体步骤如下:

LuckyCola工具库 LuckyCola工具库

LuckyCola工具库是您工作学习的智能助手,提供一系列AI驱动的工具,旨在为您的生活带来便利与高效。

LuckyCola工具库 19 查看详情 LuckyCola工具库 选择一个主(或驱动)流:这个流的事件将触发连接操作。为另一个(或多个)流维护状态:当其他流的事件到达时,将其存储在一个有状态的存储中(例如,一个基于键的字典),并设置一个过期时间,使其与连接窗口相匹配。定义连接窗口:当主流的事件到达时,在一个预定义的窗口内(例如,过去5秒或未来5秒),在有状态存储中查找匹配的事件。执行归约/匹配逻辑:如果找到匹配项,则执行连接逻辑,生成新的连接事件。

示例代码:模拟两流关联

以下是一个概念性的Python代码示例,演示了如何使用Quix Streams的特性来手动实现两个流的连接。假设我们有两个Kafka主题:user_clicks(用户点击事件)和user_profiles(用户资料更新事件),我们希望根据user_id将点击事件与最新的用户资料进行关联。

import timefrom datetime import datetime, timedeltafrom quixstreams import Application, StreamConsumer, StreamProducer# 假设Quix Streams应用已经初始化app = Application(consumer_group="join-example-group", auto_offset_reset="latest")# 定义输入和输出主题input_clicks_topic = app.topic("user_clicks")input_profiles_topic = app.topic("user_profiles")output_joined_topic = app.topic("joined_data")# 用于存储用户资料的内存状态# 键为 user_id, 值为 {profile_data, timestamp}user_profile_cache = {}CACHE_EXPIRATION_SECONDS = 300 # 资料缓存5分钟@app.consumer(input_profiles_topic)async def process_user_profiles(stream: StreamConsumer):    """    处理用户资料流,并更新本地缓存。    """    async for msg in stream:        profile_data = msg.value        user_id = profile_data.get("user_id")        if user_id:            # 存储最新的用户资料和时间戳            user_profile_cache[user_id] = {                "profile": profile_data,                "timestamp": datetime.now()            }            print(f"Updated profile for user {user_id}")@app.consumer(input_clicks_topic)@app.producer(output_joined_topic)async def process_user_clicks_and_join(stream: StreamConsumer, producer: StreamProducer):    """    处理用户点击流,并尝试与缓存中的用户资料进行连接。    """    async for msg in stream:        click_data = msg.value        user_id = click_data.get("user_id")        if user_id:            # 清理过期缓存            current_time = datetime.now()            for uid, data in list(user_profile_cache.items()):                if current_time - data["timestamp"] > timedelta(seconds=CACHE_EXPIRATION_SECONDS):                    del user_profile_cache[uid]                    # print(f"Cleaned up expired profile for user {uid}")            # 尝试从缓存中获取匹配的用户资料            cached_profile = user_profile_cache.get(user_id)            if cached_profile:                # 假设连接成功,组合数据                joined_data = {                    "click": click_data,                    "profile": cached_profile["profile"],                    "join_timestamp": current_time.isoformat()                }                print(f"Joined click for user {user_id}")                await producer.send(value=joined_data)            else:                print(f"Click for user {user_id} without matching profile in cache.")                # 可以选择将未连接的点击事件发送到另一个主题进行后续处理# if __name__ == "__main__":#     print("Starting Quix Streams application...")#     app.run()

代码说明:

user_profile_cache:这是一个全局字典,模拟了有状态存储,用于缓存最新的用户资料。process_user_profiles:这个消费者负责监听user_profiles主题,并将接收到的用户资料更新到user_profile_cache中。同时,记录资料的更新时间,以便后续进行过期清理。process_user_clicks_and_join:这个消费者监听user_clicks主题。当接收到点击事件时,它会:清理过期缓存:移除超过CACHE_EXPIRATION_SECONDS时间未更新的用户资料,防止内存无限增长和使用过时数据。查找匹配资料:根据点击事件中的user_id,在user_profile_cache中查找对应的用户资料。执行连接:如果找到匹配的资料,则将点击事件与资料合并,形成一个joined_data事件,并发送到output_joined_topic。处理未匹配事件:如果没有找到匹配的资料,可以根据业务需求选择丢弃、记录日志或发送到另一个主题进行后续处理。

这个示例展示了如何利用Quix Streams的消费者和生产者抽象,结合Python原生的数据结构,实现一个基本的、基于键和时间窗口的流连接。

选择合适的工具与未来发展

在选择Python Kafka流处理库时,应综合考虑以下因素:

功能完整性:是否提供所需的窗口化、有状态处理、连接等功能。开发者体验:API是否直观易用,文档是否完善。性能与扩展性:库在处理高吞吐量数据时的表现,以及是否支持分布式部署。社区支持与活跃度:项目的维护情况,以及遇到问题时能否获得帮助。未来路线图:了解项目未来的发展方向,是否会加入您当前或未来所需的功能。

随着流处理技术的不断成熟,越来越多的库将提供内置的、声明式的流连接API,这将大大简化开发者的工作。在等待这些功能完善的同时,利用现有工具提供的基础能力(如窗口和状态管理)进行手动实现,是解决当前问题的有效策略。

实施流连接的注意事项

在设计和实现流连接时,需要注意以下几点:

数据一致性与精确一次语义:确保连接操作在故障恢复后能够保持数据的一致性,避免数据丢失或重复。选择支持精确一次语义的框架至关重要。状态管理与扩展性:手动管理状态(如示例中的user_profile_cache)需要考虑内存消耗、数据持久化(如果需要)以及在分布式环境下的状态同步问题。对于大规模应用,可能需要集成外部状态存储(如RocksDB、Redis)。性能优化:连接操作可能涉及大量的数据查找和匹配。优化数据结构、合理设置缓存过期时间、以及利用并行处理能力是提升性能的关键。迟到数据(Late Data)处理:流处理中,数据可能不会严格按照时间顺序到达。连接逻辑需要考虑如何处理那些晚于其所属窗口到达的事件。连接语义:明确您的业务需求是内连接(Inner Join)、左外连接(Left Outer Join)还是其他类型的连接,并据此设计您的匹配逻辑。

总结

在Python中实现Kafka流连接,虽然可能不像在其他语言的流处理框架中那样直接,但通过Quix Streams等现代库提供的窗口化和有状态处理能力,开发者完全可以通过手动方式构建健壮的连接逻辑。理解这些底层概念和实现策略,不仅能够解决当前的连接需求,也为未来更高级的流处理任务奠定了坚实的基础。随着Python流处理生态的不断发展,我们可以期待更多开箱即用的高级连接功能出现,进一步简化实时数据关联的复杂性。

以上就是Python Kafka流连接:策略、工具与实践的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/592332.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
如何在SQLServer中优化死锁问题?减少锁冲突的详细方法
上一篇 2025年11月10日 16:31:51
怎样清理电脑内存,提升电脑运行速度
下一篇 2025年11月10日 16:32:10

相关推荐

  • VSCode如何集成Jai游戏开发环境 VSCode配置高性能游戏编程工作流

    配置#%#$#%@%@%$#%$#%#%#$%@_e2fc++805085e25c9761616c00e065bfe8集成jai游戏开发环境的核心在于正确设置编译器与调试器并利用扩展提升效率,1. 配置settings.json指定jai.compilerpath、builddirectory、in…

    2026年9月22日
    400
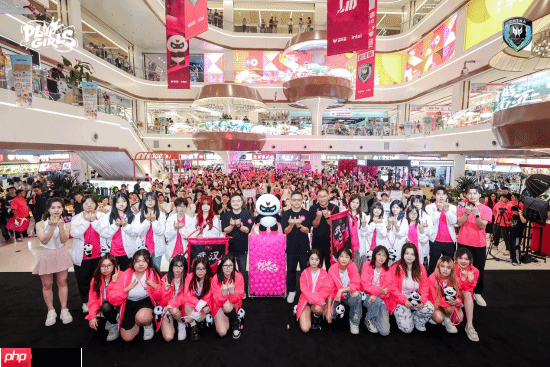
  • 决战江城之巅 掠夺者PL Girls引爆打瓦热潮!

    决战江城之巅 掠夺者PL Girls引爆打瓦热潮!决战江城之巅 掠夺者PL Girls引爆打瓦热潮!决战江城之巅 掠夺者PL Girls引爆打瓦热潮!决战江城之巅 掠夺者PL Girls引爆打瓦热潮!

    10月12日,plgirls掠夺者校园电竞女神联赛【线下城市晋级赛-武汉站】在武汉世界城光谷学生街圆满落幕。经过紧张激烈的对抗,「dcg」与「jmm」两支战队从四强中脱颖而出,成功挺进10月26日的全国总决赛。与此同时,广州赛区的线上海选战果也正式揭晓:「海底大纵队」「fgs」「paperrex」「…

    2026年9月22日 • 用户投稿
    500
  • 为什么需要定期更新主板的BIOS,更新过程中断电会导致什么严重后果?

    定期更新BIOS可提升系统稳定性、硬件兼容性、安全性和性能。支持新CPU和内存需更新BIOS;修复启动异常、USB识别等问题;修补Spectre等安全漏洞;优化电源管理与超频能力。但更新中断可能导致BIOS损坏、主板无法开机,需专业修复,因此操作时须确保稳定供电并遵循厂商指引。 定期更新主板的BIO…

    2026年9月22日
    000
  • mac怎么使用iMovie剪辑视频_mac使用iMovie剪辑视频教程

    首先打开iMovie并导入视频素材,然后将视频拖入时间线进行裁剪与分割,接着为片段间添加转场效果,再插入背景音乐并调节音量,最后设置参数导出视频。 如果您想在Mac上对视频进行剪辑和编辑,但不知道如何使用系统自带的iMovie应用完成操作,可以按照以下步骤进行。iMovie提供了直观的界面和基础剪辑…

    2026年9月22日
    500
  • 淘宝签到红包如何兑换

    淘宝签到红包是平台为用户准备的一项实用福利,帮助你在日常购物中获得更多实惠。那么,如何顺利兑换这些签到红包呢?接下来为你一步步解析。 一、参与签到领取红包 打开淘宝App后,通常在首页就能看到醒目的“签到”入口,点击即可进入签到页面。每日坚持打卡,系统便会发放对应的签到红包。红包金额会根据连续签到的…

    2026年9月22日
    000
  • MySQL自动化备份如何实现_适合企业级部署吗?

    MySQL自动化备份如何实现_适合企业级部署吗?MySQL自动化备份如何实现_适合企业级部署吗?MySQL自动化备份如何实现_适合企业级部署吗?MySQL自动化备份如何实现_适合企业级部署吗?

    mysql的自动化备份对企业级部署是必要的,且可通过多种方式实现。1. 使用mysqldump+定时任务(crontab)是最基础的方式,操作简单适合中小规模数据库,但备份时可能锁表影响业务;2. 增量备份结合二进制日志(binary log)更高效,适用于频繁变更的数据,支持精确恢复到某时间点;3…

    2026年9月21日 • 用户投稿
    000
  • TensorFlow的AI混合工具怎么操作?构建机器学习模型的详细步骤

    TensorFlow的混合编程核心在于结合Keras的高级抽象与TensorFlow底层API的灵活性,实现高效模型开发。首先使用tf.data构建高性能数据管道,通过map、batch、shuffle和prefetch等操作优化数据预处理;接着利用Keras快速搭建模型结构,同时通过继承tf.ke…

    2026年9月21日
    300
  • 如何在Windows系统配置Gradle环境变量 Gradle路径设置方法

    首先设置GRADLE_HOME环境变量指向Gradle安装目录,再将%GRADLE_HOME%bin添加到PATH中,最后在命令行输入gradle -v验证配置是否成功。 要在Windows系统中配置Gradle环境变量,你需要将Gradle的安装路径添加到系统的PATH环境变量中,这样可以在命令行…

    2026年9月21日
    100
  • 360浏览器医生在哪里打开_360浏览器医生功能启动入口介绍

    360浏览器异常时可通过四种方式启动“浏览器医生”:1.点击右下角医疗箱图标;2.按下F1键;3.从菜单栏“帮助”中进入;4.在设置的扩展功能里查找,随后选择修复模式并重启浏览器。 如果您发现360浏览器运行异常,例如网页加载缓慢、频繁弹窗或无法正常打开页面,可以借助“浏览器医生”功能进行检测与修复…

    2026年9月21日
    100
  • 如何为iPhone14下载最新固件?官方渠道操作教程

    首先通过设备设置检查更新,进入“设置-通用-软件更新”下载并安装;若失败,可连接电脑使用Mac的访达或Windows的iTunes进行固件下载与更新。 如果您尝试为您的iPhone 14获取最新的系统版本,但无法通过常规方式完成下载,可能是由于网络连接不稳定或设备存储空间不足。以下是通过官方渠道进行…

    2026年9月21日
    200
  • Intel前CEO:公司过去15年连锁犯错、18A是重要里程碑

    10月14日,曾担任intel首席执行官的帕特·基辛格(pat gelsinger)在近期一次采访中分享了他对自身在intel职业生涯的反思,并就当下ai产业的发展态势表达了个人见解。 他坦言,Intel“在过去十五年间接连做出多项错误的战略选择”, 这使得公司进入了漫长的重建期,同时也失去了曾经在…

    2026年9月21日
    600
  • 抖音直播间管理员可以设置几个?做主播管理员有收入吗

    抖音直播已成为当前最火爆的社交形式之一。作为直播间的管理核心,抖音直播间管理员在维护秩序、提升体验以及推动直播间发展方面发挥着重要作用。本文将围绕抖音直播间管理员的设置要点进行详细解析,帮助管理者更有效地运营直播间,构建高质量的直播环境。 一、抖音直播间管理员设置关键点 1. 门槛设定 为了保证直播…

    2026年9月21日
    000
  • VSCode如何自定义文件图标 VSCode资源管理器视觉优化的技巧

    自定义vscode文件图标需安装图标主题扩展,如material icon theme;2. 通过扩展市场安装后,在文件图标主题设置中启用;3. 选择主题时应考虑视觉风格、图标覆盖率、辨识度和更新频率;4. 可结合文件嵌套、隐藏文件夹、缩进指南等设置优化资源管理器视觉体验;5. 自定义图标对性能影响…

    2026年9月21日
    000
  • 手机淘宝怎么加热区?淘宝怎么添加热区

    需商家账号在淘宝商家中心或旺铺PC端设置热区,普通买家无权限。①手机端:登录商家中心→店铺管理→详情页装修→选图添加热点→设链接保存;②PC端:登录旺铺官网→店铺装修→用图片热区工具划区域→设跳转链接→发布;③确认账号为已开店的商家主/子账号,未开通需申请店铺并订购旺铺服务。 如果您在使用手机淘宝时…

    2026年9月21日
    000
  • 如何使用Scikit-learn训练AI大模型?传统机器学习与深度结合

    如何使用Scikit-learn训练AI大模型?传统机器学习与深度结合如何使用Scikit-learn训练AI大模型?传统机器学习与深度结合如何使用Scikit-learn训练AI大模型?传统机器学习与深度结合如何使用Scikit-learn训练AI大模型?传统机器学习与深度结合

    Scikit-learn在大型模型预处理中的核心作用是提供数据清洗、特征缩放、编码和降维等工具,确保输入数据高质量且规范化,为深度学习模型奠定坚实基础。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 说实话,如果你的目标是纯粹地“训练AI大…

    2026年9月21日 • 用户投稿
    700
  • win11复制大文件时速度突然掉到0怎么办_win11大文件复制速度突然掉0解决方法

    传输速度降为0可尝试Robocopy命令、修复磁盘错误、更新驱动、关闭占用程序或格式化为NTFS。首先使用Robocopy无缓冲复制避免卡顿;其次通过chkdsk扫描修复文件系统错误;接着在设备管理器中更新USB与存储控制器驱动;然后通过任务管理器关闭高磁盘占用的后台进程;最后若目标盘为FAT32/…

    2026年9月21日
    200
  • Online Config VS Code

    Online Config VS CodeOnline Config VS CodeOnline Config VS CodeOnline Config VS Code

    run vs view Install Code Server Update Code Server Database:It is recommended to create a Docker container for the database. Code Language: JavaScript…

    2026年9月21日 • 用户投稿
    000
  • Java Collections.sort与Collections.reverse的使用区别

    Collections.sort用于排序,基于元素值比较,结果有序,默认升序,可自定义规则;2. Collections.reverse仅反转列表顺序,不比较元素,时间复杂度O(n);3. 两者功能不同,不可替代,按需选择使用。 Java 中 Collections.sort 和 Collectio…

    2026年9月21日
    200
  • MediBangPaint中AI生成图片如何导出?快速保存图像的详细方法

    答案:导出AI生成图片应优先选择PNG格式以保留细节和色彩。通过“文件”菜单中的“导出(单层)”功能,可将图像保存为PNG或JPG等格式,其中PNG为无损压缩,适合高质量输出;若需透明背景或后续编辑,更应选用PNG。清晰度不足常因原始分辨率低、过度放大或JPG压缩过度所致,建议导出时设置高质量(80…

    2026年9月21日
    300
  • 百度搜索app如何启用搜索关键词过滤_百度搜索app关键词过滤的设置技巧

    可通过减号语法排除关键词,如“健身教程 -广告”;用双引号实现精确匹配,如”瑜伽初学者教程”;结合site:指令限定范围,如Python入门教程 site:zhihu.com,提升搜索精准度。 如果您在使用百度搜索App时,希望减少不相关或不想要的搜索结果,可以通过设置关键词…

    2026年9月21日
    800

发表回复

登录后才能评论
关注微信