使用 Pandas json_normalize 展平嵌套 JSON 数据

使用 pandas json_normalize 展平嵌套 json 数据

本文旨在指导读者如何使用 Pandas 库中的 `json_normalize` 函数处理包含嵌套列表的 JSON 文件,将其转换为易于分析的表格数据。我们将详细介绍如何针对不同的嵌套层级进行展平操作,并演示如何将展平后的数据合并成一个完整的 DataFrame。通过本文的学习,读者将能够有效地处理复杂的 JSON 数据,并将其应用于实际的数据分析任务中。

准备工作

首先,确保你已经安装了 Pandas 库。如果没有安装,可以使用 pip 进行安装:

pip install pandas

加载 JSON 数据

假设我们有一个名为 data.json 的 JSON 文件,内容如下:

[{  "uuid": "a2d89c9b-6e2e-4e3a-8d60-bf3ce2fe3fda",  "timestamp": "2023-11-23 00:26:31.851000 UTC",  "process_timestamp": "2023-11-23 00:26:32.326000 UTC",  "visitor_id": "oeu1700282566730r0.9025758502018271",  "session_id": "AUTO",  "account_id": "25408250069",  "experiments": {    "list": [{      "element": {        "campaign_id": "26314710187",        "experiment_id": "26322360336",        "variation_id": "26314800349",        "is_holdback": "false"      }    }]  },  "entity_id": "25754820685",  "attributes": {    "list": [{      "element": {        "id": null,        "name": "",        "type": "browserId",        "value": "gc"      }    }, {      "element": {        "id": null,        "name": "",        "type": "campaign",        "value": "blablabla"      }    }, {      "element": {        "id": null,        "name": "",        "type": "device",        "value": "desktop"      }    }, {      "element": {        "id": null,        "name": "",        "type": "device_type",        "value": "desktop_laptop"      }    }, {      "element": {        "id": null,        "name": "",        "type": "referrer",        "value": "https://bookings.perrito.com/21df6542"      }    }, {      "element": {        "id": null,        "name": "",        "type": "source_type",        "value": "campaign"      }    }, {      "element": {        "id": null,        "name": "",        "type": "currentTimestamp",        "value": "1700699073915"      }    }, {      "element": {        "id": null,        "name": "",        "type": "offset",        "value": "300"      }    }]  },  "user_ip": "72.38.10.0",  "user_agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/116.0.0.0 Safari/537.36",  "referer": "https://bookings.perrito.com/",  "event_type": "other",  "event_name": "transaction",  "revenue": "240939",  "value": null,  "quantity": null,  "tags": {    "key_value": [{      "key": "tour_id",      "value": "386"    }, {      "key": "booking_id",      "value": "123456"    }, {      "key": "payment_type",      "value": "creditcard"    }, {      "key": "revenue",      "value": "240939"    }, {      "key": "pax",      "value": "1"    }, {      "key": "tour_name",      "value": "Best Viaje ever"    }, {      "key": "extras",      "value": "245.00"    }]  },  "revision": "859",  "client_engine": "js",  "client_version": "0.188.1",  "element": {    "campaign_id": "26314710187",    "experiment_id": "26322360336",    "variation_id": "26314800349",    "is_holdback": "false"  }}]

使用以下代码加载 JSON 数据:

import jsonimport pandas as pdwith open("data.json", "r") as f:    data = json.load(f)

使用 json_normalize 展平数据

json_normalize 函数可以将 JSON 数据展平为表格形式。对于包含嵌套列表的 JSON,我们需要指定 record_path 参数来告诉函数需要展平的列表路径。

首先,定义一些顶层字段作为元数据,这些字段将作为索引字段保留在展平后的数据中:

meta = [    "uuid",    "timestamp",    "process_timestamp",    "visitor_id",    "session_id",    "account_id",    "entity_id",    "user_ip",    "user_agent",    "referer",    "event_type",    "event_name",    "revenue",    "value",    "quantity",    "revision",    "client_engine",    "client_version",]

接下来,针对 experiments.list、attributes.list 和 tags.key_value 这三个嵌套列表分别进行展平:
Find JSON Path Online Find JSON Path Online

Easily find JSON paths within JSON objects using our intuitive Json Path Finder

Find JSON Path Online 30 查看详情 Find JSON Path Online

experiments_list = pd.json_normalize(    data=data,    record_path=["experiments", "list"],    meta=meta,    record_prefix="experiments.list.",)attributes_list = pd.json_normalize(    data=data,    record_path=["attributes", "list"],    meta=meta,    record_prefix="attributes.list.",)tags_key_value = pd.json_normalize(    data=data,    record_path=["tags", "key_value"],    meta=meta,    record_prefix="tags.key_value.",)

在上述代码中,record_path 参数指定了需要展平的列表路径,meta 参数指定了需要保留的元数据字段,record_prefix 参数用于为展平后的字段添加前缀,避免命名冲突。

合并展平后的数据

展平后的数据分别存储在 experiments_list、attributes_list 和 tags_key_value 三个 DataFrame 中。为了将这些数据合并成一个完整的 DataFrame,可以使用 pd.merge 函数:

out = (    pd.merge(left=experiments_list, right=attributes_list, on=meta)    .merge(right=tags_key_value, on=meta))

pd.merge 函数根据指定的元数据字段将 DataFrame 进行合并。注意,由于每个嵌套列表的长度可能不同,合并后的 DataFrame 可能会出现重复的行。

示例代码

以下是完整的示例代码:

import jsonimport pandas as pdwith open("data.json", "r") as f:    data = json.load(f)meta = [    "uuid",    "timestamp",    "process_timestamp",    "visitor_id",    "session_id",    "account_id",    "entity_id",    "user_ip",    "user_agent",    "referer",    "event_type",    "event_name",    "revenue",    "value",    "quantity",    "revision",    "client_engine",    "client_version",]experiments_list = pd.json_normalize(    data=data,    record_path=["experiments", "list"],    meta=meta,    record_prefix="experiments.list.",)attributes_list = pd.json_normalize(    data=data,    record_path=["attributes", "list"],    meta=meta,    record_prefix="attributes.list.",)tags_key_value = pd.json_normalize(    data=data,    record_path=["tags", "key_value"],    meta=meta,    record_prefix="tags.key_value.",)out = (    pd.merge(left=experiments_list, right=attributes_list, on=meta)    .merge(right=tags_key_value, on=meta))print(out)

注意事项

在使用 json_normalize 函数时,需要仔细分析 JSON 数据的结构,确定正确的 record_path 和 meta 参数。如果 JSON 数据中包含多个嵌套层级,可能需要多次调用 json_normalize 函数进行展平。合并展平后的数据时,需要注意数据重复的问题,可以根据实际需求进行去重或聚合操作。

总结

本文介绍了如何使用 Pandas 库中的 json_normalize 函数处理包含嵌套列表的 JSON 文件。通过指定 record_path 和 meta 参数,我们可以将 JSON 数据展平为表格形式,并使用 pd.merge 函数将展平后的数据合并成一个完整的 DataFrame。掌握这些技巧可以帮助我们更有效地处理复杂的 JSON 数据,并将其应用于实际的数据分析任务中。

以上就是使用 Pandas json_normalize 展平嵌套 JSON 数据的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/592453.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
如何通过查询重写优化MySQL?简化SQL语句的实用方法
上一篇 2025年11月10日 16:33:13
CentOS上Zookeeper的Java版本要求是什么
下一篇 2025年11月10日 16:33:23

相关推荐

  • Linux用户和权限管理的安全最佳实践

    最小权限原则要求用户和进程仅拥有必要权限,避免赋予root权限,通过sudo提权并限制命令,服务账户禁止登录且权限最小化;定期审查sudoers文件,删除无用账户,禁用root直接登录,强密码策略由pam_pwquality实现,usermod -s /sbin/nologin限制服务账户登录;文件…

    2026年9月23日
    500
  • 使用 Mp4Parser API 重构 MP4 文件:理解原子结构与常见陷阱

    本文深入探讨了如何使用 Java 的 Mp4Parser API 进行 MP4 文件的低级操作,特别是在复制或重构文件时可能遇到的问题。通过一个实际案例,文章揭示了忽略关键 MP4 原子(如 uuid)可能导致文件无法播放的原因,并提供了修复后的代码示例,强调了理解 MP4 规范和原子完整性的重要性…

    2026年9月23日
    500
  • PC热门游戏《深岩银河:幸存者》即将登陆iOS与Android平台

    在pc平台结束抢先体验后不久,《深岩银河:幸存者》现已宣布将移植至android与ios平台。此消息随同游戏后续更新的补丁说明一并公布,并发布了一支新的预告片,一起来看看吧! 预告视频: 预告片展示了移动版《深岩银河:幸存者》的核心玩法。其内容将与PC版本质相同,但操作方式将改为利用屏幕上的虚拟摇杆…

    2026年9月23日
    000
  • mysql如何进入编辑模式 mysql输入sql语句创建数据库

    mysql如何进入编辑模式 mysql输入sql语句创建数据库mysql如何进入编辑模式 mysql输入sql语句创建数据库mysql如何进入编辑模式 mysql输入sql语句创建数据库mysql如何进入编辑模式 mysql输入sql语句创建数据库

    创建mysql数据库需登录后执行sql语句;避免sql注入用参数化查询、输入验证、最小权限原则、waf;解决乱码需统一客户端、数据库、表编码为utf8mb4;优化查询性能可通过索引、explain分析、避免select *、使用join、分页优化、定期维护、硬件升级、缓存。 想要用MySQL创建数据…

    2026年9月23日 用户投稿
    1500
  • Asianux 7.3安装Oracle 11.2.0.4单实例体验

    在asianux 7.3环境中安装#%#$#%@%@%$#%$#%#%#$%@_a189c++633d9995e11bf8607170ec9a4b8 11.2.0.4单实例的具体步骤和注意事项如下: 环境:Asianux 7.3 需求:安装Oracle 11.2.0.4 单实例 背景:系统使用默认的…

    2026年9月23日
    300
  • VSCode管理FPGA约束文件(高效编辑方法,时序约束指南)

    使用vscode高效编辑fpga约束文件的方法包括:1. 安装“better comments”和“bracket pair colorizer”等插件以提升可读性和编辑效率;2. 利用代码片段功能创建常用约束模板,如时钟和i/o约束,通过关键词快速插入以减少重复输入和错误;3. 使用支持正则表达式…

    2026年9月23日
    000
  • 如何在Krita中使用AI裁剪图片?快速掌握高效图像裁剪技巧

    如何在Krita中使用AI裁剪图片?快速掌握高效图像裁剪技巧如何在Krita中使用AI裁剪图片?快速掌握高效图像裁剪技巧如何在Krita中使用AI裁剪图片?快速掌握高效图像裁剪技巧如何在Krita中使用AI裁剪图片?快速掌握高效图像裁剪技巧

    Krita虽无内置AI裁剪功能,但可通过其构图辅助线、选区与变换工具实现“智能”裁剪,并结合外部AI工具完成内容扩展与智能构图,形成高效工作流。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ Krita本身,作为一款强大的开源数字绘画与图像…

    2026年9月23日 用户投稿
    200
  • 在Loom中利用虚拟线程实现递归任务:告别ForkJoinPool的限制

    本文探讨了Java Loom中RecursiveAction和RecursiveTask与虚拟线程的兼容性。由于它们设计上依赖于ForkJoinPool及其特定的工作线程,无法直接与虚拟线程配合使用。文章提供了两种替代方案:一是利用CompletableFuture结合虚拟线程工厂实现自定义递归任务…

    2026年9月23日
    500
  • 《蝎之尾》攻略——游戏配置要求介绍

    《蝎之尾》(tail of scorpios)是由jabberworks打造的一款设定在架空历史背景下的悬疑推理类视觉小说游戏。该游戏不仅剧情引人入胜,画面表现也相当出色,同时对设备的硬件要求较为亲民,最低仅需1.6ghz单核的intel或amd处理器即可运行。 《蝎之尾》最低配置要求如下: 操作系…

    2026年9月23日
    200
  • CodeIgniter 动态多数据库连接与数据导入实践指南

    本文详细介绍了在 CodeIgniter 框架中,如何根据用户输入的动态数据库凭证建立并管理第二个数据库连接。通过构建自定义连接配置数组,并利用 CodeIgniter 的数据库加载机制,开发者可以灵活地切换数据库实例,从而实现从外部数据库导入数据到主数据库的功能,提升应用的灵活性和数据处理能力。 …

    2026年9月23日
    000
  • Android自定义开关UI实现教程:打造独特交互体验

    本教程旨在指导开发者如何在Android应用中实现高度定制化的开关UI,摆脱原生组件的限制。我们将探讨两种主要方法:一是利用功能丰富的第三方库快速构建复杂动画效果的开关;二是通过XML Drawable Selector自定义原生ToggleButton的外观,实现简洁高效的视觉定制。 在andro…

    2026年9月23日
    200
  • MICCAI 2020 | 基于3D监督预训练的全身病灶检测SOTA(预训练代码和模型已公开)

    MICCAI 2020 | 基于3D监督预训练的全身病灶检测SOTA(预训练代码和模型已公开)MICCAI 2020 | 基于3D监督预训练的全身病灶检测SOTA(预训练代码和模型已公开)MICCAI 2020 | 基于3D监督预训练的全身病灶检测SOTA(预训练代码和模型已公开)MICCAI 2020 | 基于3D监督预训练的全身病灶检测SOTA(预训练代码和模型已公开)

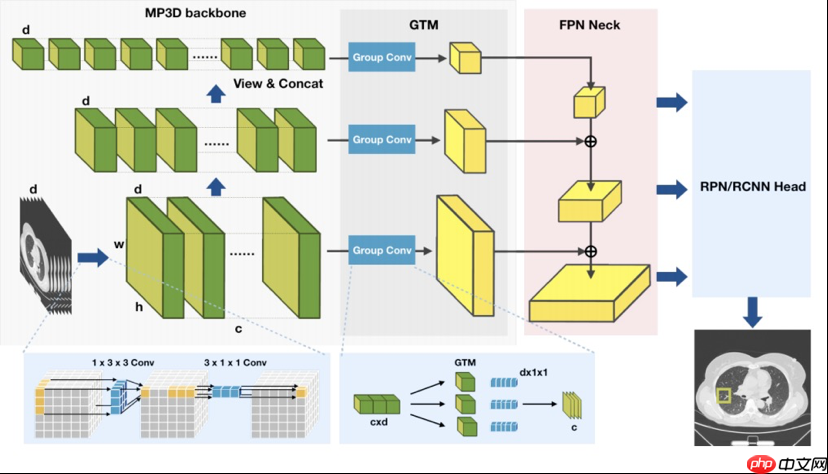
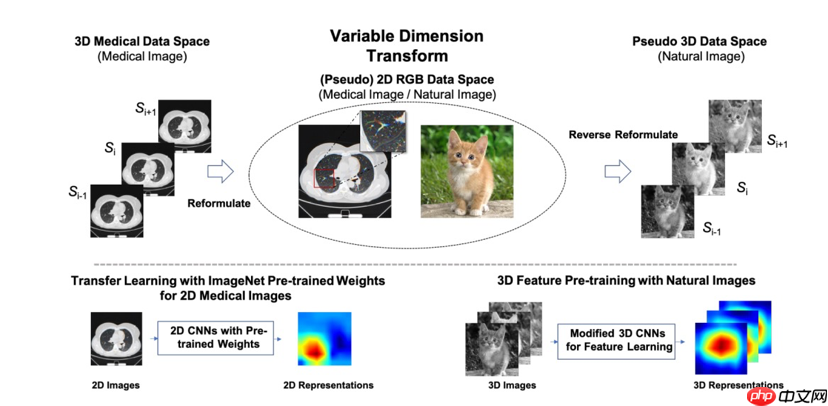
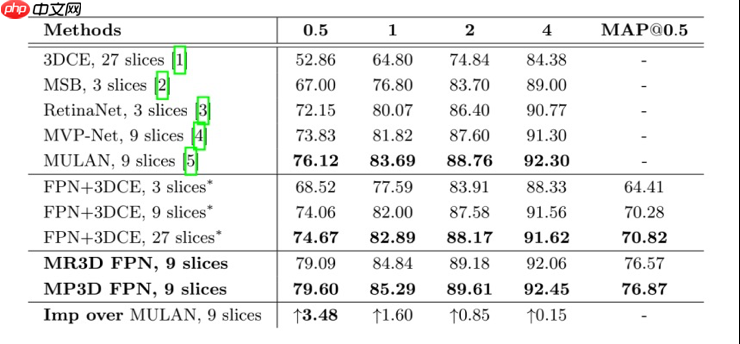
    ▊ 研究背景介绍 由于深度学习任务通常依赖大量标注数据,医疗图像的标注需要专业知识,标注人员需精确判断病灶的大小、形状、边缘等信息,甚至需要经验丰富的专家进行多次评估,这增加了深度学习在医疗领域应用的难度。 目前,尽管有一些公开数据集(如LIDC-IDRI、LUNA等)可供使用,但这些数据集的图像数…

    2026年9月23日 用户投稿
    200
  • 2025内存条最新榜单 内存条品牌排行榜前十名盘点

    为您的电脑挑选合适的内存条是提升整体性能的关键一步。面对市场上琳琅满目的品牌,选择可能变得困难。本文为您整理了2025年最值得关注的内存条品牌排行榜,帮助您清晰地了解各大品牌的特点,为您的设备升级或新机配置提供有力参考。 一、2025内存条品牌排行榜前十名 1、海盗船 (Corsair):作为高端硬…

    2026年9月23日
    100
  • win10提示“由你的组织管理”怎么办_win10组织管理提示解除教程

    首先断开工作或学校账户,再将网络ID改为家庭模式,接着用命令行清除组策略和注册表项,最后手动删除特定注册表路径中的管理策略项并重启电脑。 如果您在使用Windows 10时发现系统设置中出现“由你的组织管理”的提示,这通常意味着某些策略正在控制您的设备设置,导致部分功能受限。以下是解除该管理状态的多…

    2026年9月23日
    000
  • 如何使用TensorFlowLite训练AI大模型?移动端模型优化的教程

    如何使用TensorFlowLite训练AI大模型?移动端模型优化的教程如何使用TensorFlowLite训练AI大模型?移动端模型优化的教程如何使用TensorFlowLite训练AI大模型?移动端模型优化的教程如何使用TensorFlowLite训练AI大模型?移动端模型优化的教程

    TensorFlow Lite通过模型转换、量化、剪枝等优化手段,将训练好的大模型压缩并加速,使其能在移动端高效推理。首先在服务器端训练模型,随后用TFLiteConverter转为.tflite格式,结合量化(如Float16或全整数量化)、量化感知训练、剪枝和聚类等技术减小模型体积、提升运行速度…

    2026年9月23日 用户投稿
    000
  • 抖音ai分身怎么关闭?抖音AI怎么关闭

    作为广受欢迎的短视频社交平台,抖音通过其AI分身功能为用户带来了更具个性化的推荐体验。但如何停用这一功能也逐渐成为用户关心的问题。本文将为您详细介绍如何关闭抖音的AI分身,并探讨在享受个性化推荐的同时如何保障个人隐私。 一、抖音AI分身功能概述 抖音的AI分身是基于人工智能技术,通过对用户的兴趣偏好…

    2026年9月23日
    000
  • mysql怎么修改索引 mysql索引创建与更新操作教程

    mysql怎么修改索引 mysql索引创建与更新操作教程mysql怎么修改索引 mysql索引创建与更新操作教程mysql怎么修改索引 mysql索引创建与更新操作教程mysql怎么修改索引 mysql索引创建与更新操作教程

    mysql中修改索引的正确方法是删除旧索引并创建新索引,因为mysql不支持直接修改索引结构;1. 创建索引可通过create index或alter table add index实现,用于加速数据检索;2. 删除索引使用drop index或alter table drop index,操作前需…

    2026年9月23日 用户投稿
    200
  • Hibernate 3.6 Criteria API 根别名设置行为解析

    在Hibernate 3.6版本中,使用getSession().createCriteria(Entity.class, “myAlias”)尝试为根实体设置自定义表别名时,生成的SQL语句中的根别名仍可能默认为this_,而非用户指定的别名。这源于Hibernate内部C…

    2026年9月23日
    100
  • VSCode如何管理技术债务 VSCode代码质量跟踪的实用方法

    eslint、pylint等linter类扩展可实时识别代码问题,从源头减少技术债务;2. sonarlint能集成sonarqube规则,深度检测代码异味并提供修复建议;3. code metrics可量化函数圈复杂度等指标,帮助定位高风险代码;4. todo tree将todo、fixme等注释…

    2026年9月23日
    000
  • 谷歌浏览器如何更改界面语言_谷歌浏览器界面语言修改方法

    1、打开谷歌浏览器设置,添加简体中文并设为显示语言,重启生效;2、在macOS语言与地区中将中文拖至首选语言顶部以同步系统设置;3、若未生效,可清除Chrome的Preferences缓存文件重置配置。 如果您在使用谷歌浏览器时希望将其界面语言更改为其他语言,可能是因为系统默认语言不符合您的使用习惯…

    2026年9月23日
    000

发表回复

登录后才能评论
关注微信