Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
Pandas高效计算基于类别变化的滚动时间差_创想鸟

Pandas高效计算基于类别变化的滚动时间差

Pandas高效计算基于类别变化的滚动时间差

本文详细介绍了如何在pandas dataframe中高效计算一个时间列相对于另一个类别列值发生变化时的滚动时间差。通过利用`shift()`、`ne()`、`cumsum()`组合创建连续组,并结合`groupby().transform(‘first’)`获取组内起始时间,最终实现矢量化操作,避免了低效的循环,从而显著提升数据处理性能。

引言:问题背景与挑战

在数据分析场景中,我们经常需要根据某个特定条件的变化来计算时间或其他数值的累积或差值。一个常见需求是,给定一个包含时间戳(t)和类别标识符(A)的DataFrame,我们希望计算从类别A的当前值首次出现(即A值发生变化)到当前行所经过的时间。传统上,许多开发者可能会倾向于使用Python的for循环来遍历DataFrame并进行判断,但这在处理大型数据集时效率极低,计算成本高昂。

例如,考虑以下数据结构:

A t X (期望输出)

10.0013.23.213.93.9118.018127.427.4347.40350.22.8357.29.8364.817.4376.429.0280.50185.30187.42.1

我们的目标是生成X列,其中每个值表示当前行t距离其所属的连续A值块开始时的t值的差。当A的值发生变化时,新的A块的第一个X值应为0。

解决方案:Pandas矢量化操作

Pandas库提供了强大的矢量化操作,能够以远超for循环的效率处理此类问题。核心思路是:

识别连续的类别组:将DataFrame根据A列中连续相同值的块进行分组。获取组内起始时间:对于每个识别出的组,获取其第一个t值。计算时间差:用当前行的t值减去其所属组的起始t值。

下面是具体的实现步骤和代码示例。

步骤一:创建示例DataFrame

首先,我们创建一个与问题描述相符的Pandas DataFrame:

import pandas as pddata = {    'A': [1, 1, 1, 1, 1, 3, 3, 3, 3, 3, 2, 1, 1],    't': [0.0, 3.2, 3.9, 18.0, 27.4, 47.4, 50.2, 57.2, 64.8, 76.4, 80.5, 85.3, 87.4]}df = pd.DataFrame(data)print("原始DataFrame:")print(df)

输出:

算家云 算家云

高效、便捷的人工智能算力服务平台

算家云 37 查看详情 算家云

原始DataFrame:    A      t0   1    0.01   1    3.22   1    3.93   1   18.04   1   27.45   3   47.46   3   50.27   3   57.28   3   64.89   3   76.410  2   80.511  1   85.312  1   87.4

步骤二:识别连续的类别组

这是解决问题的关键一步。我们需要为A列中每个连续的相同值块生成一个唯一的标识符。这可以通过结合使用shift()、ne()和cumsum()方法来实现:

df[‘A’].shift():将A列向下移动一行,这样每一行都可以与上一行的A值进行比较。df[‘A’].ne(df[‘A’].shift()):比较当前行的A值是否不等于上一行的A值。如果不同,则返回True,表示类别发生了变化;否则返回False。.cumsum():对布尔序列进行累积求和。每当遇到True(即类别变化)时,累加值增加1。这样,每个连续的类别块都会得到一个唯一的整数作为组标识符。

group = df['A'].ne(df['A'].shift()).cumsum()print("n生成的连续组标识符:")print(group)

输出:

生成的连续组标识符:0     11     12     13     14     15     26     27     28     29     210    311    412    4Name: A, dtype: int64

可以看到,A值为1的第一个连续块被标记为组1,A值为3的块被标记为组2,依此类推。

步骤三:获取每个组的起始时间

有了组标识符后,我们可以使用groupby()结合transform(‘first’)来获取每个组的第一个t值。transform(‘first’)的优点在于它会返回一个与原始DataFrame长度相同的Series,其中每个值都是其所属组的第一个元素。

first_t_per_group = df.groupby(group)['t'].transform('first')print("n每个组的起始时间 (广播到每行):")print(first_t_per_group)

输出:

每个组的起始时间 (广播到每行):0      0.01      0.02      0.03      0.04      0.05     47.46     47.47     47.48     47.49     47.410    80.511    85.312    85.3Name: t, dtype: float64

步骤四:计算时间差

最后,我们将原始的t列减去每个组的起始t值,即可得到所需的滚动时间差X:

df['X'] = df['t'].sub(first_t_per_group)print("n最终结果DataFrame:")print(df)

输出:

最终结果DataFrame:    A      t      X0   1    0.0    0.01   1    3.2    3.22   1    3.9    3.93   1   18.0   18.04   1   27.4   27.45   3   47.4    0.06   3   50.2    2.87   3   57.2    9.88   3   64.8   17.49   3   76.4   29.010  2   80.5    0.011  1   85.3    0.012  1   87.4    2.1

这个结果与我们期望的输出完全一致。

完整代码示例

将上述步骤整合,完整的解决方案代码如下:

import pandas as pd# 1. 创建示例DataFramedata = {    'A': [1, 1, 1, 1, 1, 3, 3, 3, 3, 3, 2, 1, 1],    't': [0.0, 3.2, 3.9, 18.0, 27.4, 47.4, 50.2, 57.2, 64.8, 76.4, 80.5, 85.3, 87.4]}df = pd.DataFrame(data)# 2. 识别连续的类别组# df['A'].shift() 获取上一行的A值# df['A'].ne(df['A'].shift()) 比较当前A值是否不等于上一行A值,生成布尔序列# .cumsum() 对布尔序列进行累积求和,为每个连续的A值块生成唯一组IDgroup = df['A'].ne(df['A'].shift()).cumsum()# 3. 计算每个组的起始时间并广播# df.groupby(group)['t'] 按生成的组ID对t列进行分组# .transform('first') 获取每个组的第一个t值,并将其广播到组内的所有行first_t_per_group = df.groupby(group)['t'].transform('first')# 4. 计算时间差# df['t'].sub(...) 用当前t值减去其所属组的起始t值df['X'] = df['t'].sub(first_t_per_group)print("最终计算结果:")print(df)

注意事项与总结

效率优势:这种方法完全依赖于Pandas的矢量化操作和C语言实现,相比Python原生的for循环,在处理大规模数据集时能提供显著的性能提升。通用性:此模式不仅适用于时间差计算,也可以推广到其他需要基于连续类别变化的组内统计(如组内计数、组内求和等)的场景,只需将transform(‘first’)替换为相应的聚合函数即可。shift()的第一个值:df[‘A’].shift()在第一行会产生NaN。当ne()与NaN比较时,结果通常是True,因此cumsum()会从1开始,这对于生成第一个组的标识符是正确的行为。数据类型:确保时间列t是数值类型(如float或int),以便进行数学运算。如果它是日期时间对象,则需要先转换为时间差(timedelta)或Unix时间戳进行计算。

通过掌握shift()、ne()、cumsum()以及groupby().transform()的组合使用,我们可以高效且优雅地解决Pandas中涉及连续数据块分析的复杂问题,极大地提升数据处理的效率和代码的可读性。

以上就是Pandas高效计算基于类别变化的滚动时间差的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/595327.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫

手机无线wifi桥接教程(通过手机实现无线wifi桥接的方法及步骤)
上一篇 2025年11月10日 17:56:28
mybatis 和 hibernate 的区别有哪些?
下一篇 2025年11月10日 17:56:39

相关推荐

  • 如何配置VSCode与Jupyter Notebook进行交互式数据科学编程?

    首先安装Python、VSCode及Python扩展,再通过pip安装jupyter;接着在VSCode中创建或打开.ipynb文件,使用Shift+Enter运行单元格;然后通过Ctrl+Shift+P选择Python解释器并确保安装ipykernel以匹配内核;最后启用变量查看器、代码块分隔符和…

    2026年9月21日
    000
  • avg计算平均值在mysql中如何使用

    AVG()是MySQL中计算列平均值的聚合函数,忽略NULL值。基本语法为SELECT AVG(列名) FROM 表名;可结合WHERE筛选条件,如SELECT AVG(score) FROM students WHERE subject = ‘math’ AND score…

    2026年9月21日
    000
  • 蝴蝶号内容创作不露脸的五大绝技与执行方法 | 快速提升曝光率的实用操作流程

    不露脸也能玩转蝴蝶号内容创作,关键在于将焦点从个人形象转移到内容本身与观众体验上,通过声音叙事、动态文字、手部特写、数据可视化和场景搭建五大核心策略构建吸引力,结合高质量音画配合、精准的受众定位、稳定更新与算法互动,提升曝光率;同时规避素材版权、声音质量与画面单调等技术挑战,善用免费或付费正版素材、…

    2026年9月21日
    100
  • 如何使用XGBoost训练AI大模型?优化机器学习模型的步骤

    XGBoost并非用于训练GPT类大模型,而是擅长处理结构化数据的高效梯度提升算法,其优势在于速度快、准确性高、支持并行计算、内置正则化与缺失值处理,适用于表格数据建模;通过分阶段超参数调优(如学习率、树深度、采样策略)、结合贝叶斯优化与交叉验证,并配合特征工程、数据预处理和集成学习等关键步骤,可显…

    2026年9月21日
    000
  • VSCode怎么运行全部代码_VSCode批量执行代码教程

    在VSCode里“运行全部代码”或“批量执行代码”,其实很少是一个单一的、所有语言通用的按钮。它更多的是指根据你项目的具体需求,通过配置任务(Tasks)、使用集成终端(Integrated Terminal)配合脚本,或者利用特定语言的运行/调试配置(Launch Configurations)来…

    2026年9月21日
    100
  • VSCode怎么新建ipynb文件_VSCode创建和编辑Jupyter笔记本文件教程

    答案:在VSCode中运行Jupyter笔记本需准备Python环境、安装Python扩展并确保安装ipykernel;通过命令面板或文件菜单新建笔记本,编辑时可添加代码或Markdown单元格,运行代码后结果实时显示;通过右上角内核选择器切换Python环境,推荐为不同项目配置独立虚拟环境以避免依…

    2026年9月21日
    200
  • mysql如何实现后台管理系统

    答案:基于MySQL的%ignore_a_1%需设计用户、权限、日志等表结构,通过后端语言实现安全的CRUD接口与JWT认证,前端展示数据并控制权限,确保系统安全稳定。 实现一个基于 MySQL 的后台管理系统,核心是构建一个安全、稳定、可扩展的系统架构,将数据库作为数据存储层,配合后端语言和前端界…

    2026年9月21日
    000
  • 压力测试(Benchmark)Swoole服务的工具与方法

    进行swoole服务的压力测试是为了确保服务在高负载下稳定运行。1. 选择工具:apache jmeter、wrk、locust。2. 使用方法:jmeter通过脚本配置,wrk通过命令行,locust通过python脚本。3. 注意事项:环境隔离、数据监控、脚本设计。4. 优化点:内存泄漏、连接池…

    2026年9月21日
    000
  • 利用蝴蝶号搭建多账号无人直播系统的完整方案

    利用蝴蝶号搭建多账号无人直播系统的完整方案利用蝴蝶号搭建多账号无人直播系统的完整方案利用蝴蝶号搭建多账号无人直播系统的完整方案利用蝴蝶号搭建多账号无人直播系统的完整方案

    搭建多账号无人直播系统并非一键操作,而是通过“蝴蝶号”实现自动化流程。首先,“蝴蝶号”负责多账号的生命周期管理,包括登录、状态维护、ip代理分配和设备指纹模拟;其次,内容调度系统决定直播内容及播放时间,可为预录视频或动态生成流;再次,推流引擎将内容实时推送至平台,推荐使用ffmpeg结合python…

    2026年9月21日 • 用户投稿
    100
  • 数据库运维开发环境的调试模式演进

    数据库运维开发环境的调试模式演进数据库运维开发环境的调试模式演进数据库运维开发环境的调试模式演进数据库运维开发环境的调试模式演进

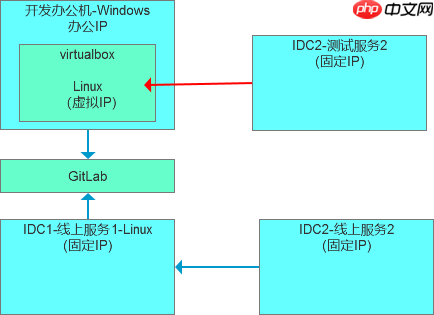
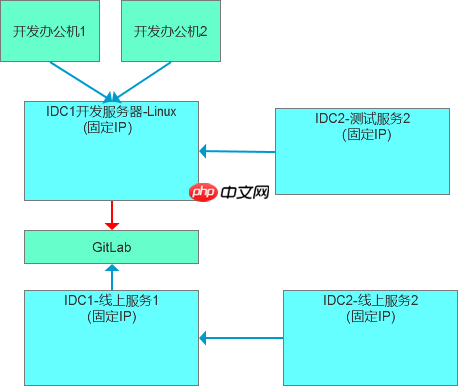
    这是学习笔记的第2393篇文章。 昨日,同事反馈了一个问题,原本的办公机环境中的虚拟机可以将办公机的IP暴露出来,提供数据库运维的API服务。例如,办公机的IP为192.168.10.100,而使用VirtualBox的虚拟机采用主机模式,其IP可能为192.168.56.100,那么192.168…

    2026年9月21日 • 用户投稿
    100
  • VSCode编写Java代码方法_VSCode搭建Java开发环境实战教程

    答案:在VSCode中配置Java开发环境需安装JDK并设置环境变量,再安装VSCode及Java扩展包,即可实现Java项目的创建、编写、运行与调试。它轻量、启动快,支持多语言和丰富扩展,集成Maven/Gradle,适合日常开发。 在VSCode里编写Java代码,说白了,就是把这个轻量级的代码…

    2026年9月21日
    100
  • VSCode的代码折叠功能好用吗?

    VSCode代码折叠功能支持多种方式:点击箭头、快捷键、命令面板及按区域类型折叠;可自定义基于缩进的折叠、默认层级和提示装饰器;集成语言服务后能智能识别JSX、Vue组件等结构,提升大型文件编辑效率。 VSCode 的代码折叠功能非常实用,尤其在处理大型文件或复杂结构时能显著提升阅读和编辑效率。 支…

    2026年9月21日
    200
  • 控制台命令(Console Command)开发

    控制台命令是程序员日常工作中不可或缺的工具,它提高了开发效率并帮助理解和控制程序运行。1) 通过简单的文本输入,完成复杂任务,如文件管理和系统监控。2) 控制台命令可用于快速调试、测试代码和自动化重复工作。3) 开发控制台命令时需注意安全性和兼容性问题。4) 控制台命令可实现有趣功能,如监控服务器资…

    2026年9月21日
    200
  • Linux文件和目录管理常见命令

    Linux文件和目录管理依赖于ls、cd、mkdir、rm、cp、mv等核心命令,用于浏览、创建、删除、复制和移动文件与目录;通过find、du、grep等命令可查找文件、定位大文件并清理磁盘空间;使用rename、mmv或脚本可实现批量重命名;为安全起见,应谨慎使用rm命令,推荐结合-i选项或使用…

    2026年9月21日
    100
  • 大数据量下的批量导入/导出优化

    在大数据环境下优化批量导入/导出的方法包括:1. 使用批处理技术分批导入/导出数据,减少系统资源压力;2. 采用数据流技术如apache kafka进行实时处理,降低内存占用;3. 利用并行处理技术分配任务到多个处理器或节点,提高处理速度;4. 通过性能监控和调优识别并解决瓶颈点,以提升整体效率。 …

    2026年9月21日
    300
  • 如何在Java中实现简单的输入输出

    使用Scanner类读取键盘输入,需导入java.util.Scanner并创建实例;2. 调用nextInt、nextLine等方法获取不同类型数据,注意nextInt不读取换行符可能导致nextLine读取空字符串;3. 推荐使用后关闭Scanner;4. 输出通过System.out.prin…

    2026年9月21日
    000
  • 如何自定义代码的格式化规则?

    自定义代码格式化规则需选择合适工具并配置文件实现统一风格。1. 根据语言选用主流工具如Prettier、Black、clang-format等;2. 在项目根目录创建对应配置文件如.prettierrc、.eslintrc.js或pyproject.toml,定义缩进、引号、行宽等规则;3. 将配置…

    2026年9月21日
    100
  • mysql如何设置自动重连

    答案:通过连接配置、连接池和应用层逻辑实现MySQL自动重连。启用MYSQL_OPT_RECONNECT选项(旧版本),推荐使用连接池如PooledDB、HikariCP并配置ping机制,应用层捕获连接异常后重试,结合指数退避策略提升稳定性。 MySQL 客户端或应用程序在连接断开后无法自动恢复,…

    2026年9月21日
    100
  • 协程调试与性能分析工具

    我们需要协程调试和性能分析工具是因为协程的异步特性使得传统工具难以应对调试和性能优化挑战。1) pycharm 适合基本调试,但处理大量协程时可能变慢。2) aiodebug 适用于检测协程问题,但会增加性能开销。3) asyncio-profiler 用于分析协程性能,但可能难以解读大量协程的结果…

    2026年9月21日
    100
  • 怎样在VSCode中快速生成注释文档?

    安装插件如Document This和Koro File Header,通过快捷键在VSCode中快速生成函数及文件注释,支持自定义模板,提升注释效率与规范性。 在 VSCode 中快速生成注释文档,主要依赖插件和快捷键配合代码语言特性来实现。不同编程语言支持方式略有差异,但核心思路是使用智能提示和…

    2026年9月21日
    200

发表回复

登录后才能评论
关注微信