Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
Scrapy CSS选择器技巧:提取未直接包裹在标签中的文本数据_创想鸟

Scrapy CSS选择器技巧:提取未直接包裹在标签中的文本数据

Scrapy CSS选择器技巧:提取未直接包裹在标签中的文本数据

本文深入探讨了如何使用scrapy的css选择器精确提取html中未直接包裹在独立标签内的文本数据,特别是当目标数据以文本节点形式存在时。通过结合`::text`伪元素、`getall()`方法以及正则表达式,我们能够有效定位并清洗出所需数值,克服了传统选择器可能遇到的挑战,确保数据抓取的准确性与鲁棒性。

在进行网页数据抓取时,我们经常会遇到目标数据并非整齐地包裹在独立的HTML标签(如、

、

)中,而是作为父元素下的一个直接文本节点存在。这种情况下,传统的CSS选择器可能难以直接定位,导致数据提取失败。本文将以一个实际案例为例,详细讲解如何利用Scrapy的CSS选择器,结合::text伪元素和getall()方法,并辅以正则表达式进行数据清洗,从而准确地提取这类数据。

理解问题场景

假设我们有以下HTML片段,目标是提取表示“卧室数量”的数字“1”:

Chambres
1

可以看到,数字“1”直接位于div.search-results-listings-list__item-description__characteristics__item标签内部,但它既不是SVG的一部分,也不是div.popover的一部分,而是一个独立的文本节点。直接使用div::text或div:contains(“Chambres”)::text等选择器可能无法直接获取到这个数字,或者获取到的是包含其他文本的混杂结果。

Scrapy选择器基础回顾

Scrapy提供了强大的选择器(Selectors)机制,支持CSS和XPath表达式来定位HTML元素。

立即学习“前端免费学习笔记(深入)”;
巧文书 巧文书

巧文书是一款AI写标书、AI写方案的产品。通过自研的先进AI大模型,精准解析招标文件,智能生成投标内容。

巧文书 61 查看详情 巧文书 response.css(‘selector’):使用CSS选择器。response.xpath(‘xpath_expression’):使用XPath表达式。.get():返回匹配到的第一个结果的字符串形式。.getall():返回匹配到的所有结果的列表形式。

解决方案:::text与getall()的组合应用

要提取上述HTML中的数字“1”,我们需要采取以下步骤:

定位包含目标文本的父元素: 我们可以通过其类名和内容来定位。div.search-results-listings-list__item-description__characteristics__item是包含目标数字的直接父元素。为了进一步精确,我们可以利用:contains(“Chambres”)伪类,确保我们选择的是包含“Chambres”(卧室)信息的那个特定div。提取所有文本节点: 使用::text伪元素可以选取指定元素下的所有直接文本节点,包括那些未被其他标签包裹的文本。使用getall()获取所有结果: 由于::text会返回父元素下的所有文本节点(包括SVG后的空白、Chambres文本以及目标数字“1”),我们需要使用getall()来获取一个包含所有这些文本的列表。识别并清洗目标数据: 在获取到的文本列表中,目标数字通常是最后一个非空且有意义的元素。通过列表索引和正则表达式,我们可以精确地提取出数值。

示例代码

import scrapyimport re# 模拟Scrapy的Selector对象,实际Scrapy项目中会是 response.css()html_content = """
Chambres
1
"""selector = scrapy.Selector(text=html_content)# 1. 使用:contains()定位父元素,并用::text获取所有文本节点bedrooms_info_list = selector.css( '.search-results-listings-list__item-description__characteristics__item:contains("Chambres") ::text').getall()print(f"原始文本列表: {bedrooms_info_list}")# 2. 提取最后一个元素,它通常包含我们需要的数字# 结果示例: ['n ', 'n', 'Chambres', 'n 1n ']# 注意:列表可能包含空白字符串或换行符raw_bedroom_string = bedrooms_info_list[-1] if bedrooms_info_list else Noneprint(f"原始卧室数量字符串: '{raw_bedroom_string}'")# 3. 使用正则表达式提取数字bedrooms = Noneif raw_bedroom_string: match = re.search(r'd+', raw_bedroom_string) if match: bedrooms = int(match.group())print(f"提取到的卧室数量: {bedrooms}")# 完整的提取函数(可在Scrapy Spider中作为辅助方法)def extract_number(value): try: if value is None: return None match = re.search(r'd+', value) return int(match.group()) if match else None except (TypeError, ValueError): return None# 在Scrapy Spider中的使用示例# class MySpider(scrapy.Spider):# name = 'my_spider'# start_urls = ['http://example.com']## def parse(self, response):# house_listings = response.css('.some-listing-selector') # 假设这里获取到列表项# for house_listing in house_listings:# bedrooms_info_list = house_listing.css(# '.search-results-listings-list__item-description__characteristics__item:contains("Chambres") ::text'# ).getall()# raw_bedroom_string = bedrooms_info_list[-1] if bedrooms_info_list else None# bedrooms = self.extract_number(raw_bedroom_string)# yield {# 'bedrooms': bedrooms# }## def extract_number(self, value):# try:# if value is None:# return None# match = re.search(r'd+', value)# return int(match.group()) if match else None# except (TypeError, ValueError):# return None

输出:

原始文本列表: ['n            ', 'n', 'Chambres', 'n            1n        ']原始卧室数量字符串: '            1        '提取到的卧室数量: 1

注意事项与最佳实践

get()与getall()的区别:get()只返回匹配到的第一个结果。在处理::text时,如果第一个文本节点不是你想要的,get()会失败。getall()返回所有匹配结果的列表,这对于处理多个文本节点的情况至关重要。::text的特性: ::text会提取元素内部的所有直接文本节点,包括换行符、空格等。因此,返回的列表可能包含多个看似空白的字符串。:contains()伪类: 这个伪类非常有用,可以帮助我们进一步缩小选择范围,确保我们选择的是包含特定文本内容的父元素,即使该文本被子元素包裹。正则表达式的重要性: 提取到的原始字符串往往包含多余的空白字符和换行符。使用re.search(r’d+’, value)可以从字符串中稳健地提取出第一个或所有数字序列。re.search比re.match更灵活,因为它不需要匹配字符串的开头。健壮性考虑: 在实际项目中,务必对可能出现的None值或空列表进行处理,以防止程序因索引错误或对空值操作而崩溃。例如,在获取bedrooms_info_list[-1]之前检查bedrooms_info_list是否为空。HTML结构变动: 网页的HTML结构可能会发生变化。定期检查选择器是否仍然有效是数据抓取项目维护的关键。

总结

通过结合Scrapy的CSS选择器、::text伪元素、getall()方法以及Python的正则表达式,我们可以高效且准确地从复杂的HTML结构中提取出未直接包裹在标签内的文本数据。这种方法尤其适用于那些以文本节点形式存在的关键信息,如本例中的卧室数量。掌握这些技巧,将大大提升Scrapy爬虫在面对多样化网页结构时的适应性和健壮性。

以上就是Scrapy CSS选择器技巧:提取未直接包裹在标签中的文本数据的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/597256.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
SQL Server在CentOS上的资源占用情况
上一篇 2025年11月10日 18:45:51
广东:打造人工智能与机器人产业创新高地
下一篇 2025年11月10日 18:45:56

相关推荐

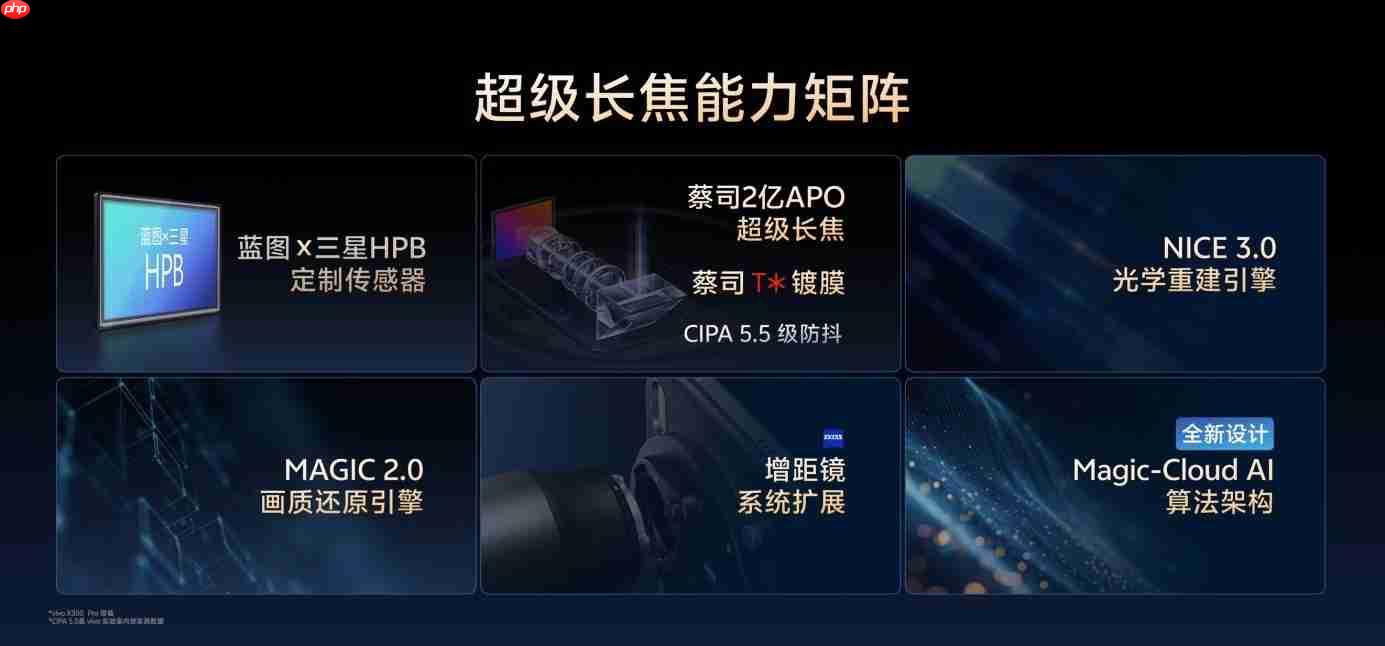
  • vivo X300系列重构移动影像体验,全链路创新开启场景化创作新时代

    vivo X300系列重构移动影像体验,全链路创新开启场景化创作新时代vivo X300系列重构移动影像体验,全链路创新开启场景化创作新时代vivo X300系列重构移动影像体验,全链路创新开启场景化创作新时代vivo X300系列重构移动影像体验,全链路创新开启场景化创作新时代

    9月26日,vivo在“x系列蓝图影像技术沟通会”上正式发布全新影像战略,提出以“场景解决方案”为核心,构建开放协同的影像生态,推动移动影像从功能性工具向文化表达载体跃迁。作为这一战略的首款实践之作,vivo x300系列通过全链路技术创新,在画质表现、极限拍摄、旅行人像及视频创作四大维度实现全面突…

    2026年9月26日 • 用户投稿
    000
  • Debian系统上Tomcat日志如何备份

    Debian系统上Tomcat日志如何备份Debian系统上Tomcat日志如何备份Debian系统上Tomcat日志如何备份Debian系统上Tomcat日志如何备份

    本文介绍几种在Debian系统上备份Tomcat日志文件的有效方法,帮助您安全地保存和管理重要的日志信息。 方法一:手动备份 找到日志文件: Tomcat日志文件通常位于 /var/log/tomcat 或 /opt/tomcat/logs 目录下。请根据您的实际安装路径进行调整。压缩日志: 使用 …

    2026年9月26日 • 用户投稿
    000
  • Debian上Tomcat日志文件过大怎么办

    Debian上Tomcat日志文件过大怎么办Debian上Tomcat日志文件过大怎么办Debian上Tomcat日志文件过大怎么办Debian上Tomcat日志文件过大怎么办

    Debian系统中Tomcat日志文件(例如catalina.out)过大,可能导致磁盘空间占用过多,影响系统性能,并增加日志管理和分析的难度。本文提供几种解决方法: 方法一:利用logrotate实现日志轮转 logrotate是Linux系统自带的日志管理工具,可自动轮转、压缩和删除日志文件。 …

    2026年9月26日 • 用户投稿
    100
  • LINUX连接不上WiFi怎么办_LINUX系统WiFi连接失败排查指南

    LINUX连接不上WiFi怎么办_LINUX系统WiFi连接失败排查指南LINUX连接不上WiFi怎么办_LINUX系统WiFi连接失败排查指南LINUX连接不上WiFi怎么办_LINUX系统WiFi连接失败排查指南LINUX连接不上WiFi怎么办_LINUX系统WiFi连接失败排查指南

    首先检查无线网卡是否被系统识别,通过lspci或lsusb命令确认硬件存在;若识别正常但无法连接,需安装对应驱动如firmware-iwlwifi或rtl88x2bu-dkms;确保NetworkManager服务已启动并启用;使用nmcli命令扫描并连接WiFi网络;若仍失败,可手动编辑Netpl…

    2026年9月26日 • 用户投稿
    400
  • Java 方法中数组参数的正确调用方式

    Java 方法中数组参数的正确调用方式Java 方法中数组参数的正确调用方式Java 方法中数组参数的正确调用方式Java 方法中数组参数的正确调用方式

    本文旨在阐述如何在 Java 方法中正确传递和使用数组参数。通过一个实际的例子,我们将详细讲解如何创建数组、将其作为参数传递给方法,以及如何在方法内部访问和操作数组元素。掌握这些技巧对于编写高效且易于维护的 Java 代码至关重要。 在 Java 编程中,方法经常需要接收数组作为参数,以便对一组数据…

    2026年9月26日 • 用户投稿
    000
  • 从Scanner读取单个字符时处理空格的问题

    从Scanner读取单个字符时处理空格的问题从Scanner读取单个字符时处理空格的问题从Scanner读取单个字符时处理空格的问题从Scanner读取单个字符时处理空格的问题

    本文旨在解决Java中使用Scanner读取用户输入时,由于Scanner默认以空格作为分隔符,导致读取单个字符时出现的问题。我们将深入探讨Scanner的工作原理,并提供使用Scanner.nextLine()方法读取整行输入来解决此问题的方案,确保程序能够正确处理包含空格的输入。 在使用Java…

    2026年9月26日 • 用户投稿
    100
  • grokAI平台官方网站主页 grokAI 智能助手入口官方直达地址

    GrokAI平台官方网站主页是https://grok.com/,用户可直接访问该网址进入。新用户无需注册即可点击“Start Chatting”体验基础功能,登录X账号则可使用高级服务。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ Gr…

    2026年9月26日
    100
  • Z790主板比B760主板强在哪里?

    Z790主板相比B760在超频支持、供电能力与扩展性上更强。1. Z790支持带“K”后缀CPU超频,B760不支持;2. Z790供电模组更豪华,散热设计更强,可应对高功耗CPU长时间满载;3. Z790拥有8条DMI通道,扩展接口更丰富,支持更多高速设备;4. Z790对高频内存支持更好,内存超…

    2026年9月26日
    100
  • 从 0 开始学 V8 漏洞利用之 V8 通用利用链(二)

    作者:hcamael@知道创宇404实验室 相关阅读:从 0 开始学 V8 漏洞利用之环境搭建(一)经过一段时间的研究,先进行一波总结,不过因为刚开始研究没多久,也许有一些局限性,以后如果发现了,再进行修正。 概述 ‍我认为,在搞漏洞利用前都得明确目标。比如打CTF做二进制的题目,大部分情况下,目标…

    2026年9月26日
    100
  • 强!荣耀 Magic V5 官宣搭载 6100mAh 青海湖刀片电池

    强!荣耀 Magic V5 官宣搭载 6100mAh 青海湖刀片电池强!荣耀 Magic V5 官宣搭载 6100mAh 青海湖刀片电池强!荣耀 Magic V5 官宣搭载 6100mAh 青海湖刀片电池强!荣耀 Magic V5 官宣搭载 6100mAh 青海湖刀片电池

    官方消息透露,7 月 2 日晚 19:00,荣耀将召开 magic v5 及 ai 终端生态发布会。届时,荣耀 magic v5 等多款旗舰新品将同步登场。早在 6 月 25 日,荣耀就已为 magic v5 开启预热宣传。据 cnmo 掌握的信息,这款折叠屏手机搭载了容量高达 6100mah 的青…

    2026年9月26日 • 用户投稿
    100
  • sublime怎么解决mac上无法使用命令行subl的问题_sublime Mac命令行Subl问题解决

    sublime怎么解决mac上无法使用命令行subl的问题_sublime Mac命令行Subl问题解决sublime怎么解决mac上无法使用命令行subl的问题_sublime Mac命令行Subl问题解决sublime怎么解决mac上无法使用命令行subl的问题_sublime Mac命令行Subl问题解决sublime怎么解决mac上无法使用命令行subl的问题_sublime Mac命令行Subl问题解决

    首先确认Sublime Text已安装在/Applications/Sublime Text.app,然后通过sudo ln -s /Applications/Sublime Text.app/Contents/SharedSupport/bin/subl /usr/local/bin/subl创建…

    2026年9月26日 • 用户投稿
    100
  • 伊津野英昭腾讯原创3A新情报:融合鬼泣、龙信精华!

    伊津野英昭腾讯原创3A新情报:融合鬼泣、龙信精华!伊津野英昭腾讯原创3A新情报:融合鬼泣、龙信精华!伊津野英昭腾讯原创3A新情报:融合鬼泣、龙信精华!伊津野英昭腾讯原创3A新情报:融合鬼泣、龙信精华!

    据automatonmedia报道,《鬼泣》系列总监、《龙之信条》系列主导者伊津野英昭近日在接受《fami通》采访时,分享了他离开卡普空后首个新项目的最新进展。 伊津野在卡普空工作长达30年,于2024年8月正式离职,并加入腾讯,出任光子工作室日本分部负责人。他目前正在主导开发的首款作品,是一款面向…

    2026年9月26日 • 用户投稿
    000
  • debian邮件服务器如何实现自动回复

    debian邮件服务器如何实现自动回复debian邮件服务器如何实现自动回复debian邮件服务器如何实现自动回复debian邮件服务器如何实现自动回复

    在debian系统搭建自动回复邮件服务器,只需简单几步即可实现。本文将指导您配置postfix邮件服务器,实现自动回复功能。 一、安装Postfix 首先,确认Debian系统已安装Postfix。若未安装,请执行以下命令: sudo apt updatesudo apt install postf…

    2026年9月26日 • 用户投稿
    300
  • ️「SpringBoot3.2深度探索」WebFlux性能优化与RSocket集成指南

    ️「SpringBoot3.2深度探索」WebFlux性能优化与RSocket集成指南️「SpringBoot3.2深度探索」WebFlux性能优化与RSocket集成指南️「SpringBoot3.2深度探索」WebFlux性能优化与RSocket集成指南️「SpringBoot3.2深度探索」WebFlux性能优化与RSocket集成指南

    Spring Boot 3.2通过升级底层依赖、增强GraalVM Native Image支持、深化Micrometer Tracing集成及引入Project Loom虚拟线程,优化WebFlux性能;同时通过spring-boot-starter-rsocket简化RSocket集成,实现高效…

    2026年9月26日 • 用户投稿
    000
  • 多模态与单模态效果有何差异 实际应用中两种模型的优劣比较

    多模态与单模态效果有何差异 实际应用中两种模型的优劣比较多模态与单模态效果有何差异 实际应用中两种模型的优劣比较多模态与单模态效果有何差异 实际应用中两种模型的优劣比较多模态与单模态效果有何差异 实际应用中两种模型的优劣比较

    本文将围绕多模态与单模态模型的差异展开叙述,旨在阐明两者在实际应用中的具体效果与优劣。文章会首先解析两种模型的基本概念,然后通过对比它们在处理信息、应对复杂任务等方面的能力,讲解其核心区别。最后,会提供一个基于应用场景的选择思路,帮助您理解如何根据具体需求来判断哪种模型更为适用。 ☞☞☞AI 智能聊…

    2026年9月26日 • 用户投稿
    100
  • 使用构造器注入替代 @Autowired 注解

    使用构造器注入替代 @Autowired 注解使用构造器注入替代 @Autowired 注解使用构造器注入替代 @Autowired 注解使用构造器注入替代 @Autowired 注解

    本文旨在讲解如何使用构造器注入来替代 Spring 框架中的 @Autowired 注解,从而实现更简洁、更易于测试的代码。我们将通过一个实际案例,展示如何利用 Lombok 提供的 @AllArgsConstructor 注解简化构造器注入的过程,并解决可能遇到的问题,最终避免手动创建 Bean。…

    2026年9月26日 • 用户投稿
    100
  • sublime怎么配置python开发环境_sublime搭建Python开发环境教程

    sublime怎么配置python开发环境_sublime搭建Python开发环境教程sublime怎么配置python开发环境_sublime搭建Python开发环境教程sublime怎么配置python开发环境_sublime搭建Python开发环境教程sublime怎么配置python开发环境_sublime搭建Python开发环境教程

    首先安装Sublime Text并配置Package Control,接着安装Anaconda等插件以实现代码补全与检查,然后设置Python编译系统运行脚本,最后通过代码格式化、多光标编辑等功能提升开发效率。 Sublime Text 是一款轻量级但功能强大的代码编辑器,适合快速编写和调试 Pyt…

    2026年9月26日 • 用户投稿
    100
  • 华为开发者大会曝光《王者荣耀》新英雄:孙权即将上线

    华为开发者大会曝光《王者荣耀》新英雄:孙权即将上线华为开发者大会曝光《王者荣耀》新英雄:孙权即将上线华为开发者大会曝光《王者荣耀》新英雄:孙权即将上线华为开发者大会曝光《王者荣耀》新英雄:孙权即将上线

    在 6 月 20 日举行的华为开发者大会 2025(hdc2025)上,华为与《王者荣耀》联合发布了一系列令人振奋的消息,其中最受关注的亮点之一便是全新英雄孙权即将上线。 华为常务董事、终端 BG 董事长余承东在大会上正式宣布 HarmonyOS 6 已面向开发者开放 Beta 版。作为新一代操作系…

    2026年9月26日 • 用户投稿
    000
  • 如何通过豆包AI进行异常检测?离群值分析实战

    如何通过豆包AI进行异常检测?离群值分析实战如何通过豆包AI进行异常检测?离群值分析实战如何通过豆包AI进行异常检测?离群值分析实战如何通过豆包AI进行异常检测?离群值分析实战

    异常检测是识别数据集中不符合预期模式的数据点的过程,这些“异常”可能由错误、欺诈、设备故障等引起,在金融、网络安全、制造质量控制等领域具有重要意义。常见方法包括基于统计的z-score、iqr法;基于距离的knn;孤立森林;one-class svm;以及深度学习中的自编码器。其中孤立森林因高效性和…

    2026年9月26日 • 用户投稿
    100
  • 俄罗斯yandex主页手机版入口 yandex入口引擎无需登录手机链接

    俄罗斯yandex主页手机版入口 yandex入口引擎无需登录手机链接俄罗斯yandex主页手机版入口 yandex入口引擎无需登录手机链接俄罗斯yandex主页手机版入口 yandex入口引擎无需登录手机链接俄罗斯yandex主页手机版入口 yandex入口引擎无需登录手机链接

    Yandex,作为俄罗斯本土最大的互联网公司,其搜索引擎在全球范围内享有盛誉,尤其在俄语市场占据绝对主导地位。其精心优化的手机版主页入口,旨在为全球移动用户提供极致便捷的上网体验,让用户无论身处何地,都能通过无需登录的快速链接,瞬时直达其功能异常丰富的综合性平台。 一、正确的官网地址 要直接进入俄罗…

    2026年9月26日 • 用户投稿
    000

发表回复

登录后才能评论
关注微信