在程序代码中,0.1 + 0.2 的计算结果不等于0.3,这一看似违反数学常识的现象,其根源在于现代计算机普遍采用的、基于“二进制”的浮点数存储与运算法则,无法精确地表示某些十进制小数。这个问题的产生,主要涉及五个核心环节:源于计算机“二进制”的存储特性、十进制小数在转换为二进制时产生的“无限循环”、遵守“IEEE 754”标准所带来的“精度限制”、浮点数运算过程中的“舍入误差”累积、以及计算机“有限”内存无法精确表达“无限”小数的根本矛盾。
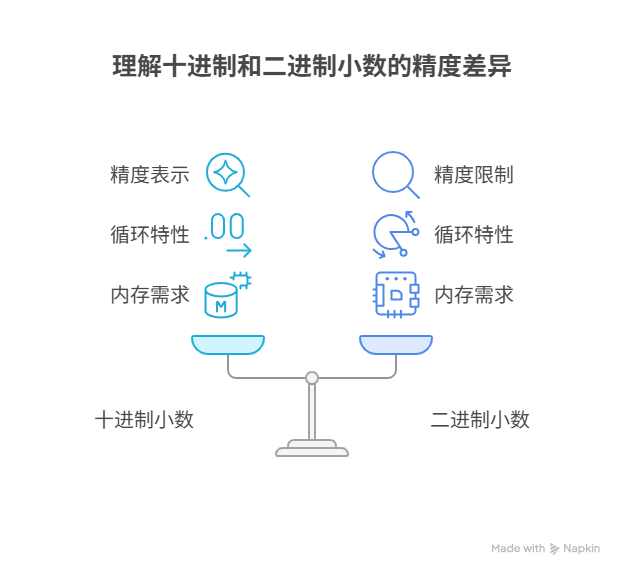
具体来说,就像十进制无法精确表示分数1/3(会产生0.333...的无限循环小数)一样,十进制的0.1和0.2,在被转换为二进制时,也会变成一个无限循环的二进制小数。计算机的内存是有限的,它只能截取并存储一个与真实值极其接近的“近似值”。当这两个“近似值”进行相加时,其最终结果,自然也只是一个与0.3的精确二进制表示,存在微小差异的“近似值”,从而导致了0.1 + 0.2不等于0.3这一令人困惑的结果。
一、问题的“表象”:一个“违反”数学直觉的结果
对于任何一个有基础数学常识的人来说,0.1 + 0.2 = 0.3 是一条颠扑不破的真理。然而,当我们将这个简单的表达式,交给计算机去执行时,却常常会得到一个“离经叛道”的结果。
例如,在被广泛使用的JavaScript语言中,如果你在浏览器的控制台中,输入 0.1 + 0.2,你将看到的结果,并非是0.3,而是一个令人费解的数字:0.30000000000000004。 同样地,在Python、Java、C++等众多主流编程语言中,你都会遇到同样的问题。
我们必须首先明确一点:这并非某个特定编程语言的“缺陷”或“漏洞”。恰恰相反,这正是它们严格遵守了全球统一的、现代计算机硬件进行浮点数运算的“国际标准”——即“IEEE 754”标准——所必然导致的结果。
要理解这个看似“反直觉”的现象,我们不能再用人类的、习惯于“十进制”的、抽象的数学思维去看待它,而必须深入到计算机的“内心世界”,去了解它是如何用“二进制”的、具体的方式,来“存储”和“计算”小数的。
正如计算机科学巨匠高德纳(Donald Knuth)的名言所警示的:“要警惕上述代码中的错误;我只是证明了它是正确的,而没有真正地运行过它。” 这句话,以一种幽默的方式,揭示了“理论上的数学正确”与“物理世界中的计算机实现”之间,常常存在着微妙而关键的鸿沟。
二、根本原因:十进制小数的“二进制转换”之痛
问题的最根本原因,在于我们熟悉的“十进制”小数,与计算机所能理解的“二进制”小数之间,存在一个“转换鸿沟”。
1. 一个简单的类比:十进制下的1/3 在我们的十进制世界里,我们可以轻松地表示 1/2 = 0.5,1/4 = 0.25,1/5 = 0.2。但是,当我们试图去表示 1/3 时,就会遇到一个问题:它等于 0.333333...,一个拥有无限循环小数部分的数字。我们永远无法,在一张有限的纸上,写下1/3的“精确”的十进制小数值,我们能写的,只是一个“近似值”。
2. 小数的二进制转换 计算机,也面临着同样的问题,只不过,它的“语言”,是只有0和1的二进制。 将一个十进制小数,转换为二进制小数,其基本算法是“乘2取整,顺序排列”。
让我们先来看一个“幸运”的例子:0.5
0.5 * 2 = 1.0 -> 取整数部分 1,小数部分变为 0。
因为小数部分已为0,转换结束。
所以,十进制的0.5,其精确的二进制表示,就是 0.1。这是一个有限的二进制小数。
现在,让我们来看那个“不幸”的主角:0.1
0.1 * 2 = 0.2 -> 取整数部分 0,小数部分 0.2。
0.2 * 2 = 0.4 -> 取整数部分 0,小数部分 0.4。
0.4 * 2 = 0.8 -> 取整数部分 0,小数部分 0.8。
0.8 * 2 = 1.6 -> 取整数部分 1,小数部分 0.6。
0.6 * 2 = 1.2 -> 取整数部分 1,小数部分 0.2。
0.2 * 2 = 0.4 -> 取整数部分 0,小数部分 0.4。 ……
3. 揭示“无限循环” 我们发现,在第五步之后,小数部分,又变回了0.2,与第二步完全相同。这意味着,接下来的计算,将陷入一个0.2 -> 0.4 -> 0.8 -> 0.6 -> 0.2的无限循环之中。 因此,十进制的0.1,其二进制的表示,是 0.0001100110011...,其中 0011 会无限地循环下去。
结论:就像1/3在十进制中无法被精确表示一样,0.1在二进制中,也无法被精确表示。计算机,从一开始,就无法“得知”0.1的真实值,它所能做的,只是存储一个与它极其接近的“近似值”。同理,0.2也是如此。
三、实现机制:IEEE 754“浮点数”标准
那么,计算机,具体是“如何”存储这个“近似值”的呢?这就要提到那个统治着所有现代计算机浮点运算的“IEEE 754”标准。
1. 有限的“存储空间” 在JavaScript等现代语言中,我们通常使用的小数,都遵循该标准的“双精度浮点数”格式。这意味着,每一个小数,都必须被存储在一个固定长度为64个比特位的内存空间里。
2. 科学记数法的启示 为了能在有限的空间内,表示尽可能大范围、高精度的数字,IEEE 754标准,借鉴了我们熟悉的“科学记数法”的思想。它将这64个比特位,划分为三个部分:
符号位(1位):用于表示这个数是正数还是负数。
指数位(11位):用于存储一个指数,决定了小数点应该“浮动”到哪个位置。
尾数位(52位):用于存储这个数的、最核心的、有效的二进制数字。
3. “截断”与“舍入”的必然 现在,问题来了。我们已经知道,0.1的二进制表示,是0.0001100110011...,它是一个无限长的序列。而我们的“尾数位”,只有区区52位的空间。 因此,计算机,必须,且只能,将这个无限长的序列,进行“截断”,只保留其前52位有效的数字。在截断时,为了尽可能地提高精度,IEEE 754标准,还规定了一套类似“四舍五入”的“舍入”规则(最常见的是“向最近的偶数舍入”)。
4. 最终的结果 经过这套复杂的“十进制 -> 无限二进制 -> 截断与舍入 -> 存入64位内存”的过程之后:
我们代码中的0.1,在内存中,实际存储的,是一个极其接近,但略大于0.1的二进制近似值。
我们代码中的0.2,在内存中,实际存储的,是一个极其接近,但略小于0.2的二进制近似值。
当这两个本就存在微小“误差”的近似值,再通过中央处理器的浮点数加法器,进行一次同样存在“舍入误差”的二进制运算后,其最终得到的结果,自然,也就不再是0.3的那个精确的二进制表示,而是一个我们看到的、带有...00004尾巴的、另一个“近似值”了。
四、实践中的“连锁反应”
理解了这个底层原理后,我们就能明白,在实际的业务开发中,由浮点数精度问题,所引发的、各种各样的“连锁反应”。
金融计算的“灾难”:在任何涉及到“金钱”的计算中,直接使用浮点数,都是绝对不被允许的、极其危险的行为。JavaScriptlet price = 10.10; let tax = 0.05; let total = price * (1 + tax); // 理论上应为 10.605 // 因为浮点数误差,结果可能是 10.605000000000001 // 如果后续有 `if (total == 10.605)` 这样的判断,将永远为假。
循环中的“累积误差”:JavaScriptlet sum = 0; for (let i = 0; i < 10; i++) { sum += 0.1; } // 理论上,sum应为1.0 // 实际结果是 0.9999999999999999 每一次的加法,都会引入一点点微小的误差,在10次循环后,这个误差,被累积和放大了。
五、如何“驯服”浮点数:解决方案
既然浮点数的精度问题,是计算机硬件层面的“天性”,那么,我们在软件层面,就必须学会如何去“驯服”它。
1. 方案一:设定“精度阈值”进行比较 永远不要,使用 == 或 ===,来直接比较两个浮点数是否相等。正确的做法,是比较它们的“差值”,是否小于一个我们能接受的、极小的“精度阈值”。
代码示例:JavaScriptlet a = 0.1 + 0.2; let b = 0.3; const EPSILON = 1e-10; // 定义一个极小值,作为精度容忍度 if (Math.abs(a - b) < EPSILON) { console.log("a和b在我们的精度要求内,是相等的。"); }
2. 方案二:转化为“整数”进行计算(金融计算首选) 这是在进行任何与“金钱”相关的、要求“绝对精确”的计算时,业界公认的最佳实践。其核心思想,是通过“单位换算”,完全地,避开小数的运算。
流程:
确定精度:首先,确定你的业务,需要精确到小数点后几位(例如,对于人民币“元”,需要精确到“分”,即2位小数)。
乘以倍数:在进行任何计算之前,将所有涉及的金额,都乘以一个相应的倍数(如100),将其,从“元”,全部转化为“分”,即,从“浮点数”,转化为“整数”。
整数运算:所有的加、减、乘、除,都在“分”这个“整数”的世界里进行。
除以倍数:只在最终,需要向用户“展示”结果时,才将计算完成的“分”,除以100,并格式化为“元”的字符串。
示例:JavaScriptlet priceInCents = 1010; // 10.10元 let quantity = 3; let totalInCents = priceInCents * quantity; // 结果是精确的整数 3030 // 展示时 console.log("总金额为: " + (totalInCents / 100).toFixed(2) + " 元");
3. 方案三:使用“高精度”计算库 对于更复杂的、需要超出常规整数范围的、高精度的科学或金融计算,可以引入专门的“高精度”计算库。
例如,在Java中,有内置的BigDecimal类;在JavaScript中,有Decimal.js或BigNumber.js等广受欢迎的第三方库。
这些库的原理,是不再使用硬件原生的、基于二进制的浮点数表示法,而是在内存中,以“字符串”或“十进制数组”的形式,来存储数字,然后,通过软件算法,来模拟和实现高精度的“十进制”算术运算。它们的性能,会比原生运算慢,但却能保证结果的“绝对精确”。
六、在流程与规范中“防范”
最后,除了技术手段,还需要在团队的流程和规范中,建立起对“浮点数精度”问题的“防范”机制。
建立团队编码规范:团队的《编码规范》中,必须有专门的章节,明确规定:“在处理任何与金融相关的计算时,严禁直接使用浮点数类型,必须采用‘转为整数’或‘使用高精度库’的方案。” 这份规范,可以被沉淀在像 Worktile 或 PingCode 的知识库中,作为所有成员都可随时查阅的标准。代码审查:在进行代码审查时,对所有涉及浮点数的、特别是“比较”和“累加”操作的代码,都应保持高度的警惕。单元测试:必须为所有涉及浮点数计算的核心逻辑,都编写专门的单元测试。在测试中,对浮点数的断言,也必须使用“精度阈值”的方式来进行,而非直接的相等比较。
常见问答 (FAQ)
Q1: 这个问题是只在JavaScript中存在,还是所有语言都有?
A1: 几乎所有,采用了IEEE 754浮点数标准的现代编程语言,都存在这个问题,包括Java, C++, C#, Python, Ruby, Go等。这并非某个语言的缺陷,而是现代计算机硬件的通用实现方式所决定的。
Q2: 为什么 0.5 + 0.25 的结果就是准确的 0.75 呢?
A2: 这是一个“巧合”。因为0.5, 0.25和0.75这几个数,恰好,都能被二进制,进行有限位的、精确的表示(0.5是0.1,0.25是0.01,0.75是0.11)。因为在转换过程中,没有产生“无限循环”,所以,也就没有“舍入误差”的引入。
Q3: 在处理金额时,我应该总是使用高精度库吗?
A3: 不一定。如果你的业务场景,所涉及的金额,其精度要求,和数值范围,都在常规的“长整型”所能表示的范围之内(例如,将所有金额,都乘以100或10000后,不会溢出),那么,“转化为整数进行计算”的方案,因为其性能更高、且无需引入外部依赖,通常是更简单、也更推荐的最佳实践。
Q4: 计算机硬件本身,能解决这个问题吗?
A4: 计算机硬件(中央处理器)的浮点数处理单元,正是IEEE 754标准的“执行者”,所以问题根源就在于此。要解决它,就需要采用不同的“数据表示法”,例如,一些专用的金融或科学计算硬件,可能会内置对“十进制浮点数”的硬件支持,但这在通用的中央处理器中,并非主流。
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:百晓生,转转请注明出处:https://www.chuangxiangniao.com/p/639600.html
 微信扫一扫
 支付宝扫一扫