volcano v1.13 版本正式发布。本次更新在多方面进行了功能增强,为用户提供更完善的云原生批量计算解决方案。
新版本主要亮点包括:新增对大模型推理LWS的支持;新增定时任务管理能力;提供更灵活的网络拓扑发现机制,并增强对主流AI计算框架的兼容性。同时在混部架构上实现了重要改进,提升了在不同环境中的部署灵活性。这些增强功能共同提升了Volcano在复杂工作负载管理中的实用性和易用性,旨在打造更高效、更稳定的大规模计算平台,为AI时代的基础设施提供关键调度支撑。
大模型推理场景支持 LeaderWorkerSet
LeaderWorkerSet (LWS) 是一个用于在 Kubernetes 上部署一组 Pod 的 API。它主要用于解决 AI/ML 推理工作负载中的多主机推理,尤其是需要将大型语言模型(LLM)分片并跨多个节点上的多个设备运行的场景。
Volcano自开源以来,积极与上下游生态进行集成,构建了完善的AI、大数据等批量计算社区生态,LWS在 v0.7[4]的版本中,原生集成了Volcano的AI调度能力,配合Volcano的新版本,用户在使用LWS时,可自动创建PodGroup,由Volcano进行Pod的调度与资源管理,从而实现了大模型推理场景下的Gang调度等高阶能力。
展望未来,Volcano 将继续扩展其生态系统集成能力,为更多致力于在 Kubernetes 上实现分布式推理的项目提供强大的调度和资源管理支持。
新增 Cron Volcano Job
该版本引入了对 Cron Volcano Job 的支持,用户可以像使用原生 Kubernetes CronJob 一样,按预定的时间计划(schedule)来周期性地创建和运行 Volcano Job,以实现周期性运行AI、大数据等批量计算任务。详细功能如下:
定时调度:通过标准的 Cron 表达式(spec.schedule)定义作业的执行周期。
时区支持:支持在 spec.timeZone 中设置时区,以确保作业在预期的本地时间执行。
并发策略:通过 spec.concurrencyPolicy 控制并发行为:
AllowConcurrent:允许并发运行多个作业(默认)。
ForbidConcurrent:如果前一个作业尚未完成,则跳过本次调度。
ReplaceConcurrent:如果前一个作业仍在运行,则终止它并启动新的作业。
历史记录管理:可配置保留成功(successfulJobsHistoryLimit)和失败(failedJobsHistoryLimit)的作业历史记录数量,自动清理旧的作业。
错过调度处理:通过 startingDeadlineSeconds 字段,可以容忍一定时间内的调度延迟,超时则视为错过执行。
状态追踪:CronJob 的状态(status)会追踪当前活跃的作业、上一次调度时间以及上一次成功完成的时间,便于监控和管理。
支持基于 Label 的 HyperNode 自动发现机制
Volcano 在 v1.12 版本中正式推出了网络拓扑感知调度能力,并率先实现了基于 InfiniBand (IB) 网络的 UFM 自动发现机制。然而,对于不支持 IB 网络或采用其他网络架构的硬件集群(如以太网),手动维护网络拓扑结构依然繁琐。
为解决这一问题,新版本引入了基于节点标签(Label)的 HyperNode 自动发现机制。该功能为用户提供了一种通用且灵活的方式来描述网络拓扑,将复杂的拓扑管理工作转变为简单的节点标签管理。
该机制允许用户在 volcano-controller-configmap 中定义拓扑层级与节点标签的对应关系。Volcano 控制器会周期性地扫描集群中的所有节点,并根据其标签自动完成以下工作:
自动构建拓扑:根据节点上的一组标签,从上至下(例如:机架 -> 交换机 -> 节点)自动构建出多层 HyperNode 拓扑结构。
动态维护:当节点的标签发生变化,或节点被添加、移除时,控制器会自动更新 HyperNode 的成员和结构,确保拓扑信息始终与集群状态保持一致。
支持多种拓扑类型:允许用户同时定义多种独立的网络拓扑,以适应不同的硬件集群(如 GPU 集群、NPU 集群等)或不同的网络分区。
配置示例:
# volcano-controller-configmap.yamlapiVersion: v1kind: ConfigMapmetadata: name: volcano-controller-configmap namespace: volcano-systemdata: volcano-controller.conf: | networkTopologyDiscovery: - source: label enabled: true interval: 10m # 发现周期 config: networkTopologyTypes: # 定义一个名为 topology-A 的拓扑类型 topology-A: # 定义拓扑层级,顺序从上到下 - nodeLabel: "volcano.sh/hypercluster"# 顶层 HyperNode - nodeLabel: "volcano.sh/hypernode" # 中间层 HyperNode - nodeLabel: "kubernetes.io/hostname"# 底层物理节点
通过在 Volcano 控制器的 ConfigMap 中添加 label 源即可启用此功能。以下配置定义了一个名为 topology-A 的三层拓扑结构:
顶层 (Tier 2) :由 volcano.sh/hypercluster 标签定义。
中间层 (Tier 1) :由 volcano.sh/hypernode 标签定义。
底层 :物理节点,由 Kubernetes 内置的 kubernetes.io/hostname 标签标识。
当一个节点被打上如下标签时,它将被自动识别并归入 cluster-s4 -> node-group-s0 的拓扑路径下:
# 节点 node-0 的标签labels: kubernetes.io/hostname: node-0 volcano.sh/hypernode: node-group-s0 volcano.sh/hypercluster: cluster-s4
基于label的网络拓扑自动发现功能具有出色的通用性与灵活性,不依赖于特定的网络硬件(如 IB),因此适用于各类异构集群,并允许用户通过标签灵活定义任意深度的层级结构。它将复杂的拓扑维护工作转变为简单的节点标签管理,实现了自动化,从而显著降低运维成本和出错风险。此外,该机制能够动态适应集群节点和标签的变化,无需人工干预即可实时保持拓扑信息的准确性。
原生支持 Ray 框架
Ray是一个开源的统一分布式计算框架,其核心目标是简化从单机到大规模集群的并行计算,特别适合扩展Python和AI应用。为了在Kubernetes上管理和运行Ray,社区提供了KubeRay——一个专为Kubernetes设计的Operator,它充当了Kubernetes和Ray框架之间的桥梁,极大地简化了Ray集群和作业的部署与管理。
一直以来,在Kubernetes上运行Ray工作负载主要依赖于KubeRay Operator,同时Kuberay在v0.4.0 (2022年release) 版本已经集成了Volcano来进行Ray Cluster的调度和资源管理,以解决分布式训练场景的资源死锁等问题。现在,通过新版本的Volcano,用户可以直接通过原生Volcano Job来创建和管理Ray集群,并提交计算任务。这为Ray用户提供了另一种使用方案,可以更直接地使用Volcano的Gang Scheduling、队列管理与公平调度、作业生命周期管理等能力来运行Ray工作负载。
新增 HCCL 插件支持
新版本在Volcano Job中增加了分布式AI训练场景需要的HCCL Rank 插件(hcclrank),用于在分布式任务中自动为 Pod 分配 HCCL Rank。具体包括:
新增 Volcano Job的hcclrank 插件实现,支持通过任务类型(master/worker)和索引自动计算并注入 HCCL Rank 到 Pod 注解。
插件支持自定义 master/worker 任务名,用户可以指定分布式任务的master/worker角色。
该功能提升了 Volcano 在华为昇腾等 HCCL 通信场景下的原生支持,方便用户在 AI 训练任务中自动管理和分配 Rank。
增强 NodeGroup 功能
在层级队列结构中,为每个子队列重复配置与其父队列相同的节点组亲和性(nodeGroupAffinity)会导致配置冗余且难以维护。
为解决此问题,Nodegroup 插件新增了对层级队列亲和性的继承支持。启用后,调度器将遵循以下规则解析队列的有效亲和性:
优先自身配置:若队列已定义 spec.affinity,则直接使用该配置。
向上继承:若队列未定义 spec.affinity,则沿其父级向上查找,并继承最近的祖先队列所定义的亲和性配置。
覆盖能力:子队列可通过定义自身的 spec.affinity 来覆盖继承的配置,保证了灵活性。
此功能允许管理员在父队列(如部门级别)设置统一的节点组亲和性,其下的所有子队列(如团队级别)将自动继承该设置,从而简化了管理。
同时对于未设置NodeAffinity的队列,用户可以在插件配置中设置”strict”参数来决定调度行为。当 strict 为 true(默认值)时,这些队列的任务将无法被调度到任何节点上。当 strict 设置为 false 时,这些任务则被允许调度到未设置 “volcano.sh/nodegroup-name” 标签的普通节点上。
在调度配置文件的 nodegroup 插件参数中,设置 enableHierarchy: true可开启层级队列模式,设置strict为false可设置non-strict模式,示例配置如下:
actions: "allocate, backfill, preempt, reclaim"tiers:- plugins: - name: nodegroup enableHierarchy: true# 启用层级队列 arguments: strict: false# 设置为non-strict模式,队列内任务可以被调度到不包含"volcano.sh/nodegroup-name"标签的节点上
新增 ResourceStrategyFit 插件
在 Kubernetes 原生的 noderesources 调度策略中,只能对所有资源应用单一的聚合(MostAllocated)或分散(LeastAllocated)策略。这在复杂的异构计算环境(如 AI/ML 集群)中存在局限性。为了满足差异化调度需求,Volcano 增强提出了 ResourceStrategyFit 插件,以应对更加复杂的场景。
该插件现在集成了两大核心功能:按资源类型配置独立策略以及稀缺资源规避(SRA)。
按资源类型的独立打分策略
此功能允许用户为不同的资源(如 cpu, memory, nvidia.com/gpu)分别指定 MostAllocated(聚合)或 LeastAllocated(分散)策略,并为其分配不同权重。调度器会根据每个资源的独立配置精细化计算节点得分。
为了简化对同一系列资源(如来自同一供应商的不同型号 GPU)的管理,该功能还支持资源名称的后缀通配符(*)匹配。
语法规则:仅支持后缀通配符,例如 nvidia.com/gpu/*。诸如 vendor./gpu 等模式将被视为无效。
匹配优先级:采用“最长前缀匹配”原则。精确匹配的优先级最高;当没有精确匹配时,将选择前缀最长的通配符模式。
配置示例: 以下配置为特定型号的 V100 GPU 设置了高优先级的聚合策略,为所有其他 NVIDIA GPU 设置了通用的聚合策略,同时为 CPU 资源配置了分散策略。
actions: "enqueue, allocate, backfill, reclaim, preempt"tiers:- plugins: - name: resource-strategy-fit arguments: resourceStrategyFitWeight: 10 resources: # 精确匹配,最高优先级 nvidia.com/gpu-v100: type: MostAllocated weight: 3 # 通配符匹配,适用于其他所有 NVIDIA GPU nvidia.com/gpu/*: type: MostAllocated weight: 2 # 精确匹配,用于 CPU 资源 cpu: type: LeastAllocated weight: 1
同时ResourceStrategyFit 插件也支持设置Pod粒度的资源打分策略。主要通过以下两个注解进行设置:
volcano.sh/resource-strategy-scoring-type: 指定该 Pod 的资源调度策略,可选值为 “LeastAllocated”(优先调度到资源使用率最低的节点)或 “MostAllocated”(优先调度到资源使用率最高的节点)。
volcano.sh/resource-strategy-weight: 以 JSON 格式为不同的资源(如 CPU、内存、GPU 等)设置自定义的调度权重,以影响最终的节点评分。
以下示例展示了如何为一个 Volcano Job 配置 Pod 粒度的资源调度策略:
apiVersion: batch.volcano.sh/v1alpha1kind: Jobmetadata: name: resource-strategy-jobspec: minAvailable: 2 schedulerName: volcano tasks: - replicas: 2 name: worker template: metadata: annotations: # 为该任务的 Pod 设置调度策略为 LeastAllocated volcano.sh/resource-strategy-scoring-type: "LeastAllocated" # 为 CPU 和内存资源设置不同的调度权重 volcano.sh/resource-strategy-weight: '{"cpu": 2, "memory": 1}' spec: containers: - name: worker image: my-worker:latest resources: requests: cpu: "2" memory: "4Gi" limits: cpu: "2" memory: "4Gi" restartPolicy: Never
在这个例子中,worker 任务下的所有 Pod 在调度时将遵循 LeastAllocated 策略。在计算节点分数时,CPU 的权重是 2,内存的权重是 1。这意味着调度器会更倾向于将 Pod 调度到 CPU 和内存空闲资源(根据权重加权后)更多的节点上。
稀缺资源规避(Scarce Resource Avoidance, SRA)
SRA 是一项“软”策略,旨在提高昂贵或稀缺资源(如 GPU)的整体利用率。它通过影响节点评分,引导那些不需要特定稀缺资源的普通任务(如纯 CPU 任务)尽量避开包含这些资源的节点。这样可以将稀缺资源节点“预留”给真正需要它们的任务,从而减少资源竞争和任务等待时间。
工作机制:
1. 用户在配置中定义一组“稀缺资源”(如 nvidia.com/gpu)。
2. 当调度一个不请求任何已定义稀缺资源的 Pod 时,SRA 策略会生效。
3. 调度器会降低那些拥有这些稀缺资源的节点的得分。节点上存在的稀缺资源种类越多,其得分就越低。
4. 对于那些请求了稀缺资源的 Pod,SRA 策略不会对其调度决策产生负面影响.
配置示例:
以下配置将 nvidia.com/gpu 定义为稀缺资源。当调度纯 CPU 任务时,拥有 GPU 的节点得分会降低,从而使任务更倾向于被调度到没有 GPU 的节点上。
actions: "enqueue, allocate, backfill, reclaim, preempt"tiers:- plugins: - name: resource-strategy-fit arguments: # ... resourceStrategyFit 的聚合/分散策略配置 ... resources: nvidia.com/gpu: type: MostAllocated weight: 2 cpu: type: LeastAllocated weight: 1 # SRA 策略配置 sra: enable: true resources: "nvidia.com/gpu"# 定义稀缺资源列表,逗号分隔 weight: 10 # SRA 策略在总分中的权重 resourceWeight: nvidia.com/gpu: 1 # 定义 nvidia.com/gpu 为稀缺资源及其权重
通过将 ResourceStrategyFit 的聚合/分散策略与 SRA 的规避策略相结合,用户可以实现更精细、更高效的异构资源调度。
实现混部与 OS 解耦
Volcano 混部能力分为应用态和内核态两部分,应用态混部提供在离线统一调度、动态资源超卖、节点压力驱逐等能力,内核态混部分为内核层面的CPU/Memory/Network等资源的QoS保障,内核态混部能力通常需要特性OS支持(如OpenEuler等)。在新版本中,Volcano将混部能力与OS进行了解耦,对于使用了不支持混部能力的OS的用户来讲,可以选择使用Volcano应用态的混部能力,来达到在离线任务统一调度、动态资源超卖、高优任务保障等能力。
具体使用方式如下,在安装Volcano agent时指定–supported-features参数:
helm install volcano . --create-namespace -n volcano-system --set custom.colocation_enable=true --set"custom.agent_supported_features=OverSubscription,Eviction,Resources"
支持自定义混部超卖资源名称
Vocano混部Agent新增参数 –extend-resource-cpu-name 和 –extend-resource-memory-name,允许用户自定义超卖资源名称,支持自定义设置 CPU 和内存资源的名称(默认分别为 kubernetes.io/batch-cpu 和 kubernetes.io/batch-memory)。提升了超卖资源名称设置的灵活性。
具体使用方式如下,在安装Volcano时指定–extend-resource-cpu-name和–extend-resource-memory-name参数:
helm install volcano . --create-namespace -n volcano-system --set custom.colocation_enable=true --set custom.agent_extend_resource_cpu_name=example.com/cpu --set custom.agent_extend_resource_memory_name=example.com/gpu
混部相关文档参考:https://volcano.sh/en/docs/colocation/
将网络拓扑感知调度能力扩展至 Kubernetes 标准工作负载
在新版本中,Volcano 的网络拓扑感知调度能力不再局限于 Volcano Job。现在,也可以为 Kubernetes 的标准工作负载(如 Deployment、StatefulSet 等)配置网络拓扑约束。
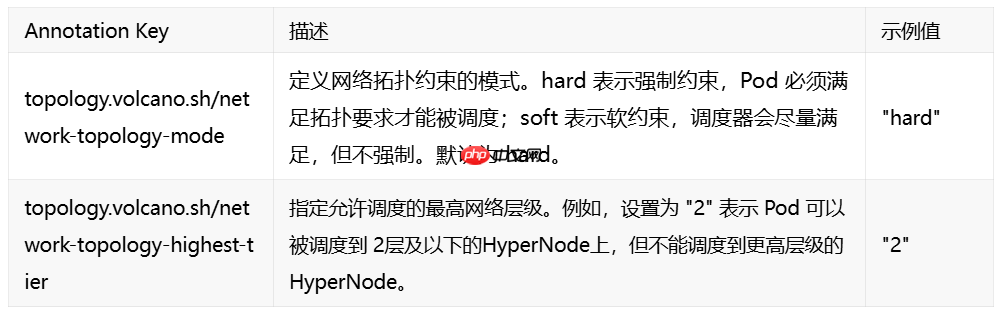
该功能通过 Pod 模板中的注解(Annotation)实现。当为 Deployment 或 StatefulSet 的 Pod 模板添加网络拓扑相关的注解后,Volcano 的 podgroup-controller 会自动为这些 Pod 创建一个PodGroup,并将注解中定义的网络拓扑约束继承到 PodGroup 的规约(Spec)中,从而在调度时应用相应的网络亲和性策略。
可以通过以下两个注解来配置网络拓扑感知调度:
Deployment 配置示例
以下示例展示了如何为一个 Deployment 配置网络拓扑感知调度。调度器将把该 Deployment 的 Pod 调度到网络层级不超过 2 的节点上:
apiVersion: apps/v1kind: Deploymentmetadata: name: network-aware-deploymentspec: replicas: 3 selector: matchLabels: app: my-app template: metadata: labels: app: my-app annotations: # 设置网络拓扑为硬约束 topology.volcano.sh/network-topology-mode: "hard" # 设置允许调度的最高网络层级为 2 topology.volcano.sh/network-topology-highest-tier: "2" spec: # 必须指定调度器为 volcano schedulerName: volcano containers: - name: main-container image: nginx:latest resources: requests: cpu: "1" memory: "1Gi" limits: cpu: "1" memory: "1Gi"
适配 Kubernetes 1.33
Volcano 版本紧随 Kubernetes 社区版本。v1.13 支持最新的 Kubernetes v1.33 版本,并通过完整的 UT 和 E2E 测试用例确保功能和可靠性。
更多详情可查看:https://github.com/volcano-sh/volcano/releases/tag/v1.13.0
源码地址:点击下载
以上就是Volcano v1.13 发布,大模型训练与推理等调度能力全面增强的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/66473.html
 微信扫一扫
 支付宝扫一扫