Bengio团队提出多模态新基准,直指Claude 3.5和GPT-4o弱点

Bengio团队提出多模态新基准,直指Claude 3.5和GPT-4o弱点
AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com

本文作者张天宇,就读于加拿大mila人工智能研究所,师从图灵奖得主yoshua bengio教授。博士期间的主要工作聚焦于多模态、gflownet、多智能体强化学习、ai于气候变化的应用。目前已在icml、iclr、icassp等机器学习顶会发表论文。代表作为large-scale contrastive language-audio pretraining with feature fusion and keyword-to-caption augmentation (clap)。

想要达成通用人工智能 AGI 的终极目标,首先要达成的是模型要能完成人类所能轻松做到的任务。为了做到这一点,大模型开发的关键指导之一便是如何让机器像人类一样思考和推理。诸如注意力机制和思维链(Chain-of-Thought)等技术正是由此产生的灵感。
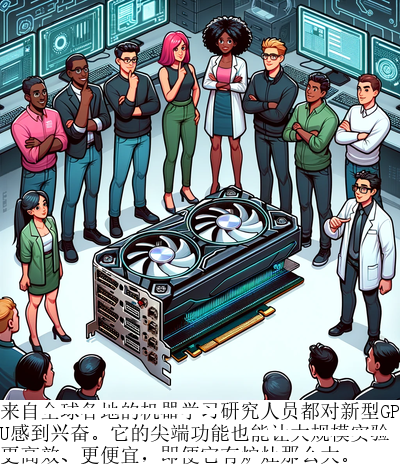
然而,可能很多人并没有意识到,很多对人类来说很简单的认知任务也往往伴随着非常复杂的推理过程。举个栗子,请大家试试根据下方的图片填补被遮挡的文字空白:

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
Bengio团队提出多模态新基准,直指Claude 3.5和GPT-4o弱点

(正确答案:来自全球各地的机器学习研究人员都对新型 GPU 感到兴奋。它的尖端功能也能让大规模实验更高效、更便宜,即使它有炉灶那么大。)
对大多数中文母语者而言,这个任务应该不难,相信大家不需要几秒钟就可以得到答案。但想从露出的部分文字推断完整文字仍然需要十分复杂的推理过程:当代神经科学研究表明,复原被部分遮挡物体需要能进行高级决策的前额叶皮质的高度参与。
我们知道,当前的视觉语言模型(Vision-Language Models, VLM)可以非常精确地进行物体识别和文字识别。但是,当被遮挡的部分是文字;当模型的光学字符识别(OCR)失效;当仅有的关键信息只有被遮挡文字的几个像素,模型能够模拟人类的推理过程完成这一任务吗?
为此,来自图灵奖得主 Yoshua Bengio 的团队提出了全新的视觉问答任务:视觉字幕恢复(Visual Caption Restoration,VCR)。让我们借由这个任务对视觉语言模型的推理能力一探究竟:当前的视觉语言模型距离人类的认知水平还有多长的路要走?
Bengio团队提出多模态新基准,直指Claude 3.5和GPT-4o弱点

论文标题:VCR: Visual Caption Restoration
论文链接:arxiv.org/abs/2406.06462
代码仓库:github.com/tianyu-z/VCR (点击阅读原文即可直达,包含评用于模型评测和预训练的数据生成代码)
Hugging Face 链接:huggingface.co/vcr-org
VCR 数据集简介

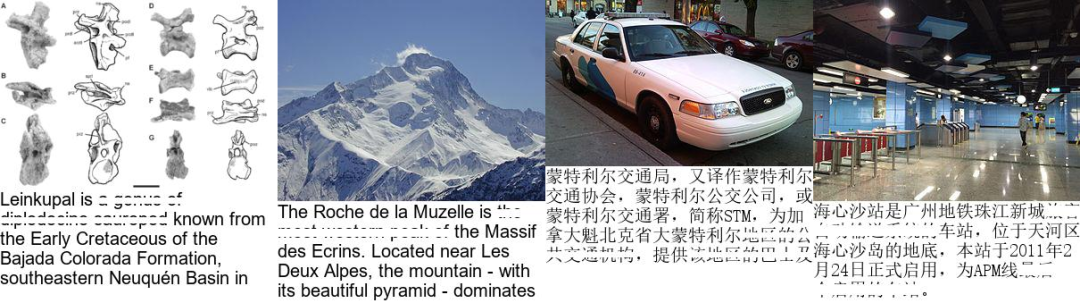
为了开发 VCR 任务,研究人员构建了一个由图像 – 文字生成 VCR 合成图像的流程。在该流程中可以通过控制遮住文字的白色矩形大小来改变图像中文本的可见性,从而控制任务难度
借由该数据生成流程,研究人员通过维基百科的主图 – 介绍对生成了 VCR-wiki 数据集。对两种语言均设置 “简单” 和 “困难” 两个难度级别。其中:
“简单” 难度 VCR 任务能使得 OCR 模型失效
“困难” 难度 VCR 任务则对每个被遮挡的文本只保留上下各 1-2 个像素的高度,但依然能让对应语言的使用者完成任务。
每种语言和难度中,测试集和验证集各有 5000 个样本,剩下的样本都在训练集中。
Bengio团队提出多模态新基准,直指Claude 3.5和GPT-4o弱点

                          图例:从左到右分别为,英文简单难度、英文困难难度、中文简单难度、中文困难难度
难度进一步提升后,人类 vs 模型
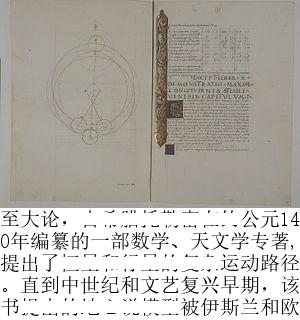
文章开头的例子对人类而言只是一个小挑战,不能很好地展示人类做这个任务的极限水平以及人类在解题的时候运用的思维和技巧。下面展示了一个 “困难” 难度的 VCR 任务样例。读者可以更专注地尝试自己填补下方被遮挡的文字空白。
Bengio团队提出多模态新基准,直指Claude 3.5和GPT-4o弱点

(正确答案:至大论,古希腊托勒密在约公元 140 年编纂的一部数学、天文学专著,提出了恒星和行星的复杂运动路径。直到中世纪和文艺复兴早期,该书提出的地心说模型被伊斯兰和欧…)
人类是如何补全被部分遮挡的文字的?
教育学和认知科学中有一个概念叫做元认知(meta-cognition)。在设计 AI 的时候,我们人类作为教师,可以通过监控自己的思维过程当作参考来帮助作为模型的学生提高学习效率。因此,思考 “人类是如何完成 VCR 任务的” 可以对模型设计有指导意义。
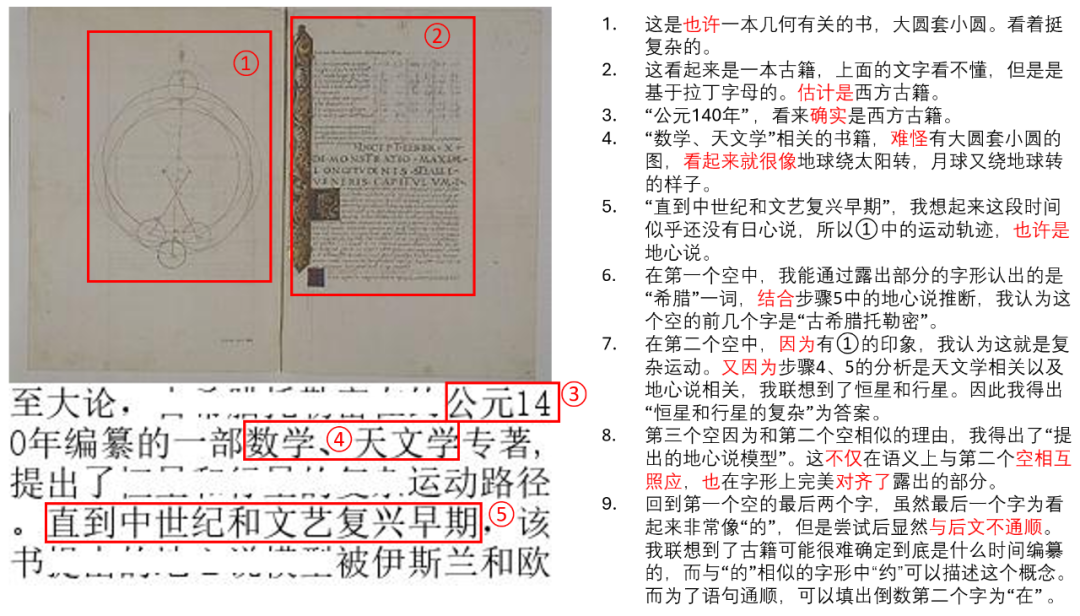
下图展示了一种笔者对 VCR 任务的解题思路作为参考:
Bengio团队提出多模态新基准,直指Claude 3.5和GPT-4o弱点

看似步骤很多,其实就是在不断通过不同的区域获取信息再反复验证来增加回答的置信度。
最开始看到图片时,心里只有一个模糊的猜测,在不断阅读图片获取新信息的过程中,逐步验证猜测。阅读完毕后,开始填空时,仍然没有停止通过信息的不同方面来相互对照,印证答案。当 “假设” 无法与其他信息保持一致时,就会推翻 “假设”,重新尝试新的假设。
人类评测结果
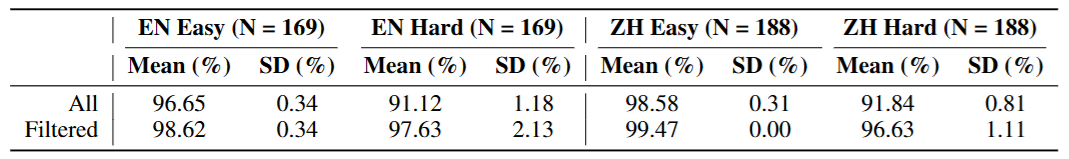
人类在 VCR 任务下的水平如何呢?下图中展示了母语者或各语言的流利使用者在英 / 中两种语言的简单 / 困难设定下的准确度:
Bengio团队提出多模态新基准,直指Claude 3.5和GPT-4o弱点

新CG儿 新CG儿

数字视觉分享平台 | AE模板_视频素材

新CG儿 412 查看详情 新CG儿

如果考虑包含时间、地名、人名的错误,人类在简单难度下的中文平均正确率约为 98.58%,在困难难度下的中文平均正确率约为 91.84%。而去掉这些因为时间、地名、人名的错误,人类在简单难度的中文下几乎接近满分,而中文困难难度下正确率也达到了 96.63%。可以看出,VCR 任务对于人类而言是非常简单的
现有模型结果
作者测试了 “全明星阵容”:Claude 3 Opus, Claude 3.5 Sonnet, Gemini 1.5 Pro, GPT-4o, GPT-4 Turbo, Qwen-VL-Max, Reka Core 以及一些目前性能最好的开源模型。
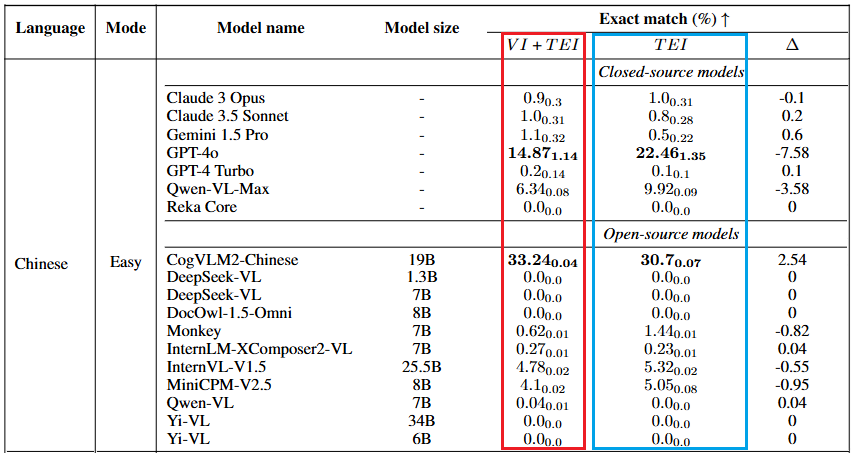
下图中展示了在 VCR-Wiki 中文的简单难度上各个模型的性能:
Bengio团队提出多模态新基准,直指Claude 3.5和GPT-4o弱点

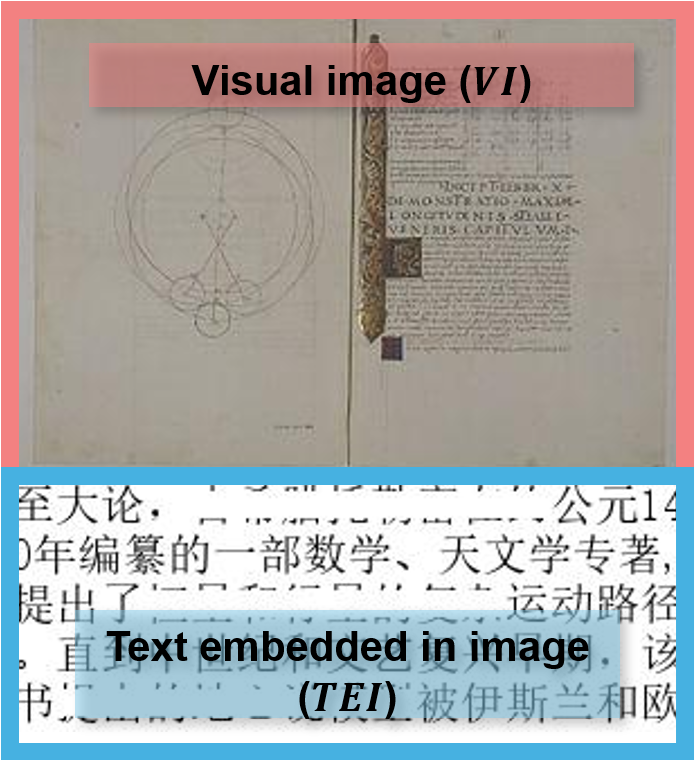
红框测量指标包括代表包含了图像(VI)图像中的文字(TEI)两部分作为上下文信息,模型能还原出被遮住的文字的准确率。蓝色框内表示仅包含图像中的文字(TEI)的作为上下文信息,并不包含图像(VI),模型能还原出的遮住文字的准确率。
Bengio团队提出多模态新基准,直指Claude 3.5和GPT-4o弱点

结果表明:
绝大多数模型目前都不能胜任这个任务;
绝大多数模型没有利用好图像信息,没有因为图像信息(VI)而提高准确率。
在中文的困难难度上,模型遇到了更大的麻烦。表现得最好的是 GPT-4o,但其只有 2.2% 的准确率。除了 CogVLM2-Chinese 和 Qwen-VL-Max,绝大多数模型的准确率都接近 0%
可以观察到,在困难模式下,原始模型很难在本问题上以显著的比例答对,更不用说接近人类了。
英文 VCR 评测结果
作者同样对目前最优的开源和闭源视觉 – 语言模型在英文 VCR-Wiki 上做了测试。在展示测试结果之前,请先看两个英文 VCR-Wiki 任务的样例:
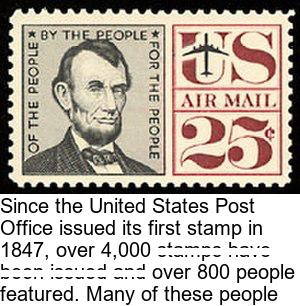
英文简单样例:

Bengio团队提出多模态新基准,直指Claude 3.5和GPT-4o弱点

(正确答案:Since the United States Post Office issued its first stamp in 1847, over 4,000 stamps have been issued and over 800 people featured. Many of these people…)
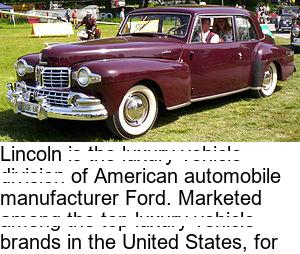
英文困难样例:

Bengio团队提出多模态新基准,直指Claude 3.5和GPT-4o弱点

(正确答案:Lincoln is the luxury vehicle division of American automobile manufacturer Ford. Marketed among the top luxury vehicle brands in the United States, for…)
文中展示的英文 VCR-Wiki 的测试结果如下:
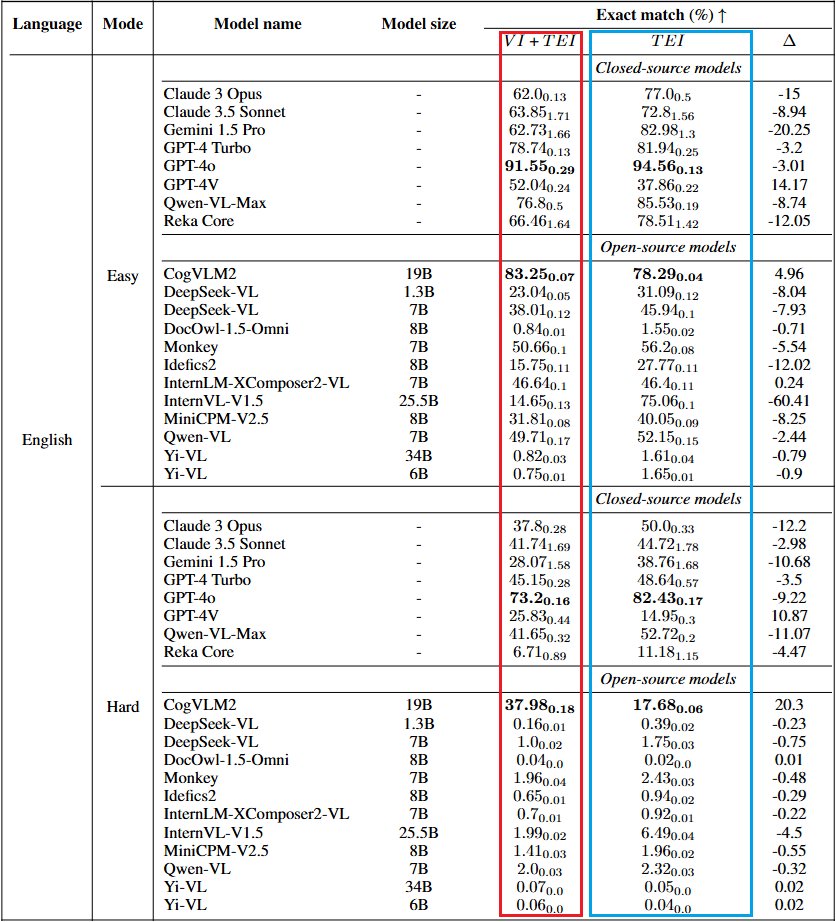
Bengio团队提出多模态新基准,直指Claude 3.5和GPT-4o弱点

从结果整体来看,模型在英文的简单模式和困难模式下都分别比中文表现得要好。这个结果与我们一般认为的 “因为特殊的模块化构形,残缺的中文更加容易被补全” 的直觉不一致。或许这是由于在预训练过程中,英文在数据量和数据质量上相比中文有更大的优势。
在所测试的众多模型中,GPT-4o 是闭源模型中的效果最佳的,CogVLM2 是开源模型中表现最佳的
一个很有趣的现象是加入了图片对 CogVLM2 来说有了明显的帮助(在困难模式下提升了 20.3%),而对于 GPT-4o 而言反而结果有下降。在中文测试中,也有相似的现象。笔者认为这是模型的结构所导致的。具体的细节,欢迎读者参阅 CogVLM 系列的论文以及代码。
另外,闭源模型普遍取得了比开源模型更优的结果,这可能归功于更优的训练策略或是更多的模型参数。但即使如此,模型依然在 “困难” 设定下遇到了很大的挑战。开源模型虽然可以部分完成 “简单” 设定,但在困难设定下,大多数开源模型都无法完成这个对人类而言十分简单的任务。
相关任务简介
VQA
视觉问答(Visual Question Answering, VQA)任务要求模型根据输入的图像和自然语言问题生成自由形式的回答。由于没有唯一的标准答案,评估 VQA 具有很大的挑战性。传统的 VQA 方法主要集中于图像中可见元素的直接查询,而不涉及图像中嵌入的文本内容与整体图像上下文之间的复杂关系。
在一些文字在图片中信息占比比较大的 VQA 评测中,模型的视觉模块甚至可能完全不需要与语言模块对齐就可以胜任。此类流程为:图像输入给 OCR 视觉模块,OCR 视觉模块输出图像中的字符信息并以此为上下文输入给语言模块。这样就导致了 VQA 任务退化成了不需要图像信息的 QA 任务。原本比较不同的 VLM 需要的视觉模块对齐能力被忽视而 OCR 能力被重视。
OCR
光学字符识别(Optical Character Recognition, OCR)任务通常输入图像中的完整字符,并输出表示图像中字符的字符串文本,而无需考虑图像上下文。
预训练过 OCR 的模型能够从输入图像中提取嵌入的文本,即使这些文本是不完整或模糊的。然而,随着文本组件模糊或被遮挡的程度增加,只利用可见部分恢复原始文本变得困难,OCR 方法在这种情况下效果有限
可以看出,VQA 任务没有标准答案,评估模型回答的质量仍然是一个开放性问题。而 OCR 任务不需要通过上下文来完成,无法检验模型是否真的学会利用了上下文中的信息。
VCR 任务的不可替代性
视觉字幕恢复(Visual Caption Restoration, VCR)任务旨在恢复图像中被遮挡的文本,这一任务 VQA 和 OCR 之间架起了桥梁
VCR 任务的独特挑战在于要求模型在视觉和文本信息之间进行精确的对齐,这与 OCR 的简单文本提取任务形成鲜明对比。在 OCR 中,主要关注的是识别可见字符,而无需理解它们在图像叙事中的上下文相关性。相比之下,VCR 要求模型协同利用可用的部分像素级文本提示和视觉上下文来准确地重建被遮挡的内容。这不仅测试了模型处理嵌入文本和视觉元素的能力,还考验了其保持内部一致性的能力,类似于人类通过上下文和视觉线索进行理解和响应的认知过程
与 VQA 不同,VCR 任务的问题有唯一的答案,这使得评估可以通过准确度进行,使评测指标更加明确。
通过调整文本的遮盖比例,可以控制任务的难度,从而提供一个丰富的测试环境。
与 OCR 任务一样,VCR 任务也可以充当 VLM 的训练任务。作者开放了 transform 代码,可以生成任意给定图像 – 文字对的 VCR 任务图。
小结
本文提出的视觉字幕恢复(VCR)任务通过看似简单的字幕恢复任务巧妙地揭开了现有模型图像 – 文本对齐的局限性,以及模型与人类在高级认知任务上的推理能力差异。相信这一任务可以启发未来更加有效的 VLM 训练、评测和推理方法,进一步拉近多模态模型和人类认知能力的差距。

以上就是Bengio团队提出多模态新基准,直指Claude 3.5和GPT-4o弱点的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/793178.html


(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
华为鸿蒙系统是否可视为安卓的延伸
上一篇 2025年11月26日 15:05:59
java怎么通过地址输出数组
下一篇 2025年11月26日 15:06:03

相关推荐

  • Valkey 9.0.0 正式 GA,Linux 基金会维护的 Redis 分支

    由 linux 基金会主导维护的 redis 分支——开源内存数据库 valkey 9.0.0 正式发布,现已进入通用可用(ga)阶段。本次版本带来了多项关键性的性能提升与功能增强,重点聚焦于更高效的集群数据迁移、精细化的哈希字段管理能力,以及对大规模分布式部署场景的深度优化。 原子化槽位迁移(At…

    2026年9月21日
    100
  • 如何调整VSCode的设置以获得最佳性能?

    合理配置VSCode可显著提升性能。1. 禁用不必要扩展,减少后台资源占用;2. 在settings.json中设置files.watcherExclude和search.exclude以降低CPU负载;3. 启用editor.renderLineHighlight和largeFileOptimiz…

    2026年9月20日
    500
  • Gemini2.5网页版访问入口_Gemini2.5官方网站下载链接

    Gemini 2.5网页版访问入口为 https://gemini.google.com/app,登录谷歌账号后可使用主交互界面、模型切换、文件上传、历史记录及移动端同步等功能。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ Gemini2…

    2026年9月20日
    000
  • VSCode的扩展推荐是怎么工作的?

    VSCode的扩展推荐基于用户行为和项目环境智能生成,当你打开.py文件时会推荐Python相关工具,打开.ts、.vue等文件则触发对应语言插件;系统通过分析package.json、requirements.txt等依赖文件识别技术栈,推荐Docker、ESLint等匹配扩展;同时记录常用操作如…

    2026年9月20日
    000
  • 当VSCode启动或运行变慢时,有哪些系统性的排查和优化步骤?

    答案:VSCode变慢主要由扩展、文件监控和设置引起。先以安全模式启动排查扩展影响,使用内置性能工具分析启动耗时,优化工作区的文件监听与搜索范围,调整渲染设置并清理缓存,可显著提升运行效率。 VSCode 启动或运行变慢通常涉及扩展、设置、系统资源或文件索引等问题。以下是系统性的排查与优化步骤,帮助…

    2026年9月20日
    000
  • 怎样在VSCode中查看Git提交历史?

    VSCode通过内置源代码管理视图查看Git提交历史,点击左侧图标或使用快捷键Ctrl+Shift+G进入;2. 在COMMIT输入框下方点击“…”菜单选择View Commit History可查看完整提交记录;3. 右键文件选择Git: View File History可查看单个文…

    2026年9月20日
    100
  • VSCode怎么查看NPM版本_VSCode NPM版本查询教程

    在VSCode中查看NPM版本,需打开集成终端并输入npm -v或npm –version。1. 使用快捷键Ctrl + (Windows/Linux)或Cmd + (macOS)打开终端;2. 输入命令npm -v执行;3. 终端将显示当前NPM版本号,如8.19.2。该方法可快速验证…

    2026年9月20日
    000
  • VSCode如何与Git Submodules或SVN等非Git版本控制系统协作?

    VSCode原生支持Git,对Submodules需手动初始化并提交指针,协作时推荐结合终端;通过安装svn-scm插件可支持SVN,依赖本地svn工具,混合项目应避免路径冲突,建议明确分工、合理配置忽略规则,使用集成终端处理复杂操作,确保工具链完整与插件更新,以实现多版本控制系统协同。 VSCod…

    2026年9月20日
    100
  • 在Java中高效提取整数的最小与最大数字

    本文详细介绍了在java中如何从一个整数中提取其包含的最小和最大数字。通过采用数学运算(取模和除法)或字符串转换两种方法,实现对整数各位数字的遍历与比较,从而高效地找出并显示这些极值数字。文章提供了具体的代码示例,并探讨了不同方法的适用场景与注意事项。 在Java编程中,我们有时需要从一个给定的整数…

    2026年9月20日
    000
  • VSCode的开发者社区是如何运作的,普通用户可以通过哪些途径参与贡献和反馈?

    VSCode社区开放活跃,用户可通过报告问题、贡献代码、开发扩展、改进文档及参与讨论等多种方式加入。 VSCode 的开发者社区活跃且开放,由微软主导但高度依赖开源协作。项目托管在 GitHub 上,采用透明的开发流程,所有功能讨论、问题追踪和代码提交都公开可见。普通用户无论是否具备编程能力,都可以…

    2026年9月20日
    000
  • VSCode的侧边栏图标代表什么?

    资源管理器(文件夹图标)用于管理项目文件结构,支持新建、重命名、删除和拖拽操作;2. 搜索(放大镜图标)实现全局文本查找与替换,支持正则表达式及范围筛选;3. 源代码管理(分支图标)集成Git功能,可查看变更、提交代码并同步远程仓库;4. 运行和调试(虫子图标)支持断点调试、变量监控及多语言启动配置…

    2026年9月20日
    000
  • 漏洞复现 | DirtyPipe CVE-2022-0847 Linux 内核提权漏洞复现

    漏洞复现 | DirtyPipe CVE-2022-0847 Linux 内核提权漏洞复现漏洞复现 | DirtyPipe CVE-2022-0847 Linux 内核提权漏洞复现漏洞复现 | DirtyPipe CVE-2022-0847 Linux 内核提权漏洞复现漏洞复现 | DirtyPipe CVE-2022-0847 Linux 内核提权漏洞复现

    0x00 前言 CVSS 评分:7.8 影响范围:5.8 通过 CVE-2022-0847,RT 可以覆盖重写任意可读文件中的数据,从而将普通权限的用户提升到特权 root 级别。 这个漏洞被作者命名为 Dirty Pipe,之所以这样命名,是因为其原理与 Dirty Cow 相似,但 Dirty …

    2026年9月20日 用户投稿
    000
  • Linux如何自定义命令别名

    Linux如何自定义命令别名Linux如何自定义命令别名Linux如何自定义命令别名Linux如何自定义命令别名

    自定义Linux命令别名是通过alias命令或配置文件为常用命令设置简短别名,提升效率与个性化。首先使用alias定义临时别名,如alias ll=’ls -alF’;为永久生效需将别名写入~/.bashrc或~/.zshrc,并用source命令加载。避免覆盖原命令、合理添…

    2026年9月20日 用户投稿
    000
  • VSCode的终端集成有哪些技巧?

    掌握VSCode终端技巧可提升开发效率。1. 用Ctrl+`快速打开终端,支持多实例创建与重命名;2. 在设置中自定义默认shell如zsh或Git Bash;3. 优化字体、启用自动换行与智能复制;4. 终端联动编辑器实现一键运行、路径拖拽补全与点击跳转。 VSCode的终端集成非常实用,合理使用…

    2026年9月20日
    000
  • 如何为VSCode配置一个自定义的文件编码检测策略?

    VSCode无直接自定义编码检测API,需通过files.encoding设默认编码,files.autoGuessEncoding启自动识别,files.associations按文件类型指定编码,.editorconfig统一项目规范,辅以扩展处理特殊需求,组合实现自定义策略;编码误判主因包括B…

    2026年9月20日
    000
  • VSCode版本管理:解决代码冲突与合并分支的实用方法

    掌握VSCode中Git冲突解决与分支合并方法,能提升协作效率。当多开发者修改同一代码区域时会触发冲突,VSCode用标记(如<<<<<<>>>>>>分支名)标出冲突块,并提供“接受当前”“接受传入”等按钮图形化处理。解决后需暂…

    2026年9月20日
    100
  • VSCode怎么把代码整齐_VSCode代码格式化与自动排版功能设置教程

    VSCode代码格式化可显著提升代码可读性与质量,通过内置功能及Prettier、ESLint插件实现。安装Prettier和ESLint插件后,需在设置中配置默认格式化工具、保存时自动格式化(Format On Save)、粘贴时格式化(Format On Paste)及保存时修复ESLint问题…

    2026年9月20日
    100
  • 如何使用VSCode的源代码管理视图?

    VSCode的SCM视图可高效管理Git工作流。1. 点击左侧源代码管理图标或使用快捷键Ctrl+Shift+G打开视图;2. 查看未暂存和已暂存更改,通过点击“+”号暂存文件;3. 输入提交信息后按Ctrl+Enter提交,点击同步按钮推送至远程仓库;4. 通过状态栏分支名称切换或创建分支,冲突时…

    2026年9月20日
    000
  • 如何在Laravel中管理环境变量

    在laravel中管理环境变量的核心在于利用.env文件和config配置系统。具体来说,1. 使用.env文件存储环境变量,如数据库连接信息、api密钥等;2. 通过laravel的配置文件(如config/database.php)读取.env中的值,并使用config()函数获取配置;3. 在…

    2026年9月20日
    000
  • VSCode的扩展推荐是基于什么?

    答案是VSCode根据文件类型、项目配置、用户行为和社区流行度智能推荐扩展。打开.py文件时提示Python扩展,存在package.json则推荐JS工具,频繁格式化代码会推荐Prettier,安装ESLint后可能推荐Prettier,高评分和官方扩展优先展示。 VSCode的扩展推荐主要基于你…

    2026年9月20日
    000

发表回复

登录后才能评论
关注微信