Transformer模型在挑战视频生成中成功利用20亿个数据点学习物理世界

建立会做视频的世界模型,也能通过transformer来实现了!

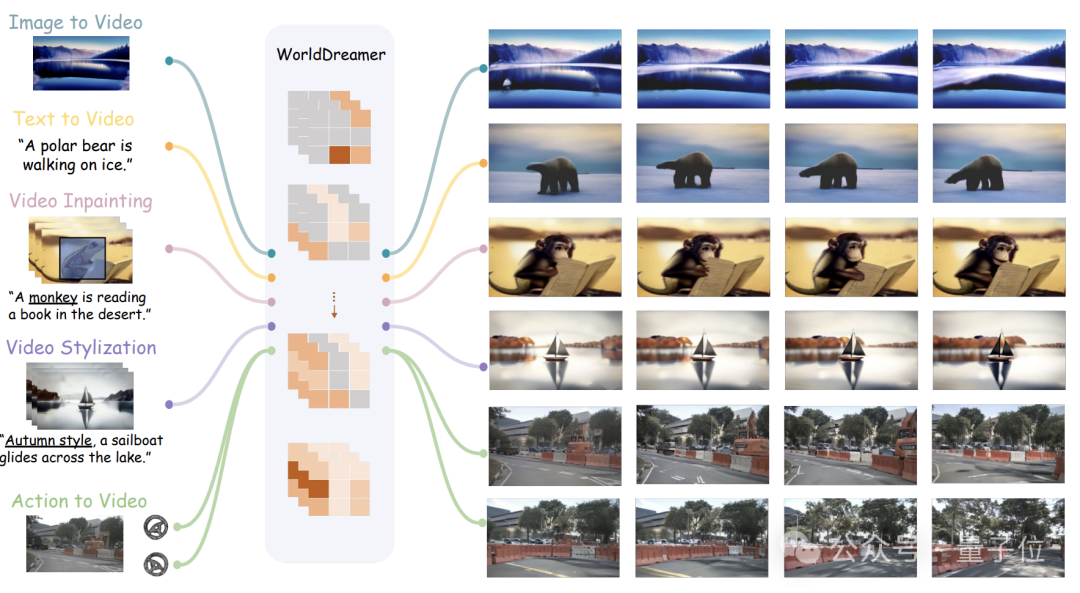
来自清华和极佳科技的研究人员联手,推出了全新的视频生成通用世界模型——WorldDreamer。

它可以完成多种视频生成任务,包括自然场景和自动驾驶场景,如文生视频、图生视频、视频编辑、动作序列生视频等。

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
从20亿数据中学习物理世界,基于Transformer的通用世界模型成功挑战视频生成

据团队介绍,通过预测Token的方式来建立通用场景世界模型,WorldDreamer是业界首个。

它把视频生成转换为一个序列预测任务,可以对物理世界的变化和运动规律进行充分地学习。

可视化实验已经证明,WorldDreamer已经深刻理解了通用世界的动态变化规律。

那么,它都能完成哪些视频任务,效果如何呢?

支持多种视频任务

图像生成视频(Image to Video)

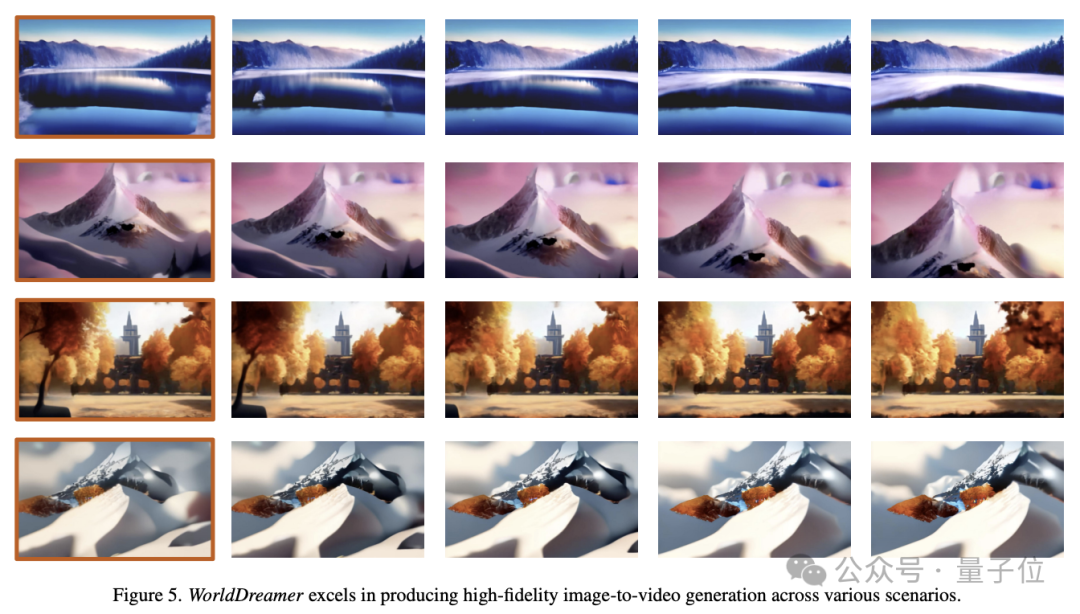
WorldDreamer可以基于单一图像预测未来的帧。

只需首张图像输入,WorldDreamer将剩余的视频帧视为被掩码的视觉Token,并对这部分Token进行预测。

如下图所示,WorldDreamer具有生成高质量电影级别视频的能力。

其生成的视频呈现出无缝的逐帧运动,类似于真实电影中流畅的摄像机运动。

而且,这些视频严格遵循原始图像的约束,确保帧构图的显著一致性。
从20亿数据中学习物理世界,基于Transformer的通用世界模型成功挑战视频生成

文本生成视频(Text to Video)

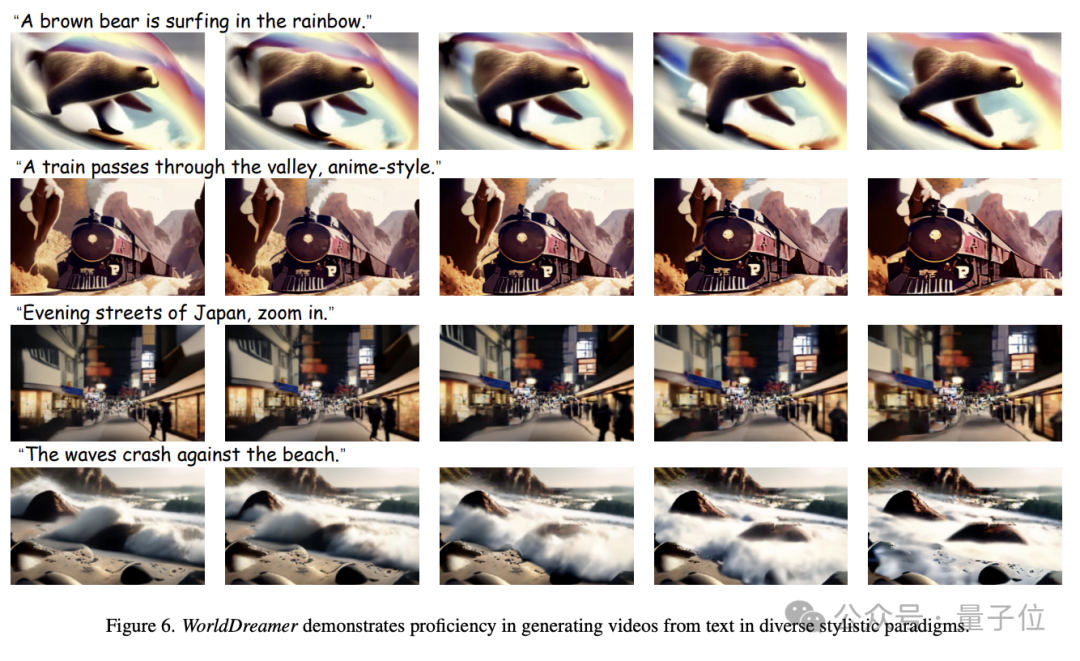
WorldDreamer还可以基于文本进行视频生成。

仅仅给定语言文本输入,此时WorldDreamer认为所有的视频帧都是被掩码的视觉Token,并对这部分Token进行预测。

下图展示了WorldDreamer在各种风格范式下从文本生成视频的能力。

生成的视频与输入语言无缝契合,其中用户输入的语言可以塑造视频内容、风格和相机运动。
从20亿数据中学习物理世界,基于Transformer的通用世界模型成功挑战视频生成

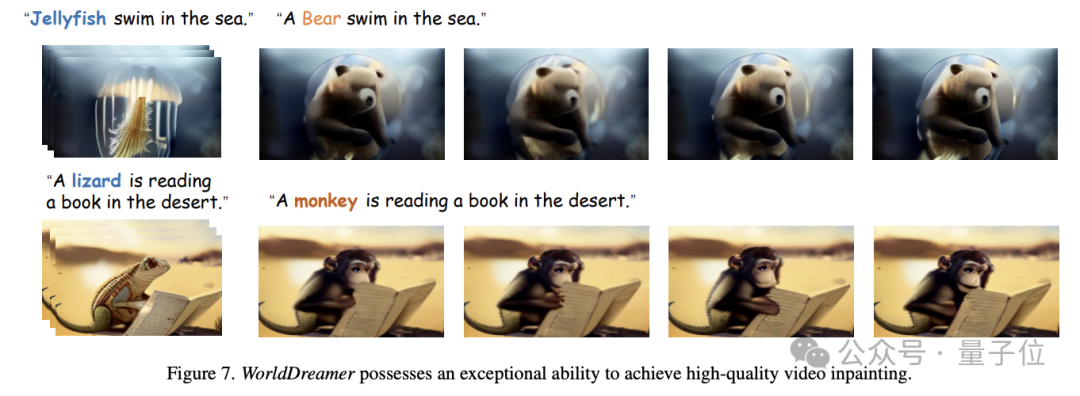
视频修改(Video Inpainting)

WorldDreamer进一步可以实现视频的inpainting任务。

具体来说,给定一段视频,用户可以指定mask区域,然后根据语言的输入可以更改被mask区域的视频内容。

如下图所示,WorldDreamer可以将水母更换为熊,也可以将蜥蜴更换为猴子,且更换后的视频高度符合用户的语言描述。
从20亿数据中学习物理世界,基于Transformer的通用世界模型成功挑战视频生成

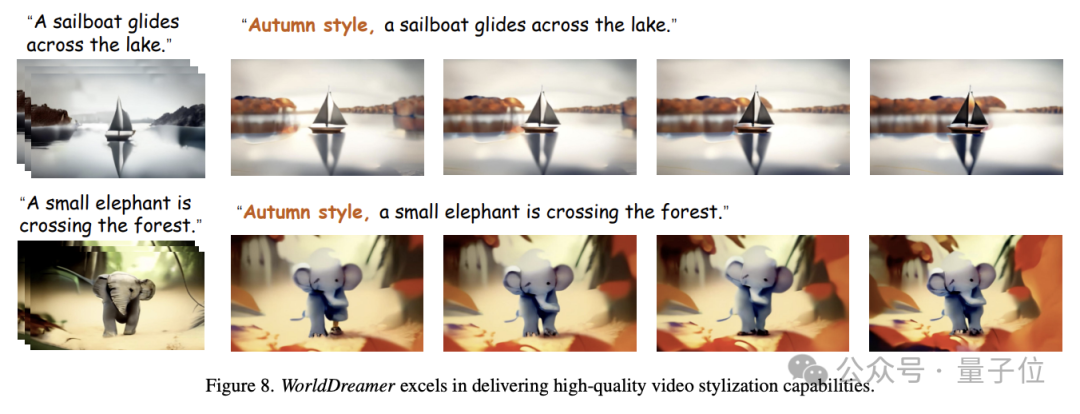
视频风格化(Video Stylization)

除此以外,WorldDreamer可以实现视频的风格化。

如下图所示,输入一个视频段,其中某些像素被随机掩码,WorldDreamer可以改变视频的风格,例如根据输入语言创建秋季主题效果。
从20亿数据中学习物理世界,基于Transformer的通用世界模型成功挑战视频生成

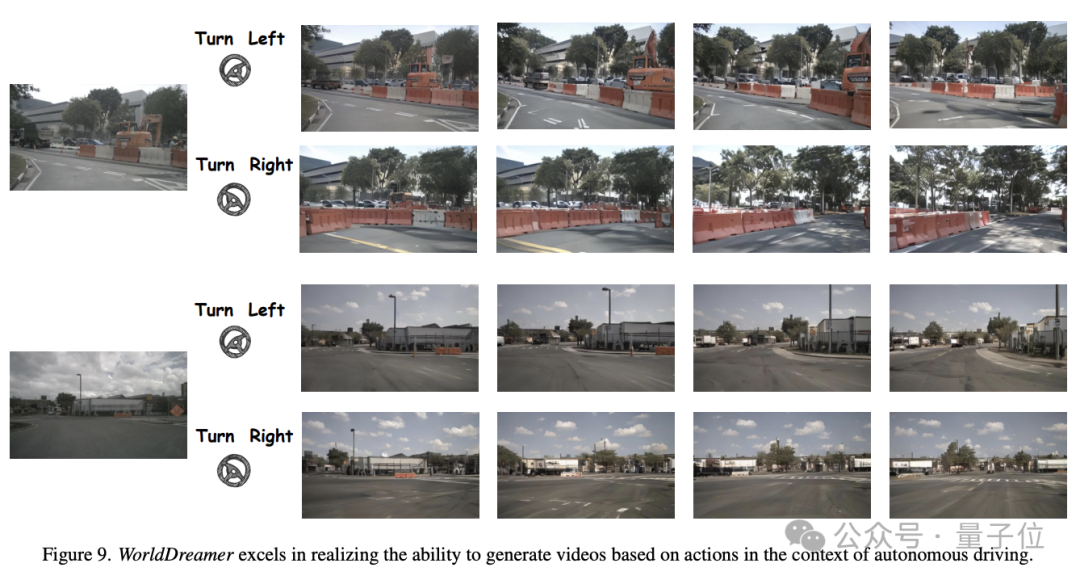
基于动作合成视频(Action to Video)

WorldDreamer也可以实现在自动驾驶场景下的驾驶动作到视频的生成。
豆包AI编程 豆包AI编程

豆包推出的AI编程助手

豆包AI编程 1697 查看详情 豆包AI编程

如下图所示,给定相同的初始帧以及不同的驾驶策略(如左转、右转),WorldDreamer可以生成高度符合首帧约束以及驾驶策略的视频。
从20亿数据中学习物理世界,基于Transformer的通用世界模型成功挑战视频生成

那么,WorldDreamer又是怎样实现这些功能的呢?

用Transformer构建世界模型

研究人员认为,目前最先进的视频生成方法主要分为两类——基于Transformer的方法和基于扩散模型的方法。

利用Transformer进行Token预测可以高效学习到视频信号的动态信息,并可以复用大语言模型社区的经验,因此,基于Transformer的方案是学习通用世界模型的一种有效途径。

而基于扩散模型的方法难以在单一模型内整合多种模态,且难以拓展到更大参数,因此很难学习到通用世界的变化和运动规律。

而当前的世界模型研究主要集中在游戏、机器人和自动驾驶领域,缺乏全面捕捉通用世界变化和运动规律的能力。

所以,研究团队提出了WorldDreamer来加强对通用世界的变化和运动规律的学习理解,从而显著增强视频生成的能力。

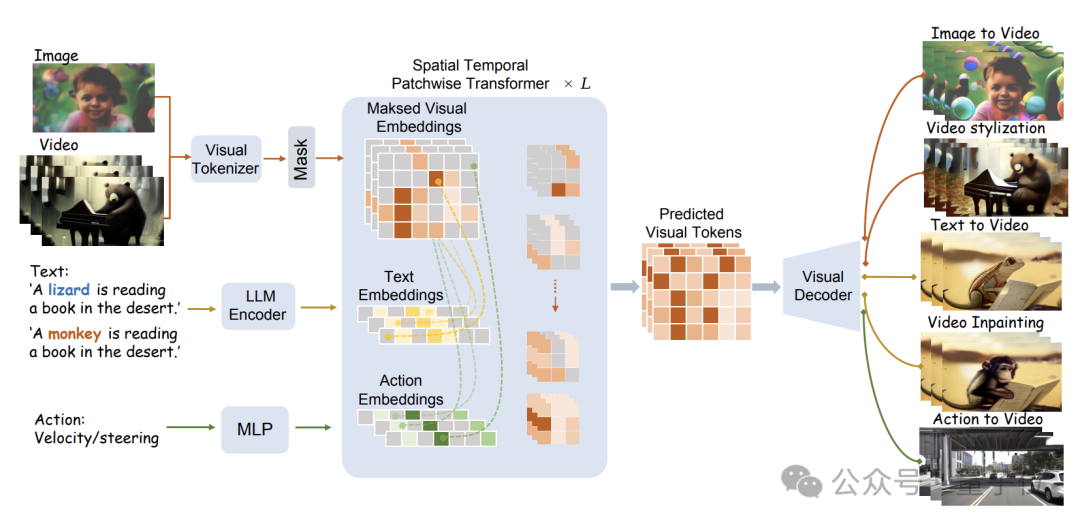
借鉴大型语言模型的成功经验,WorldDreamer采用Transformer架构,将世界模型建模框架转换为一个无监督的视觉Token预测问题。

具体的模型结构如下图所示:
从20亿数据中学习物理世界,基于Transformer的通用世界模型成功挑战视频生成

WorldDreamer首先使用视觉Tokenizer将视觉信号(图像和视频)编码为离散的Token。

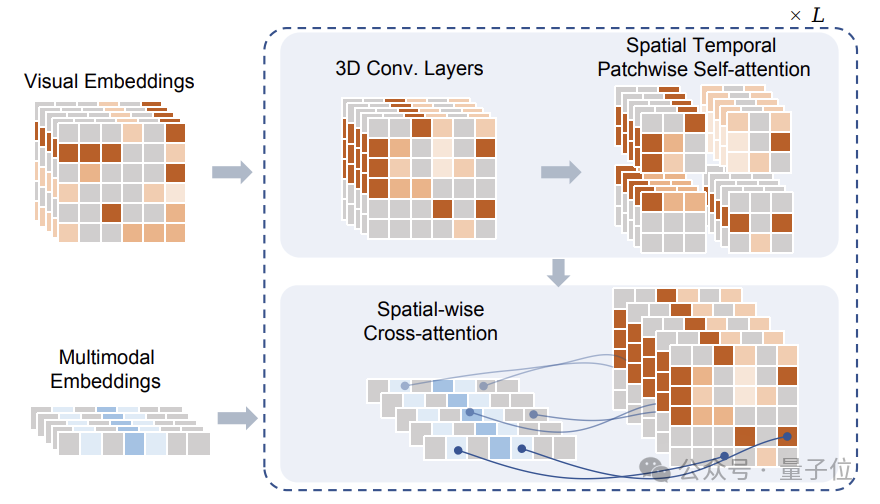
这些Token在经过掩蔽处理后,输入给研究团队提出的Sptial Temporal Patchwuse Transformer(STPT)模块。

同时,文本和动作信号被分别编码为对应的特征向量,以作为多模态特征一并输入给STPT。

STPT在内部对视觉、语言、动作等特征进行充分的交互学习,并可以预测被掩码部分的视觉Token。

最终,这些预测出的视觉Token可以用来完成各种各样的视频生成和视频编辑任务。
从20亿数据中学习物理世界,基于Transformer的通用世界模型成功挑战视频生成

值得注意的是,在训练WorldDreamer时,研究团队还构建了Visual-Text-Action(视觉-文本-动作)数据的三元组,训练时的损失函数仅涉及预测被掩蔽的视觉Token,没有额外的监督信号。

而在团队提出的这个数据三元组中,只有视觉信息是必须的,也就是说,即使在没有文本或动作数据的情况下,依然可以进行WorldDreamer的训练。

这种模式不仅降低了数据收集的难度,还使得WorldDreamer可以支持在没有已知或只有单一条件的情况下完成视频生成任务。

研究团队使用大量数据对WorldDreamer进行训练,其中包括20亿经过清洗的图像数据、1000万段通用场景的视频、50万段高质量语言标注的视频、以及近千段自动驾驶场景视频。

团队对10亿级别的可学习参数进行了百万次迭代训练,收敛后的WorldDreamer逐渐理解了物理世界的变化和运动规律,并拥有了各种的视频生成和视频编辑能力。

论文地址:https://arxiv.org/abs/2401.09985
项目主页:https://world-dreamer.github.io/

以上就是Transformer模型在挑战视频生成中成功利用20亿个数据点学习物理世界的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/799987.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
光遇12.18每日任务速通指南
上一篇 2025年11月26日 17:32:25
Windows10的U盘装机方法
下一篇 2025年11月26日 17:32:28

相关推荐

  • 智能平权下,燃油车如何升级?

    智能平权下,燃油车如何升级?智能平权下,燃油车如何升级?智能平权下,燃油车如何升级?智能平权下,燃油车如何升级?

    曾几何时,“智能驾驶是电动车的专属”成为汽车行业的共识。宝马、奔驰、奥迪等传统豪华品牌长期专注于机械精密性和驾驶质感,在智能化布局上尤为谨慎,一度被贴上保守与落后的标签。 与此同时,新能源品牌凭借智能化迅速打开市场缺口,成功构建起“电动即智能、燃油即传统”的认知框架,在舆论和市场销量中占据先机。 ☞…

    2026年9月24日 用户投稿
    000
  • mac怎么使用听写功能_mac听写输入开启方法

    首先启用高级听写功能,进入系统设置→键盘→听写,勾选“使用高级听写”并下载语言包;随后可设置快捷键(如双击Fn键)快速启动语音输入;在支持的应用中也可通过菜单栏“编辑→开始听写”直接调用;最后根据需要配置听写语言、自动纠正及连续听写选项以提升识别准确率。 如果您希望在Mac上通过语音输入文字以提高效…

    2026年9月24日
    200
  • 使用MySQL命令行客户端进行交互式管理

    使用MySQL命令行客户端进行交互式管理使用MySQL命令行客户端进行交互式管理使用MySQL命令行客户端进行交互式管理使用MySQL命令行客户端进行交互式管理

    mysql命令行客户端的常用命令包括:1. 使用mysql -u 用户名 -p命令连接数据库;2. 执行show databases;查看所有数据库;3. 使用use 数据库名;选择数据库;4. 使用select * from 表名;查询数据;5. 使用insert into 表名 (列1, 列2)…

    2026年9月24日 用户投稿
    500
  • 赋能AI未来!康盈半导体 AI 应用存储新品登陆 elexcon 2025 展会

    赋能AI未来!康盈半导体 AI 应用存储新品登陆 elexcon 2025 展会赋能AI未来!康盈半导体 AI 应用存储新品登陆 elexcon 2025 展会赋能AI未来!康盈半导体 AI 应用存储新品登陆 elexcon 2025 展会赋能AI未来!康盈半导体 AI 应用存储新品登陆 elexcon 2025 展会

    8 月 26 日,中国电子、嵌入式及半导体先进封测行业的风向标 ——elexcon2025 深圳国际电子展暨嵌入式展盛大开幕。作为本届展会的重磅环节之一,国产存储领军品牌康盈半导体携新而来,以 “小而不凡,速启 ai 未来” 为核心主题,正式发布 2025 年存储新品,同步拉开面向 ai 终端应用的…

    2026年9月24日 用户投稿
    000
  • Java中固定长度用户ID输入验证:解决int类型长度检查问题

    本文详细介绍了在Java程序中如何实现用户输入固定长度ID的验证机制。针对常见的int cannot be dereferenced错误,我们将探讨将ID作为字符串读取并进行长度及格式校验的最佳实践,并提供处理字母数字型和纯数字型ID的示例代码,确保数据输入的准确性和程序的健壮性。 引言:用户输入验…

    2026年9月24日
    500
  • 数据实时迁移同步工具 CloudCanal v5.2.0.0 发布,支持 SaaS 全托管

    cloudcanal 免费社区版 是 clougence 公司推出的一款全自研、可视化、自动化数据迁移同步工具,具备 结构迁移、数据迁移、数据同步、数据校验、数据订正 等功能,支持 60+ 款流行关系型数据库、实时数仓、消息中间件、缓存数据库和搜索引擎之间数据互通,其中包含国产数据库 oceanba…

    2026年9月24日
    000
  • VSCode如何实现AI代码反混淆 VSCode智能分析混淆代码的技巧

    vscode没有一键ai反混淆功能,但可通过智能扩展、调试器、ast查看器、代码格式化工具及外部ai工具集成来辅助分析和逐步还原混淆代码;2. 利用eslint、prettier等扩展提升代码可读性,通过“重命名符号”“转到定义”“查找引用”等功能追踪变量和函数流向,结合多光标编辑和代码片段进行手动…

    2026年9月24日
    100
  • Laravel 表单验证失败后保留输入值:最佳实践教程

    本文旨在帮助 Laravel 开发者解决表单验证失败后,如何保留用户已输入数据的问题。我们将深入探讨 withInput() 方法的使用,并提供清晰的代码示例,确保即使在验证失败的情况下,用户体验也能保持流畅。通过本文的学习,你将掌握在 Laravel 中优雅地处理表单验证,并提升应用的可用性。 在…

    2026年9月24日
    000
  • 怎么在mysql中创建数据库表 mysql建表完整流程解析

    在 mysql 中创建数据库表的步骤包括:1) 选择合适的数据类型,如 int、varchar、timestamp;2) 设置索引,如主键和唯一索引;3) 应用约束条件,如 not null 和 unique;4) 设计表结构以满足业务需求,如使用 foreign key 和 enum;5) 优化性…

    2026年9月24日
    000
  • 生成Java中全范围正Double随机数的正确方法

    本文旨在指导开发者如何在Java中生成覆盖整个正Double范围的随机数,并解释了使用ThreadLocalRandom.nextDouble(Double.MIN_VALUE, Double.MAX_VALUE)可能产生偏差的原因。我们将提供一种基于位操作的替代方案,确保生成的随机数在Double…

    2026年9月24日
    100
  • PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验

    PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验

    8月27日晚,根据权威独立测评平台 artificial analysis 最新测试结果,爱诗科技发布的pixverse v5 新一代自研视频生成大模型,在图生视频(image to video)项目中排名全球 top2,在文生视频(text to video)项目中位列 top3,保持在全球第一梯…

    2026年9月24日 用户投稿
    100
  • hive安装配置实验

    一、安装前的准备工作 1. 配置并安装hadoop,请参考链接http://blog.csdn.net/wzy0623/article/details/50681554。 2. 下载以下安装包:mysql-5.7.10-linux-glibc2.5-x86_64.tar.gz、apache-hive…

    2026年9月24日
    600
  • 大学论文怎么写?让AI工具助你一臂之力

    大学论文怎么写?让AI工具助你一臂之力大学论文怎么写?让AI工具助你一臂之力大学论文怎么写?让AI工具助你一臂之力大学论文怎么写?让AI工具助你一臂之力

    如果要选出大学学习过程中最令人头疼的事,写论文无疑能稳居榜首。从选题开题、内容撰写,到翻译润色、查重降重,每个步骤都耗时耗力,让人焦头烂额。然而,随着 ai 技术的发展,如今写论文这件事,已经可以借助智能工具变得更高效、更轻松。 开题太难?AI 来帮你破局! 论文的第一道难关就是开题。面对浩如烟海的…

    2026年9月24日 用户投稿
    100
  • 使用 PHP 解析 JSON 文件并在网页上显示特定数据

    本文旨在帮助开发者学习如何使用 PHP 解析 JSON 文件,并提取其中的特定数据,将其以结构化的方式展示在网页上。我们将通过一个简单的示例,演示如何读取 JSON 数据,解析成 PHP 数组,并最终以 HTML 表格的形式呈现。 PHP 解析 JSON 数据 JSON (JavaScript Ob…

    2026年9月24日
    100
  • OriginOS 6 深度体验:当操作系统回归「体验为王」

    OriginOS 6 深度体验:当操作系统回归「体验为王」OriginOS 6 深度体验:当操作系统回归「体验为王」OriginOS 6 深度体验:当操作系统回归「体验为王」OriginOS 6 深度体验:当操作系统回归「体验为王」

    2020 年,智能手机刚刚进入 5g 普及阶段,手机的硬件与软件都迎来了一次迭代浪潮——新形态的需求对操作系统的设计与交互都提出了诸多新的问题,originos 的首个版本,可以看作 vivo对这些问题的回答。 彼时,我曾有机会与 OriginOS 开发团队沟通,正如 OriginOS 的中文名原 …

    2026年9月24日 用户投稿
    100
  • 如何在PHP的require语句中传递参数并有效管理变量作用域

    本文探讨了在php中使用`require`或`include`语句时如何向被引入文件传递参数。文章详细阐述了通过直接变量作用域共享、利用`$_get`超全局变量(不推荐)以及将引入文件内容封装为函数或类(推荐最佳实践)这三种方法,并提供了相应的代码示例,旨在帮助开发者理解和选择最适合其场景的参数传递…

    2026年9月24日
    000
  • DeepArt的AI混合工具怎么操作?快速生成艺术风格图像的方法

    使用DeepArt类工具时,先选匹配的风格图与内容图,调节风格强度避免失真,推荐尝试Artbreeder、RunwayML、NightCafe等多元平台以提升创作效果。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ DeepArt的AI混合…

    2026年9月24日
    000
  • 如何用COUNT函数统计行数?处理NULL值时SUM/AVG函数的注意事项

    如何用COUNT函数统计行数?处理NULL值时SUM/AVG函数的注意事项如何用COUNT函数统计行数?处理NULL值时SUM/AVG函数的注意事项如何用COUNT函数统计行数?处理NULL值时SUM/AVG函数的注意事项如何用COUNT函数统计行数?处理NULL值时SUM/AVG函数的注意事项

    count函数统计行数时需注意使用方式,count(*)统计所有行包括null值,count(column_name)仅统计非null值。sum和avg函数均忽略null值,可能导致计算偏差,可通过coalesce或case语句处理。明确需求后选择合适方法,并注意数据类型与测试验证以避免错误。 CO…

    2026年9月24日 用户投稿
    000
  • Pages如何协作修改文档 Pages跟踪修改和建议的用法

    使用Pages的协作与修订功能可高效编辑文档,先启用共享邀请协作者,再通过建议模式提出修改,所有更改以标记形式显示,经审查后接受或拒绝,最终关闭修订模式保存定稿。 如果您正在与团队成员共同编辑一份文档,但希望保留原始内容并记录所有更改建议,可以使用 Pages 的协作与修订功能来实现高效沟通。通过这…

    2026年9月24日
    100
  • Polarr的AI工具怎么裁剪图片?教你轻松实现高效图像裁剪

    Polarr的AI工具怎么裁剪图片?教你轻松实现高效图像裁剪Polarr的AI工具怎么裁剪图片?教你轻松实现高效图像裁剪Polarr的AI工具怎么裁剪图片?教你轻松实现高效图像裁剪Polarr的AI工具怎么裁剪图片?教你轻松实现高效图像裁剪

    Polarr的AI裁剪通过内容感知智能识别主体与构图焦点,提供如主体居中、构图优化和比例推荐等方案,操作上先导入图片,选择裁剪工具后AI即分析画面并生成多个推荐预设,用户可直接应用或手动微调,相比传统裁剪显著提升效率、辅助构图决策,尤其适用于社交媒体多平台比例适配,帮助保持视觉一致性并避免关键信息被…

    2026年9月24日 用户投稿
    600

发表回复

登录后才能评论
关注微信