Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
Java中高效读取结构化文本数据并填充二维数组指南_创想鸟

Java中高效读取结构化文本数据并填充二维数组指南

Java中高效读取结构化文本数据并填充二维数组指南

本文旨在指导读者如何使用Java的Scanner类高效地从结构化文本文件中读取数据,并将其正确地填充到二维数组中。我们将重点解决常见的数组维度定义错误和不必要的字符串分割问题,通过一个具体的例子展示如何简洁、准确地处理每行包含固定数量整数的输入,确保数据正确映射到二维数组。

概述与问题背景

在java编程中,经常需要从外部文件读取结构化数据。一个常见的场景是,文件首行包含一个整数n,表示后续将有n行数据,每行数据包含固定数量(例如两个)的整数,这些整数需要被存储到一个二维数组中。例如,输入文件可能如下所示:

42 21 34 73 4

这里,4表示后续有4行数据,每行包含两个整数。我们的目标是将(2,2)存入array[0][0]和array[0][1],将(1,3)存入array[1][0]和array[1][1],依此类推。

初学者在处理这类问题时,常会遇到以下两个主要误区:

二维数组维度定义错误: 根据问题描述,每行只有两个整数,但有时会错误地将二维数组定义为new int[num][num],导致数组空间浪费或索引越界。文件读取与解析效率低下: 试图先使用nextLine()读取整行字符串,然后再通过split()方法分割字符串并转换成整数。这种方法虽然可行,但在Scanner类已经提供更直接的整数读取功能时,显得冗余且效率不高。

正确的解决方案:利用Scanner高效读取

Java的Scanner类提供了强大的文本解析能力。对于以空格分隔的整数,Scanner的nextInt()方法能够自动跳过分隔符(包括空格、制表符、换行符等)并读取下一个整数,这极大地简化了数据解析过程。

以下是解决上述问题的正确且高效的代码实现:

立即学习“Java免费学习笔记(深入)”;

import java.util.Scanner;import java.io.File;import java.io.FileNotFoundException;public class DataReader {    public static void main(String[] args) {        // 假设输入文件名为 "input.txt"        File inputFile = new File("input.txt");         Scanner scan = null;        try {            scan = new Scanner(inputFile);            // 1. 读取第一行,获取数据行数N            int numRows = scan.nextInt();             // 2. 正确初始化二维数组            // 每行固定有2个整数,所以列数为2            int[][] dataArray = new int[numRows][2];             // 3. 循环读取后续N行数据并填充数组            for (int i = 0; i < numRows; i++) {                for (int j = 0; j < dataArray[i].length; j++) { // 每行读取2个整数                    dataArray[i][j] = scan.nextInt();                }            }            // 打印数组内容以验证读取结果            System.out.println("成功读取数据并填充二维数组:");            for (int i = 0; i < numRows; i++) {                for (int j = 0; j < dataArray[i].length; j++) {                    System.out.print(dataArray[i][j] + " ");                }                System.out.println();            }        } catch (FileNotFoundException e) {            System.err.println("错误:文件未找到 - " + e.getMessage());        } finally {            if (scan != null) {                scan.close(); // 确保关闭Scanner资源            }        }    }}

代码解析:

文件与Scanner初始化:首先创建一个File对象指向输入文件。然后使用try-catch-finally结构初始化Scanner,以处理FileNotFoundException并确保Scanner资源最终被关闭。读取行数N:int numRows = scan.nextInt();:Scanner会自动读取文件中的第一个整数(即N),并将其赋值给numRows。此时,Scanner的内部指针已移动到第一个整数之后,准备读取后续数据。二维数组的正确初始化:int[][] dataArray = new int[numRows][2];:这是关键一步。根据问题描述,我们知道每行数据只包含两个整数,因此二维数组的列数应该固定为2,而不是numRows。这样既节省了内存,也避免了潜在的索引错误。循环读取并填充数组:外层循环for (int i = 0; i < numRows; i++):控制读取的行数,即N次。内层循环for (int j = 0; j < dataArray[i].length; j++):控制每行读取的列数。dataArray[i].length在这里始终为2。dataArray[i][j] = scan.nextInt();:在每次内层循环中,scan.nextInt()会从文件中读取下一个可用的整数,并将其直接赋值给二维数组的相应位置。Scanner会自动处理整数之间的空格和换行符,无需手动进行字符串分割。

注意事项与最佳实践

资源管理: 始终确保在文件操作完成后关闭Scanner(或其他I/O流),以释放系统资源。使用try-with-resources语句(Java 7及更高版本)可以更简洁地实现这一点。

try (Scanner scan = new Scanner(inputFile)) {    // ... 文件读取逻辑 ...} catch (FileNotFoundException e) {    System.err.println("错误:文件未找到 - " + e.getMessage());}

输入格式验证: 上述代码假设输入文件严格遵循预期的格式。在实际应用中,你可能需要添加额外的错误处理机制,例如检查scan.hasNextInt()以确保下一个token确实是整数,或者处理非预期的输入格式。其他数据类型: Scanner不仅可以读取整数,还提供了nextLong()、nextDouble()、nextBoolean()、next()(读取下一个字符串token)以及nextLine()(读取整行字符串)等方法,可以根据具体需求选择使用。性能考量: 对于非常大的文件,Scanner可能不是最高效的读取方式。在需要极致性能的场景下,可以考虑使用BufferedReader结合String.split()或StringTokenizer,但这会增加代码的复杂性。对于大多数常见的教学和中小型应用场景,Scanner已经足够高效和方便。

总结

通过本教程,我们学习了如何利用Java Scanner类高效、准确地从结构化文本文件中读取数据并填充到二维数组中。关键在于正确定义二维数组的维度,并充分利用Scanner的nextInt()方法自动解析整数token的特性,避免了不必要的字符串操作,使代码更加简洁、健壮。掌握这种方法,将有助于更有效地处理各种文件输入任务。

以上就是Java中高效读取结构化文本数据并填充二维数组指南的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/84789.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
客户管理制度怎么办
上一篇 2025年11月17日 01:26:28
客户怎么分配管理工作的
下一篇 2025年11月17日 01:26:45

相关推荐

  • 豆包是否可以本地部署 自主可控环境下运行豆包的技术路径说明

    本文旨在解答关于豆包是否可以在本地环境下进行部署并实现自主可控运行的问题。目前,豆包主要以云服务形式提供,用户通过网络访问其功能。要在自主可控的环境下运行类似的大型语言模型能力,通常需要采用不同的技术路径,即在本地计算资源上部署可用的AI模型。本文将概述实现本地自主可控AI运行的通用技术路线和关键步…

    2026年9月25日
    300
  • 荣耀 300 系列系统升级,后续多款新机待发

    荣耀 300 系列系统升级,后续多款新机待发荣耀 300 系列系统升级,后续多款新机待发荣耀 300 系列系统升级,后续多款新机待发荣耀 300 系列系统升级,后续多款新机待发

    日前,荣耀 300 系列手机迎来 magicos 9.0.0.187 版本升级,此次更新带来了清理建议、ai 通话等多项新功能,系统升级将以分批推送的形式逐步覆盖用户。 本次更新的主要亮点如下: 图库方面新增“清理建议”功能,可智能识别重复照片、相似图片及超大视频,帮助用户更高效地管理存储空间; 通…

    2026年9月25日 • 用户投稿
    500
  • 动态缓存键在Spring Boot中的实现教程

    动态缓存键在Spring Boot中的实现教程动态缓存键在Spring Boot中的实现教程动态缓存键在Spring Boot中的实现教程动态缓存键在Spring Boot中的实现教程

    本文介绍了如何在Spring Boot应用中实现基于请求参数的动态缓存键。通过直接操作CacheManager获取缓存对象,并使用cache.get(key, () -> …)方法,可以灵活地根据请求参数生成缓存键,从而实现更精细化的缓存控制。这种方法避免了直接修改缓存名称,而是专…

    2026年9月25日 • 用户投稿
    700
  • sublime怎么配置eslint进行js校验_sublime集成ESLint代码检查配置

    sublime怎么配置eslint进行js校验_sublime集成ESLint代码检查配置sublime怎么配置eslint进行js校验_sublime集成ESLint代码检查配置sublime怎么配置eslint进行js校验_sublime集成ESLint代码检查配置sublime怎么配置eslint进行js校验_sublime集成ESLint代码检查配置

    首先安装SublimeLinter和SublimeLinter-eslint插件,确保系统或项目中已安装ESLint;通过npx eslint –init生成配置文件;插件会自动调用项目内的eslint,若未识别可手动设置executable路径;保存JavaScript文件时即可实时显…

    2026年9月25日 • 用户投稿
    000
  • sublime怎么设置字体和字号 _sublime字体与字号调整方法

    sublime怎么设置字体和字号 _sublime字体与字号调整方法sublime怎么设置字体和字号 _sublime字体与字号调整方法sublime怎么设置字体和字号 _sublime字体与字号调整方法sublime怎么设置字体和字号 _sublime字体与字号调整方法

    先修改用户设置文件以调整字体和字号,打开Preferences → Settings,在右侧User配置中添加”font_face”和”font_size”选项,如{“font_face”: “Fira Code&#…

    2026年9月25日 • 用户投稿
    000
  • Java 8 使用 Stream API 扁平化嵌套 Map 并提取首个元素

    Java 8 使用 Stream API 扁平化嵌套 Map 并提取首个元素Java 8 使用 Stream API 扁平化嵌套 Map 并提取首个元素Java 8 使用 Stream API 扁平化嵌套 Map 并提取首个元素Java 8 使用 Stream API 扁平化嵌套 Map 并提取首个元素

    本文将详细介绍如何使用 Java 8 的 Stream API 将一个嵌套的 Map 结构进行扁平化处理,并从中提取所需的数据。 具体来说,我们将把 Map<Integer, Map<String, List>> 转换为 Map,其中新 Map 的键是原内部 Map 的键,值…

    2026年9月25日 • 用户投稿
    1200
  • 首个对话式音乐创作 Agent“Tunee”正式公测

    首个对话式音乐创作 Agent“Tunee”正式公测首个对话式音乐创作 Agent“Tunee”正式公测首个对话式音乐创作 Agent“Tunee”正式公测首个对话式音乐创作 Agent“Tunee”正式公测

    趣丸科技旗下天谱乐团队自主研发的国内首款对话式音乐创作agent“tunee”近日正式启动全球公测,全面向公众开放使用。 据悉,用户只需通过自然语言描述自己的音乐设想,即便表达模糊,Tunee也能自动完成需求解析、方案设计到实际作曲的完整流程,最终输出契合用户意图的原创音乐作品。 Tunee采用先进…

    2026年9月25日 • 用户投稿
    500
  • Debian syslog如何定制报警机制

    Debian syslog如何定制报警机制Debian syslog如何定制报警机制Debian syslog如何定制报警机制Debian syslog如何定制报警机制

    本文介绍如何在Debian系统中定制syslog报警机制,利用rsyslog实现更灵活的日志监控和告警。 首先,确保已安装rsyslog: sudo apt-get updatesudo apt-get install rsyslog 接下来,修改rsyslog配置文件,/etc/rsyslog.c…

    2026年9月25日 • 用户投稿
    100
  • 对话逐际动力张巍:造机器人很容易,关键是用起来

    对话逐际动力张巍:造机器人很容易,关键是用起来对话逐际动力张巍:造机器人很容易,关键是用起来对话逐际动力张巍:造机器人很容易,关键是用起来对话逐际动力张巍:造机器人很容易,关键是用起来

    “让天下没有难落地的机器人。” 在这样向量子位表达定位和使命后,逐际动力”解释了”为何会成为阿里投资的第一家具身智能机器人公司。 在这样解释定位和使命后,量子位大概感受到了逐际动力被投资的原因—— 至少是成为阿里第一个具身智能投资项目的原因。 实际上,…

    2026年9月25日 • 用户投稿
    500
  • 修改 Android KeyStore 中 KeyPair 的用途

    修改 Android KeyStore 中 KeyPair 的用途修改 Android KeyStore 中 KeyPair 的用途修改 Android KeyStore 中 KeyPair 的用途修改 Android KeyStore 中 KeyPair 的用途

    本文档介绍了如何在 Android KeyStore 中修改现有 KeyPair 的用途,使其支持密钥协商 (Key Agreement) 操作。通过示例代码展示了如何利用 KeyStore.setEntry 方法在 Android 13 (API 33) 及以上版本中导入 KeyPair 并设置所…

    2026年9月25日 • 用户投稿
    600
  • 专业横评便携微单:佳能R50V凭6K超采样+精准快速追焦 成 8000 元内全能首选

    专业横评便携微单:佳能R50V凭6K超采样+精准快速追焦  成 8000 元内全能首选专业横评便携微单:佳能R50V凭6K超采样+精准快速追焦  成 8000 元内全能首选专业横评便携微单:佳能R50V凭6K超采样+精准快速追焦  成 8000 元内全能首选专业横评便携微单:佳能R50V凭6K超采样+精准快速追焦  成 8000 元内全能首选

    随着旅行摄影与短视频创作的需求激增,便携微单已成为多数用户的核心影像工具。面对 8000元以下微单市场的繁杂选择,专业影像评测团队通过150小时实测(涵盖画质解析力、防抖稳定性、低光对焦等 15 项核心指标),结合近万份用户口碑反馈,筛选出 3 款高潜力机型。其中佳能 R50V 凭借“画质无短板、便…

    2026年9月25日 • 用户投稿
    200
  • AI Overviews是否具备个性化推荐机制 个性推荐背后的逻辑与调整方法

    AI Overviews是否具备个性化推荐机制 个性推荐背后的逻辑与调整方法AI Overviews是否具备个性化推荐机制 个性推荐背后的逻辑与调整方法AI Overviews是否具备个性化推荐机制 个性推荐背后的逻辑与调整方法AI Overviews是否具备个性化推荐机制 个性推荐背后的逻辑与调整方法

    AI Overviews在提供信息摘要时,确实融入了个性化推荐机制。本文将深入探讨这一机制的原理、其背后的逻辑以及用户可能影响或理解其个性化倾向的一些方法。我们将分步骤解析这一过程,帮助用户更好地理解和利用AI Overviews的功能。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无…

    2026年9月25日 • 用户投稿
    000
  • 并发处理共享列表并收集结果的方案

    并发处理共享列表并收集结果的方案并发处理共享列表并收集结果的方案并发处理共享列表并收集结果的方案并发处理共享列表并收集结果的方案

    本文旨在介绍如何利用 Java 并行流高效地处理大型列表,尤其是在每个元素的处理过程耗时较长的情况下。并行流能够将列表分割成多个子任务,并在多个线程上并发执行,从而显著提升处理速度。但同时,并发编程也带来了共享资源同步的问题,需要谨慎处理。 使用并行流并发处理列表 假设我们有一个 Foo 类,其 p…

    2026年9月25日 • 用户投稿
    000
  • 参加PHP+MySQL就业培训后能获得的岗位有哪些

    参加php+mysql就业培训后,你可以获得以下岗位:1. web开发工程师,利用php和mysql开发动态网站和web应用程序;2. 后端开发工程师,使用php构建后端服务和api;3. 全栈开发工程师,结合前端技术进行全站开发;4. 数据库管理员,负责mysql数据库的设计、优化和维护;5. 软…

    2026年9月25日
    400
  • 高效并发处理共享列表与结果收集的Java教程

    高效并发处理共享列表与结果收集的Java教程高效并发处理共享列表与结果收集的Java教程高效并发处理共享列表与结果收集的Java教程高效并发处理共享列表与结果收集的Java教程

    本文介绍了如何利用Java并发特性,特别是并行流(Parallel Streams),来高效处理共享列表,并将处理结果进行收集。针对耗时操作,通过将列表分割成子列表,并利用并行流并发执行,可以显著提高处理效率。同时,强调了在并发环境下对共享资源进行同步的重要性,并提供了收集处理结果的示例代码。 在处…

    2026年9月25日 • 用户投稿
    000
  • AI Overviews能否用于电商搜索 产品信息摘要在购物场景下的使用体验

    AI Overviews能否用于电商搜索 产品信息摘要在购物场景下的使用体验AI Overviews能否用于电商搜索 产品信息摘要在购物场景下的使用体验AI Overviews能否用于电商搜索 产品信息摘要在购物场景下的使用体验AI Overviews能否用于电商搜索 产品信息摘要在购物场景下的使用体验

    随着人工智能技术的发展,AI Overviews作为一种通过整合信息提供摘要的搜索功能,正逐渐改变用户获取信息的方式。本文将探讨AI Overviews是否以及如何在电商搜索场景下应用,特别关注产品信息摘要对于用户购物体验的影响。我们将讲解其运作原理、潜在优势、面临挑战以及优化体验的过程,帮助理解这…

    2026年9月25日 • 用户投稿
    000
  • AI 图像水印失守!开源工具 5 分钟内抹除所有水印

    AI 图像水印失守!开源工具 5 分钟内抹除所有水印AI 图像水印失守!开源工具 5 分钟内抹除所有水印AI 图像水印失守!开源工具 5 分钟内抹除所有水印AI 图像水印失守!开源工具 5 分钟内抹除所有水印

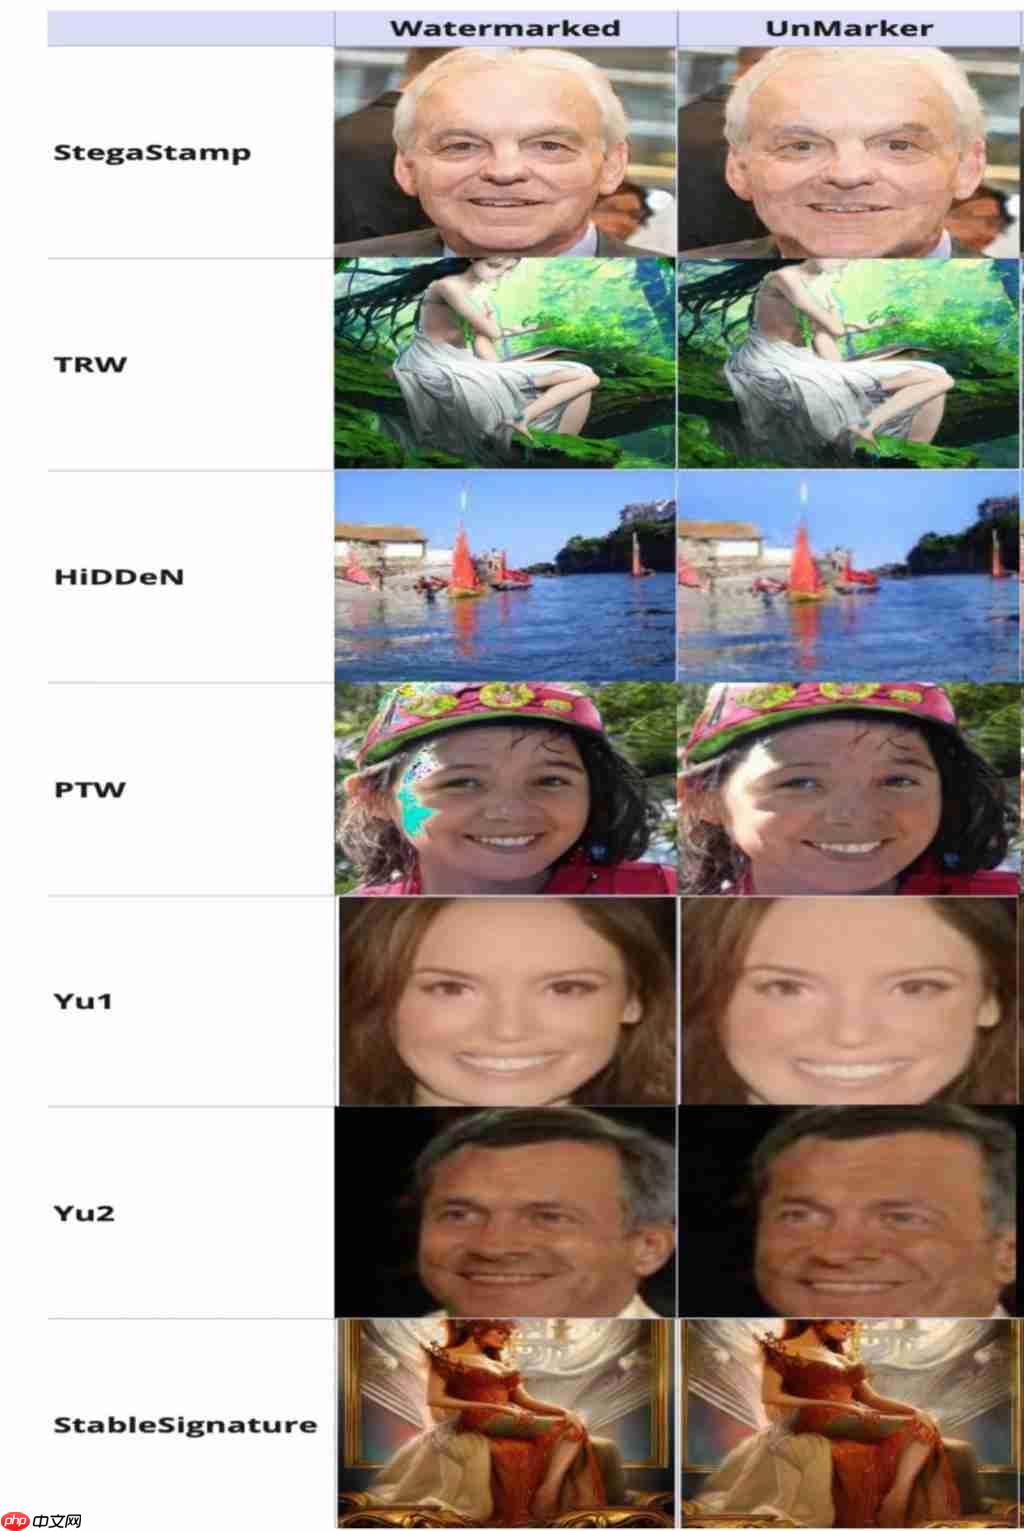
    ai 图像的水印技术正面临重大挑战! 一种名为 UnMarker 的新型去水印技术横空出世,宣称可在短短5分钟内清除市面上绝大多数 AI 生成图像中的水印。 该技术已成功完全破解谷歌的 HiDDeN 水印系统,对另一款 Google 水印技术 SynthID 的破解率也达到了79%。 更令人震惊的是…

    2026年9月25日 • 用户投稿
    000
  • AI Overviews与传统摘要工具有何不同 模型机制与结果效果的差异分析

    AI Overviews与传统摘要工具有何不同 模型机制与结果效果的差异分析AI Overviews与传统摘要工具有何不同 模型机制与结果效果的差异分析AI Overviews与传统摘要工具有何不同 模型机制与结果效果的差异分析AI Overviews与传统摘要工具有何不同 模型机制与结果效果的差异分析

    本文将探讨AI Overviews与传统摘要工具之间的核心差异,重点分析它们在模型机制和结果效果上的不同。通过理解这两种技术的底层原理和最终呈现形式,用户可以更好地认识到它们各自的优势和应用场景。文章将分步讲解这些差异点,帮助您掌握如何区分并理解它们的工作方式。 ☞☞☞AI 智能聊天, 问答助手, …

    2026年9月25日 • 用户投稿
    000
  • 使用并行流并发处理共享列表并收集结果

    使用并行流并发处理共享列表并收集结果使用并行流并发处理共享列表并收集结果使用并行流并发处理共享列表并收集结果使用并行流并发处理共享列表并收集结果

    本文将探讨如何高效地并发处理共享列表,并收集处理结果。在处理大量数据时,将任务分解为多个子任务并行执行可以显著提高效率。Java 8引入的并行流(Parallel Streams)为我们提供了一种简洁而强大的方式来实现这一目标。 并行流简介 并行流是Java 8 Stream API的一个特性,它允…

    2026年9月25日 • 用户投稿
    400
  • 如何在微服务之间共享静态数据

    如何在微服务之间共享静态数据如何在微服务之间共享静态数据如何在微服务之间共享静态数据如何在微服务之间共享静态数据

    微服务架构的本质决定了微服务之间无法直接共享静态变量。正如上面摘要所说,每个微服务都是一个独立的进程,拥有自己的内存空间,静态变量只在其所属的进程内有效。试图在一个微服务中访问另一个微服务的静态变量,就像试图在一个独立的Java程序中访问另一个程序的变量一样,是不可能的。 微服务架构的独立性 微服务…

    2026年9月25日 • 用户投稿
    100

发表回复

登录后才能评论
关注微信