干货满满!大神Karpathy两小时AI大课文字版第一弹,全新工作流自动把视频转成文章

前段时间,AI大神Karpathy上线的AI大课,已经收获了全网15万次播放量。

当时还有网友表示,这2小时课程的含金量,相当于大学4年。

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜

干货满满!大神Karpathy两小时AI大课文字版第一弹,全新工作流自动把视频转成文章

就在这几天,Karpathy又萌生了一个新的想法:

将2小时13分钟的“从头开始构建gpt分词器”视频内容转化为书中的章节或博客文章的形式,着重探讨“分词”这一主题。

具体步骤如下:

– 为视频添加字幕或解说文字。

– 将视频切割成若干带有配套图片和文字的段落。

– 利用大语言模型的提示工程技术,逐段进行翻译。

– 将结果输出为网页形式,其中包含指向原始视频各部分的链接。

更广泛地说,这样的工作流程可以应用于任何视频输入,自动生成各种教程的「配套指南」,使其格式更加便于阅读、浏览和搜索。

这听起来是可行的,但也颇具挑战。

干货满满!大神Karpathy两小时AI大课文字版第一弹,全新工作流自动把视频转成文章

他在GitHub项目minbpe下,写了一个例子来阐述自己的想象。

干货满满!大神Karpathy两小时AI大课文字版第一弹,全新工作流自动把视频转成文章

地址:https://github.com/karpathy/minbpe/blob/master/lecture.md

Karpathy表示,这是自己手动完成的任务,即观看视频并将其翻译成markdown格式的文章。

「我只看了大约4分钟的视频(即完成了3%),而这已经用了大约30分钟来写,所以如果能自动完成这样的工作就太好了」。

干货满满!大神Karpathy两小时AI大课文字版第一弹,全新工作流自动把视频转成文章

接下来,就是上课时间了!

「LLM分词」课程文字版

大家好,今天我们将探讨LLM中的「分词」问题。

遗憾的是,「分词」是目前最领先的大模型中,一个相对复杂和棘手的组成部分,但我们有必要对其进行详细了解。

因为LLM的许多缺陷可能归咎于神经网络,或其他看似神秘的因素,而这些缺陷实际上都可以追溯到「分词」。

字符级分词

那么,什么是分词呢?

事实上,在之前的视频《让我们从零开始构建 GPT》中,我已经介绍过分词,但那只是一个非常简单的字符级版本。

如果你去Google colab查看那个视频,你会发现我们从训练数据(莎士比亚)开始,它只是Python中的一个大字符串:

First Citizen: Before we proceed any further, hear me speak.All: Speak, speak.First Citizen: You are all resolved rather to die than to famish?All: Resolved. resolved.First Citizen: First, you know Caius Marcius is chief enemy to the people.All: We know't, we know't.

但是,我们如何将字符串输入LLM呢?

我们可以看到,我们首先要为整个训练集中的所有可能字符,构建一个词汇表:

# here are all the unique characters that occur in this textchars = sorted(list(set(text)))vocab_size = len(chars)print(''.join(chars))print(vocab_size)# !$&',-.3:;?ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz# 65

然后根据上面的词汇表,创建用于在单个字符和整数之间进行转换的查找表。此查找表只是一个Python字典:

stoi = { ch:i for i,ch in enumerate(chars) }itos = { i:ch for i,ch in enumerate(chars) }# encoder: take a string, output a list of integersencode = lambda s: [stoi[c] for c in s]# decoder: take a list of integers, output a stringdecode = lambda l: ''.join([itos[i] for i in l])print(encode("hii there"))print(decode(encode("hii there")))# [46, 47, 47, 1, 58, 46, 43, 56, 43]# hii there

一旦我们将一个字符串转换成一个整数序列,我们就会看到每个整数,都被用作可训练参数的二维嵌入的索引。

因为我们的词汇表大小为 vocab_size=65 ,所以该嵌入表也将有65行:

class BigramLanguageModel(nn.Module):def __init__(self, vocab_size):super().__init__()self.token_embedding_table = nn.Embedding(vocab_size, n_embd)def forward(self, idx, targets=None):tok_emb = self.token_embedding_table(idx) # (B,T,C)

在这里,整数从嵌入表中「提取」出一行,这一行就是代表该分词的向量。然后,该向量将作为相应时间步长的输入输入到Transformer。

使用BPE算法进行「字符块」分词

对于「字符级」语言模型的天真设置来说,这一切都很好。

但在实践中,在最先进的语言模型中,人们使用更复杂的方案来构建这些表征词汇。

具体地说,这些方案不是在字符级别上工作,而是在「字符块」级别上工作。构建这些块词汇表的方式是使用字节对编码(BPE)等算法,我们将在下面详细介绍该算法。

暂时回顾一下这种方法的历史发展,将字节级BPE算法用于语言模型分词的论文,是2019年OpenAI发表的GPT-2论文Language Models are Unsupervised Multitask Learners。

干货满满!大神Karpathy两小时AI大课文字版第一弹,全新工作流自动把视频转成文章

论文地址:https://d4mucfpksywv.cloudfront.net/better-language-models/language_models_are_unsupervised_multitask_learners.pdf

向下翻到第2.2节「输入表示」,在那里他们描述并激励这个算法。在这一节的末尾,你会看到他们说:

词汇量扩大到50257个。我们还将上下文大小从512增加到1024个token,并使用512更大batchsize。

回想一下,在Transformer的注意力层中,每个token都与序列中之前的有限token列表相关联。

本文指出,GPT-2模型的上下文长度从GPT-1的512个token,增加到1024个token。

换句话说,token是 LLM 输入端的基本「原子」。

干货满满!大神Karpathy两小时AI大课文字版第一弹,全新工作流自动把视频转成文章

「分词」是将Python中的原始字符串,转换为token列表的过程,反之亦然。

还有一个流行的例子可以证明这种抽象的普遍性,如果你也去Llama 2的论文中搜索「token」,你将得到63个匹配结果。

比如,该论文声称他们在2万亿个token上进行了训练,等等。

干货满满!大神Karpathy两小时AI大课文字版第一弹,全新工作流自动把视频转成文章

论文地址:https://arxiv.org/pdf/2307.09288.pdf
CodeSquire CodeSquire

AI代码编写助手,把你的想法变成代码

CodeSquire 103 查看详情 CodeSquire

浅谈分词的复杂性

在我们深入探讨实现的细节之前,让我们简要地说明一下,需要详细了解「分词」过程的必要性。

分词是LLM中许多许多怪异问题的核心,我建议你不要忽略它。

很多看似神经网络架构的问题,实际上都与分词有关。这里只是几个例子:

– 为什么LLM不会拼写单词?——分词 

– 为什么LLM不能执行超简单的字符串处理任务,比如反转字符串?——分词 

– 为什么LLM在非英语语言(比如日语)任务中更差?——分词 

– 为什么LLM不擅长简单的算术?——分词 

– 为什么GPT-2在用Python编码时遇到了更多的问题?——分词 

– 为什么我的LLM在看到字符串时突然停止?——分词 

– 我收到的关于「trailing whitespace」的奇怪警告是什么?——分词 

– 如果我问LLM关于「SolidGoldMagikarp」的问题,为什么它会崩溃?——分词 

– 为什么我应该使用带有LLM的YAML而不是JSON?——分词 

– 为什么LLM不是真正的端到端语言建模?——分词

干货满满!大神Karpathy两小时AI大课文字版第一弹,全新工作流自动把视频转成文章

我们将在视频的末尾,再回到这些问题上。

分词的可视化预览

接下来,让我们加载这个分词WebApp。

干货满满!大神Karpathy两小时AI大课文字版第一弹,全新工作流自动把视频转成文章

地址:https://tiktokenizer.vercel.app/

这个Web应用程序的优点是,分词在网络浏览器中实时运行,允许你轻松地在输入端输入一些文本字符串,并在右侧看到分词结果。

在顶部,你可以看到我们当前正在使用 gpt2 分词器,并且可以看到,这个示例中粘贴的字符串目前正在分词为 300个token。

在这里,它们用颜色明确显示出来:

干货满满!大神Karpathy两小时AI大课文字版第一弹,全新工作流自动把视频转成文章

比如,字符串「Tokenization」编码到token30642,其后是token是1634。

token「is」(注意,这是三个字符,包括前面的空格,这很重要!)是318。

注意使用空格,因为它在字符串中是绝对存在的,必须与所有其他字符一起分词。但为了清晰可见,在可视化时通常会省略。

你可以在应用程序底部打开和关闭它的可视化功能。同样,token「at」是379,「the」是262,依此类推。

接下来,我们有一个简单的算术例子。

在这里,我们看到,分词器对数字的分解可能不一致。比如,数字127是由3个字符组成的token,但数字677是因为有2个token:6(同样,请注意前面的空格)和77。

我们依靠LLM来解释这种任意性。

它必须在其参数内部和训练过程中,了解这两个token(6和77实际上组合成了数字677)。

同样,我们可以看到,如果LLM想要预测这个总和的结果是数字804,它必须在两个时间步长内输出:

首先,它必须发出token「8」,然后是token「04」。

请注意,所有这些拆分看起来都是完全任意的。在下面的例子中,我们可以看到1275是「12」,然后「75」,6773实际上是三个token「6」、「77」、「3」,而8041是「8」、「041」。

(未完待续…)

(TODO:若想继续文字版的内容,除非我们想出如何从视频中自动生成)

干货满满!大神Karpathy两小时AI大课文字版第一弹,全新工作流自动把视频转成文章

网友在线,出谋划策

网友表示,太好了,实际上我更喜欢阅读这些帖子,而不是看视频,更容易把握自己的节奏。

干货满满!大神Karpathy两小时AI大课文字版第一弹,全新工作流自动把视频转成文章

还有网友为Karpathy出谋划策:

「感觉很棘手,但使用LangChain可能是可行的。我在想是否可以使用whisper转录,产生有清晰章节的高级大纲,然后对这些章节块并行处理,在整体提纲的上下文中,专注于各自章节块的具体内容(也为每个并行处理的章节生成配图)。然后再通过LLM把所有生成的参考标记,汇编到文章末尾」。

干货满满!大神Karpathy两小时AI大课文字版第一弹,全新工作流自动把视频转成文章

有人为此还写了一个pipeline,而且很快便会开源。

以上就是干货满满!大神Karpathy两小时AI大课文字版第一弹,全新工作流自动把视频转成文章的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/868528.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Windows 系统下如何正确安装和配置 composer?
上一篇 2025年11月28日 03:53:12
黄仁勋:我可从没说过中国会赢得中美AI竞赛
下一篇 2025年11月28日 03:53:14

相关推荐

  • 大数据量下的批量导入/导出优化

    在大数据环境下优化批量导入/导出的方法包括:1. 使用批处理技术分批导入/导出数据,减少系统资源压力;2. 采用数据流技术如apache kafka进行实时处理,降低内存占用;3. 利用并行处理技术分配任务到多个处理器或节点,提高处理速度;4. 通过性能监控和调优识别并解决瓶颈点,以提升整体效率。 …

    2026年9月21日
    200
  • 《忍者龙剑传4》明日发售 制作人谈亮点:经典与创新并存!

    白金工作室今日迎来《忍者龙剑传4》(ninja gaiden 4)制作人兼导演中尾裕治的特别公告,正式确认游戏将于10月21日(周二)全球上线。中尾在声明中详细介绍了本作的核心特色,强调在传承系列精髓的同时注入全新机制,为玩家打造既怀旧又充满惊喜的忍者冒险。 特色一:传承与进化的战斗系统 系列经典操…

    2026年9月21日
    000
  • mysqlmysql如何优化in条件大列表查询

    使用EXPLAIN和慢查询日志判断IN性能问题,type为ALL且possible_keys为空或rows过大说明需优化;JOIN在有索引时通常优于IN,尤其当列表值来自另一表时;大IN列表可拆分为多个小IN结合UNION ALL,或存入临时表后用JOIN提升效率。 优化 MySQL 中 IN 条件…

    2026年9月21日
    000
  • 拍摄更强了!vivo X200系列功能升级:舞台模式双视野录像来了

    10月15日,vivo正式公布x200系列功能迭代计划,影像系统与相册体验将迎来多项重磅升级。 据悉,全新的希区柯克式Live Photo功能将支持主体智能追踪,用户可一键实现流畅变焦效果,该功能预计从11月起逐步推送。 舞台模式双视野录制功能将于12月陆续上线, 用户可一键启动前后双摄,录制视频时…

    2026年9月21日
    000
  • Linux怎么踢出指定的登录用户

    要踢出指定登录用户,首先使用w或who命令识别其TTY或会话ID,再通过pkill -KILL -t 强制终止会话,或用loginctl terminate-session 优雅结束;若需防止重新登录,可临时锁定账户(passwd -l)或将用户shell改为/sbin/nologin。 在Linu…

    2026年9月21日
    000
  • edge浏览器如何安装Chrome网上应用店的扩展_edge浏览器安装Chrome扩展方法

    答案:可通过四种方法在Edge浏览器中安装Chrome扩展。1、直接从Chrome网上应用店添加扩展,Edge会自动识别并安装;2、手动下载CRX或ZIP文件,通过开启开发者模式加载已解压的扩展程序;3、从Crx4Chrome等第三方平台下载兼容扩展并按手动方式安装;4、对扩展的manifest.j…

    2026年9月21日
    000
  • 何小鹏称飞行汽车市场份额将超汽车 家庭生活将巨变

    在10月16日启动的可持续全球领导者大会上,小鹏汽车创始人、董事长兼首席执行官何小鹏发表了主题演讲,深入阐述了公司在智能出行与人工智能技术方面的前沿战略。他透露,小鹏汽车预计将在2026年实现飞行汽车的量产,并坚信这一新兴领域的发展速度和市场潜力将远超传统汽车产业。 ☞☞☞AI 智能聊天, 问答助手…

    2026年9月21日
    000
  • iQOO 15开售:2K珠峰屏+自研Q3芯片 重塑手游视效新标杆

    iQOO 15开售:2K珠峰屏+自研Q3芯片 重塑手游视效新标杆iQOO 15开售:2K珠峰屏+自研Q3芯片 重塑手游视效新标杆iQOO 15开售:2K珠峰屏+自研Q3芯片 重塑手游视效新标杆iQOO 15开售:2K珠峰屏+自研Q3芯片 重塑手游视效新标杆

      备受瞩目的“未来性能旗舰”iqoo 15正式开售,起售价为4199元。作为iqoo推出的重磅力作,iqoo 15不仅延续了品牌一贯的硬核性能基因,更以“性能超长板,全面无短板”的产品理念,凭借第五代骁龙8至尊版、自研电竞芯片q3、2k三星珠峰屏、超级潜望长焦等顶级配置,全面刷新了高性能智能手机的…

    2026年9月21日 用户投稿
    100
  • VSCode的快捷键映射冲突怎么办?

    首先查看快捷键绑定情况,通过Ctrl+K再Ctrl+S打开键盘快捷方式界面,搜索目标键组合如Ctrl+Shift+P,查看并识别冲突命令;接着右键冲突命令选择“更改键绑定”设置新组合或删除多余绑定;为精确定位,可查看命令ID如workbench.action.quickOpen区分相似命令;若调整较…

    2026年9月21日
    000
  • 打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?

    打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?

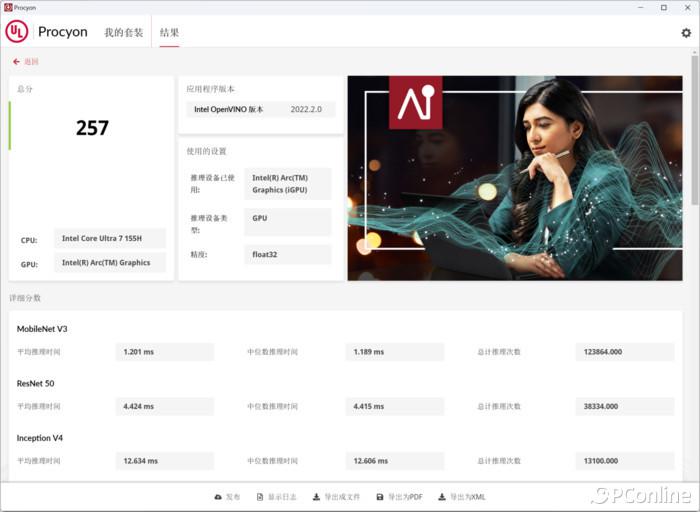
    进入2024年,无论是硬件厂商还是软件供应商,都开始加大力度,向公众宣扬ai对工作生活乃至游戏的影响。在这样的背景下,选择购买一台全新的笔记本,很难不考量它的ai能力对自身使用的影响。因此,我们可以看到办公轻薄本的 ” 常青树 ” ——戴尔灵越系列,也凭借搭载的英特尔酷睿 u…

    2026年9月21日 用户投稿
    400
  • mysql如何排查磁盘IO瓶颈

    首先检查系统级磁盘IO,使用iostat、iotop等工具分析磁盘利用率和进程IO行为;再通过MySQL慢查询日志、sys.schema视图及SHOW ENGINE INNODB STATUS排查高IO消耗的SQL与内部等待事件;接着评估innodb_buffer_pool_size、innodb_…

    2026年9月21日
    000
  • 在Java中如何创建一个天气查询小应用

    注册OpenWeatherMap获取API密钥;2. 使用Java 11+的HttpClient发送HTTP请求;3. 构造带城市参数的URL并调用天气接口;4. 解析返回的JSON数据提取温度和天气描述;5. 在控制台输出结果,支持中文城市需URL编码。 在Java中创建一个天气查询小应用,核心是…

    2026年9月21日
    000
  • 虚拟伴侣AI如何避免对话失误 虚拟伴侣AI错误纠正机制的优化技巧

    虚拟伴侣AI如何避免对话失误 虚拟伴侣AI错误纠正机制的优化技巧虚拟伴侣AI如何避免对话失误 虚拟伴侣AI错误纠正机制的优化技巧虚拟伴侣AI如何避免对话失误 虚拟伴侣AI错误纠正机制的优化技巧虚拟伴侣AI如何避免对话失误 虚拟伴侣AI错误纠正机制的优化技巧

    当虚拟伴侣AI回应出错时,可通过上下文感知纠错、用户反馈校正、多模型交叉验证、角色规则约束和渐进学习控制五项机制优化。一、建立动态上下文缓存池,比对语义一致性并检测情感或人设冲突,触发重生成;二、捕捉用户显式或隐式反馈,主动确认错误并更新对话状态,积累微调数据;三、部署三个专家模型分别评估逻辑、事实…

    2026年9月21日 用户投稿
    100
  • 如何实现多租户(SaaS)架构?

    多租户架构可以通过三种方法实现:1. 数据库隔离,每个租户有自己的数据库,隔离性好但管理复杂;2. 共享数据库,独立schema,管理较简单但仍需schema管理;3. 共享数据库和schema,通过租户id区分数据,管理最简单但隔离性最差。实现多租户架构需要考虑数据隔离、性能优化、扩展性、自定义和…

    2026年9月21日
    100
  • Java字符串字符计数:避免substring()误用与==比较陷阱

    本文旨在解决java字符串字符计数中常见的陷阱,包括对`substring()`方法的误解、使用`==`进行字符串内容比较的错误以及循环边界条件的设置问题。通过深入解析`charat()`、`equals()`方法,并提供正确的代码示例和调试技巧,帮助开发者编写出高效、准确的字符串处理逻辑,避免初学…

    2026年9月21日
    100
  • mysql如何调试事务问题

    首先通过日志和锁信息确认事务状态,1. 启用通用日志追踪事务操作,2. 查询INNODB_TRX和INNODB_LOCK_WAITS分析活跃事务与阻塞关系,3. 查看死锁日志定位冲突原因,4. 调整隔离级别并优化事务逻辑以避免异常。 调试 MySQL 事务问题需要结合日志分析、锁信息查看和事务状态监…

    2026年9月21日
    100
  • 如何自定义代码的格式化规则?

    自定义代码格式化规则需选择合适工具并配置文件实现统一风格。1. 根据语言选用主流工具如Prettier、Black、clang-format等;2. 在项目根目录创建对应配置文件如.prettierrc、.eslintrc.js或pyproject.toml,定义缩进、引号、行宽等规则;3. 将配置…

    2026年9月21日
    100
  • 协程调试与性能分析工具

    我们需要协程调试和性能分析工具是因为协程的异步特性使得传统工具难以应对调试和性能优化挑战。1) pycharm 适合基本调试,但处理大量协程时可能变慢。2) aiodebug 适用于检测协程问题,但会增加性能开销。3) asyncio-profiler 用于分析协程性能,但可能难以解读大量协程的结果…

    2026年9月21日
    100
  • AI推文助手如何制作产品教程 AI推文助手的教学内容创作

    AI推文助手如何制作产品教程 AI推文助手的教学内容创作AI推文助手如何制作产品教程 AI推文助手的教学内容创作AI推文助手如何制作产品教程 AI推文助手的教学内容创作AI推文助手如何制作产品教程 AI推文助手的教学内容创作

    使用AI推文助手可高效制作产品教学内容:一、输入产品功能并选择分步教程模板生成图文教程;二、提供操作关键词生成60秒内短视频脚本;三、启用多语言模块并上传术语表生成本地化推文;四、分析客服数据将高频问题转为步骤化解法推文。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 Dee…

    2026年9月21日 用户投稿
    100
  • 如何利用Draw.io Integration扩展在VSCode中绘制并嵌入架构图?

    安装Draw.io Integration扩展后,可在VSCode中直接创建编辑图表。右键选择“Create Diagram with Draw.io”新建.diagram文件,双击打开内置编辑器,拖拽组件绘制流程图、架构图等。保存后自动生成Base64编码的嵌入代码,粘贴至Markdown即可预览…

    2026年9月21日
    200

发表回复

登录后才能评论
关注微信