细粒度图像分类中的数据不平衡问题

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜

细粒度图像分类中的数据不平衡问题

细粒度图像分类中的数据不平衡问题,需要具体代码示例

细粒度图像分类是指对具有相似视觉特征的物体进行进一步细分和识别。在这个任务中,数据不平衡是一个常见的问题,即不同类别的样本数量存在较大差异,导致模型在训练和测试过程中对数据分布的偏向性,影响了分类的准确性和鲁棒性。为了解决这个问题,我们可以采取一些方法来平衡数据,并提高模型的性能。

数据采样方法

一种常见的方法是欠采样,即随机从数据集中删除一些数量较多的样本,使得每个类别的样本数量相等或接近相等。这种方法简单快捷,但可能会导致信息丢失和样本不足的问题。

另一种方法是过采样,即复制或生成一些数量较少的样本,使得每个类别的样本数量相等或接近相等。过采样可以通过复制样本、生成新样本或插值等方式实现。这种方法可以增加数据的多样性,但可能会导致模型过拟合。

数据增强技术

数据增强是通过对原始数据进行一系列随机变换来增加样本数量和多样性。常用的数据增强技术包括旋转、缩放、平移、镜像翻转、添加噪声等。通过数据增强,可以增加训练集的样本数量,减轻数据不平衡的问题。

Bolt.new Bolt.new

Bolt.new是一个免费的AI全栈开发工具

Bolt.new 466 查看详情 Bolt.new

下面是一个使用PyTorch实现数据增强和欠采样的示例代码:

import torchfrom torch.utils.data import Datasetfrom torch.utils.data import DataLoaderfrom torchvision import transformsfrom imblearn.under_sampling import RandomUnderSamplerclass CustomDataset(Dataset):    def __init__(self, data, targets, transform=None):        self.data = data        self.targets = targets        self.transform = transform    def __len__(self):        return len(self.data)    def __getitem__(self, index):        x = self.data[index]        y = self.targets[index]        if self.transform:            x = self.transform(x)        return x, y# 定义数据增强的transformtransform = transforms.Compose([    transforms.RandomHorizontalFlip(),    transforms.RandomRotation(20),    transforms.ToTensor(),    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])])# 创建自定义数据集dataset = CustomDataset(data, targets, transform=transform)# 使用欠采样方法平衡数据sampler = RandomUnderSampler()data_resampled, targets_resampled = sampler.fit_resample(dataset.data, dataset.targets)# 创建平衡数据的数据集dataset_resampled = CustomDataset(data_resampled, targets_resampled, transform=transform)# 创建数据加载器dataloader = DataLoader(dataset_resampled, batch_size=32, shuffle=True)

在上面的代码中,我们定义了一个自定义数据集类CustomDataset,其中包含了数据增强的transform,通过transforms.Compose()定义了多个数据增强操作。然后使用imbalanced-learn库中的RandomUnderSampler进行欠采样,平衡了样本数量,最后创建了一个平衡数据的数据集dataset_resampled和数据加载器dataloader。

综上所述,细粒度图像分类中的数据不平衡问题可以通过数据采样和数据增强等方法来解决。代码示例中使用了PyTorch和imbalanced-learn库来实现数据增强和欠采样,以提高模型性能和鲁棒性。通过合理使用这些方法,可以有效地解决数据不平衡问题,提升模型在细粒度图像分类任务中的表现。

以上就是细粒度图像分类中的数据不平衡问题的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/899736.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
如何使用 HMPLjs (fetch) 从 API 获取 HTML 并在 DOM 中显示?
上一篇 2025年11月28日 19:39:27
在Java中如何使用断言机制代替部分异常
下一篇 2025年11月28日 19:39:48

相关推荐

  • VSCode怎么弄歌曲_VSCode通过扩展实现背景音乐播放的方法教程

    答案:通过安装扩展可实现在VSCode中播放音乐,推荐使用Code Radio听网络电台,或安装本地音乐播放器扩展导入私人歌单;选择轻量级工具、播放本地文件并合理配置可避免性能影响,提升编码沉浸感与效率。 想在VSCode里边敲代码边听歌,这事儿其实挺简单,核心就是通过安装合适的扩展来实现。它能让你…

    2026年8月31日
    000
  • 零基础也能快速上手宜搭低代码开发?从入门到API应用,你需要了解哪些步骤?

    宜搭低代码开发快速入门指南:从零基础到API应用 许多开发者在学习低代码平台时都会遇到挑战,尤其对于功能强大的宜搭平台更是如此。本文将提供一个循序渐进的学习路径,帮助您快速掌握宜搭低代码开发,并熟练运用流程api。 一位开发者在阅读宜搭文档后,仍然对实际操作和代码编写感到困惑,并询问了学习步骤和证书…

    2026年8月31日
    100
  • 如何解决Drupal自动化测试的复杂性?使用Composer安装DrupalExtension可以!

    可以通过以下地址学习composer:学习地址 在开发drupal网站时,确保其功能和用户体验的质量至关重要。自动化测试是实现这一目标的有效方法,但配置和维护这些测试却常常让人头疼。最近,我在处理一个drupal项目时,遇到了自动化测试设置的复杂问题,尝试了多种方法后,最终通过composer安装d…

    用户投稿 2026年8月31日
    200
  • 怎么查看电脑配置信息?

    怎么查看电脑配置信息?怎么查看电脑配置信息?怎么查看电脑配置信息?怎么查看电脑配置信息?

    电脑的配置是评估一台电脑性能的重要指标,它直接影响到电脑的运行效率。电脑配置通常包括cpu、显卡、主板、内存、硬盘等多个方面。接下来,我将向大家介绍几种简单易懂的方式来查询电脑配置。 如何快速查看电脑配置呢?了解电脑配置对于选购或维护电脑的人来说至关重要,但很多人并不知道从哪里入手。实际上,查看电脑…

    2026年8月31日 用户投稿
    200
  • 夸克浏览器怎么找资源 夸克浏览器免费资源网站入口

    夸克浏览器凭借其简洁的界面和强大的网盘功能,成为了许多用户寻找资源的首选工具。本文将详细介绍如何在夸克浏览器中高效地查找电影、书籍、软件等各类免费资源,并为你指明几个实用的资源网站入口和方法。 一、善用夸克自带的“网盘”功能 1、夸克的核心优势之一便是其深度集成的“夸克网盘”。如今大量的资源分享都基…

    2026年8月31日
    200
  • 豆包和deepseek区别

    豆包和 DeepSeek 的主要区别在于:用法:豆包为传统搜索引擎,DeepSeek 用于深层网络搜索。索引范围:豆包索引公开网络,DeepSeek 索引深层网络。搜索目标:豆包提供广泛搜索结果,DeepSeek 检索特定文件或信息来源。可用性:豆包公开使用,DeepSeek 需付费注册。其他区别:…

    2026年8月31日
    100
  • 如何在NestJS应用中优雅地配置Prisma数据库连接?

    在NestJS应用中灵活配置Prisma数据库连接 本文将演示如何利用@nestjs/config包优雅地配置NestJS应用中的Prisma数据库连接,提升配置的灵活性和可维护性。 首先,确保已安装@nestjs/config和Prisma依赖包。 以下步骤将指导您完成配置: 第一步:创建数据库配…

    2026年8月31日
    100
  • 如何解决Composer依赖版本查询效率低下的问题?ocramius/package-versions助你提升效率

    可以通过一下地址学习composer:学习地址 最近在开发一个需要频繁查询composer依赖版本的项目时,我遇到了一个棘手的问题:每次查询都需要进行i/o操作,导致程序运行效率低下。这不仅影响了用户体验,还增加了系统负载。为了解决这个问题,我尝试了多种方法,最终找到了ocramius/packag…

    用户投稿 2026年8月31日
    300
  • 豆包和deepseek的差距

    豆包和 DeepSee 的主要差距在于用途、规模和复杂性。用途方面,豆包用于数据传输,DeepSee 用于大数据分析。规模方面,豆包处理少量数据,DeepSee 处理海量数据集。复杂性方面,豆包易于使用,DeepSee 需要高级技术技能。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无…

    2026年8月31日
    100
  • MySQL事务锁机制对性能影响_MySQL死锁预防和处理技巧

    MySQL事务锁机制对性能影响_MySQL死锁预防和处理技巧MySQL事务锁机制对性能影响_MySQL死锁预防和处理技巧MySQL事务锁机制对性能影响_MySQL死锁预防和处理技巧MySQL事务锁机制对性能影响_MySQL死锁预防和处理技巧

    mysql的事务锁机制是为保证数据一致性与完整性,通过锁定资源避免并发冲突。其对性能的影响主要体现在阻塞、死锁及锁开销。解决死锁的核心策略包括:1.缩短事务生命周期,减少锁持有时间;2.统一资源访问顺序,打破循环依赖;3.优化sql与索引,缩小锁范围;4.分批次处理大数据操作;5.谨慎调整事务隔离级…

    2026年8月31日 用户投稿
    100
  • 百度搜索 10 年来最大改版,首次支持超千字文本输入

    7 月 2 日消息,在今天的百度 ai day 活动中,百度搜索宣布了近十年来最大规模的界面改版。 百度搜索框现已升级为“智能输入框”,可支持超过千字的文本输入,并在拍照、语音、视频等功能上进行了全面增强,同时还能直接调用 AI 写作、AI 绘图等工具。 据百度方面介绍,搜索框的这一变化背后,是百度…

    2026年8月31日
    600
  • ​​电脑风扇噪音大怎么办?降噪解决方法​​

    电脑风扇噪音大通常由灰尘堆积、风扇老化或负载过高引起,解决方法包括:1. 清洁灰尘,使用压缩空气和软刷清理散热片与风扇,注意固定叶片防止空转损坏;2. 更换老化风扇,尤其是轴承磨损后需更换cpu、显卡或机箱风扇,笔记本建议专业人士操作;3. 重新涂抹导热硅脂,清除旧硅脂并均匀涂抹新硅脂以提升散热效率…

    2026年8月31日
    200
  • 夸克的神秘电影入口 夸克浏览器进入私人影院入口

    夸克浏览器作为一款以极简设计和智能搜索为核心的次世代工具,早已超越了传统浏览器的范畴。它不仅仅是信息获取的窗口,更凭借其强大的内核与集成的多功能模块,为用户悄然构建了一个专属的私人影院。在这个空间里,用户可以摆脱繁杂广告的干扰,通过其独特的智能检索技术,高效触达全网海量的影视资源,享受沉浸式、纯净且…

    2026年8月31日
    100
  • 荣耀 MWC 2024 展区体验:开启 AI 终端时代

    在今年的mwc上,荣耀设立了专门的展区,主题主要聚焦在ai终端。利用magicos 8.0,荣耀成功实现了跨设备的协同办公,并在其硬件产品中加入了多项ai相关功能。 在荣耀展区,他们精心邀请了一位芭蕾舞者,她翩翩起舞的同时,荣耀 Magic 6 Pro手机也在一旁展示其强大的抓拍能力。通过AI算法的…

    2026年8月31日
    100
  • 如何优雅的使用和理解线程池

    如何优雅的使用和理解线程池如何优雅的使用和理解线程池如何优雅的使用和理解线程池如何优雅的使用和理解线程池

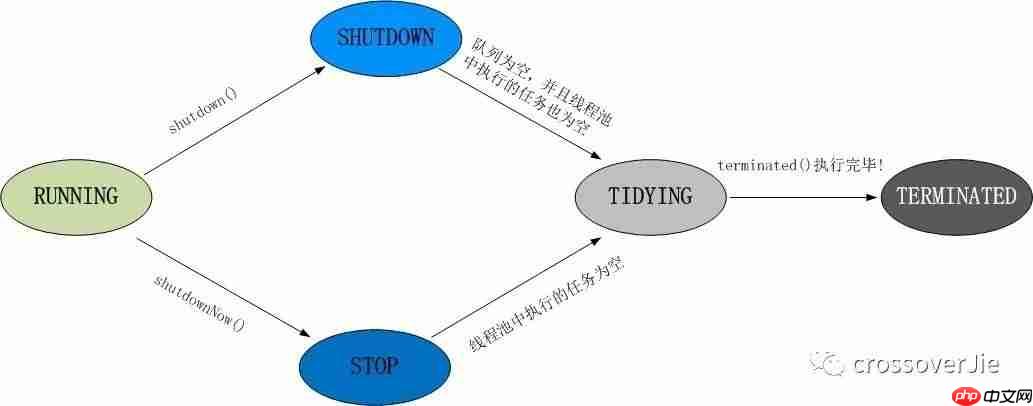
    前言 平时接触过多线程开发的童鞋应该都或多或少了解过线程池,之前发布的《阿里巴巴 java 手册》里也有一条: 可见线程池的重要性。 简单来说使用线程池有以下几个目的: 线程是稀缺资源,不能频繁的创建。解耦作用;线程的创建于执行完全分开,方便维护。应当将其放入一个池子中,可以给其他任务进行复用。线程…

    2026年8月31日 用户投稿
    100
  • Soul聊天记录丢失怎么找回_Soul聊天记录恢复方法

    聊天记录丢失可尝试四种恢复方法:首先检查云端备份,登录账号后在设置中查找“从云端恢复聊天记录”选项并还原;其次查看设备本地缓存,通过应用存储管理寻找可导出的数据,配合第三方工具解析;若因登录异常导致记录未加载,可退出账号重新登录并刷新界面;最后若自助无效,可通过“帮助与反馈”联系官方客服,提交问题详…

    2026年8月31日
    100
  • JavaScript forEach异步操作如何同步化?

    JavaScript forEach 异步操作的同步化处理详解 forEach 方法用于遍历 JavaScript 数组,其默认行为是同步执行。然而,当 forEach 循环体内部包含异步操作(例如 Promise)时,其执行顺序便不再同步。 文章中提到的代码片段试图通过 async/await 来…

    2026年8月31日
    100
  • Android开发中,responseData.data数组返回null值,如何正确解析嵌套JSON数据?

    Android开发:解析嵌套JSON数据及responseData.data数组返回null的解决方法 Android应用开发中,服务器返回的JSON数据常常包含复杂的嵌套结构。例如,responseData包含一个data字段,而data字段的值是一个JSON对象数组。本文探讨一个常见问题:res…

    2026年8月31日
    000
  • 台湾AI伺服器厂商赴美生产,鸿海、广达等布局德州

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 受美国关税政策影响,台湾多家AI服务器厂商正加速在美国建厂,其中德州成为首选之地。鸿海、广达、维创、英业达和仁宝等企业均已将德州列为优先投资地点。据悉,电电公会近期已带领七家AI服务器厂商赴美考…

    2026年8月31日
    500
  • Java Optional.filter方法使用技巧

    Optional.filter用于条件筛选,值存在且满足条件时返回原值封装,否则返回空;可与map等链式调用,实现安全简洁的嵌套数据提取与校验。 Java 中的 Optional.filter 方法是一个非常实用的工具,用于在不破坏 Optional 封装的前提下,对内部值进行条件判断。如果值存在且…

    2026年8月31日
    100

发表回复

登录后才能评论
关注微信