
模型
-
白宫发文,呼吁开发者放弃C、C++:Rust被「钦点」内存安全


最近,白宫国家网络主任办公室(ONCD)在一份长达19页的报告中提出了一个重要观点:开发者应该采用内存安全的编程语言,比如 Rust 语言。这份报告指出,选择内存安全的编程语言是确保软件以安全设计方式开发的关键方法。 ONCD还指出,报告中的建议是通过与科技公司、学术界和其他机构合作制定的,并获得了…
-
我们一起聊聊大模型的模型融合方法


在以前的实践中,模型融合被广泛运用,尤其在判别模型中,它被认为是一种能够稳定提升性能的方法。然而,对于生成语言模型而言,由于其涉及解码过程,其运作方式并不像判别模型那样直截了当。 另外,由于大模型的参数量增大,在参数规模更大的场景,简单的集成学习可以考量的方法相比低参数的机器学习更受限制,比如经典的…
-
大佬出走后首个发布!Stability官宣代码模型Stable Code Instruct 3B

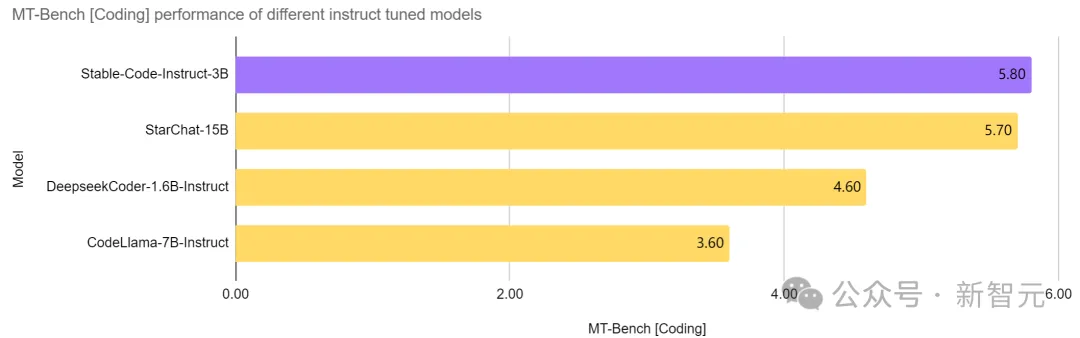
大佬出走后,第一个模型来了! 就在今天,Stability AI官宣了新的代码模型Stable Code Instruct 3B。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 图片 Stability是非常重要的,首席执行官离职对Stab…
-
GPT-4单项仅得7.1分,揭露大模型代码能力三大短板,最新基准测试来了


首个ai软件工程师devin正式亮相,立即引爆了整个技术界。 Devin虽然不能够轻松解决编码任务,但可以自主完成软件开发的整个周期——从项目规划到部署。他尽力挖掘,但不限于构建网站、自主寻找并修复BUG、培训和微调AI模型等。 这种 “强到逆天” 的软件开发能力,让一众码农纷纷绝望,直呼:“程序员…
-
0门槛免费商用!孟子3-13B大模型正式开源,万亿token数据训练
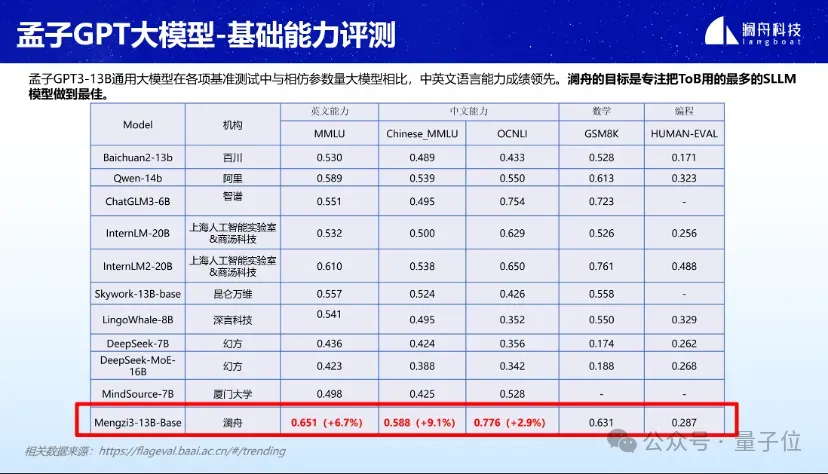
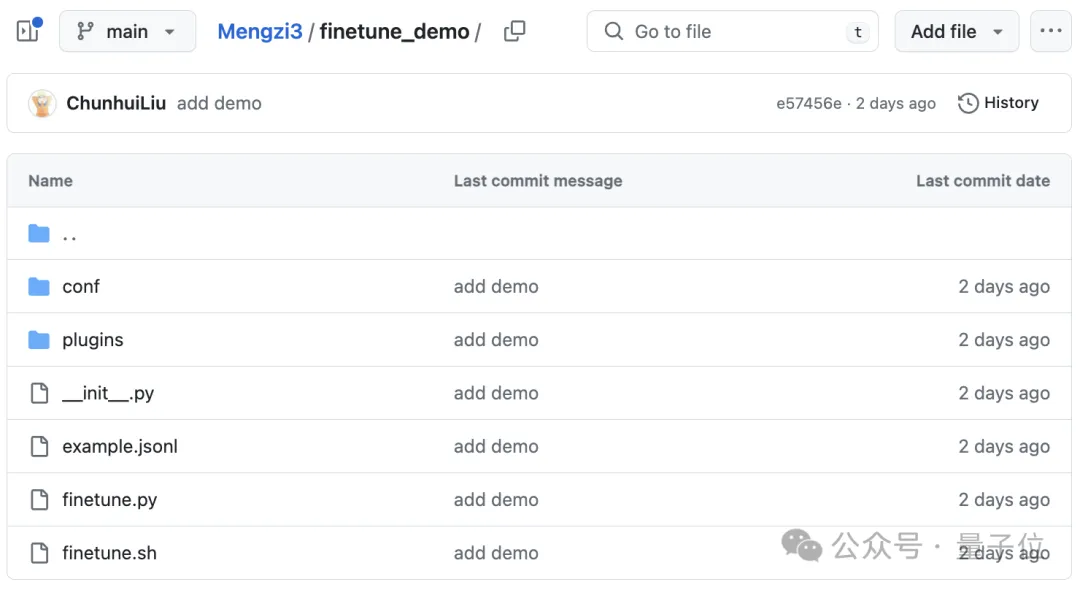
澜舟科技官宣:孟子3-13b大模型正式开源! 这一主打高性价比的轻量化大模型,面向学术研究完全开放,并支持免费商用。 在MMLU、GSM8K、HUMAN-EVAL等各项基准测评估中,孟子3-13B都表现出了不错的性能。 尤其在参量20B以内的轻量化大模型领域,中英文语言能力方面尤为突出。数学和编程能…
-
谷歌狂喜:JAX性能超越Pytorch、TensorFlow!或成GPU推理训练最快选择


谷歌力推的JAX在最近的基准测试中性能已经超过Pytorch和TensorFlow,7项指标排名第一。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 而且测试并不是在JAX性能表现最好的TPU上完成的。 虽然现在在开发者中,Pytorch依…
-
5倍于ChatGPT Intel推出Aurora genAI大模型:1万亿参数


这几个月来chatgpt很火,带动各大科技巨头都要下场研发自己的ai大模型,现在intel也加入战局,推出aurora genai模型,参数量高达1万亿。 目前ChatGPT 3.5模型的参数规模说是1750亿,意味着Aurora genAI模型至少是它的5倍,目前有不少公司都宣传自家的模型是万亿参…
-
大象P转身开箱即用!港大、南大、清华等抢先开源「复刻」版DragGAN


还记得前几天发布的DragGAN吗? 没错,就是那个「轻轻点两下」1秒修图的工具。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 拍的照片表情不好?修!脸型不够瘦?修!脸冲镜头的角度不对?修! 搞不好,「让大象转个身」这个远古PS段子,可能…
-
AI模仿人脑记忆模式,游戏成绩大涨29.9%


我们常常被教育的做事“三思而后行”,充分运用积累过的经验,现在这句话对%ign%ignore_a_1%re_a_1%也有所启发了。 传统的决策AI模型由于遗忘效应的存在不能有效积累经验,但一项由华人主导的研究改变了AI的记忆方式。 新的记忆方式模仿了人类大脑,有效地提高了AI积累经验的效率,从而将A…
-
500万token巨兽,一次读完全套「哈利波特」!比ChatGPT长1000多倍
记性差是目前主流大型语言模型的主要痛点,比如ChatGPT只能输入4096个token(约3000个词),经常聊着聊着就忘了之前说什么了,甚至都不够读一篇短篇小说的。 过短的输入窗口也限制了语言模型的应用场景,比如给一篇科技论文(约1万词)做摘要的时候,需要把文章手动切分后再输入到模型中,不同章节之…

