
sora
-
【Multi-Agent实战】如何用 LangChain 打造一个 Multi-Agent 实战项目


【multi-agent】一、如何用 langchain 打造一个 multi-agent 实战 ✍ 前言 这篇就是给已经玩过 langchain tools + agent 的同学看的进阶篇: 你已经玩过 time / weather 这种自定义工具;也看过 AgentType.CHAT_ZERO…
-
爆火Sora背后的技术,一文综述扩散模型的最新发展方向


为了使机器具有人类的想象力,深度生成模型取得了重大进展。这些模型能创造逼真的样本,尤其是扩散模型,在多个领域表现出色。扩散模型解决了其他模型的限制,如 VAEs 的后验分布对齐问题、GANs 的不稳定性、EBMs 的计算量大和 NFs 的网络约束问题。因此,扩散模型在计算机视觉、自然语言处理等方面备…
-
清华叉院、理想提出DriveVLM,视觉大语言模型提升自动驾驶能力
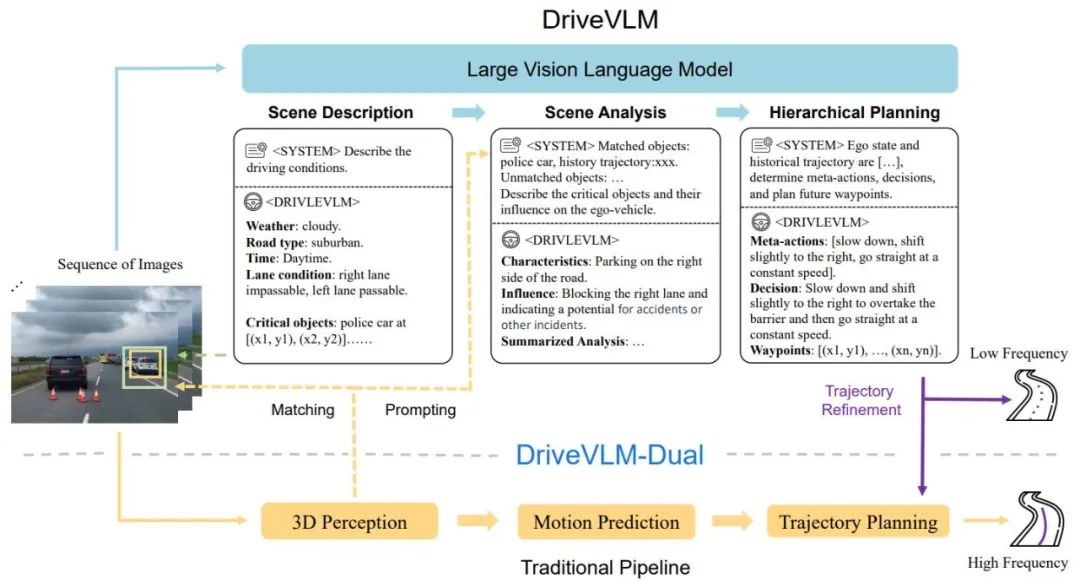
在自动驾驶领域,研究人员也在朝着 gpt/sora 等大模型方向进行探索。 与生成式 AI 相比,自动驾驶也是近期 AI 最活跃的研究和开发领域之一。要想构建完全的自动驾驶系统,人们面临的主要挑战是 AI 的场景理解,这会涉及到复杂、不可预测的场景,例如恶劣天气、复杂的道路布局和不可预见的人类行为。…
-
国内高校打造类Sora模型VDT,通用视频扩散Transformer被ICLR 2024接收
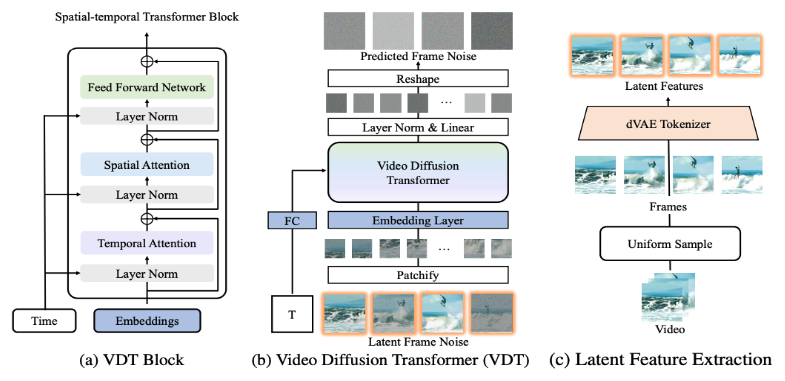
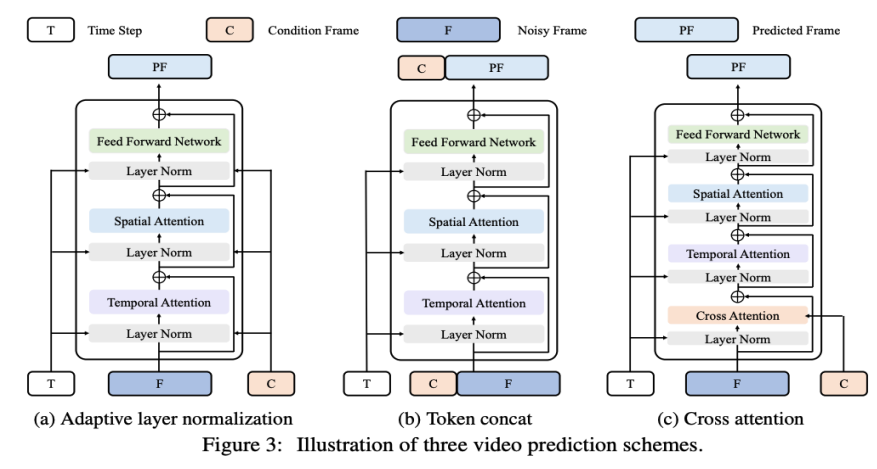
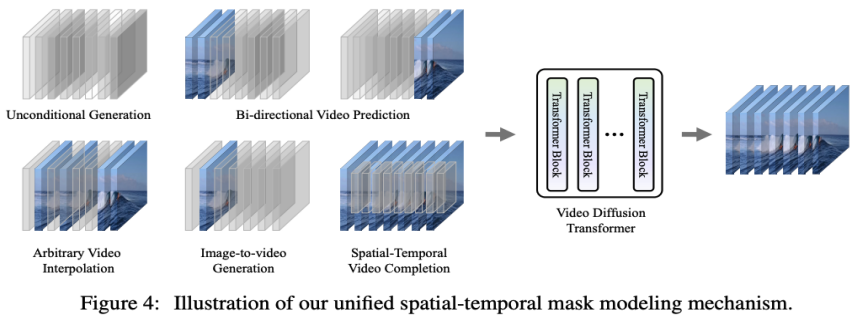
2 月 16 日,OpenAI Sora 的发布无疑标志着视频生成领域的一次重大突破。Sora 基于 Diffusion Transformer 架构,和市面上大部分主流方法(由 2D Stable Diffusion 扩展)并不相同。 为什么 Sora 坚持使用 Diffusion Transfo…
-
用扩散模型生成网络参数,LeCun点赞尤洋团队新研究

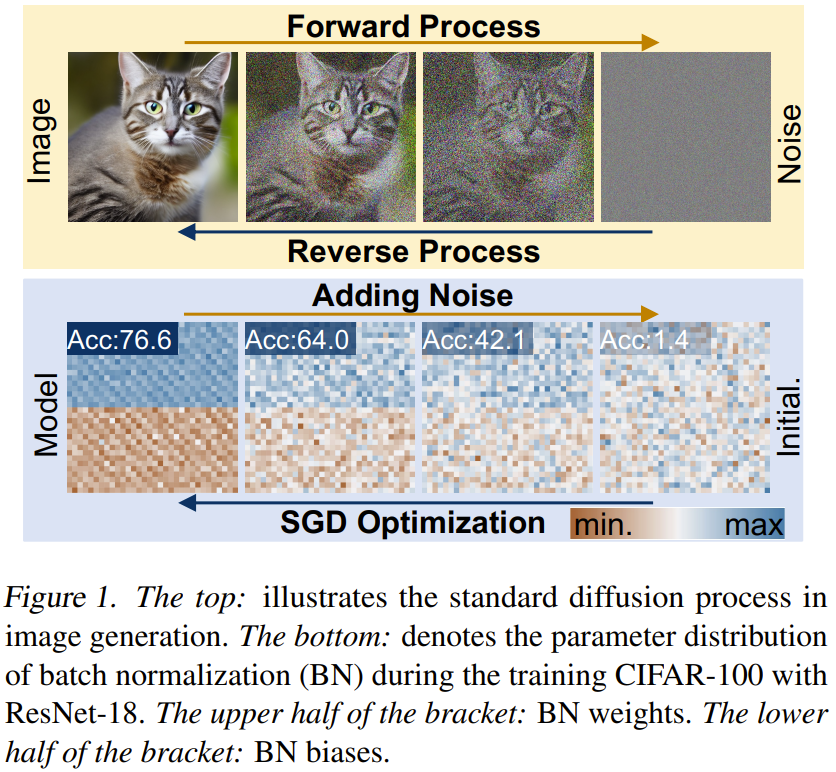
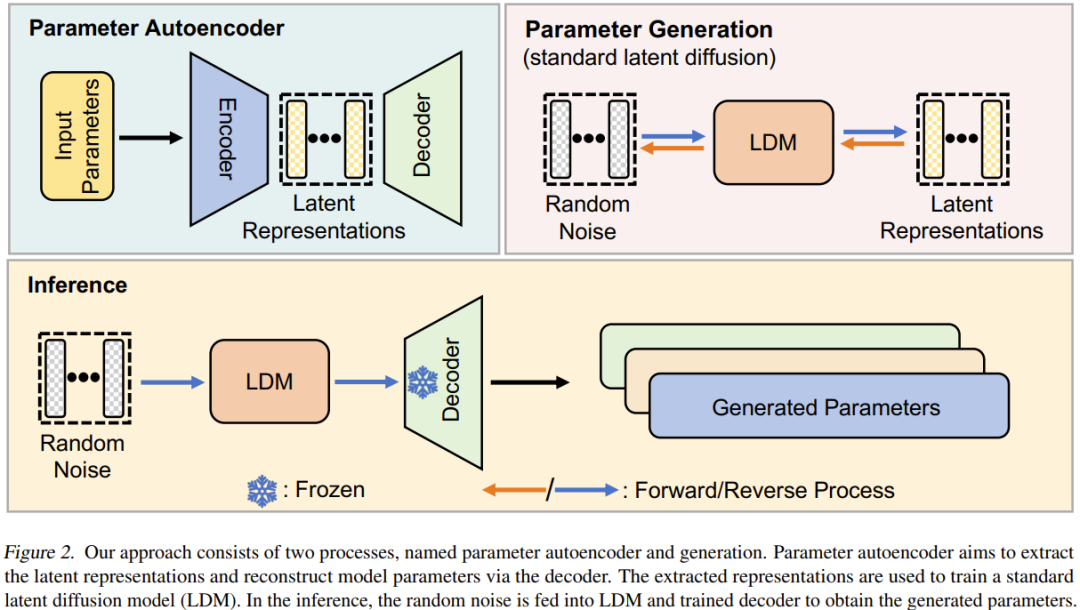
如果你有被 sora 生成的视频震撼到,那你就已经见识过扩散模型在视觉生成方面的巨大潜力。当然,扩散模型的潜力并不止步于此,它在许多其它不同领域也有着让人期待的应用前景,更多案例可参阅本站不久前的报道《爆火sora背后的技术,一文综述扩散模型的最新发展方向》。 最近,由新加坡国立大学的尤洋团队、加州…
-
Sora视频分析怎么进行_Sora生成视频内容分析与评估指南


首先通过提取关键帧并结合CLIP模型分析静态内容,验证画面与文本提示的一致性;接着利用光流算法和时序动作模型评估帧间连贯性与动作逻辑;再通过计算文本与视频的多模态嵌入余弦相似度量化语义对齐程度;随后构建人工评分体系,从清晰度、流畅性等维度获取平均意见分数;最后逐帧检测物理规律违例及异常现象,综合判断…
-
Sora自定义模板怎么构建_Sora视频模板创建与复用方法解析
首先使用Sora内置模板编辑器修改并保存专属模板,其次可从空白画布创建全新模板,再通过导入外部资源构建复合型模板,最后利用版本管理实现团队协作与迭代共享。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 如果您希望在Sora中创建个性化的视频…
-
Sora音频同步怎么添加_Sora视频音效与同步添加教程步骤
音画不同步可通过手动调整、自动对齐、延迟补偿或重新封装解决。首先在时间轴上拖动音频对齐画面;其次使用Sora的“自动对齐到参考音频”功能匹配波形;再通过项目设置中的输入延迟补偿修正设备延迟;最后可导出音视频并用FFmpeg重新封装以解决编码导致的同步问题。 ☞☞☞AI 智能聊天, 问答助手, AI …
-
Sora如何生成超长一分钟视频_Sora模型高级参数设置猜想
Sora最长生成60秒视频,受限于时空补丁机制,无法突破一分钟;用户可通过分段生成、提示词一致性与后期剪辑实现更长内容,重点应放在提升60秒内视频的质量与叙事连贯性。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 目前Sora并不能生成超过…
-
Pika推出音画同步新功能一天后,翻车视频来了


Pika 的音效新功能「Sound Effects」,有大大的惊喜,也有小小的「惊吓」。 Sora 的出现让文生视频模型及应用火了起来。不过,此类模型生成的视频大多数都是无声的。因此,人们开始探索为 AI 生成的视频「配音」。 这一领域的代表有 AI 语音克隆初创公司 ElevenLab,此前该公司…


