udio
-
StepAudio R1— 阶跃星辰开源的原生音频推理模型


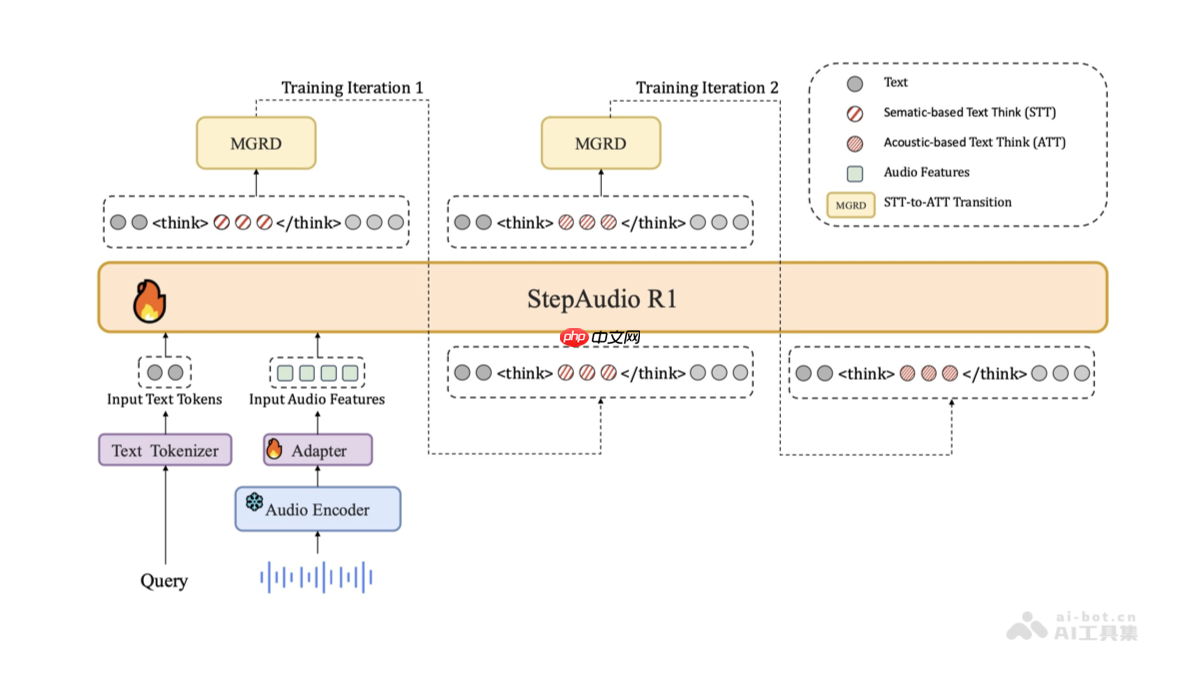
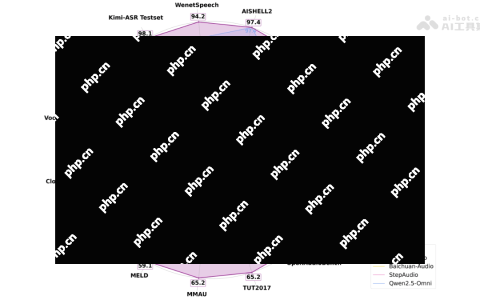
StepAudio R1是什么 stepaudio r1 是由阶跃星辰研发并开源的全球首款原生音频推理模型,标志着音频智能处理领域的重大突破。该模型采用创新的模态锚定推理蒸馏(mgrd)框架,有效解决了传统音频模型在复杂逻辑推理任务中表现不佳的问题,真正实现了基于声学特征的深度推理能力。在多项权威基…
-
Udio怎样用风格模型仿流派_Udio用风格模型仿流派【流派模仿】
一、选择与目标流派匹配的预训练风格模型,如“Neo-Soul Groove”用于灵魂乐;二、在提示栏输入流派关键词、参考艺术家及音乐结构描述;三、可选上传WAV/MP3参考音频,系统分析节奏、音色等特征;四、调整Groove Quantization、Harmonic Constraint等参数以强…
-
ReplicaStudios怎样用情绪参数调戏感_ReplicaStudios用情绪参数调戏感【情绪演绎】
通过调整ReplicaStudios的情绪参数可显著提升语音情感表现力:一、在文本输入界面添加情绪标签,选择如“anger”“joy”等情绪类型并设置0.0–1.0强度值;二、叠加多种情绪(如“fear”0.7+“surprise”0.5)以构建复杂情感层次,避免冲突失真;三、联动调节音高与语速,激…
-
Gemini怎样用多模态分析图文数_Gemini用多模态分析图文数【多模分析】

Gemini处理图文数据需启用多模态功能,1、选Gemini Pro Vision模型并开启multimodal选项;2、上传图像并关联文本构成请求体;3、图像编码为Base64或提供URL;4、用”parts”字段封装图文数据且图像在前;5、提示词明确任务目标与操作类型;6…
-
真快!几分钟就把视频语音识别为文本了,不到10行代码

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 大家好,我是风筝 两年前,将音视频文件转换为文字内容的需求难以实现,但是如今只需几分钟便可轻松解决。 据说一些公司为了获取训练数据,已经对抖音、快手等短视频平台上的视频进行了全面爬取,然后将视频…
-
谷歌10M上下文窗口正在杀死RAG?被Sora夺走风头的Gemini被低估了?

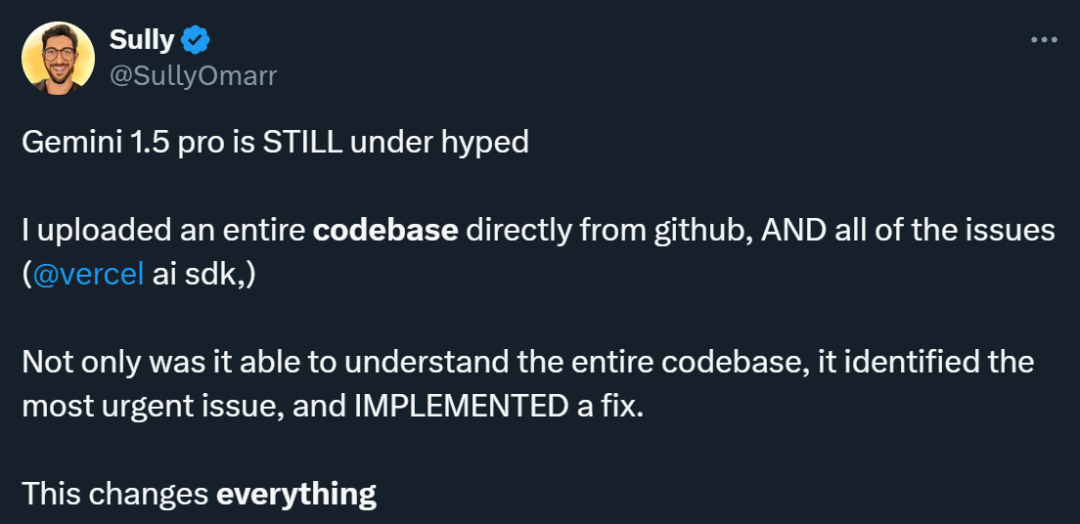
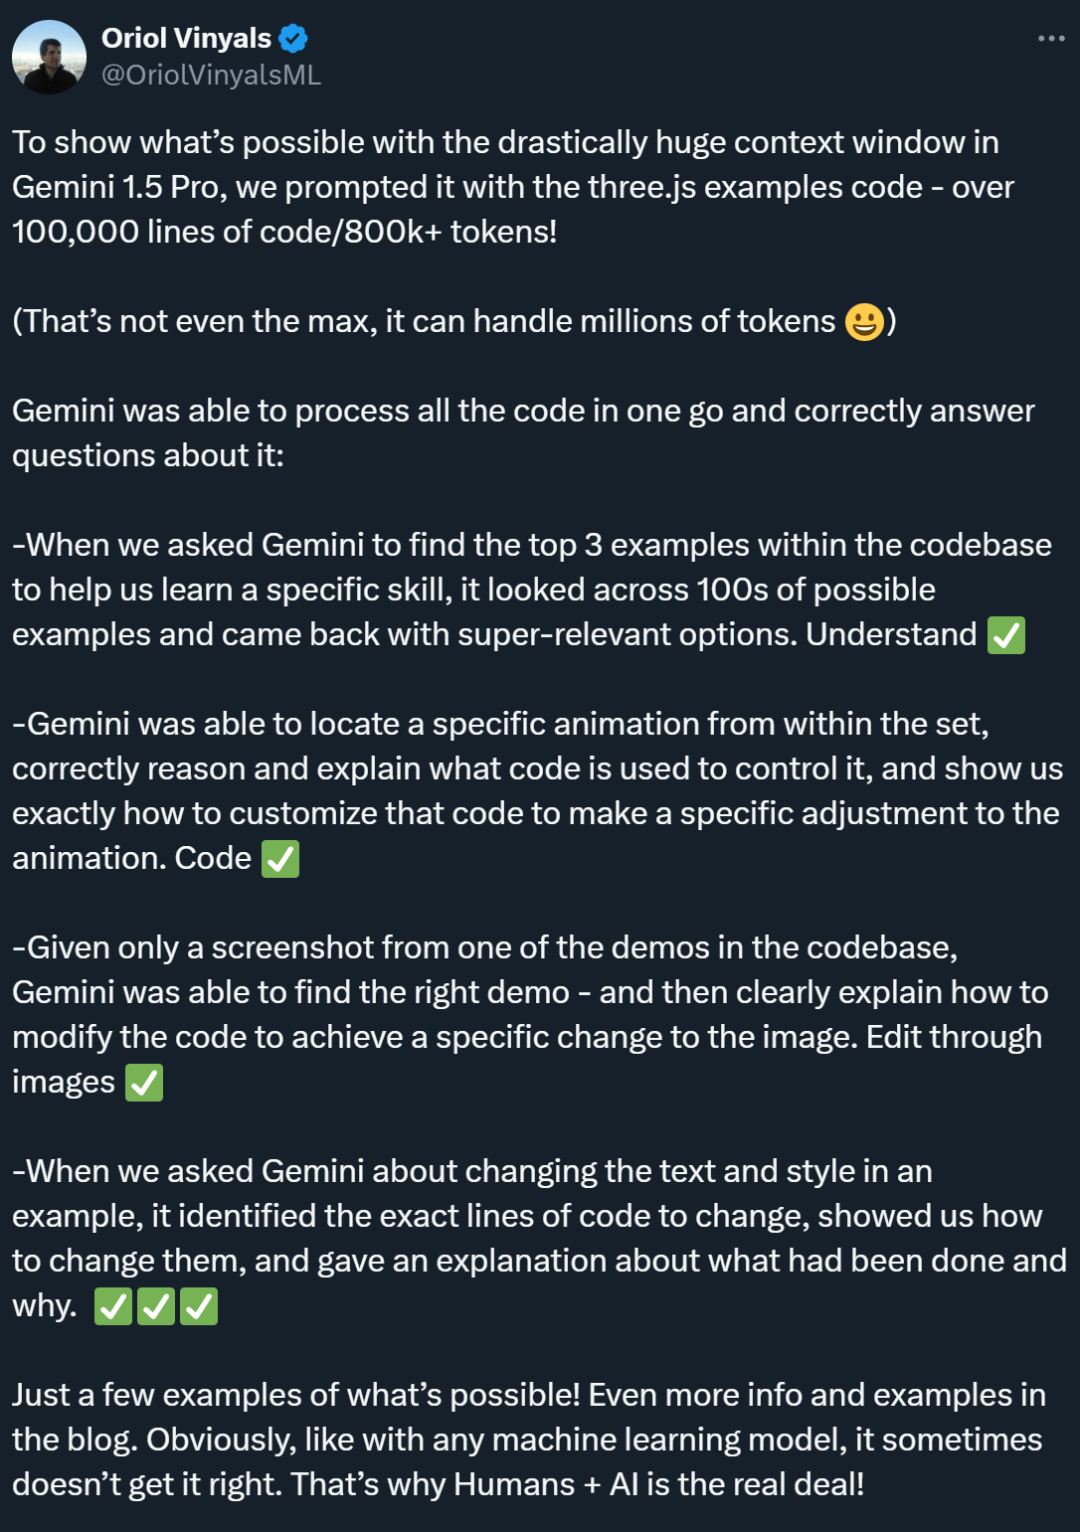
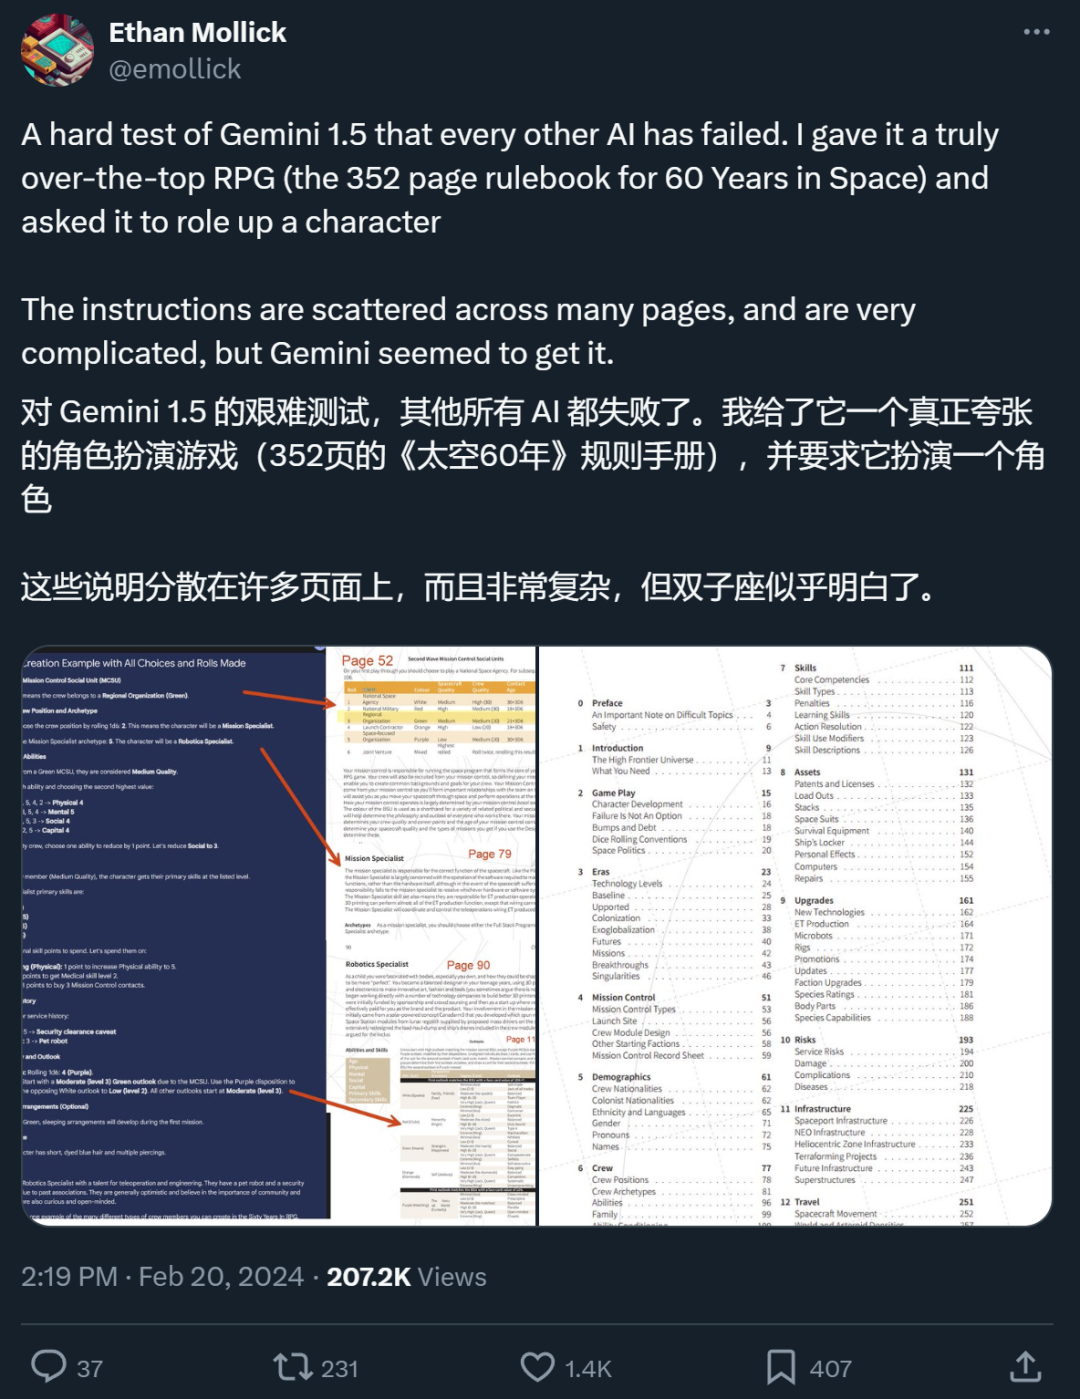
要说最近最郁闷的公司,谷歌肯定算得上一个:自家的 Gemini 1.5 刚刚发布,就被 OpenAI 的 Sora 抢尽了风头,堪称 AI 界的「汪峰」。 具体来说,谷歌这次推出的是用于早期测试的 Gemini 1.5 的第一个版本 ——Gemini 1.5 Pro。它是一种中型多模态模型(涉及文本…
-
Kimi-Audio— Moonshot AI 开源的音频基础模型
kimi-audio 是由 moonshot ai 推出的开源音频基础模型,专注于音频理解、生成和对话任务。它在超过 1300 万小时的多样化音频数据上进行预训练,具备强大的音频推理和语言理解能力。其核心架构采用混合音频输入(连续声学 + 离散语义标记),结合基于 llm 的设计,支持并行生成文本和…
-
如何通过AI生成体育精彩集锦_体育视频AI精彩片段自动生成教程

AI可自动提取体育赛事精彩瞬间:首先上传视频至AI平台并选择对应运动模型,系统通过动作、声音和观众反应识别高光时刻;其次本地部署TensorFlow等框架,利用预训练模型如SlowFast分析视频帧,筛选高置信度事件导出片段;最后融合解说关键词、音频峰值与画面动态,多模态对齐提升识别精度,生成高质量…
-
AI视频剪辑免费入口 AI自动配音配字幕工具
AI视频剪辑免费入口为https://app.spikes.studio,该平台支持视频上传、智能剪辑、自动配音配字幕,新用户完成任务可获10分钟免费额度,邀请好友还可叠加使用时长,适合个人创作者高效制作短视频。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek…
-
哩布哩布AI怎么生成3D模型_哩布哩布AI图生3D功能最新教程

使用哩布哩布AI生成2D图像并结合Tripo AI转换为3D模型,具体步骤包括:登录哩布哩布AI官网,选择合适模型并输入详细提示词生成正方形图像,下载后上传至Tripo AI进行自动3D重建,可导出PLY或GLB格式;为进一步提升效果,可借助DeepSeek优化提示词,并通过CherryStudio…