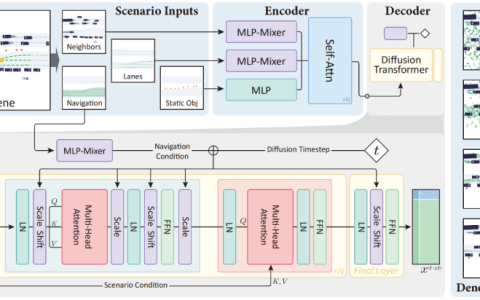
轨迹预测在自动驾驶中承担着重要的角色,自动驾驶轨迹预测是指通过分析车辆行驶过程中的各种数据,预测车辆未来的行驶轨迹。作为自动驾驶的核心模块,轨迹预测的质量对于下游的规划控制至关重要。轨迹预测任务技术栈丰富,需要熟悉自动驾驶动/静态感知、高精地图、车道线、神经网络架构(cnn&gnn&transformer)技能等,入门难度很大!很多粉丝期望能够尽快上手轨迹预测,少踩坑,今天就为大家盘点下轨迹预测常见的一些问题和入门学习方法!
入门相关知识
1.预习的论文有没有切入顺序?
A:先看survey,problem formulation, deep learning-based methods里的sequential network,graph neural network和Evaluation。
2.行为预测是轨迹预测吗
耦合和行为并不相同,耦合通常指目标车可能采取的动作,例如变道、停车、超车、加速、左转、右转或直行。而轨迹则指具有时间信息的具体未来位置点。
3.请问Argoverse数据集里提到的数据组成中,labels and targets指的是什么呢?labels是指要预测时间段内的ground truth吗
在右边的表格中,OBJECT_TYPE栏目通常代表自动驾驶车辆本身。数据集通常为每个场景指定一个或多个待预测的障碍物,并将这些待预测目标称为target或focal agent。有些数据集还会为每个障碍物提供语义标签,例如车辆、行人或自行车等。
Q2:车辆和行人的数据形式是一样的吗?我的意思是说,比如一个点云点代表行人,几十个点代表车辆?
A:这种轨迹数据集里面其实给的都是物体中心点的xyz坐标,行人和车辆都是
Q3:argo1和argo2的数据集都是只指定了一个被预测的障碍物吧?那在做multi-agent prediction的时候 这两个数据集是怎么用的
argo1只指定了一个障碍物,而argo2却可能指定了多达二十个。然而,即使只指定了一个障碍物,这并不会影响您模型的能力来预测多个障碍物。
4.路径规划一般考虑低速和静态障碍物 轨迹预测结合的作用是??关键snapshot?
A:”预测“自车轨迹当成自车规划轨迹,可以参考uniad
5.轨迹预测对于车辆动力学模型的要求高吗?就是需要数学和汽车理论等来建立一个精准的车辆动力学模型么?
A:nn网络基本不需要哈,rule based的需要懂一些
6. 模模糊糊的新手小白,应该从哪里在着手拓宽一下知识面(还不会代码撰写)
A:先看综述,把思维导图整理出来,例如《Machine Learning for Autonomous Vehicle’s Trajectory Prediction: A comprehensive survey, Challenges, and Future Research Directions》这篇综述去看看英文原文
7.预测和决策啥关系捏,为啥我觉得好像预测没那么重要?
A1(stu): 默认预测属于感知吧,或者决策中隐含预测,反正没有预测不行。A2(stu): 决策该规控做,有行为规划,高级一点的就是做交互和博弈,有的公司会有单独的交互博弈组
8.目前头部公司,一般预测是属于感知大模块还是规控大模块?
A:预测是出他车轨迹,规控是出自车轨迹,这俩轨迹还互相影响,所以预测一般放规控。
Q: 一些公开的资料,比如小鹏的感知xnet会同时出预测轨迹,这时候又感觉预测的工作是放在感知大模块下,还是说两个模块都有自己的预测模块,目标不一样?
A:是会相互影响,所以有的地方预测和决策就是一个组。比如自车规划的轨迹意图去挤别的车,他车一般情况是会让道的。所以有些工作会把自车的规划当成他车模型输入的一部分。可以参考下M2I(M2I: From Factored Marginal Trajectory Prediction to Interactive Prediction). 这篇思路差不多,可以了解 PiP: Planning-informed Trajectory Prediction for Autonomous Driving
9.argoverse的这种车道中线地图,在路口里面没有车道线的地方是怎么得到的呀?
A: 人工标注的
10.用轨迹预测写论文的话,哪篇论文的代码可以做baseline?
A: hivt可以做baseline,蛮多人用的
11.现在轨迹预测基本都依赖地图,如果换一个新的地图环境,原模型是否就不适用了,要重新训练吗?
A: 有一定的泛化能力,不需要重新训练效果也还行
12.对多模态输出而言,选择最佳轨迹的时候是根据概率值最大的选吗
A(stu): 选择结果最好的Q2:结果最好是根据什么来判定呢?是根据概率值大小还是根据和gt的距离A: 实际在没有ground truth的情况下,你要取“最好”的轨迹,那只能选择相信预测概率值最大的那条轨迹了Q3: 那有gt的情况下,选择最好轨迹的时候,根据和gt之间的end point或者average都可以是吗A: 嗯嗯,看指标咋定义
轨迹预测基础模块
1.Argoverse数据集里HD-Map怎么用,能结合motion forecast作为输入,构建驾驶场景图吗,异构图又怎么理解?
A:这个课程里都有讲的,可以参照第二章,后续的第四章也会讲. 异构图和同构图的区别:同构图中,node的种类只有一种,一个node和另一个node的连接关系只有一种,例如在社交网络中,可以想象node只有‘人’这一个种类,edge只有‘认识’这一种连接。而人和人要么认识,要么不认识。但是也可能细分有人,点赞,推文。则人和人可能通过认识连接,人和推文可能通过点赞连接,人和人也可能通过点赞同一篇推文连接(meta path)。这里节点、节点之间关系的多样性表达就需要引入异构图了。异构图中,有很多种node。node之间也有很多种连接关系(edge),这些连接关系的组合则种类更多(meta-path), 而这些node之间的关系有轻重之分,不同连接关系也有轻重之分。
2.A-A交互考虑的是哪些车辆与被预测车辆的交互呢?
A:可以选择一定半径范围内的车,也可以考虑K近邻的车,你甚至可以自己提出更高级的启发式邻居筛选策略,甚至有可能可以让模型自己学出来两个车是否是邻居
Q2:还是考虑一定范围内的吧,那半径大小有什么选取的原则吗?另外,选取的这些车辆是在哪个时间步下的呢
A:半径的选择很难有标准答案,这本质上就是在问模型做预测的时候到底需要多远程的信息,有点像在选择卷积核的大小对于第二个问题,我个人的准则是,想要建模哪个时刻下物体之间的交互,就根据哪个时刻下的物体相对位置来选取邻居
Q3:这样的话对于历史时域都要建模吗?不同时间步下在一定范围内的周边车辆也会变化吧,还是说只考虑在当前时刻的周边车辆信息
A:都行啊,看你模型怎么设计
3.老师uniad端到端模型中预测部分存在什么缺陷啊?
A:只看它motion former的操作比较常规,你在很多论文里都会看到类似的SA和CA。现在sota的模型很多都比较重,比如decoder会有循环的refine
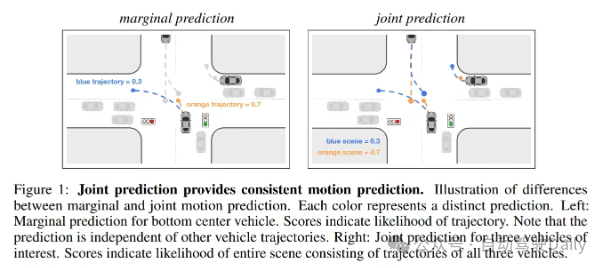
A2:做的是marginal prediction不是joint prediction;2. prediction和planning是分开来做的,没有显式考虑ego和周围agent的交互博弈;3.用的是scene-centric representation,没有考虑对称性,效果必拉
Q2:啥是marginal prediction啊
A:具体可以参考scene transformer
Q3:关于第三点,scene centric没有考虑对称性,怎么理解呢
A:建议看HiVT, QCNet, MTR++.当然对于端到端模型来说对称性的设计也不好做就是了
A2:可以理解成输入的是scene的数据,但在网络里会建模成以每个目标为中心视角去看它周边的scene,这样你就在forward里得到了每个目标以它自己为中心的编码,后续可以再考虑这些编码间的交互
 Waymark
是一个视频制作工具,帮助企业快速轻松地制作高影响力的广告。
 79 查看详情

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
4. 什么是以agent为中心?
A:每个agent有自己的local region,local region是以这个agent为中心
5.轨迹预测里yaw和heading是混用的吗
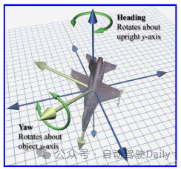
A:可以理解为车头朝向
6.argoverse地图中的has_traffic_control这个属性具体代表什么意思?
A:其实我也不知道我理解的对不对,我猜是指某个lane是否被红绿灯/stop sign/限速标志等所影响
7. 请问Laplace loss和huber loss 对于轨迹预测而言所存在的优劣势在哪里呢?如果我只预测一条车道线的话
A:两个都试一下,哪个效果好哪个就有优势。Laplace loss要效果好还是有些细节要注意的
Q2:是指参数要调的好吗
A:Laplace loss相比L1 loss其实就是多预测了一个scale参数
Q3:对的 但似乎这个我不知道有啥用 如果只预测一个轨迹的话。感觉像是多余的。我把它理解为不确定性 不知道是否正确
A:如果你从零推导过最小二乘法就会知道,MSE其实是假设了方差为常数的高斯分布的NLL。同理,L1 loss也是假设了方差为常数的Laplace分布的NLL。所以说LaplaceNLL也可以理解为方差非定值的L1 loss。这个方差是模型自己预测出来的。为了使loss更低,模型会给那些拟合得不太好的样本一个比较大的方差,而给拟合得好的样本比较小的方差
Q4:那是不是可以理解为对于非常随机的数据集【轨迹数据存在缺帧 抖动】 就不太适合Laplace 因为模型需要去拟合这个方差?需要数据集质量比较高
A:这个说法我觉得不一定成立。从效果上来看,会鼓励模型优先学习比较容易拟合的样本,再去学习难学习的样本
Q5:还想请问下这句话(Laplace loss要效果好还是有些细节要注意的)如何理解 A:主要是预测scale那里。在模型上,预测location的分支和预测scale的分支要尽量解耦,不要让他们相互干扰。预测scale的分支要保证输出结果>0,一般人会用exp作为激活函数保证非负,但是我发现用ELU +1会更好。然后其实scale的下界最好不要是0,最好让scale>0.01或者>0.1啥的。以上都是个人看法。其实我开源的代码(周梓康大佬的github开源代码)里都有这些细节,不过可能大家不一定注意到。
给出链接:https://github.com/ZikangZhou/QCNet
https://github.com/ZikangZhou/HiVT
8. 有拿VAE做轨迹预测的吗,给个链接!
https://github.com/L1aoXingyu/pytorch-beginner/tree/master/08-AutoEncoder
9. 请问大伙一个问题,就是Polyline到底是啥?另外说polyline由向量Vector组成,这些Vector是相当于节点吗?
A:Polyline就是折线,折线就是一段一段的,每一段都可以看成是一段向量Q2:请问这个折线段和图神经网络的节点之间的边有关系吗?或者说Polyline这个折现向量相当于是图神经网络当中的节点还是边呀?A:一根折线可以理解为一个节点。轨迹预测里面没有明确定义的边,边如何定义取决于你怎么理解这个问题。Q3: VectorNet里面有很多个子图,每个子图下面有很多个Polyline,把Polyline当做向量的话,就相当于把Polyline这个节点变成了向量,相当于将节点进行特征向量化对吗?然后Polyline里面有多个Vector向量,就是相当于是构成这个节点的特征矩阵么?A: 一个地图里有很多条polyline;一个Polyline就是一个子图;一个polyline由很多段比较短的向量组成,每一段向量都是子图上的一个节点
10. 有的论文,像multipath++对于地图两个点就作为一个单元,有的像vectornet是一条线作为一个单元,这两种有什么区别吗?
A: 节点的粒度不同,要说效果的话那得看具体实现;速度的话,显然粒度越粗效率越高Q2:从效果角度看,什么时候选用哪种有没有什么原则?A: 没有原则,都可以尝试
11.有什么可以判断score的平滑性吗? 如果一定要做的话
A: 这个需要你输入是流动的输入比如0-19和1-20帧然后比较两帧之间的对应轨迹的score的差的平方,统计下就可以了
Q2: Thomas老师有哪些指标推荐呢,我目前用一阶导数和二阶导数。但好像不是很明显,绝大多数一阶导和二阶导都集中在0附近。
A: 我感觉连续帧的对应轨迹的score的差值平方就可以了呀,比如你有连续n个输入,求和再除以n。但是scene是实时变化的,发生交互或者从非路口到路口的时候score就应该是突变的
12.hivt里的轨迹没有进行缩放吗,就比如×0.01+10这种。分布尽可能在0附近。我看有的方法就就用了,有的方法就没有。取舍该如何界定?
A:就是把数据标准化归一化呗。可能有点用 但应该不多
13.HiVT里地图的类别属性经过embedding之后为什么和数值属性是相加的,而不是concat?
A:相加和concat区别不大,而对于类别embedding和数值embedding融合来说,实际上完全等价
Q2: 完全等价应该怎么理解?
A: 两者Concat之后再过一层线性层,实际上等价于把数值embedding过一层线性层以及把类别embedding过一层线性层后,两者再相加起来.把类别embedding过一层线性层其实没啥意义,理论上这一层线性层可以跟nn.Embeddding里面的参数融合起来
14.作为用户可能更关心的是,HiVT如果要实际部署的话,最小的硬件要求是多少?
A:我不知道,但根据我了解到的信息,不知道是NV还是哪家车厂是拿HiVT来预测行人的,所以实际部署肯定是可行的
15. 基于occupancy network的预测有什么特别吗?有没有论文推荐?
A:目前基于occupancy的未来预测的方案里面最有前途的应该是这个:https://arxiv.org/abs/2308.01471
16.考虑规划轨迹的预测有什么论文推荐吗?就是预测其他障碍物的时候,考虑自车的规划轨迹?
A:这个可能公开的数据集比较困难,一般不会提供自车的规划轨迹。上古时期有一篇叫做PiP的,港科Haoran Song。我感觉那种做conditional prediction的文章都可以算是你想要的,比如M2I
17.有没有适合预测算法进行性能测试的仿真项目可以学习参考的呢
A(stu):这个论文有讨论:Choose Your Simulator Wisely A Review on Open-source Simulators for Autonomous Driving
18.请问如何估计GPU显存需要多大,如果使用Argoverse数据集的话,怎么算
A:和怎么用有关系,之前跑hivt我1070都可以,现在一般电脑应该都可以
原文链接:https://mp.weixin.qq.com/s/EEkr8g4w0s2zhS_jmczUiA
以上就是自动驾驶与轨迹预测看这一篇就够了!的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1005258.html
 微信扫一扫
 支付宝扫一扫