Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
Kafka Streams中基于消息头条件过滤消息的实现指南_创想鸟

Kafka Streams中基于消息头条件过滤消息的实现指南

kafka streams中基于消息头条件过滤消息的实现指南

本教程详细阐述了如何在Kafka Streams中利用`Processor`接口根据消息头(Headers)中的特定值来有条件地跳过消息。通过在`Processor`的`process`方法中访问消息头,并结合`ProcessorContext`的`forward`方法,我们可以灵活地实现基于复杂业务逻辑的消息过滤,弥补了`KStream#filter()`无法直接访问消息头的局限性。

1. 引言:Kafka Streams消息过滤的挑战

在Kafka Streams应用中,我们经常需要对流中的消息进行过滤。标准的KStream#filter()方法允许开发者根据消息的键(Key)和值(Value)来决定是否保留消息。然而,在许多高级场景下,过滤逻辑可能需要依赖于消息的元数据,例如消息头(Headers)中包含的重试次数、业务标识或优先级等信息。KStream#filter()方法无法直接访问消息头,这给基于消息头进行过滤带来了挑战。

为了解决这一限制,Kafka Streams提供了更底层的Processor API。通过实现自定义的Processor,开发者可以完全控制消息的处理流程,包括访问完整的Record对象(包含键、值、时间戳和消息头),从而实现基于任意复杂条件的过滤逻辑。

2. Processor接口与消息跳过机制

Processor是Kafka Streams提供的一个低级API,它允许开发者构建自定义的处理逻辑。当标准的高级DSL(如map、filter、groupBy等)不足以满足需求时,Processor就显得尤为重要。

Processor接口定义了三个核心方法:

Ai Mailer Ai Mailer

使用Ai Mailer轻松制作电子邮件

Ai Mailer 49 查看详情 Ai Mailer init(ProcessorContext context): 初始化方法,在处理器实例创建后调用一次。ProcessorContext提供了与Kafka Streams运行时环境交互的接口,例如访问状态存储、记录度量指标以及最重要的——将记录转发到下游。process(Record record): 核心处理逻辑,对每一条传入的记录进行处理。在此方法中,我们可以访问Record的全部内容,包括消息头。close(): 清理方法,在处理器关闭前调用,用于释放资源。

消息跳过的核心机制

在Processor中实现消息跳过的关键在于ProcessorContext的forward()方法。forward()方法负责将当前处理的记录传递给拓扑中的下一个处理器。如果我们在process()方法中根据某些条件判断后,不调用context.forward(record),那么这条记录就不会被发送到下游,从而实现了消息的“跳过”或“过滤”。

3. 实现基于消息头阈值跳过消息的Processor

本节将演示如何创建一个自定义的Processor,该处理器会检查消息头中的RetryCount(重试次数)字段。如果RetryCount超过预设的阈值,则跳过该消息;否则,它会递增RetryCount并转发消息。

import org.apache.kafka.common.header.Header;import org.apache.kafka.common.header.Headers;import org.apache.kafka.streams.processor.api.Processor;import org.apache.kafka.streams.processor.api.ProcessorContext;import org.apache.kafka.streams.processor.api.Record;import java.nio.charset.StandardCharsets;import java.util.Iterator;import java.util.Optional;/** * MessageHeaderSkippingProcessor是一个Kafka Streams处理器, * 它根据消息头中的"RetryCount"值来决定是否跳过消息。 * 如果RetryCount超过预设阈值,消息将被跳过;否则,RetryCount会递增并转发消息。 */public class MessageHeaderSkippingProcessor implements Processor {    private static final String RETRY_COUNT_HEADER = "RetryCount";    private final int threshold;    private ProcessorContext context; // 用于转发消息到下游    /**     * 构造函数     * @param threshold 允许的最大重试次数,超过此值将跳过消息。     */    public MessageHeaderSkippingProcessor(int threshold) {        this.threshold = threshold;    }    @Override    public void init(ProcessorContext context) {        this.context = context; // 初始化ProcessorContext    }    @Override    public void process(Record record) {        Headers headers = record.headers(); // 获取当前记录的消息头        int currentRetryCount = getRetryCountFromHeaders(headers); // 获取当前的重试次数        // 递增重试计数并更新消息头        int newRetryCount = currentRetryCount + 1;        updateRetryCountHeader(headers, newRetryCount); // 更新消息头中的重试次数        // 判断是否应该跳过消息        if (newRetryCount <= this.threshold) {            // 如果重试次数在阈值范围内,则转发消息到下游            context.forward(record);        } else {            // 如果重试次数超过阈值,则不调用context.forward(),从而跳过此消息。            // 可以在此处添加日志记录或将消息发送到死信队列的逻辑。            System.out.println("跳过消息 (Key: " + record.key() + ", 重试次数: " + newRetryCount +                                ", 阈值: " + this.threshold + ")");        }    }    /**     * 从消息头中提取RetryCount值。     * @param headers 消息头对象。     * @return 提取到的重试次数,如果消息头不存在或格式错误则返回0。     */    private int getRetryCountFromHeaders(Headers headers) {        Iterator
retryHeaders = headers.headers(RETRY_COUNT_HEADER).iterator(); if (retryHeaders.hasNext()) { try { // 将字节数组转换为字符串,再解析为整数 return Integer.parseInt(new String(retryHeaders.next().value(), StandardCharsets.UTF_8)); } catch (NumberFormatException e) { // 记录错误并默认处理,例如视为初始重试(0) System.err.println("消息头 '" + RETRY_COUNT_HEADER + "' 值格式无效: " + e.getMessage()); return 0; } } return 0; // 未找到重试次数消息头,视为首次尝试 } /** * 更新消息头中的RetryCount值。 * @param headers 消息头对象。 * @param newRetryCount 新的重试次数。 */ private void updateRetryCountHeader(Headers headers, int newRetryCount) { // 先移除旧的RetryCount消息头,确保只有一个 headers.remove(RETRY_COUNT_HEADER); // 添加更新后的RetryCount消息头 headers.add(RETRY_COUNT_HEADER, String.valueOf(newRetryCount).getBytes(StandardCharsets.UTF_8)); } @Override public void close() { // 清理可能存在的资源,例如关闭数据库连接等 }}

4. 将自定义Processor集成到Kafka Streams拓扑

创建好自定义的Processor后,需要将其集成到Kafka Streams的拓扑中。这通常通过KStream#process()方法完成。process()方法接受一个ProcessorSupplier(或一个返回Processor实例的Supplier),Kafka Streams会利用它来创建Processor的实例。

import org.apache.kafka.streams.StreamsBuilder;import org.apache.kafka.streams.kstream.KStream;import org.springframework.beans.factory.annotation.Autowired;import org.springframework.stereotype.Component;/** * EventStreamTopology 定义了Kafka Streams的拓扑结构。 * 它从"inputTopic"读取消息,通过自定义Processor处理,然后将非跳过消息写入"outputTopic"。 */@Componentpublic class EventStreamTopology {    @Autowired    public void buildTopology(StreamsBuilder streamsBuilder) {        // 从"inputTopic"创建KStream        KStream inputStream = streamsBuilder.stream("inputTopic");        // 定义跳过消息的重试阈值        int retryThreshold = 3;         // 应用自定义的MessageHeaderSkippingProcessor。        // 使用lambda表达式作为ProcessorSupplier,每次处理节点创建时都会生成一个新的Processor实例。        inputStream.process(() -> new MessageHeaderSkippingProcessor(retryThreshold));        // 将经过处理器处理(未被跳过)的消息写入"outputTopic"        // 注意:此处inputStream.to("outputTopic")会发送所有从inputStream流过来的消息。        // 如果MessageHeaderSkippingProcessor是流的最后一个操作,并且它的目的是过滤消息,        // 那么应该在Processor内部通过context.forward()将消息发送到另一个命名的子拓扑或直接到一个输出topic。        //         // 更推荐的做法是:        // KStream processedStream = inputStream.process(() -> new MessageHeaderSkippingProcessor(retryThreshold));        // processedStream.to("outputTopic");        // 但由于Processor API直接操作context.forward,它没有直接返回KStream。        // 因此,如果要在Processor之后继续使用KStream DSL,需要使用branch等方式,或者直接在Processor内部决定输出。        //        // 修正后的集成方式:        // Processor API通常作为拓扑中的一个独立节点,其输出通过context.forward()决定。        // 如果想在Processor之后继续使用KStream DSL,通常会将Processor的输出连接到另一个KStream。        // 对于本例的过滤场景,最直接的方式是Processor只转发需要保留的消息。        //        // 考虑到原问题中 inputStream.to("outputTopic"); 的位置,        // 如果Processor是直接应用在inputStream上,并且其目的是过滤,        // 那么 inputStream.to("outputTopic"); 会发送所有原始的 inputStream 消息,而不是经过过滤的。        //        // 正确的做法是:Processor作为拓扑的一个独立处理节点,其输出由context.forward()控制。        // 我们需要为Processor定义一个输出名称,然后KStream可以从该名称的流中读取。        // 或者,更简单地,直接在Processor内部决定最终的输出。        //        // 为了保持示例的简洁性并遵循Processor的过滤逻辑,我们假设Processor的输出就是最终的输出。        //         // 如果Processor是最终输出点,且不希望后续KStream操作影响过滤结果,        // 那么 `inputStream.to("outputTopic");` 应该被移除或放在 `process` 之前,        // 否则 `outputTopic` 会收到所有原始消息。        //        // 让我们修改为更清晰的,通过 ProcessorContext 直接输出到特定主题的逻辑,        // 或者,让 Processor 仅做过滤,然后后续的 KStream 节点只接收被转发的消息。        //         // 对于过滤场景,最直接的是 Processor 内部判断后,只对需要转发的消息调用 `context.forward()`。        // 如果 `context.forward()` 后面没有进一步的 KStream DSL 操作,        // 那么这个 `process` 操作就是流的终点或中间节点。        //        // 为了让示例更符合教程语境,假设 `outputTopic` 接收的是经过 `MessageHeaderSkippingProcessor` 筛选后的消息。        // `KStream#process` 方法本身并不返回一个新的 `KStream` 实例,它的输出是通过 `ProcessorContext#forward` 实现的。        // 所以,如果 `outputTopic` 应该只包含未被跳过的消息,那么 `inputStream.to("outputTopic");` 应该被移除,        // 并且 `MessageHeaderSkippingProcessor` 内部应该通过 `context

以上就是Kafka Streams中基于消息头条件过滤消息的实现指南的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1049035.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
OPPO Find X8 / Pro 手机影像爆料:新 IMX882 潜望模组、Pro 版搭载双潜望
上一篇 2025年12月2日 04:21:27
C4D克隆样条应用技巧
下一篇 2025年12月2日 04:21:31

相关推荐

  • 豆包AI安装后如何配置TPU加速 豆包AI张量处理器优化方案

    本文将详细介绍在豆包AI环境中,如何配置张量处理器(TPU)以实现加速优化。我们将从理解TPU的基本原理开始,逐步讲解安装驱动、设置环境以及验证加速效果的整个过程,旨在帮助用户高效地利用TPU提升豆包AI模型的训练和推理性能。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 D…

    2026年9月28日
    200
  • Linux学习笔记(二)系统基础操作

    Linux学习笔记(二)系统基础操作Linux学习笔记(二)系统基础操作Linux学习笔记(二)系统基础操作Linux学习笔记(二)系统基础操作

    Linux基础学习笔记精选专栏 本专栏由小雨ttt创建,致力于分享学习linux基础知识的过程。本专栏不是机械地介绍linux指令集,而是包含了作者亲自实践的操作过程,站在一个初学者的角度理解linux基础知识。 目前本专栏包含的内容有: Linux学习笔记(一)使用文本编辑器VimLinux学习笔…

    2026年9月28日 • 用户投稿
    000
  • sublime怎么保存时自动格式化代码_Sublime配置保存时自动格式化代码方法

    sublime怎么保存时自动格式化代码_Sublime配置保存时自动格式化代码方法sublime怎么保存时自动格式化代码_Sublime配置保存时自动格式化代码方法sublime怎么保存时自动格式化代码_Sublime配置保存时自动格式化代码方法sublime怎么保存时自动格式化代码_Sublime配置保存时自动格式化代码方法

    安装插件并配置可实现Sublime Text保存时自动格式化代码,提升代码可读性与一致性。首先安装Package Control包管理器,通过控制台执行指定代码完成安装;重启后使用命令面板(Ctrl+Shift+P)调出Package Control: Install Package,搜索并安装所需…

    2026年9月28日 • 用户投稿
    700
  • 对于内容创作者而言,多核性能与高频率哪个才是更关键的选择指标?

    视频创作者优先多核以提升渲染效率,图形设计和实时操作则依赖高频率保证流畅性,直播等多任务场景需平衡二者,最终选择应基于主要工作负载。 对于内容创作者来说,多核性能和高频率哪个更重要,取决于具体的创作类型和使用场景。没有绝对的答案,但可以根据工作负载的特点做出更合理的选择。 视频剪辑与渲染:多核性能优…

    2026年9月28日
    100
  • mac怎么安装win10双系统_mac安装Win10双系统方法

    答案:Intel芯片Mac可使用启动转换助理安装Windows 10双系统,M系列芯片则需通过虚拟机实现。具体包括下载ISO镜像、创建分区或U盘启动盘、安装系统及驱动等步骤,确保硬件兼容与数据安全。 如果您希望在Mac电脑上运行Windows 10应用程序或游戏,可能需要通过双系统方式安装Windo…

    2026年9月28日
    100
  • 使用云 Firestore 在服务器端处理数据以优化 Android 应用性能

    正如前文摘要所述,本文将介绍如何将 Android 应用中 Cloud Firestore 的数据处理逻辑迁移至服务器端,从而提高应用的性能和可维护性。 在 Android 应用开发中,直接在客户端执行大量的 Firestore CRUD(创建、读取、更新、删除)操作可能会导致应用运行缓慢,并且代码…

    2026年9月28日
    400
  • 宜鼎携全栈创新成果PTEXPO 2025亮相智构AI存储新生态

    宜鼎携全栈创新成果PTEXPO 2025亮相智构AI存储新生态宜鼎携全栈创新成果PTEXPO 2025亮相智构AI存储新生态宜鼎携全栈创新成果PTEXPO 2025亮相智构AI存储新生态宜鼎携全栈创新成果PTEXPO 2025亮相智构AI存储新生态

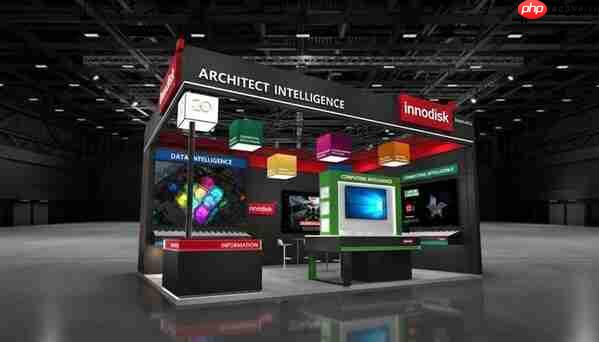
    9月24日,素有“ict行业风向标”之称的中国国际信息通信展览会(pt expo 2025)在北京国家会展中心盛大启幕。全球领先的ai解决方案与工业级存储品牌宜鼎国际(innodisk)重磅亮相,以“智构未来|architect intelligence”为主题,全面展示其在工业存储、边缘ai及5g…

    2026年9月28日 • 用户投稿
    100
  • 美图秀秀拍照黑屏 美图相机权限设置调整

    美图秀秀拍照黑屏 美图相机权限设置调整美图秀秀拍照黑屏 美图相机权限设置调整美图秀秀拍照黑屏 美图相机权限设置调整美图秀秀拍照黑屏 美图相机权限设置调整

    美图秀秀拍照黑屏通常因相机权限未开启,需进入手机设置中的应用权限管理,找到美图秀秀并开启摄像头权限,建议同时开启拍照和录像权限。不同品牌路径略有差异,如华为、小米、OPPO、vivo等均需在对应菜单中开启。修改后重启应用或手机,确保权限生效。若问题仍存在,可尝试更新美图秀秀至最新版本或升级手机系统,…

    2026年9月28日 • 用户投稿
    200
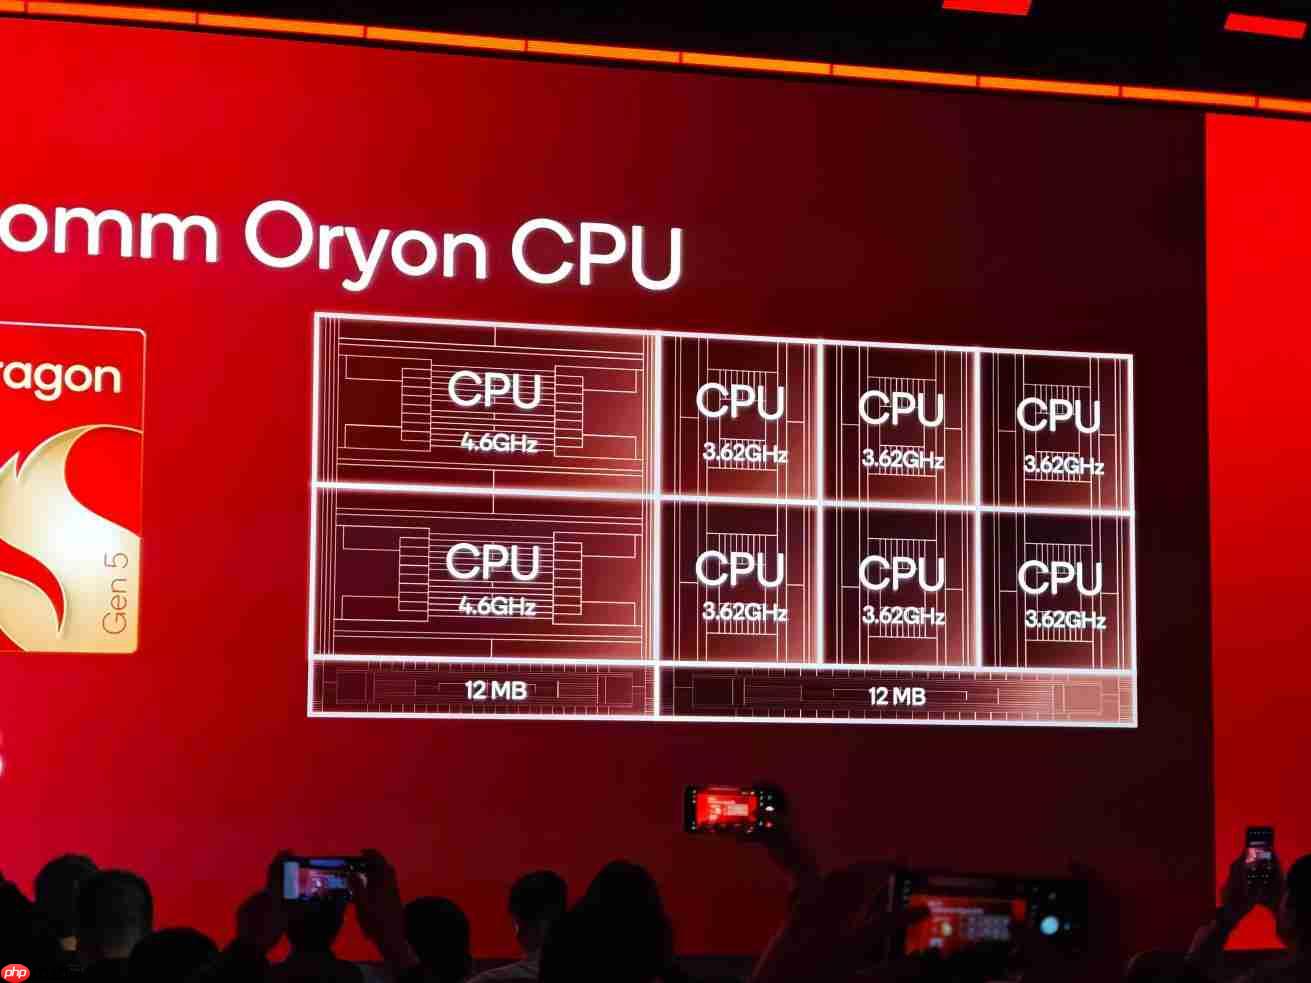
  • 骁龙X2 Elite正式发布:共3个版本 最高配达18核

    骁龙X2 Elite正式发布:共3个版本 最高配达18核骁龙X2 Elite正式发布:共3个版本 最高配达18核骁龙X2 Elite正式发布:共3个版本 最高配达18核骁龙X2 Elite正式发布:共3个版本 最高配达18核

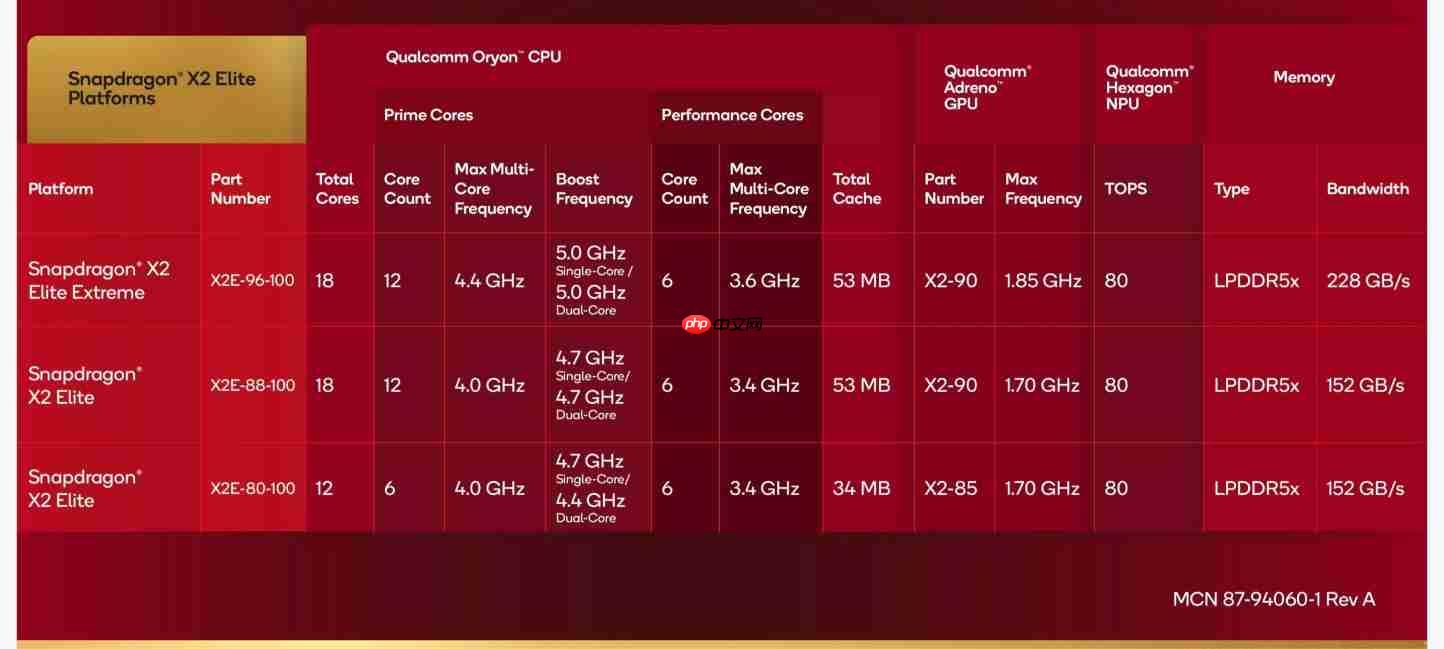
    在今日的骁龙峰会上,高通不仅推出了第五代骁龙8至尊版移动平台,还正式发布了全新的pc处理器——骁龙x2 elite。该芯片延续了基于arm架构的第三代oryon cpu设计,旨在进一步拓展其在windows笔记本市场中的竞争力。 此次发布的骁龙X2 Elite共包含三个型号:X2E-80-100、X…

    2026年9月28日 • 用户投稿
    100
  • 深入理解RESTful API的无状态性与数据持久化实践

    深入理解RESTful API的无状态性与数据持久化实践深入理解RESTful API的无状态性与数据持久化实践深入理解RESTful API的无状态性与数据持久化实践深入理解RESTful API的无状态性与数据持久化实践

    本教程深入探讨RESTful API的无状态性核心原则,阐明为何不应在服务器内存中维护跨API调用的数据状态。我们将详细介绍RESTful架构的无状态约束,分析在服务器端存储会话或资源状态的弊端,并推荐使用数据库等外部持久化机制来可靠地管理数据,确保API的可伸缩性、可靠性和一致性。 理解RESTf…

    2026年9月28日 • 用户投稿
    100
  • 「理想同学」的进化史:从 AI 助手到智能体的自研之路

    如果要选出最早凭借座舱功能占领用户心智的一家造车新势力,答案或许是理想。 ” 冰箱彩电大沙发 ” 是理想最被人所知的卖点。但抛开这些精准的硬件定义,作为未来用户智驾空间与娱乐的第三空间,座舱里只有这些是远远不够的。智能化尤其是座舱空间的智能化,已经成为车企的核心卖点。 202…

    2026年9月28日
    100
  • REST API设计原则:理解无状态性与持久化数据管理

    REST API设计原则:理解无状态性与持久化数据管理REST API设计原则:理解无状态性与持久化数据管理REST API设计原则:理解无状态性与持久化数据管理REST API设计原则:理解无状态性与持久化数据管理

    在REST API设计中,跨不同API调用维护服务器端变量(如用户列表)的内存状态与REST的无状态原则相悖。RESTful服务应将每个请求视为独立的事务,不依赖服务器端会话状态。对于需要持久化的数据,应采用数据库、文件系统等外部存储机制,而非在内存中直接维护,以确保系统的可伸缩性、可靠性和一致性。…

    2026年9月28日 • 用户投稿
    200
  • sublime怎么在侧边栏中隐藏特定的文件类型_侧边栏文件过滤设置

    sublime怎么在侧边栏中隐藏特定的文件类型_侧边栏文件过滤设置sublime怎么在侧边栏中隐藏特定的文件类型_侧边栏文件过滤设置sublime怎么在侧边栏中隐藏特定的文件类型_侧边栏文件过滤设置sublime怎么在侧边栏中隐藏特定的文件类型_侧边栏文件过滤设置

    要隐藏Sublime Text侧边栏中的特定文件类型,需修改用户或项目设置中的”folder_exclude_patterns”和”file_exclude_patterns”数组。首先在全局设置中添加如”.git”、&#822…

    2026年9月28日 • 用户投稿
    100
  • 使用单个循环优化 Java 代码:替代多个循环的策略

    使用单个循环优化 Java 代码:替代多个循环的策略使用单个循环优化 Java 代码:替代多个循环的策略使用单个循环优化 Java 代码:替代多个循环的策略使用单个循环优化 Java 代码:替代多个循环的策略

    本文旨在帮助开发者优化 Java 代码,特别是当遇到需要多次遍历同一数据集以查找不同类型数据时。我们将探讨如何使用单个循环和标志变量来替代多个循环,从而提高代码的效率和可读性,并提供多种优化策略,包括使用布尔标志、数组和辅助类,以及性能考量。 在处理数据时,经常会遇到需要从同一数据集中提取不同类型的…

    2026年9月28日 • 用户投稿
    100
  • 荣耀MagicBook Art 14 2025发布:1kg、1cm,8499元起

    荣耀MagicBook Art 14 2025发布:1kg、1cm,8499元起荣耀MagicBook Art 14 2025发布:1kg、1cm,8499元起荣耀MagicBook Art 14 2025发布:1kg、1cm,8499元起荣耀MagicBook Art 14 2025发布:1kg、1cm,8499元起

    7月2日,荣耀推出全新旗舰轻薄本magicbook art 14 2025。该产品整机重量1kg,闭合状态厚度1cm,起售价8499元(国补后6799.2元起),即日开售。 该产品配备1600nit OLED绿洲护眼屏:14.6英寸触控屏支持4320Hz高频PWM调光、100% DCI-P3色域及Δ…

    2026年9月28日 • 用户投稿
    1200
  • 如何在 Android 中保存动态创建的复选框状态

    如何在 Android 中保存动态创建的复选框状态如何在 Android 中保存动态创建的复选框状态如何在 Android 中保存动态创建的复选框状态如何在 Android 中保存动态创建的复选框状态

    本文介绍了如何在 Android 应用中保存动态创建的复选框的状态,以便用户在重新打开应用或界面后,复选框的选中状态能够保持不变。我们将探讨使用 SharedPreferences 来持久化复选框状态的方法,并提供示例代码帮助你理解和实现。 使用 SharedPreferences 持久化复选框状态…

    2026年9月28日 • 用户投稿
    000
  • 如何在Android中保存动态创建的CheckBox的状态

    如何在Android中保存动态创建的CheckBox的状态如何在Android中保存动态创建的CheckBox的状态如何在Android中保存动态创建的CheckBox的状态如何在Android中保存动态创建的CheckBox的状态

    本文旨在帮助开发者解决在Android应用中动态创建的CheckBox的状态保存问题。通过利用Shared Preferences,我们可以有效地存储CheckBox的选中状态,确保用户在重新进入应用或页面时,CheckBox的状态能够被正确恢复,从而提供更佳的用户体验。本文将提供详细的步骤和示例代…

    2026年9月28日 • 用户投稿
    100
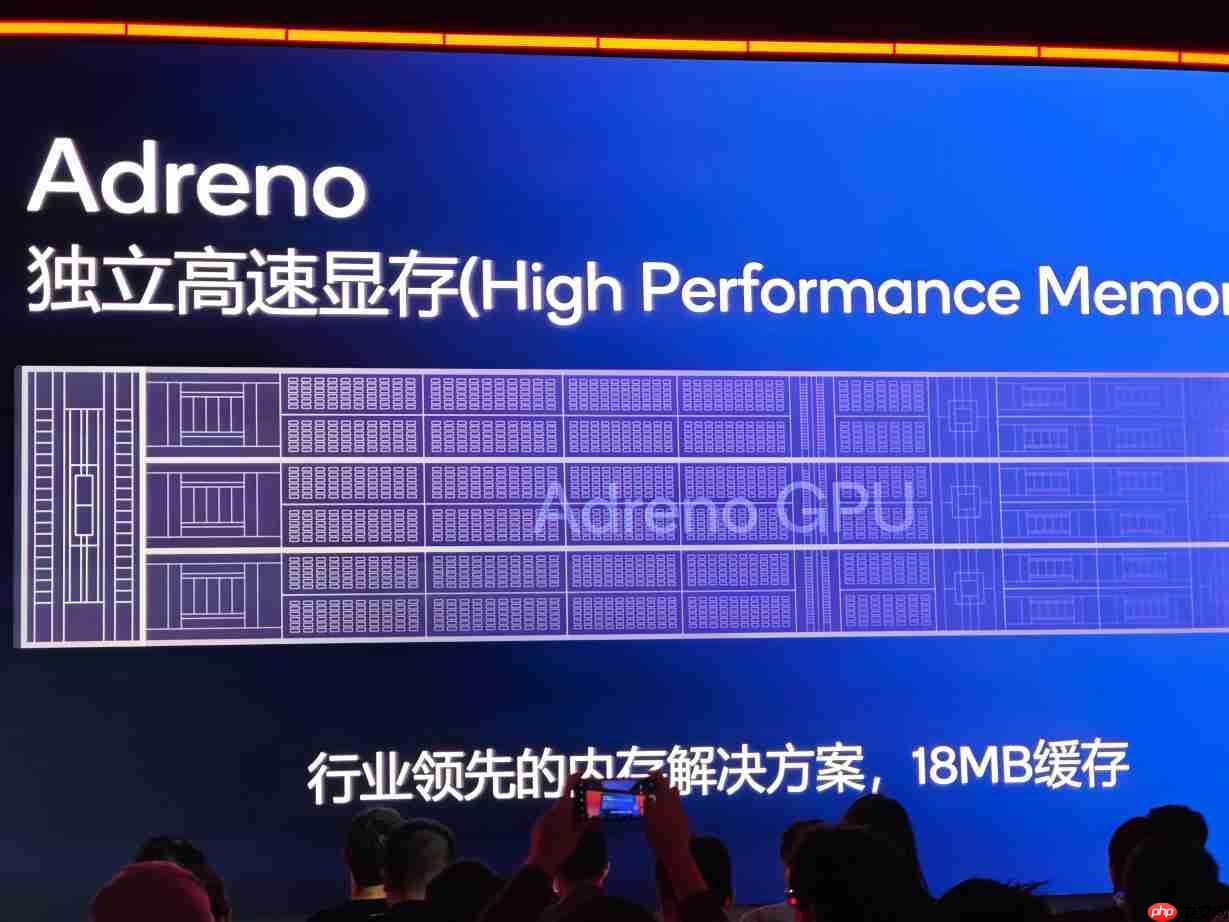
  • 第五代高通骁龙8至尊版正式发布:全球最快移动SoC

    第五代高通骁龙8至尊版正式发布:全球最快移动SoC第五代高通骁龙8至尊版正式发布:全球最快移动SoC第五代高通骁龙8至尊版正式发布:全球最快移动SoC第五代高通骁龙8至尊版正式发布:全球最快移动SoC

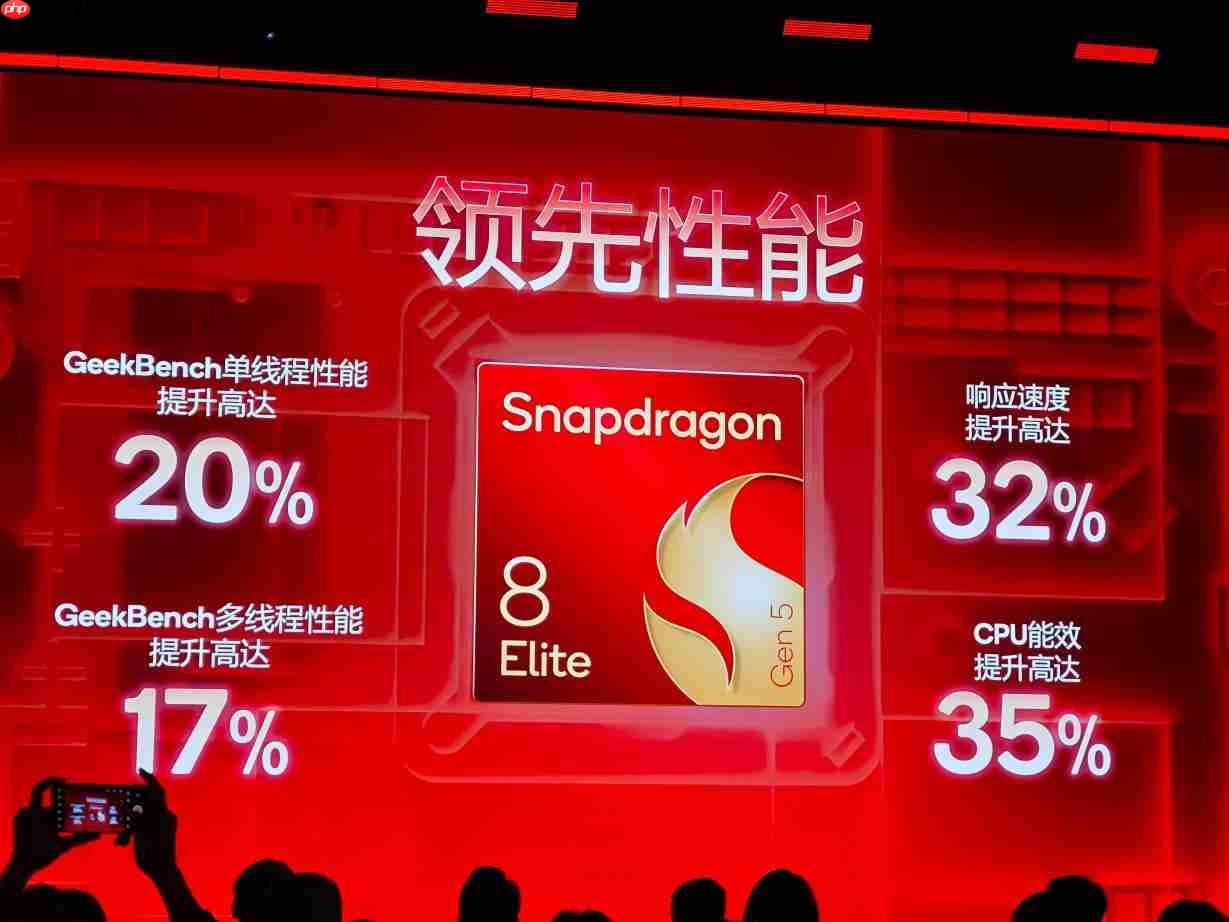
    在今日举行的骁龙峰会上,高通正式发布了其最新旗舰移动平台——第五代骁龙 8 至尊版(Snapdragon 8 Elite Gen 5),并宣称该芯片为“全球速度最快的移动 SoC”。 此次发布的芯片基于台积电最新的第三代3nm N3P工艺打造,在CPU架构上采用了全新的Oryon核心设计,延续了2+…

    2026年9月28日 • 用户投稿
    000
  • Java中ArrayList引用传递陷阱:避免数据意外修改的策略

    Java中ArrayList引用传递陷阱:避免数据意外修改的策略Java中ArrayList引用传递陷阱:避免数据意外修改的策略Java中ArrayList引用传递陷阱:避免数据意外修改的策略Java中ArrayList引用传递陷阱:避免数据意外修改的策略

    本文探讨了Java中ArrayList作为引用类型在对象构造时可能导致的数据意外修改问题。当将同一个ArrayList实例传递给多个对象后,对该列表的后续操作(如清空或添加元素)会影响所有引用它的对象。核心解决方案是为每个需要独立数据副本的对象,实例化一个新的ArrayList,从而确保数据隔离和一…

    2026年9月28日 • 用户投稿
    100
  • sublime怎么处理gbk编码的文件不乱码_Sublime正确打开GBK编码文件不乱码的设置

    sublime怎么处理gbk编码的文件不乱码_Sublime正确打开GBK编码文件不乱码的设置sublime怎么处理gbk编码的文件不乱码_Sublime正确打开GBK编码文件不乱码的设置sublime怎么处理gbk编码的文件不乱码_Sublime正确打开GBK编码文件不乱码的设置sublime怎么处理gbk编码的文件不乱码_Sublime正确打开GBK编码文件不乱码的设置

    安装ConvertToUTF8插件可解决Sublime Text打开GBK文件乱码问题,该插件能自动识别并转换编码,确保文件正确显示且保存时保留原编码,同时建议设置默认编码为UTF-8、备用编码为GBK,并通过项目配置或团队规范统一编码,避免后续乱码。 Sublime Text在处理GBK编码文件时…

    2026年9月28日 • 用户投稿
    200

发表回复

登录后才能评论
关注微信