Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
基于 Flink 和 Kafka 实现高效流处理:连续查询与时间窗口_创想鸟

基于 Flink 和 Kafka 实现高效流处理:连续查询与时间窗口

基于 flink 和 kafka 实现高效流处理:连续查询与时间窗口

本文旨在指导读者如何利用 Apache Flink 和 Kafka 构建实时连续查询系统。我们将详细探讨如何配置 Flink 的 Kafka 连接器作为数据源,并深入讲解 Flink 强大的窗口处理功能,特别是时间窗口的应用,以实现对实时数据流的聚合、分析和洞察,从而有效处理和响应无界数据流。

引言:理解连续查询与流处理

在现代数据驱动的应用中,对实时数据的即时处理和分析变得至关重要。传统的批处理系统在处理海量、持续生成的数据流时显得力不从心。流处理(Stream Processing)应运而生,它专注于处理无限的、连续的数据流。连续查询(Continuous Query)是流处理的核心概念之一,它允许用户定义一个查询逻辑,该逻辑将持续地在进入系统的数据流上执行,并实时输出结果,而不是等待所有数据都到达后再进行一次性计算。

Apache Flink 是一个强大的流处理框架,能够处理有界和无界数据流,并提供事件时间语义、状态管理和容错机制。Apache Kafka 作为一个高吞吐、低延迟的分布式流平台,常被用作流处理系统的数据源和数据汇。将 Flink 与 Kafka 结合,可以构建出健壮且高效的实时数据处理管道。

核心组件:Apache Kafka 与 Apache Flink

Apache Kafka:实时数据源

Kafka 作为一个分布式消息队列,具备以下关键特性,使其成为流处理的理想数据源:

高吞吐量与低延迟: 能够处理每秒数百万条消息。持久性: 消息被持久化到磁盘,确保数据不丢失。可扩展性: 轻松扩展以应对不断增长的数据量。发布-订阅模型: 允许多个消费者独立地读取同一主题的数据。

在 Flink 的连续查询场景中,Kafka 主要扮演数据入口的角色,负责收集和传输各种实时事件数据(如用户行为日志、传感器数据、交易记录等)。

Apache Flink:流处理引擎

Flink 是一个专门为流处理设计的分布式计算引擎,其主要优势包括:

事件时间处理: 能够根据事件发生的时间而不是处理时间来处理数据,有效处理乱序数据。灵活的窗口操作: 提供多种窗口类型(滚动、滑动、会话等),用于对数据流进行聚合。状态管理与容错: 内置强大的状态管理机制,支持检查点和保存点,确保作业的高可用性和数据一致性。丰富的连接器: 提供与 Kafka、HDFS、Cassandra 等多种外部系统的连接器。

集成 Kafka 作为 Flink 数据源

在 Flink 中,通过 KafkaSource 连接器可以方便地从 Kafka 主题读取数据。以下是配置 Flink Kafka Source 的基本步骤和示例代码:

Ai Mailer Ai Mailer

使用Ai Mailer轻松制作电子邮件

Ai Mailer 49 查看详情 Ai Mailer

添加依赖:首先,确保您的 Flink 项目中包含了 Kafka 连接器的 Maven 依赖:

    org.apache.flink    flink-connector-kafka    1.17     org.apache.flink    flink-streaming-java    1.17    provided    org.apache.flink    flink-clients    1.17    provided

配置 KafkaSource:使用 KafkaSource.builder() 来构建 Kafka 数据源。您需要指定 Kafka brokers 地址、要消费的 topic、消费者组 ID 以及消息的反序列化器。

import org.apache.flink.api.common.eventtime.WatermarkStrategy;import org.apache.flink.api.common.serialization.SimpleStringSchema;import org.apache.flink.connector.kafka.source.KafkaSource;import org.apache.flink.connector.kafka.source.enumerator.initializer.OffsetsInitializer;import org.apache.flink.streaming.api.datastream.DataStream;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;public class FlinkKafkaSourceExample {    public static void main(String[] args) throws Exception {        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();        env.setParallelism(1); // 简化示例,实际生产环境可根据需求调整并行度        // 1. 配置 Kafka Source        KafkaSource kafkaSource = KafkaSource.builder()                .setBootstrapServers("localhost:9092") // Kafka Broker 地址                .setTopics("my-input-topic") // 输入 Kafka Topic                .setGroupId("flink-kafka-consumer-group") // 消费者组 ID                .setStartingOffsets(OffsetsInitializer.earliest()) // 从最早的偏移量开始消费                .setValueOnlyDeserializer(new SimpleStringSchema()) // 使用 SimpleStringSchema 反序列化消息                .build();        // 2. 从 Kafka 读取数据        DataStream rawKafkaStream = env.fromSource(kafkaSource,                WatermarkStrategy.noWatermarks(), // 初始不设置水位线,后面会进行处理                "Kafka Source");        // 3. 打印接收到的数据        rawKafkaStream.print("Received from Kafka");        // 4. 执行 Flink 作业        env.execute("Flink Kafka Source Example");    }}

在上述代码中,我们创建了一个 KafkaSource,它将从 localhost:9092 的 Kafka 集群中名为 my-input-topic 的主题消费数据,并属于 flink-kafka-consumer-group 消费者组。OffsetsInitializer.earliest() 表示从主题的最早可用偏移量开始消费。SimpleStringSchema 用于将 Kafka 消息的字节数组反序列化为 Java 字符串。

利用 Flink 窗口处理实现时间切片与聚合

连续查询的核心需求之一是对无界数据流进行有界处理,即在某个时间段内对数据进行聚合或统计。Flink 的窗口(Window)机制正是为此而生。它将无限的数据流切分成有限的“窗口”,然后对每个窗口内的数据进行计算。

窗口类型概述

Flink 提供了多种窗口类型,最常用的是基于时间的窗口:

滚动时间窗口(Tumbling Event-Time Windows): 将数据流切分成固定大小、不重叠的时间段。例如,每分钟统计一次。滑动时间窗口(Sliding Event-Time Windows): 同样是固定大小,但窗口之间可以有重叠,并以固定的滑动间隔向前移动。例如,每30秒计算过去1分钟的数据。会话窗口(Session Windows): 根据活动间隔(即数据之间的时间间隙)来划分窗口,当数据流停止一段时间后,窗口关闭。

事件时间与水位线(Watermarks)

为了实现准确的事件时间窗口处理,Flink 引入了事件时间(Event Time)和水位线(Watermarks)的概念。

事件时间: 指事件实际发生的时间,通常由事件本身携带。水位线: 是一种特殊的、周期性生成的标记,表示在流中某个时间点之前的所有事件都应该已经到达。水位线机制帮助 Flink 处理乱序到达的数据,确保在某个时间窗口被“触发”计算时,尽可能多的相关事件已经到达。

示例:基于事件时间的滚动窗口聚合

以下示例展示了如何结合 Kafka Source 和 Flink 的事件时间滚动窗口,对流入的事件进行每分钟的计数聚合。我们假设 Kafka 消息是形如 “eventType,timestamp_in_ms” 的字符串,例如 “click,1678886400000″。

import org.apache.flink.api.common.eventtime.WatermarkStrategy;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.api.common.serialization.SimpleStringSchema;import org.apache.flink.api.java.tuple.Tuple2;import org.apache.flink.connector.kafka.source.KafkaSource;import org.apache.flink.connector.kafka.source.enumerator.initializer.OffsetsInitializer;import org.apache.flink.streaming.api.datastream.DataStream;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.windowing.assigners.TumblingEventTimeWindows;import org.apache.flink.streaming.api.windowing.time.Time;import java.time.Duration;public class FlinkKafkaContinuousQueryWithWindows {    public static void main(String[] args) throws Exception {        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();        env.setParallelism(1); // 简化示例,实际生产环境可根据需求调整并行度        // 1. 配置 Kafka Source        KafkaSource kafkaSource = KafkaSource.builder()                .setBootstrapServers("localhost:9092") // Kafka Broker 地址                .setTopics("my-input-topic") // 输入 Kafka Topic                .setGroupId("flink-kafka-consumer-group") // 消费者组 ID                .setStartingOffsets(OffsetsInitializer.earliest()) // 从最早的偏移量开始消费                .setValueOnlyDeserializer(new SimpleStringSchema()) // 使用 SimpleStringSchema 反序列化消息                .build();        // 2. 从 Kafka 读取数据        DataStream rawKafkaStream = env.fromSource(kafkaSource,                WatermarkStrategy.noWatermarks(), // 初始不设置水位线                "Kafka Source");        // 3. 解析消息并提取事件时间,然后应用 WatermarkStrategy        // 假设每条消息是 "eventType,timestamp_in_ms"        // 例如: "click,1678886400000" (Unix timestamp in milliseconds)        DataStream<Tuple2> eventStream = rawKafkaStream                .map(new MapFunction<String, Tuple2>() {                    @Override                    public Tuple2 map(String value) throws Exception {                        String[] parts = value.split(",");                        String eventType = parts[0];                        Long timestamp = Long.parseLong(parts[1]);                        return new Tuple2(eventType, timestamp);                    }                })                .assignTimestampsAndWatermarks(                        // 允许事件乱序到达,最大乱序时间为5秒                        WatermarkStrategy.<Tuple2>forBoundedOutOfOrderness(Duration.ofSeconds(5))                                .withTimestampAssigner((event, recordTimestamp) -> event.f1) // 使用Tuple2的第二个字段作为事件时间                );        // 4. 应用时间窗口进行聚合:统计每分钟内每种事件类型的数量        DataStream<Tuple2> processedStream = eventStream                // 将每个事件映射为 (事件类型, 1L),以便后续求和计数                .map(new MapFunction<Tuple2, Tuple2>() {                    @Override                    public Tuple2 map(Tuple2 value) throws Exception {                        return new Tuple2(value.f0, 1L);                    }                })                .keyBy(value -> value.f0) // 按事件类型分组                .window(TumblingEventTimeWindows.of(Time.minutes(1))) // 定义1分钟的滚动

以上就是基于 Flink 和 Kafka 实现高效流处理:连续查询与时间窗口的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1063276.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
苹果 iOS 18 拥抱个性化:像 2008 年以来安卓系统一样定制主屏幕
上一篇 2025年12月2日 05:45:20
知音漫客官网阅读记录_知音漫客官网收藏列表
下一篇 2025年12月2日 05:45:22

相关推荐

  • 用高刷带鱼屏打游戏 Vidda 三色激光投影亮相 AWE2024

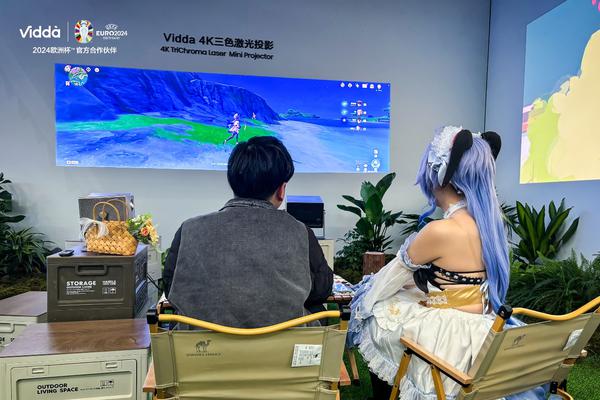
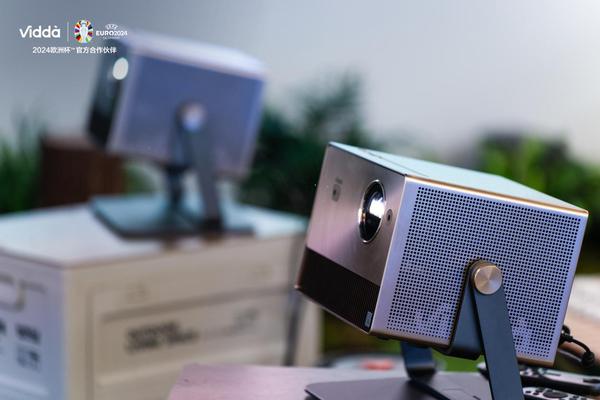
    用高刷带鱼屏打游戏 Vidda 三色激光投影亮相 AWE2024用高刷带鱼屏打游戏 Vidda 三色激光投影亮相 AWE2024用高刷带鱼屏打游戏 Vidda 三色激光投影亮相 AWE2024用高刷带鱼屏打游戏 Vidda 三色激光投影亮相 AWE2024

    vidda三色激光投影于2024年3月14日在上海awe中国家电及消费电子博览会再次展示其技术。除了传统的电影观赏体验,vidda三色激光投影还展示了一种新的玩法——通过两台投影仪拼接成超宽屏幕,为高刷新率游戏带来全新的沉浸体验。这种创新的应用方式吸引了众多参观者的目光,展示了投影技术在娱乐领域的无…

    2026年9月28日 • 用户投稿
    000
  • JNA高级教程:如何高效映射C语言嵌套结构体与联合体

    JNA高级教程:如何高效映射C语言嵌套结构体与联合体JNA高级教程:如何高效映射C语言嵌套结构体与联合体JNA高级教程:如何高效映射C语言嵌套结构体与联合体JNA高级教程:如何高效映射C语言嵌套结构体与联合体

    本教程深入探讨了JNA在Java与C语言之间进行复杂数据类型映射的机制,特别是针对包含嵌套结构体和联合体(Union)的场景。文章通过分析一个实际的错误案例,详细阐述了JNA对Java类继承Structure或Union的严格要求,并提供了两种核心解决方案:一是直接构建与C语言定义精确对应的JNA映…

    2026年9月28日 • 用户投稿
    000
  • 解决“USB4 设备功能可能受限”:Win11 USB4 支持文档终于更新

    解决“USB4 设备功能可能受限”:Win11 USB4 支持文档终于更新解决“USB4 设备功能可能受限”:Win11 USB4 支持文档终于更新解决“USB4 设备功能可能受限”:Win11 USB4 支持文档终于更新解决“USB4 设备功能可能受限”:Win11 USB4 支持文档终于更新

    微软于2023年5月推出了kb5026446更新,在windows 11 22h2版本(build 22621.1778)中为usb4设备新增了一个专门的设置界面,位于“蓝牙和设备”选项之下。在此之前,usb4并未配备独立的支持页面,但日前官方已更新相关文档,提供了解决“usb4设备功能可能受限”问…

    2026年9月28日 • 用户投稿
    100
  • sublime怎么配置python的虚拟环境_Python虚拟环境集成指南

    sublime怎么配置python的虚拟环境_Python虚拟环境集成指南sublime怎么配置python的虚拟环境_Python虚拟环境集成指南sublime怎么配置python的虚拟环境_Python虚拟环境集成指南sublime怎么配置python的虚拟环境_Python虚拟环境集成指南

    答案是通过创建自定义构建系统和配置项目文件确保Sublime Text使用指定虚拟环境。具体做法包括:在.sublime-build文件中指定虚拟环境Python解释器路径,结合.cmd字段设置无缓冲运行参数-u,并在.sublime-project文件中为项目定义独立的build_systems与…

    2026年9月28日 • 用户投稿
    000
  • 如何在Docker中安装Linux环境_Docker容器运行Ubuntu系统

    如何在Docker中安装Linux环境_Docker容器运行Ubuntu系统如何在Docker中安装Linux环境_Docker容器运行Ubuntu系统如何在Docker中安装Linux环境_Docker容器运行Ubuntu系统如何在Docker中安装Linux环境_Docker容器运行Ubuntu系统

    首先拉取Ubuntu镜像并启动容器,使用docker pull ubuntu:20.04和docker run -it命令进入系统,安装软件需执行apt update并配置常用工具,通过-v参数实现文件挂载共享,建议用Dockerfile或提交容器保存配置以防丢失。 在Docker中安装Linux环…

    2026年9月28日 • 用户投稿
    000
  • JNA高级教程:深入理解原生结构体与联合体映射

    JNA高级教程:深入理解原生结构体与联合体映射JNA高级教程:深入理解原生结构体与联合体映射JNA高级教程:深入理解原生结构体与联合体映射JNA高级教程:深入理解原生结构体与联合体映射

    本教程详细探讨了JNA在与原生库交互时,如何正确映射包含嵌套结构体或联合体的复杂数据类型。文章首先分析了IllegalArgumentException的常见原因——非Structure类型字段导致JNA无法确定原生大小,随后提供了两种解决方案:一是直接通过JNA的Structure和Union类精…

    2026年9月28日 • 用户投稿
    000
  • 夸克怎么彻底卸载干净_夸克APP及相关数据完全清除教程

    夸克怎么彻底卸载干净_夸克APP及相关数据完全清除教程夸克怎么彻底卸载干净_夸克APP及相关数据完全清除教程夸克怎么彻底卸载干净_夸克APP及相关数据完全清除教程夸克怎么彻底卸载干净_夸克APP及相关数据完全清除教程

    彻底卸载夸克APP需先通过系统设置卸载主程序,再手动删除残留文件夹如/Android/data/com.quark.browser,清除账户同步数据,并使用清理工具深度扫描残留项。 如果您尝试从设备中移除夸克应用,但发现残留数据或配置文件仍然存在,则可能是由于卸载过程中未清除用户数据与缓存信息。以下…

    2026年9月28日 • 用户投稿
    000
  • Win10系统无法更新设备驱动更新被禁用

    Win10系统无法更新设备驱动更新被禁用Win10系统无法更新设备驱动更新被禁用Win10系统无法更新设备驱动更新被禁用Win10系统无法更新设备驱动更新被禁用

    windows 10 系统默认会自动更新系统和驱动程序,但有些用户可能会遇到驱动更新被禁用的情况。如果 win10 设备驱动更新被禁用了,该如何解决呢?接下来,小编将为大家详细介绍具体的操作步骤,希望能帮到有需要的朋友们。 Win10 系统无法更新设备驱动更新被禁用怎么办: 首先,按下 Win+R …

    2026年9月28日 • 用户投稿
    000
  • 如何解决MySQL安装时权限不足的处理方法?

    如何解决MySQL安装时权限不足的处理方法?如何解决MySQL安装时权限不足的处理方法?如何解决MySQL安装时权限不足的处理方法?如何解决MySQL安装时权限不足的处理方法?

    mysql安装时权限不足问题可通过以下方法解决:1.使用管理员权限运行安装程序;2.检查并修改安装目录权限;3.关闭uac;4.修改mysql配置文件指定用户目录;5.检查防火墙和杀毒软件;6.查看安装日志定位问题;7.手动创建数据目录并设置权限;8.考虑使用docker。 MySQL安装时权限不足…

    2026年9月28日 • 用户投稿
    000
  • SublimeText如何管理多个项目窗口_Workspace工作区使用方法

    SublimeText如何管理多个项目窗口_Workspace工作区使用方法SublimeText如何管理多个项目窗口_Workspace工作区使用方法SublimeText如何管理多个项目窗口_Workspace工作区使用方法SublimeText如何管理多个项目窗口_Workspace工作区使用方法

    Sublime Text通过项目文件(.sublime-project)和工作区文件(.sublime-workspace)实现多项目高效管理,前者保存共享的静态配置如文件夹结构和构建系统,建议提交至版本控制;后者记录个人动态状态如打开文件、光标位置和布局,应被忽略以避免冲突。使用“快速切换项目”功…

    2026年9月28日 • 用户投稿
    200
  • Java中List of Lists按指定列排序与查找教程

    Java中List of Lists按指定列排序与查找教程Java中List of Lists按指定列排序与查找教程Java中List of Lists按指定列排序与查找教程Java中List of Lists按指定列排序与查找教程

    本教程详细介绍了如何在Java中处理List<List>数据结构,以实现按指定“列”进行排序,并在此基础上高效查找包含特定值的“行”。文章通过自定义Comparator来对行数据进行比较和排序,并提供了识别目标列索引的策略,从而解决了在复杂嵌套列表中进行数据组织和检索的常见挑战。 1. …

    2026年9月28日 • 用户投稿
    100
  • 豆包AI安装后如何配置TPU加速 豆包AI张量处理器优化方案

    本文将详细介绍在豆包AI环境中,如何配置张量处理器(TPU)以实现加速优化。我们将从理解TPU的基本原理开始,逐步讲解安装驱动、设置环境以及验证加速效果的整个过程,旨在帮助用户高效地利用TPU提升豆包AI模型的训练和推理性能。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 D…

    2026年9月28日
    200
  • Linux学习笔记(二)系统基础操作

    Linux学习笔记(二)系统基础操作Linux学习笔记(二)系统基础操作Linux学习笔记(二)系统基础操作Linux学习笔记(二)系统基础操作

    Linux基础学习笔记精选专栏 本专栏由小雨ttt创建,致力于分享学习linux基础知识的过程。本专栏不是机械地介绍linux指令集,而是包含了作者亲自实践的操作过程,站在一个初学者的角度理解linux基础知识。 目前本专栏包含的内容有: Linux学习笔记(一)使用文本编辑器VimLinux学习笔…

    2026年9月28日 • 用户投稿
    000
  • 360极速浏览器提示“喔唷,崩溃啦”怎么解决_浏览器崩溃问题常见原因及修复方案

    360极速浏览器提示“喔唷,崩溃啦”怎么解决_浏览器崩溃问题常见原因及修复方案360极速浏览器提示“喔唷,崩溃啦”怎么解决_浏览器崩溃问题常见原因及修复方案360极速浏览器提示“喔唷,崩溃啦”怎么解决_浏览器崩溃问题常见原因及修复方案360极速浏览器提示“喔唷,崩溃啦”怎么解决_浏览器崩溃问题常见原因及修复方案

    首先优化内存与缓存设置,启用自动释放内存和清理缓存功能;其次使用浏览器内置的一键修复工具扫描并修复异常;若问题依旧,建议卸载后重新安装最新版浏览器;最后可借助360安全卫士等第三方工具进行系统级修复,排除插件冲突或组件损坏问题。 如果您在使用360极速浏览器时遇到“喔唷,崩溃啦”的提示,这通常意味着…

    2026年9月28日 • 用户投稿
    300
  • sublime怎么保存时自动格式化代码_Sublime配置保存时自动格式化代码方法

    sublime怎么保存时自动格式化代码_Sublime配置保存时自动格式化代码方法sublime怎么保存时自动格式化代码_Sublime配置保存时自动格式化代码方法sublime怎么保存时自动格式化代码_Sublime配置保存时自动格式化代码方法sublime怎么保存时自动格式化代码_Sublime配置保存时自动格式化代码方法

    安装插件并配置可实现Sublime Text保存时自动格式化代码,提升代码可读性与一致性。首先安装Package Control包管理器,通过控制台执行指定代码完成安装;重启后使用命令面板(Ctrl+Shift+P)调出Package Control: Install Package,搜索并安装所需…

    2026年9月28日 • 用户投稿
    800
  • 在 Java 中对 List 的指定列进行排序和查找

    在 Java 中对 List 的指定列进行排序和查找在 Java 中对 List 的指定列进行排序和查找在 Java 中对 List 的指定列进行排序和查找在 Java 中对 List 的指定列进行排序和查找

    本文将详细介绍如何在 Java 中处理 List<List> 类型的数据,并实现以下功能:对指定列进行排序,在排序后的列表中使用二分查找(或类似方法)查找特定元素,并输出包含该元素的完整行。 问题背景 在实际开发中,我们经常会遇到需要处理二维数据的情况,例如从 CSV 文件读取的数据或者…

    2026年9月28日 • 用户投稿
    000
  • Windows记事本应用现在可以从Microsoft Store中获得

    Windows记事本应用现在可以从Microsoft Store中获得Windows记事本应用现在可以从Microsoft Store中获得Windows记事本应用现在可以从Microsoft Store中获得Windows记事本应用现在可以从Microsoft Store中获得

    早在2019年8月,微软就曾宣布计划将广受欢迎的Windows记事本应用迁移至应用商店,旨在提升其更新频率与运行效率。然而,到了同年12月底,微软突然叫停了这一计划,且未作过多解释。如今,这一目标终于得以实现——Windows记事本现已重新上线于微软应用商店,供用户下载使用。 自从Windows系统…

    2026年9月28日 • 用户投稿
    300
  • 在国内可以用的比较好的ai图片生成工具2025十大排名

    在国内可以用的比较好的ai图片生成工具2025十大排名在国内可以用的比较好的ai图片生成工具2025十大排名在国内可以用的比较好的ai图片生成工具2025十大排名在国内可以用的比较好的ai图片生成工具2025十大排名

    答案:2025年国内AI图片生成工具将更注重本地化、移动端体验、版权保护、个性化定制及行业融合,代表工具如稿定设计、盗梦师、Vega AI等,选择应基于用户需求、创作目的与预算,AI不会取代艺术家,而是辅助创作。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek…

    2026年9月28日 • 用户投稿
    1000
  • 360极速浏览器怎么设置默认下载工具_关联第三方下载软件操作方法

    360极速浏览器怎么设置默认下载工具_关联第三方下载软件操作方法360极速浏览器怎么设置默认下载工具_关联第三方下载软件操作方法360极速浏览器怎么设置默认下载工具_关联第三方下载软件操作方法360极速浏览器怎么设置默认下载工具_关联第三方下载软件操作方法

    首先更改360极速浏览器默认下载工具以调用第三方下载软件。进入设置页面的下载设置选项,选择“选择默认下载工具”并从下拉列表中选取已安装的工具如迅雷或IDM;若未显示目标工具,可选“自定义”或“浏览”,手动定位其.exe主程序文件完成关联;最后通过点击网页下载链接验证是否成功调起第三方工具,确保设置生…

    2026年9月28日 • 用户投稿
    400
  • win7进安全模式跳到修复系统的方法?

    win7进安全模式跳到修复系统的方法?win7进安全模式跳到修复系统的方法?win7进安全模式跳到修复系统的方法?win7进安全模式跳到修复系统的方法?

    今天有朋友问我如何让win7进入安全模式跳转到维修?原来,他的电脑出了问题,win7进入安全模式跳转修复这么简单的方法就不行了,只需几步即可。在这里,小编将win7进入安全模式跳转到修复系统方法向大家介绍。 教程/方法  1,在Win7安全模式下删除顽固文件  删除时如果文件处于Windows的正常…

    2026年9月28日 • 用户投稿
    000

发表回复

登录后才能评论
关注微信