Hadoop系列之一:大数据存储及处理平台产生的背景

传统的关系型数据库中的表通常由一个或多个字段组成,每个字段都预先定义了其可存储数据的格式及约束等,这类的数据就是结构化数据(structureddata)。一个设计良

传统的关系型数据库中的表通常由一个或多个字段组成,每个字段都预先定义了其可存储数据的格式及约束等,这类的数据就是结构化数据(structured data)。一个设计良好的数据库在其schema中定义这些格式或约束,并由相应的rdbms为这些提供实现保证。相应地,香港服务器租用,非结构化数据(unstructured data)就是指那些没有一个预定义的数据模型或不适于存储在rdbms中的数据,这些数据没有额外的描述信息(元数据)因此无法推断这些信息的真实意义,比如文本文件。半结构化数据(semi-structured data)有着特定的结构,但每个记录的结构未必完全相同,因此,无法为这些数据记录提供预定义的schema,其元数据只有在数据创建时才能获取,通常都与数据交相存储从而实现自我描述(self-describing),如xml文件。
 

话袋AI笔记 话袋AI笔记

话袋AI笔记, 像聊天一样随时随地记录每一个想法,打造属于你的个人知识库,成为你的外挂大脑

话袋AI笔记 195 查看详情 话袋AI笔记

现今,如搜索引擎类公司的网络爬虫爬行而来的web页面或社交类站点产生的用户访问日志都属半结构化或非结构化数据,传统的关系型数据库管理系统对这类数据的存储及处理能力有限,于是处理这类数据的需求就催生了一种新的数据库系统,即大数据管理系统(Big Data System)或NoSQL。这场声势浩大的数据库管理系统革新运动以Google、Amazon、Yahoo!、Facebook等先锋为主导展开的。这些组织或者由自己的业务生成海量数据,或从互联网上自由获取海量数据,但对这些海量数据进行存储、分析和处理都无一例外地成为支撑其业务的核心需求。初期,他们都采用了当时主流的数据管理技术来满足类似需求,但也都在各自的应用中遇到了规模扩展、存储性能等各方面的限制。尽管数据管理并非他们的核心业务,但数据处理却成支撑其业务运作基本组成部分,因此他们各自注入大量的技术实力依据业务需求进行新技术研发。


尽管许多公司都对他们的研究成果采取了保密措施,Google却选择了将他们的成功经验公之于众。2003年,Google公开发表了论文“The Google File System”,系统阐述了采取商用硬件计算机集群存储海量数据的分布式文件系统GFS的实现;GFS采取“数据块”管理文件数据,并在集群中多个节点上存储同一个数据块的副本以实现冗余功能;GFS设计用来支持大规模、数据密集型、分布式应用程序的运行;此外,它还为流式数据读取进行了优化,因此特别适用于存储之后读取数据并对之做出处理类的操作。这之后的第二年,Google又公开发表了另一篇论文“MapReduce: Simplified

Data Processing on Large Clusters”,定义了一个编程模型及其运行框架,提供了于集群中的多个节点上自动并行、容错及可处理数百TB规模的数据集数据处理平台;MapReduce是GFS集群的组成部分,它是一个编程框架,能够让用户编写的代码分布式运行于GFS集群中的多个节点上尽可能通过本地数据访问完成数据的并行处理操作。MapReduce与GFS一同构成了大数据存储及并行处理平台,Google的搜索索引的建立也正是基于此平台得以高效运行。与此同时,美国空间,Amazon也公开其购物车实现的基础组件Dynamo。


Google的MapReduce及GFS提供了海量数据存储及并行处理平台,但GFS并不支持对数据进行随机或实时访问,且仅适用于存储少量的、体积巨大大的文件,对海量小数据文件的管理有此力不从心。故此,Google开始寻找一种能够充分发挥GFS的高可用性及海量存储能力,又能支持类似邮件或分析系统等交互式应用的数据管理解决方案。这种数据存储要能够有效管理海量数据片断,又可以透明地将这些小数据片合并成为适合存储于GFS的大文件,也要内生地支持排序索引以在数据检索时最小程度地触发磁盘IO操作,还要能够存储网络爬行而来的海量数据并将其提供给MapReduce及时、快速构建搜索索引。针对这些需求,传统的RDBMS系统的管理能力已难以为继,因此Google的工程师发明了一种新的处理系统,这种系统移除了关系型数据库系统的众多特性而提供一种仅支持CRUD(Create、Read、Update和Delete)操作的简单API,以及一个实现范围或全表遍历的scan功能。2006年,Google将这些研究成果通过“Bigtable: A Distributed Storage System for Structured Data”论文公之于众。


任何对MapReduce、GFS及Bigtable技术感兴的朋友都应该认真读一读Google贡献给全人类的这三篇传世之作。它们也是开源系统Hadoop、HBase等得以构建的理论基石,Hadoop的核心组件为MapReduce和HDFS,其中Hadoop的MapReduce是Google的MapReduce技术的开源实现,HDFS是GFS的开源实现,HBase是Bigtable的开源实现。因此,网站空间,这三篇论文也是深入学习Hadoop、HBase等的基础性材料。


参考资料:

Introduction to Database Systems

Hadoop Operations

Hadoop The Definitive Guide 3rd edtion

HBase The Definitive Guide

HBase in Action


本文出自 “马哥教育” 博客,转载请与作者联系!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1083306.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
VSCode怎么运行Python脚本_VSCode执行和调试Python代码的方法教程
上一篇 2025年12月2日 21:16:30
再战星途 《决战》新区“豪情壮志”今日开启
下一篇 2025年12月2日 21:16:31

相关推荐

  • 在Java中如何统计List中元素出现次数

    答案是使用Map或Stream API统计List元素频次最高效。通过HashMap手动遍历统计,或用Java 8的Stream结合groupingBy和counting()实现简洁计数,Collections.frequency适用于小数据量但性能较差,推荐Stream方式兼顾性能与可读性。 在J…

    2026年9月22日
    900
  • 如何在Dask中训练AI大模型?分布式数据处理的AI训练技巧

    如何在Dask中训练AI大模型?分布式数据处理的AI训练技巧如何在Dask中训练AI大模型?分布式数据处理的AI训练技巧如何在Dask中训练AI大模型?分布式数据处理的AI训练技巧如何在Dask中训练AI大模型?分布式数据处理的AI训练技巧

    Dask在处理超大规模数据集时的独特优势在于其Python原生的分布式计算能力,能无缝扩展Pandas和NumPy的工作流,突破单机内存限制,实现高效的数据预处理与模型训练。它通过惰性计算、分块处理和内存溢写机制,支持TB级数据的并行操作,相比Spark提供了更贴近Python数据科学生态的API和…

    2026年9月22日 用户投稿
    100
  • 如何用Filmora制作高质量AI视频?简易AI视频剪辑的实用指南

    如何用Filmora制作高质量AI视频?简易AI视频剪辑的实用指南如何用Filmora制作高质量AI视频?简易AI视频剪辑的实用指南如何用Filmora制作高质量AI视频?简易AI视频剪辑的实用指南如何用Filmora制作高质量AI视频?简易AI视频剪辑的实用指南

    Filmora的AI功能通过AI Copilot脚本生成、AI文本转视频、AI语音、图像生成、智能抠像及音频优化等工具,显著提升视频制作效率与专业度,尤其在视觉处理、听觉优化和创意辅助方面表现突出;关键在于将AI作为辅助起点,避免过度依赖,结合人工精修,才能实现高质量AI视频创作。 ☞☞☞AI 智能…

    2026年9月22日 用户投稿
    500
  • 如何在mysql中实现热备份

    最推荐的MySQL热备份方案是结合Percona XtraBackup全量备份与binlog增量备份,并通过主从复制实现高可用。首先使用XtraBackup对InnoDB引擎进行在线全量备份,无需锁表;备份后执行–prepare确保数据一致性,恢复时用–copy-back还原…

    2026年9月22日
    100
  • 如何在MXNet中训练AI大模型?高效构建深度学习的详细步骤

    如何在MXNet中训练AI大模型?高效构建深度学习的详细步骤如何在MXNet中训练AI大模型?高效构建深度学习的详细步骤如何在MXNet中训练AI大模型?高效构建深度学习的详细步骤如何在MXNet中训练AI大模型?高效构建深度学习的详细步骤

    答案是优化数据管道、采用分布式训练、应用内存优化技术、精细调参。具体包括:使用RecordIO格式和DataLoader多进程预取提升数据加载效率;通过KVStore选择device或dist_sync/dist_async实现单机或多机分布式训练;利用混合精度训练、梯度累积和模型符号化降低显存占用…

    2026年9月22日 用户投稿
    100
  • Invideo的AI混合工具怎么用?快速生成专业视频的实用教程

    Invideo的AI混合工具通过智能生成视频初稿并允许创作者精细调整,显著降低制作门槛、提升效率,其优势在于快速生成、易用性强、激发创意,用户可通过优化输入、替换素材、注入个性声音和保持风格统一来最大化潜力,同时需应对素材模式化、理解偏差等挑战。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索,…

    2026年9月22日
    500
  • 如何在MindSpore中训练AI大模型?华为AI框架的训练教程

    如何在MindSpore中训练AI大模型?华为AI框架的训练教程如何在MindSpore中训练AI大模型?华为AI框架的训练教程如何在MindSpore中训练AI大模型?华为AI框架的训练教程如何在MindSpore中训练AI大模型?华为AI框架的训练教程

    答案:MindSpore通过自动并行、混合精度、优化器状态分片等技术,结合Profiler工具调试性能瓶颈,实现大模型高效分布式训练。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 在MindSpore中训练AI大模型,核心在于巧妙地利用其…

    2026年9月21日 用户投稿
    400
  • 如何用PyTorch训练AI大模型?构建高效神经网络的完整教程

    如何用PyTorch训练AI大模型?构建高效神经网络的完整教程如何用PyTorch训练AI大模型?构建高效神经网络的完整教程如何用PyTorch训练AI大模型?构建高效神经网络的完整教程如何用PyTorch训练AI大模型?构建高效神经网络的完整教程

    PyTorch大模型训练需综合运用分布式训练、内存优化与高效计算策略。首先采用DistributedDataParallel实现多GPU并行,配合DistributedSampler确保数据均衡;通过混合精度训练、梯度累积和激活检查点缓解显存压力;使用torch.compile优化模型计算效率;选择…

    2026年9月21日 用户投稿
    100
  • 中国联通:前三季度营收2929亿 净利润同比增长5.2%

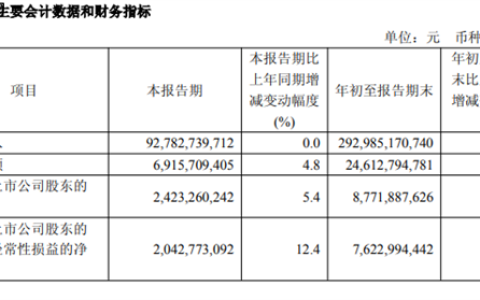
    10月22日,中国联通发布2025年第三季度业绩报告,披露前三季度公司实现营业收入2929.85亿元,同比增长1.0%;归属于母公司股东的净利润达到87.72亿元,较去年同期增长5.2%。 单季度数据显示,第三季度公司营收为927.83亿元,与上年同期持平;净利润为24.23亿元,同比增长5.4%。…

    2026年9月21日
    000
  • Java Stream 高效分组计数并获取Top N元素

    本文深入探讨了如何利用java stream api对数据进行高效的分组计数,并从中提取出现频率最高的top n元素。文章首先介绍了一种简洁的基于全排序的实现方式,该方法适用于数据集较小或top n值接近总数的情况。随后,针对大数据量和小型top n场景下的性能瓶颈,文章详细阐述了如何通过自定义`c…

    2026年9月21日
    100
  • 打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?

    打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?

    进入2024年,无论是硬件厂商还是软件供应商,都开始加大力度,向公众宣扬ai对工作生活乃至游戏的影响。在这样的背景下,选择购买一台全新的笔记本,很难不考量它的ai能力对自身使用的影响。因此,我们可以看到办公轻薄本的 ” 常青树 ” ——戴尔灵越系列,也凭借搭载的英特尔酷睿 u…

    2026年9月21日 用户投稿
    400
  • Java并发编程中CopyOnWriteArrayList使用场景

    CopyOnWriteArrayList适用于读多写少场景,通过写时复制实现线程安全,读操作无锁并发,迭代基于快照不抛异常,适合配置列表、监听器等数据变动少且需高性能读取的并发环境。 在Java并发编程中,CopyOnWriteArrayList 是一种线程安全的List实现,适用于读多写少的并发场…

    2026年9月21日
    100
  • 抖音商城是哪个公司在运营

    抖音商城的运营主体揭晓 抖音商城由北京微播视界科技有限公司负责运营。 作为抖音背后的母公司,字节跳动通过其全资子公司——微播视界,全面掌舵抖音平台及其电商板块的日常运作。依托雄厚的技术积累与多元化的业务布局,为用户打造流畅、智能且高效的购物环境。 抖音商城究竟是什么? 抖音商城是抖音App内嵌的一站…

    2026年9月21日
    200
  • mysql如何优化日期查询

    正确使用索引和避免函数干扰是MySQL日期查询优化的核心。1. 为日期字段添加索引,确保范围查询高效执行;2. 避免在WHERE条件中对日期字段使用DATE()、YEAR()等函数,改用范围比较;3. 用order_date >= ‘2024-01-01’ AND or…

    2026年9月20日
    100
  • mysql如何设计审计表

    设计MySQL审计表需明确审计范围,优先针对核心业务表实施行级、操作行为及DDL变更审计。采用通用结构audit_log表,以JSON字段存储新旧值,记录操作类型、时间、操作者等关键信息,并建立索引提升查询效率。通过触发器自动捕获数据变更,结合应用层传递真实用户身份与客户端信息,实现完整审计链路。1…

    2026年9月20日
    100
  • 跨境电商时差大?夜班客服成本高?智能客服多语言24小时值守,人力节省70%!告别熬夜值班!智能客服全天候守护全球生意,让跨境服务更轻松

    跨境电商的时差挑战终于迎来高效解决方案!当海外客户在深夜发起咨询,您无需再依赖高成本的夜间人工团队。晓多智能客服凭借先进的多语言ai应答系统,实现全天候无缝对接全球消费者。无论是英语市场的促销询问,还是法语用户的退换货请求,我们的智能客服都能精准理解并实时回复。某知名美妆品牌接入后,彻底摆脱了夜班排…

    2026年9月20日
    200
  • mysql如何实现用户行为分析

    答案:通过设计用户行为日志表并利用SQL实现活跃度、转化率、页面跳转和留存分析,结合索引优化与外部工具,MySQL可有效支持中小规模用户行为分析。 在MySQL中实现用户行为分析,核心是利用现有数据表结构(如用户操作日志、访问记录等)进行查询和统计,提取出有价值的用户行为模式。虽然MySQL不是专门…

    2026年9月13日
    100
  • mysql如何编写插入数据的insert语句

    编写INSERT语句的核心是安全准确地向表中插入数据,基本语法为INSERT INTO 表名 (列) VALUES (值);可省略列名或使用SET子句,也可通过INSERT … SELECT批量导入;为提升效率,应采用多行VALUES批量插入或LOAD DATA INFILE加载文件;面…

    2026年9月12日
    200
  • 如何在mysql中高效使用SELECT语句

    避免SELECT *,只查询必要列以减少I/O和网络开销;2. 在WHERE条件中使用索引字段并避免函数操作以防止索引失效;3. 用主键或唯一键进行分页优化,避免大偏移量导致性能下降。 在MySQL中高效使用SELECT语句,关键在于优化查询逻辑、合理利用索引以及减少不必要的数据处理。以下是一些实用…

    2026年9月12日
    000
  • 如何在mysql中优化批量写入效率

    使用批量INSERT、显式事务、调整InnoDB参数、优先LOAD DATA INFILE及优化索引策略可显著提升MySQL写入效率,核心是减少I/O与事务开销。 在 MySQL 中进行批量写入时,如果处理不当,很容易导致性能低下。优化批量写入效率可以从多个方面入手,核心目标是减少磁盘 I/O、降低…

    2026年9月12日
    000

发表回复

登录后才能评论
关注微信