Linux内核代码中广泛使用了数据结构和算法,其中最常用的两个是链表和红黑树。
链表
Linux内核代码大量使用了链表这种数据结构。链表是在解决数组不能动态扩展这个缺陷而产生的一种数据结构。链表所包含的元素可以动态创建并插入和删除。链表的每个元素都是离散存放的,因此不需要占用连续的内存。链表通常由若干节点组成,每个节点的结构都是一样的,由有效数据区和指针区两部分组成。有效数据区用来存储有效数据信息,而指针区用来指向链表的前继节点或者后继节点。因此,链表就是利用指针将各个节点串联起来的一种存储结构。
(1)单向链表
单向链表的指针区只包含一个指向下一个节点的指针,因此会形成一个单一方向的链表,如下代码所示。
struct list { int data; /*有效数据*/ struct list *next; /*指向下一个元素的指针*/};
如图所示,单向链表具有单向移动性,也就是只能访问当前的节点的后继节点,而无法访问当前节点的前继节点,因此在实际项目中运用得比较少。
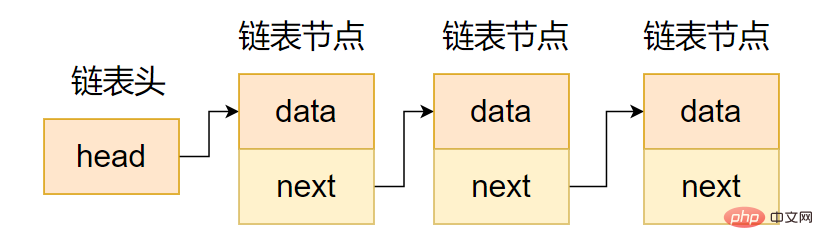
单向链表示意图
(2)双向链表
如图所示,双向链表和单向链表的区别是指针区包含了两个指针,一个指向前继节点,另一个指向后继节点,如下代码所示。
struct list { int data; /*有效数据*/ struct list *next; /*指向下一个元素的指针*/ struct list *prev; /*指向上一个元素的指针*/};
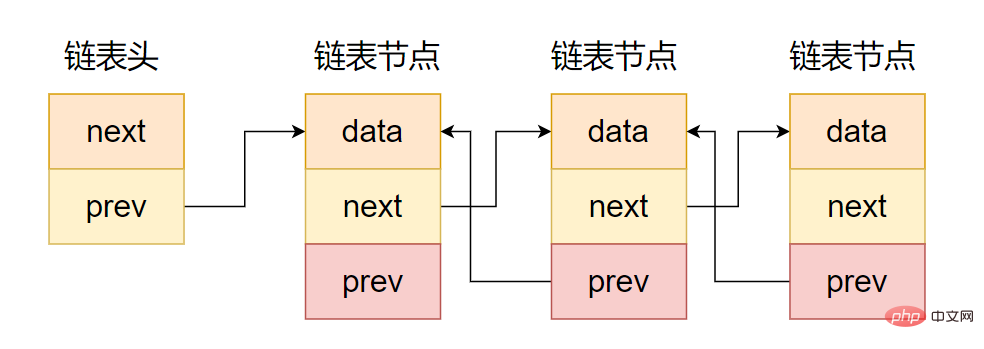
双向链表示意图
(3)Linux内核链表实现
单向链表和双向链表在实际使用中有一些局限性,如数据区必须是固定数据,而实际需求是多种多样的。这种方法无法构建一套通用的链表,因为每个不同的数据区需要一套链表。为此,Linux内核把所有链表操作方法的共同部分提取出来,把不同的部分留给代码编程者自己去处理。Linux内核实现了一套纯链表的封装,链表节点数据结构只有指针区而没有数据区,另外还封装了各种操作函数,如创建节点函数、插入节点函数、删除节点函数、遍历节点函数等。
Linux内核链表使用struct list_head数据结构来描述。
struct list_head { struct list_head *next, *prev;};
struct list_head数据结构不包含链表节点的数据区,通常是嵌入其他数据结构,如struct page数据结构中嵌入了一个lru链表节点,通常是把page数据结构挂入LRU链表。
struct page { ... struct list_head lru; ...}
链表头的初始化有两种方法,一种是静态初始化,另一种动态初始化。
把next和prev指针都初始化并指向自己,这样便初始化了一个带头节点的空链表。
/*静态初始化*/#define LIST_HEAD_INIT(name) { &(name), &(name) }#define LIST_HEAD(name) struct list_head name = LIST_HEAD_INIT(name)/*动态初始化*/static inline void INIT_LIST_HEAD(struct list_head *list){ list->next = list; list->prev = list;}
添加节点到一个链表中,内核提供了几个接口函数,如list_add()是把一个节点添加到表头,list_add_tail()是插入表尾。
void list_add(struct list_head *new, struct list_head *head)list_add_tail(struct list_head *new, struct list_head *head)
遍历节点的接口函数。
#define list_for_each(pos, head) for (pos = (head)->next; pos != (head); pos = pos->next)
这个宏只是遍历一个一个节点的当前位置,那么如何获取节点本身的数据结构呢?这里还需要使用list_entry()宏。
#define list_entry(ptr, type, member) container_of(ptr, type, member)container_of()宏的定义在kernel.h头文件中。#define container_of(ptr, type, member) ({ const typeof( ((type *)0)->member ) *__mptr = (ptr); (type *)( (char *)__mptr - offsetof(type,member) );})#define offsetof(TYPE, MEMBER) ((size_t) &((TYPE *)0)->MEMBER)
其中offsetof()宏是通过把0地址转换为type类型的指针,然后去获取该结构体中member成员的指针,也就是获取了member在type结构体中的偏移量。最后用指针ptr减去offset,就得到type结构体的真实地址了。
下面是遍历链表的一个例子。
static ssize_t class_osdblk_list(struct class *c, struct class_attribute *attr, char *data){ int n = 0; struct list_head *tmp; list_for_each(tmp, &osdblkdev_list) { struct osdblk_device *osdev; osdev = list_entry(tmp, struct osdblk_device, node); n += sprintf(data+n, "%d %d %llu %llu %sn", osdev->id, osdev->major, osdev->obj.partition, osdev->obj.id, osdev->osd_path); } return n;}
红黑树
红黑树(Red Black Tree)被广泛应用在内核的内存管理和进程调度中,用于将排序的元素组织到树中。红黑树被广泛应用在计算机科学的各个领域中,它在速度和实现复杂度之间提供一个很好的平衡。
红黑树是具有以下特征的二叉树。
每个节点或红或黑。
红黑树的一个优点是,所有重要的操作(例如插入、删除、搜索)都可以在O(log n)时间内完成,n为树中元素的数目。经典的算法教科书都会讲解红黑树的实现,这里只是列出一个内核中使用红黑树的例子,供读者在实际的驱动和内核编程中参考。这个例子可以在内核代码的documentation/Rbtree.txt文件中找到。
#include #include #include #include #include #include #include MODULE_AUTHOR("figo.zhang");MODULE_DESCRIPTION(" ");MODULE_LICENSE("GPL"); struct mytype { struct rb_node node; int key; };/*红黑树根节点*/ struct rb_root mytree = RB_ROOT;/*根据key来查找节点*/struct mytype *my_search(struct rb_root *root, int new) { struct rb_node *node = root->rb_node; while (node) { struct mytype *data = container_of(node, struct mytype, node); if (data->key > new) node = node->rb_left; else if (data->key rb_right; else return data; } return NULL; }/*插入一个元素到红黑树中*/ int my_insert(struct rb_root *root, struct mytype *data) { struct rb_node **new = &(root->rb_node), *parent=NULL; /* 寻找可以添加新节点的地方 */ while (*new) { struct mytype *this = container_of(*new, struct mytype, node); parent = *new; if (this->key > data->key) new = &((*new)->rb_left); else if (this->key key) { new = &((*new)->rb_right); } else return -1; } /* 添加一个新节点 */ rb_link_node(&data->node, parent, new); rb_insert_color(&data->node, root); return 0; }static int __init my_init(void){ int i; struct mytype *data; struct rb_node *node; /*插入元素*/ for (i =0; i key = i; my_insert(&mytree, data); } /*遍历红黑树,打印所有节点的key值*/ for (node = rb_first(&mytree); node; node = rb_next(node)) printk("key=%dn", rb_entry(node, struct mytype, node)->key); return 0;}static void __exit my_exit(void){ struct mytype *data; struct rb_node *node; for (node = rb_first(&mytree); node; node = rb_next(node)) { data = rb_entry(node, struct mytype, node); if (data) { rb_erase(&data->node, &mytree); kfree(data); } }}module_init(my_init);module_exit(my_exit);
mytree是红黑树的根节点,my_insert()实现插入一个元素到红黑树中,my_search()根据key来查找节点。内核大量使用红黑树,如虚拟地址空间VMA的管理。
无锁环形缓冲区
生产者和消费者模型是计算机编程中最常见的一种模型。生产者产生数据,而消费者消耗数据,如一个网络设备,硬件设备接收网络包,然后应用程序读取网络包。环形缓冲区是实现生产者和消费者模型的经典算法。环形缓冲区通常有一个读指针和一个写指针。读指针指向环形缓冲区中可读的数据,写指针指向环形缓冲区可写的数据。通过移动读指针和写指针实现缓冲区数据的读取和写入。
在Linux内核中,KFIFO是采用无锁环形缓冲区的实现。FIFO的全称是“First In First Out”,即先进先出的数据结构,它采用环形缓冲区的方法来实现,并提供一个无边界的字节流服务。采用环形缓冲区的好处是,当一个数据元素被消耗之后,其余数据元素不需要移动其存储位置,从而减少复制,提高效率。
(1)创建KFIFO
在使用KFIFO之前需要进行初始化,这里有静态初始化和动态初始化两种方式。
int kfifo_alloc(fifo, size, gfp_mask)
该函数创建并分配一个大小为size的KFIFO环形缓冲区。第一个参数fifo是指向该环形缓冲区的struct kfifo数据结构;第二个参数size是指定缓冲区元素的数量;第三个参数gfp_mask表示分配KFIFO元素使用的分配掩码。
静态分配可以使用如下的宏。
#define DEFINE_KFIFO(fifo, type, size)#define INIT_KFIFO(fifo)
(2)入列
把数据写入KFIFO环形缓冲区可以使用kfifo_in()函数接口。
int kfifo_in(fifo, buf, n)
该函数把buf指针指向的n个数据复制到KFIFO环形缓冲区中。第一个参数fifo指的是KFIFO环形缓冲区;第二个参数buf指向要复制的数据的buffer;第三个数据是要复制数据元素的数量。
(3)出列
从KFIFO环形缓冲区中列出或者摘取数据可以使用kfifo_out()函数接口。
#define kfifo_out(fifo, buf, n)
该函数是从fifo指向的环形缓冲区中复制n个数据元素到buf指向的缓冲区中。如果KFIFO环形缓冲区的数据元素小于n个,那么复制出去的数据元素小于n个。
(4)获取缓冲区大小
KFIFO提供了几个接口函数来查询环形缓冲区的状态。
#define kfifo_size(fifo)#define kfifo_len(fifo)#define kfifo_is_empty(fifo)#define kfifo_is_full(fifo)
kfifo_size()用来获取环形缓冲区的大小,也就是最大可以容纳多少个数据元素。kfifo_len()用来获取当前环形缓冲区中有多少个有效数据元素。kfifo_is_empty()判断环形缓冲区是否为空。kfifo_is_full()判断环形缓冲区是否为满。
(5)与用户空间数据交互
KFIFO还封装了两个函数与用户空间数据交互。
#define kfifo_from_user(fifo, from, len, copied)#define kfifo_to_user(fifo, to, len, copied)
kfifo_from_user()是把from指向的用户空间的len个数据元素复制到KFIFO中,最后一个参数copied表示成功复制了几个数据元素。
kfifo_to_user()则相反,把KFIFO的数据元素复制到用户空间。这两个宏结合了copy_to_user()、copy_from_user()以及KFIFO的机制,给驱动开发者提供了方便。
以上就是Linux内核中常用的数据结构和算法的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/110378.html
 微信扫一扫
 支付宝扫一扫