Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
Spark:在分区写入前从 Bean 中移除列_创想鸟

Spark:在分区写入前从 Bean 中移除列

spark:在分区写入前从 bean 中移除列

本文档介绍了在使用 Spark 将 Bean 对象写入分区时,如何根据不同的分区策略动态移除不需要的列。通过在写入之前使用 select 方法,可以灵活地选择需要写入的列,从而避免因数据格式不匹配导致的问题,并简化代码维护。

在 Spark 中,当我们使用 Bean 对象创建 Dataset 并进行分区写入时,可能会遇到一些问题,特别是在需要根据不同的条件动态选择分区列的情况下。例如,当某个分区列被禁用时,Bean 对象中对应的字段可能为空,导致写入时出现数据格式不匹配的错误。

解决这类问题的一个有效方法是在写入 Dataset 之前,使用 select 方法显式地选择需要写入的列。这样,我们可以根据当前的分区策略,动态地选择 Bean 对象中的字段,从而避免写入不需要的列。

以下是一个示例,展示了如何使用 select 方法来移除不需要的列:

假设我们有一个 PersonBean 类,包含 City、Bday 和 MetadataJson 三个字段。我们希望根据 City 和 Bday 进行分区写入,但有时可能只需要根据 Bday 进行分区。

import org.apache.spark.api.java.JavaRDD;import org.apache.spark.api.java.JavaSparkContext;import org.apache.spark.sql.Dataset;import org.apache.spark.sql.Encoders;import org.apache.spark.sql.Row;import org.apache.spark.sql.SparkSession;import org.apache.spark.sql.SaveMode;import java.util.Arrays;import java.util.List;public class PartitionedWrite {    public static void main(String[] args) {        SparkSession spark = SparkSession.builder()                .appName("PartitionedWrite")                .master("local[*]") // Use local mode for testing                .getOrCreate();        JavaSparkContext jsc = new JavaSparkContext(spark.sparkContext());        // Sample data        List dataList = Arrays.asList(                new PersonBean("New York", "1990-01-01", "{"key1": "value1"}"),                new PersonBean("Los Angeles", "1992-05-10", "{"key2": "value2"}"),                new PersonBean("", "1988-12-25", "{"key3": "value3"}")        );        JavaRDD rowsrdd = jsc.parallelize(dataList);        Dataset beanDataset = spark.createDataset(rowsrdd.rdd(), Encoders.bean(PersonBean.class));        // Define partition columns based on configuration        String[] partitionColumns = new String[]{"Bday"}; // Example: Only partition by Bday        // Select columns before writing        Dataset selectedDataset;        if (partitionColumns.length > 0 && Arrays.asList(partitionColumns).contains("City")) {            selectedDataset = beanDataset.select("City", "Bday", "MetadataJson");        } else {            selectedDataset = beanDataset.select("Bday", "MetadataJson");        }        // Write the dataset        selectedDataset.write()                .partitionBy(partitionColumns)                .mode(SaveMode.Append)                .option("escape", "")                .option("quote", "")                .format("text")                .save("outputpath");        spark.close();    }    public static class PersonBean {        private String City;        private String Bday;        private String MetadataJson;        public PersonBean() {}        public PersonBean(String city, String bday, String metadataJson) {            City = city;            Bday = bday;            MetadataJson = metadataJson;        }        public String getCity() {            return City;        }        public void setCity(String city) {            City = city;        }        public String getBday() {            return Bday;        }        public void setBday(String bday) {            Bday = bday;        }        public String getMetadataJson() {            return MetadataJson;        }        public void setMetadataJson(String metadataJson) {            MetadataJson = metadataJson;        }    }}

在这个例子中,我们首先创建了一个 PersonBean 的 Dataset。然后,我们根据 partitionColumns 的配置,使用 select 方法选择了需要写入的列。如果 partitionColumns 包含 “City”,则选择 “City”、”Bday” 和 “MetadataJson” 三列;否则,只选择 “Bday” 和 “MetadataJson” 两列。最后,我们将选择后的 Dataset 写入到指定路径。

注意事项:

在使用 select 方法时,需要确保选择的列名与 Bean 对象中的字段名一致。可以根据实际需求,灵活地调整 select 方法中的列名列表。使用此方法可以有效地避免因数据格式不匹配导致的错误,并简化代码维护。

总结:

通过在写入 Dataset 之前使用 select 方法,我们可以动态地选择需要写入的列,从而实现灵活的分区写入策略。这种方法不仅可以避免因数据格式不匹配导致的错误,还可以简化代码维护,提高代码的可读性和可维护性。在实际应用中,可以根据具体的需求,灵活地调整 select 方法中的列名列表,以满足不同的分区策略。

以上就是Spark:在分区写入前从 Bean 中移除列的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/111264.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
怎么用豆包AI生成Shell脚本代码 快速编写Shell脚本的豆包AI教程
上一篇 2025年11月23日 13:50:35
Sublime怎么设置主题?5步教你更换个性化主题界面
下一篇 2025年11月23日 13:53:38

相关推荐

  • DeepSeek R1T2— TNG推出的改进型AI语言模型,基于DeepSeek

    DeepSeek R1T2— TNG推出的改进型AI语言模型,基于DeepSeekDeepSeek R1T2— TNG推出的改进型AI语言模型,基于DeepSeekDeepSeek R1T2— TNG推出的改进型AI语言模型,基于DeepSeekDeepSeek R1T2— TNG推出的改进型AI语言模型,基于DeepSeek

    deepseek r1t2 是 tng 在 deepseek 原始模型基础上开发的增强型语言模型。该模型采用 tri-mind 架构,融合了 deepseek r1-0528、r1 和 v3-0324 三个基础模型的优势,通过 assembly of experts(aoe)技术整合推理能力、结构化…

    2026年9月24日 • 用户投稿
    900
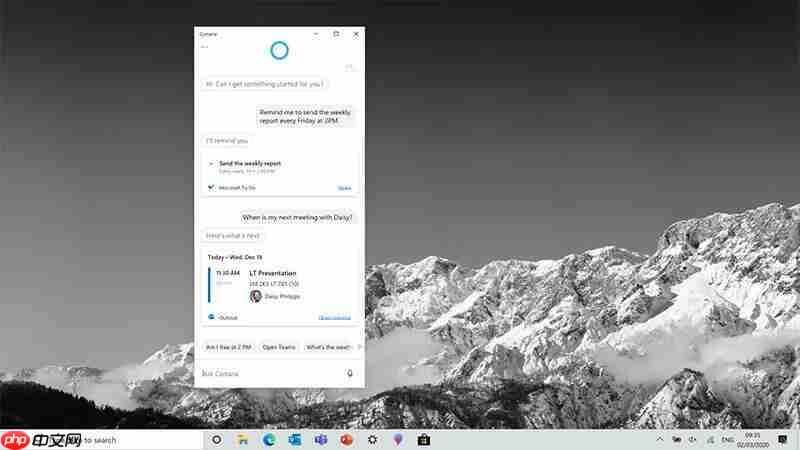
  • 微软终止Cortana支持:Windows 10迎来重大调整

    微软终止Cortana支持:Windows 10迎来重大调整微软终止Cortana支持:Windows 10迎来重大调整微软终止Cortana支持:Windows 10迎来重大调整微软终止Cortana支持:Windows 10迎来重大调整

    N软网消息,微软近日宣布,将在Windows 10系统中停止对Cortana的支持。这是继Windows 11中取消Cortana支持之后的进一步动作,微软正将重心转移到Windows Copilot、Microsoft 365 Copilot以及Bing Chat等新技术上。 曾有人预计,微软会在…

    2026年9月24日 • 用户投稿
    100
  • 2025年比较好用的生成图片AI工具前十推荐

    2025年比较好用的生成图片AI工具前十推荐2025年比较好用的生成图片AI工具前十推荐2025年比较好用的生成图片AI工具前十推荐2025年比较好用的生成图片AI工具前十推荐

    2025年AI图片生成工具将更加智能、精准且深度融入创作流程,具备超写实生成、多模态输入、实时交互和3D建模能力,代表工具包括Midjourney、Stable Diffusion、DALL-E 4、Adobe Firefly Max等,未来将朝个性化、多模态融合与实时协作发展,同时面临版权、伦理、…

    2026年9月24日 • 用户投稿
    100
  • 如何通过BIOS设置优化游戏性能与系统稳定性?

    如何通过BIOS设置优化游戏性能与系统稳定性?如何通过BIOS设置优化游戏性能与系统稳定性?如何通过BIOS设置优化游戏性能与系统稳定性?如何通过BIOS设置优化游戏性能与系统稳定性?

    启用XMP/DOCP可显著提升游戏帧数与系统响应,通过让内存运行于标称高频低时序,改善最低帧稳定性;正确设置需在BIOS中开启对应配置文件,并进行稳定性测试以确保兼容性。 BIOS设置是优化游戏性能和系统稳定性的一个关键但常被忽视的环节。通过细致调整内存频率、CPU电源管理模式,甚至是集成显卡分配,…

    2026年9月24日 • 用户投稿
    200
  • AI模型评测有哪些_好用的AI模型评测大全

    AI模型评测有哪些_好用的AI模型评测大全AI模型评测有哪些_好用的AI模型评测大全AI模型评测有哪些_好用的AI模型评测大全AI模型评测有哪些_好用的AI模型评测大全

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ MMLU:大规模多任务语言理解基准 Open LLM Leaderboard:Hugging Face推出的开源大模型排行榜单 C-Eval:一个全面的中文基础模型评估套件 FlagEval:智…

    2026年9月24日 • 用户投稿
    100
  • Debian环境下MongoDB如何进行性能调优

    在debian环境下进行mongodb性能调优,可以参考以下步骤和建议: 硬件和配置优化 选择合适的硬件:根据应用需求选择合适的CPU、内存和存储设备。配置内存:确保MongoDB有足够的内存来缓存数据和索引,减少磁盘I/O。使用SSD:SSD硬盘比传统硬盘提供更快的读写速度,显著提升数据库性能。 …

    2026年9月24日
    000
  • safari浏览器标签页图标(favicon)不显示怎么办_safari浏览器标签页图标不显示解决方法

    首先清除Safari缓存和网站数据,检查图像加载设置是否开启,刷新页面或重访网站,必要时重置浏览器设置,并确认系统显示设置未禁用相关视觉效果。 如果您在使用 Safari 浏览器时发现网页标签页的图标(favicon)未能正常显示,可能是由于缓存异常、网站资源加载问题或浏览器设置限制所致。以下是解决…

    2026年9月24日
    000
  • 安装系统时,如何手动加载第三方 SATA 或 NVMe 硬盘驱动?

    安装系统时,如何手动加载第三方 SATA 或 NVMe 硬盘驱动?安装系统时,如何手动加载第三方 SATA 或 NVMe 硬盘驱动?安装系统时,如何手动加载第三方 SATA 或 NVMe 硬盘驱动?安装系统时,如何手动加载第三方 SATA 或 NVMe 硬盘驱动?

    安装系统时若第三方SATA或NVMe硬盘不被识别,需在安装界面通过“加载驱动程序”选项手动导入厂商提供的.inf等驱动文件,确保USB驱动器格式为FAT32并存放解压后的正确版本驱动,进入BIOS确认SATA模式(如RAID/AHCI)与驱动匹配,且硬件连接正常。 安装系统时,如果遇到第三方 SAT…

    2026年9月24日 • 用户投稿
    100
  • sublime怎么配置eslint_sublime ESLint插件配置教程

    sublime怎么配置eslint_sublime ESLint插件配置教程sublime怎么配置eslint_sublime ESLint插件配置教程sublime怎么配置eslint_sublime ESLint插件配置教程sublime怎么配置eslint_sublime ESLint插件配置教程

    首先安装Node.js和ESLint,通过npm全局或项目内安装并初始化配置;接着在Sublime Text中使用Package Control安装SublimeLinter及SublimeLinter-eslint插件;然后根据需要在设置中配置ESLint可执行文件路径;再添加”&#8…

    2026年9月24日 • 用户投稿
    100
  • Java双向链表:实现高效的按索引删除节点操作

    Java双向链表:实现高效的按索引删除节点操作Java双向链表:实现高效的按索引删除节点操作Java双向链表:实现高效的按索引删除节点操作Java双向链表:实现高效的按索引删除节点操作

    本文详细讲解了如何在Java中为双向链表实现按索引删除节点的操作。教程涵盖了泛型设计、节点结构、参数校验、以及针对头节点、尾节点和中间节点的删除逻辑,并强调了维护链表head、tail和size等状态的准确性,确保了删除操作的健壮性和正确性。 1. 双向链表节点与泛型设计 在实现双向链表时,为了提高…

    2026年9月24日 • 用户投稿
    100
  • CPU的制程工艺从5nm迈向3nm,实际性能提升与价格涨幅是否成正比?

    CPU的制程工艺从5nm迈向3nm,实际性能提升与价格涨幅是否成正比?CPU的制程工艺从5nm迈向3nm,实际性能提升与价格涨幅是否成正比?CPU的制程工艺从5nm迈向3nm,实际性能提升与价格涨幅是否成正比?CPU的制程工艺从5nm迈向3nm,实际性能提升与价格涨幅是否成正比?

    3nm相比5nm性能提升有限但成本激增,晶体管密度增70%、CPU性能提15%-25%、能效与AI算力改善明显,而台积电3nm代工涨价20%、设备研发成本飙升,高通获16%优惠涨幅、联发科承24%溢价,AI芯片商支撑高价,手机厂难转嫁成本,摩尔定律性价比红利消失。 芯片制程从5nm到3nm,性能提升…

    2026年9月24日 • 用户投稿
    000
  • Java中实现跨类和函数共享变量的策略

    Java中实现跨类和函数共享变量的策略Java中实现跨类和函数共享变量的策略Java中实现跨类和函数共享变量的策略Java中实现跨类和函数共享变量的策略

    本文深入探讨了在Java中实现跨类和函数共享变量的有效策略。通过利用public static关键字,可以在不创建对象实例的情况下,使变量在整个应用程序中具备全局可访问性。文章将通过示例代码演示其使用方法,并提供关于此模式的注意事项与最佳实践,以帮助开发者理解其优势和潜在风险。 核心概念:publi…

    2026年9月24日 • 用户投稿
    000
  • sublime怎么设置代码片段(snippet)的触发词 _sublime snippet触发词设置

    sublime怎么设置代码片段(snippet)的触发词 _sublime snippet触发词设置sublime怎么设置代码片段(snippet)的触发词 _sublime snippet触发词设置sublime怎么设置代码片段(snippet)的触发词 _sublime snippet触发词设置sublime怎么设置代码片段(snippet)的触发词 _sublime snippet触发词设置

    在Sublime Text中设置代码片段触发词需编辑tabTrigger标签,2. 创建新片段并配置content、tabTrigger、scope等字段,3. 将文件保存为Packages/User/下的.sublime-snippet格式,4. 在对应语言文件中输入触发词后按Tab键即可展开。 …

    2026年9月24日 • 用户投稿
    100
  • windows磁盘占用100%怎么解决_磁盘占用率过高问题优化方案

    windows磁盘占用100%怎么解决_磁盘占用率过高问题优化方案windows磁盘占用100%怎么解决_磁盘占用率过高问题优化方案windows磁盘占用100%怎么解决_磁盘占用率过高问题优化方案windows磁盘占用100%怎么解决_磁盘占用率过高问题优化方案

    首先检查高占用进程并结束非关键任务,再禁用Superfetch和Windows Search等系统服务以降低磁盘负载,接着调整电源计划为高性能模式并启用硬盘写入缓存,随后运行sfc /scannow和chkdsk修复系统文件与磁盘错误,清理磁盘空间并针对HDD进行碎片整理或确保SSD的TRIM功能开…

    2026年9月24日 • 用户投稿
    100
  • Kimi Chat讲睡前故事:如何定制宝宝最喜欢的童话?

    Kimi Chat讲睡前故事:如何定制宝宝最喜欢的童话?Kimi Chat讲睡前故事:如何定制宝宝最喜欢的童话?Kimi Chat讲睡前故事:如何定制宝宝最喜欢的童话?Kimi Chat讲睡前故事:如何定制宝宝最喜欢的童话?

    kimi chat 可以通过定制化成为宝宝专属的睡前故事讲述者。首先,提供详细信息,包括喜欢的角色、场景和情节,使用直接描述、示例和互动提问帮助 kimi chat 理解宝宝喜好;其次,通过加入声音效果、比喻拟人、创造悬念和互动式讲述让故事更生动有趣;同时,明确限制内容、过滤关键词并人工审核避免不合…

    2026年9月24日 • 用户投稿
    000
  • Java 双向链表指定索引节点删除深度解析

    Java 双向链表指定索引节点删除深度解析Java 双向链表指定索引节点删除深度解析Java 双向链表指定索引节点删除深度解析Java 双向链表指定索引节点删除深度解析

    本文深入探讨了在 Java 中实现双向链表指定索引节点删除的完整过程。我们将详细讲解如何处理泛型化、头尾指针维护、链表大小更新以及各种边界条件(如删除头节点、尾节点、中间节点或唯一节点)的逻辑,并提供一个健壮的实现示例。 1. 双向链表基础与泛型化 双向链表是一种数据结构,其中每个节点不仅包含数据,…

    2026年9月24日 • 用户投稿
    000
  • Ubuntu挂载时遇到文件系统不支持怎么办

    当在ubuntu中挂载硬盘时遇到文件系统不支持的问题,通常是由于以下几个原因造成的: 分区方案不正确:例如,使用MBR分区方案时,最大支持2TB的硬盘,超过这个大小的硬盘需要使用GPT分区方案。文件系统格式不支持:Ubuntu可能不支持某些特殊的文件系统格式。内核模块缺失:某些文件系统可能需要特定的…

    2026年9月24日
    100
  • 在Spring Boot中利用注解实现字符串到枚举的灵活转换

    在Spring Boot中利用注解实现字符串到枚举的灵活转换在Spring Boot中利用注解实现字符串到枚举的灵活转换在Spring Boot中利用注解实现字符串到枚举的灵活转换在Spring Boot中利用注解实现字符串到枚举的灵活转换

    本文详细介绍了在Spring Boot应用中,如何通过自定义Jackson反序列化器并结合@JsonDeserialize注解,实现请求体中字符串类型数据向枚举(Enum)对象的自动转换。该方法尤其适用于处理大小写不敏感的字符串输入,确保数据模型与业务逻辑的健壮性与灵活性。 背景与问题描述 在spr…

    2026年9月24日 • 用户投稿
    600
  • Chrome浏览器怎么卸载不需要的扩展_Chrome浏览器扩展程序卸载与管理方法

    Chrome浏览器怎么卸载不需要的扩展_Chrome浏览器扩展程序卸载与管理方法Chrome浏览器怎么卸载不需要的扩展_Chrome浏览器扩展程序卸载与管理方法Chrome浏览器怎么卸载不需要的扩展_Chrome浏览器扩展程序卸载与管理方法Chrome浏览器怎么卸载不需要的扩展_Chrome浏览器扩展程序卸载与管理方法

    首先打开Chrome浏览器,通过点击右上角三点图标进入“更多工具-扩展程序”页面,或直接在地址栏输入chrome://extensions快速访问;找到目标扩展后点击“移除”按钮即可卸载;若仅需临时停用,可点击扩展右侧开关将其关闭,灰色状态表示已禁用;对于多个扩展,建议定期进入管理页面批量清理不常用…

    2026年9月24日 • 用户投稿
    000
  • AI工具如何整合Notion/ChatGPT打造智能工作流

    AI工具如何整合Notion/ChatGPT打造智能工作流AI工具如何整合Notion/ChatGPT打造智能工作流AI工具如何整合Notion/ChatGPT打造智能工作流AI工具如何整合Notion/ChatGPT打造智能工作流

    notion与chatgpt结合能解决信息过载、内容创作效率低和重复任务自动化三大核心痛点。1)chatgpt可快速摘要冗长文本,将提炼后的精华导入notion形成结构化知识条目;2)chatgpt生成初稿作为内容起点,提升写作效率,再通过notion组织成流程化内容日历;3)ai动态填充模板,实现…

    2026年9月24日 • 用户投稿
    300

发表回复

登录后才能评论
关注微信