Celery、Redis和Django配合使用,提高异步任务处理效率

celery、redis和django配合使用,提高异步任务处理效率

Celery、Redis和Django配合使用,提高异步任务处理效率

引言:在开发Web应用过程中,经常会遇到需要处理一些耗时的任务。如果这些任务直接在请求的处理流程中执行,会导致用户等待时间过长,对用户体验极为不友好。为了解决这一问题,我们可以使用Celery、Redis和Django配合使用,将耗时的任务异步处理,提高系统的性能和用户体验。

Celery介绍和安装
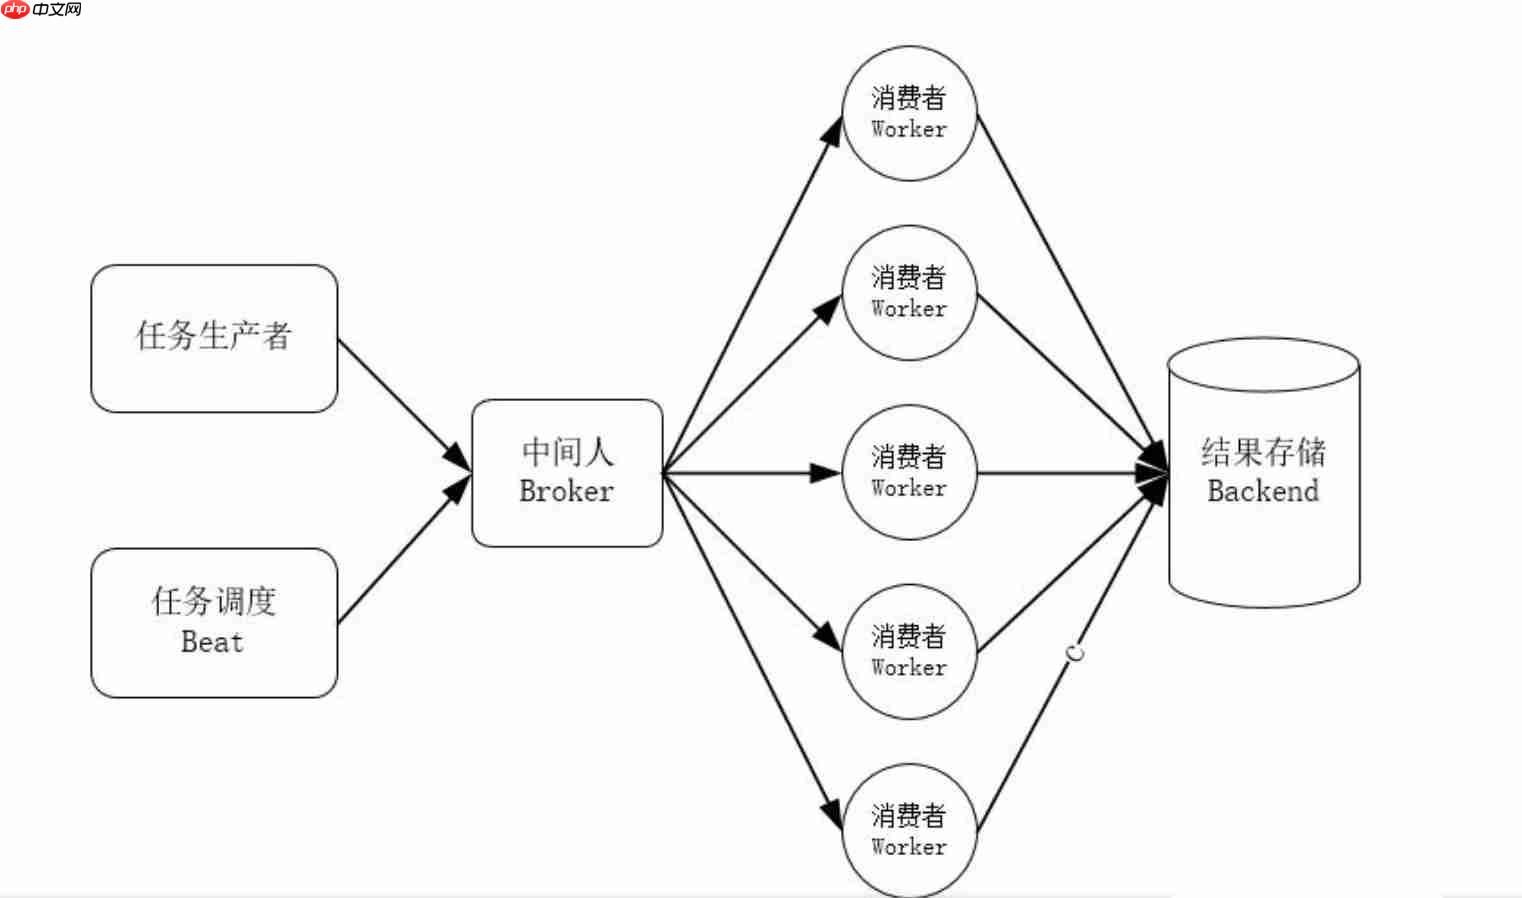
Celery是一个任务队列,它基于分布式消息传递进行工作,同时也支持任务调度。安装Celery可以通过pip命令来完成:

pip install celery

Redis介绍和安装
Redis是一个开源的内存数据库,它支持多种数据结构和广泛的应用场景。在我们的方案中,Redis主要用作任务队列的后端存储实现。安装Redis可以通过以下步骤来完成:下载Redis并解压缩进入解压后的目录,使用make命令进行编译使用make install命令进行安装

Django配置
首先需要在Django项目的settings.py文件中添加Celery的配置项,如下所示:

# settings.py# Celery配置CELERY_BROKER_URL = 'redis://localhost:6379/0'CELERY_RESULT_BACKEND = 'redis://localhost:6379/0'CELERY_ACCEPT_CONTENT = ['json']CELERY_TASK_SERIALIZER = 'json'CELERY_RESULT_SERIALIZER = 'json'

上述配置中,CELERY_BROKER_URLCELERY_RESULT_BACKEND指定了Redis的地址和端口,用来作为任务队列和结果存储的后端。

接下来,在项目的urls.py文件中添加Celery的配置,如下所示:

# urls.pyfrom django.urls import pathfrom .views import AsyncTaskViewurlpatterns = [    path('async-task/', AsyncTaskView.as_view(), name='async_task'),]

创建任务函数
在Django的app中创建tasks.py文件,并在其中定义异步任务的函数。下面是一个示例代码:

# app/tasks.pyfrom celery import shared_taskimport time@shared_taskdef process_task(): # 模拟任务处理过程(等待5秒) time.sleep(5) return 'Task completed'

在上述代码中,@shared_task装饰器用于将函数转换为Celery的任务函数。

视图实现
在Django的views.py文件中定义一个视图类,用于接收请求并调用异步任务函数。下面是一个示例代码:

# app/views.pyfrom django.views import Viewfrom .tasks import process_taskfrom django.http import HttpResponseclass AsyncTaskView(View): def get(self, request):     # 调用异步任务     task = process_task.delay()     return HttpResponse('Task started')

启动Celery服务
使用以下命令来启动Celery的工作进程:

celery -A your_project_name worker --loglevel=info

注意将your_project_name替换为你的Django项目名称。

测试
在浏览器中访问http://localhost:8000/async-task/,如果一切正常,你将会看到返回结果为’Task started’。此时任务已经在后台异步处理,并且不会阻塞用户的请求处理。

结论:通过使用Celery、Redis和Django的组合方案,我们可以将耗时的任务异步处理,提高了系统的性能和用户体验。使用Celery可以轻松地管理任务队列和任务调度,而Redis作为后端存储则实现了任务数据的可靠存储。这种方案可以广泛应用于Web应用开发中,并通过具体代码示例演示了其实现过程。

以上就是Celery、Redis和Django配合使用,提高异步任务处理效率的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1343353.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
如何用Python for NLP提取文本PDF文件中的元数据?
上一篇 2025年12月13日 06:23:11
Python for NLP:如何从PDF文件中识别和处理表格数据?
下一篇 2025年12月13日 06:23:23

相关推荐

  • MySQL和Redis数据一致性:延迟双删与先改库再删缓存,哪种方案更优?

    MySQL和Redis数据一致性:如何选择延迟双删或先改库再删缓存? 在使用MySQL和Redis构建应用时,数据一致性至关重要。本文将对比分析两种常用的数据一致性方案:延迟双删和先修改数据库再删除缓存,并探讨其适用场景。 延迟双删策略 延迟双删是指先更新数据库,然后异步删除缓存。这种方法允许短暂的…

    2026年9月4日
    000
  • ​​无法定位程序输入点于动态链接库?错误修复指南​​

    重新安装或修复出错程序,确保安装完整且无残留;2. 运行sfc++ /scannow和dism命令修复系统文件,必要时手动替换受损dll;3. 更新或重装microsoft visual c++ redistributable和.net framework等运行库;4. 更新驱动程序和系统补丁,确保…

    2026年9月4日
    400
  • LLM自主发现发表在Nature上的科学假设?ICLR 2025 论文MOOSE-Chem深度解析

    LLM自主发现发表在Nature上的科学假设?ICLR 2025 论文MOOSE-Chem深度解析LLM自主发现发表在Nature上的科学假设?ICLR 2025 论文MOOSE-Chem深度解析LLM自主发现发表在Nature上的科学假设?ICLR 2025 论文MOOSE-Chem深度解析LLM自主发现发表在Nature上的科学假设?ICLR 2025 论文MOOSE-Chem深度解析

    人工智能的下一个前沿:引领科学发现 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 编辑 | ScienceAI 人工智能(AI)在自然语言处理和计算机视觉领域的成功有目共睹,但它能否推动科学理论的突破性发现? ICLR 2025 接收论文《…

    2026年9月4日 用户投稿
    100
  • 告别缓慢的GraphQL查询:使用Graphpinator Persisted Queries提升性能

    最近,我负责维护一个使用graphql的api,随着用户数量的增加,api的响应速度逐渐变慢。分析后发现,许多用户都在重复发送相同的查询,导致服务器在解析和验证这些查询上浪费了大量资源。虽然我的解析器函数本身效率很高,但graphql本身的解析和验证过程却成为了瓶颈。为了解决这个问题,我尝试了多种方…

    用户投稿 2026年9月4日
    100
  • 如何在Java中实现对象缓存机制

    答案:Java对象缓存通过减少重复创建和远程调用提升性能,常用HashMap或ConcurrentHashMap实现简单缓存,结合TTL和LRU策略控制内存,推荐使用Guava Cache或Caffeine进行高级管理,并在分布式环境下采用Redis集成,配合Spring Cache注解简化开发,核…

    2026年9月4日
    100
  • Celery实现定时任务crontab

    Celery实现定时任务crontabCelery实现定时任务crontabCelery实现定时任务crontabCelery实现定时任务crontab

    定时任务在开发中应用广泛,几乎所有开发人员都会接触到。实现定时任务的方法有很多,其中celery的定时任务功能强大且使用简便,只需安装celery即可。以下是使用celery实现定时任务的详细步骤。 一. 搭建Celery定时任务架构 在项目中合适的位置新建一个定时任务目录 celery_cront…

    2026年9月4日 用户投稿
    200
  • 16G内存8核16线程的计算机,其单接口并发量如何估算?

    评估单机并发处理能力 设计分布式系统时,准确评估单机并发处理能力至关重要,这直接关系到系统资源配置和微服务性能优化。本文探讨一台配置为16G内存、8核16线程的计算机的并发处理能力,目标是在平均响应时间500毫秒的条件下,估算其单接口并发量。 影响并发量的关键因素 准确计算并发量并非易事,它取决于多…

    2026年9月3日
    100
  • Java微服务学习遇到瓶颈?有哪些深入学习资源推荐?

    进阶Java微服务学习资源推荐 精通Spring全家桶、Redis、MQ、ES等技术后,仍感觉Java微服务学习遇到瓶颈?别担心,这份资源清单将助您突破瓶颈,更上一层楼。 推荐学习资源: Pdai.Tech 立即学习“Java免费学习笔记(深入)”; Pdai.Tech是一个专注于Java微服务、分…

    2026年9月3日
    300
  • Java开发者如何系统学习微服务及其相关技术?

    Java开发者微服务学习路径:高效掌握关键技术 对于Java开发人员而言,系统学习微服务架构至关重要。然而,网络上的学习资源往往零散且缺乏系统性,导致学习效率低下。本指南推荐一篇高质量的中文技术文章,帮助您构建完整的微服务学习体系。 此文章内容全面,涵盖Spring、Spring MVC、Sprin…

    2026年9月3日
    100
  • PHP中利用file_get_contents高效处理动态多URL请求的教程

    本文详细阐述了在PHP中如何正确且高效地使用file_get_contents函数,结合数据库查询结果,循环访问并处理多个动态生成的URL。文章分析了常见的循环嵌套错误,并提供了优化的代码示例,旨在帮助开发者避免逻辑陷阱,确保每个URL都能被准确无误地请求,从而实现数据抓取或外部服务调用的预期效果。…

    2026年9月3日
    200
  • Win10系统下使用Django2.0.4+Celery4.4.2+Redis来实现异步任务队列以及定时(周期)任务(2020年最新攻略)

    Win10系统下使用Django2.0.4+Celery4.4.2+Redis来实现异步任务队列以及定时(周期)任务(2020年最新攻略)Win10系统下使用Django2.0.4+Celery4.4.2+Redis来实现异步任务队列以及定时(周期)任务(2020年最新攻略)Win10系统下使用Django2.0.4+Celery4.4.2+Redis来实现异步任务队列以及定时(周期)任务(2020年最新攻略)Win10系统下使用Django2.0.4+Celery4.4.2+Redis来实现异步任务队列以及定时(周期)任务(2020年最新攻略)

    首先要明确的是,celery 4.1+版本的官方文档已经详细说明了,在该版本之后,无需再引入依赖于django-celery库,直接使用celery本身即可。在去年年初的一篇文章中提到的python 3.7.2和django 2.0.4使用django-celery时遇到的一些问题,现今已不存在。技…

    2026年9月3日 用户投稿
    100
  • 告别低效:使用 Enqueue/Messenger Adapter 提升消息队列处理效率

    我们的 symfony 应用原本使用的是一个自定义的消息队列系统,性能表现却差强人意。随着用户数量的增长,消息积压问题日益严重,导致系统响应速度缓慢,用户体验极差。我们尝试了多种优化方案,但收效甚微。瓶颈主要在于消息的生产和消费效率。这时,我开始寻找更专业的消息队列解决方案,并最终选择了 enque…

    用户投稿 2026年9月3日
    100
  • 找不到ucrtbased.dll怎么办 总结4个修复方法

    找不到ucrtbased.dll怎么办 总结4个修复方法找不到ucrtbased.dll怎么办 总结4个修复方法找不到ucrtbased.dll怎么办 总结4个修复方法找不到ucrtbased.dll怎么办 总结4个修复方法

    使用#%#$#%@%@%$#%$#%#%#$%@_e855972ea937e3ffc++6bd147da9a030da时,你可能会碰到“缺少ucrtbased.dll文件,无法继续执行代码”的提示。这个dll文件属于microsoft visual c++运行库的调试组件,常见于开发环境。若系统未安…

    2026年9月3日 用户投稿
    200
  • 如何高效持久化多个客户端连续上传的坐标轨迹数据?

    应对海量坐标轨迹数据持久化挑战 本文探讨如何高效持久化多个客户端连续上传的坐标轨迹数据,并提供两种方案以应对不同场景的需求。 方案一:字符串拼接法(适用于轨迹较短的场景) 此方案将每秒接收到的坐标数据拼接成一个字符串,然后存储到数据库。 然而,该方法存在潜在风险:如果轨迹过长,字符串长度可能超过数据…

    2026年9月3日
    100
  • 使用 Composer 解决缓存管理难题:Theriskus/Cache 库的应用

    可以通过以下地址学习 composer:学习地址 在开发过程中,缓存是提升网站性能的重要手段。然而,选择合适的缓存系统并正确配置它们常常是一个挑战。Theriskus/Cache 库为此提供了一个简洁而强大的解决方案,支持多种缓存驱动,包括 Redis、Memcached 和文件系统缓存。让我们来看…

    用户投稿 2026年9月2日
    500
  • 如何确保多次请求的设备坐标数据在数据库中持久存储?

    高效存储设备轨迹数据:数据库持久化策略 在处理频繁的设备坐标数据请求时,如何确保数据完整且高效地存储到数据库中至关重要。本文将探讨两种策略,并分析其适用场景。 两种存储方案对比 字符串拼接法: 将每次请求的坐标数据拼接成一个字符串,达到一定长度后写入数据库。这种方法简单易懂,但对于高频数据请求,拼接…

    2026年9月2日
    500
  • Swoole怎么在不重启服务的情况下更新配置

    答案:Swoole通过信号机制、配置中心定时检查、管理接口触发实现配置热加载,需注意多进程同步与性能优化。 在使用 Swoole 时,想要在不重启服务的情况下更新配置,核心思路是利用进程间通信机制实现配置热加载。Swoole 提供了信号机制和自定义事件,可以结合这些特性动态重载配置。 1. 使用信号…

    2026年9月2日
    300
  • 异步方法无法睡眠及Redis缓存:如何避免线程池阻塞?

    异步任务与Redis缓存:避免线程池阻塞的策略 在使用Redis缓存时,异步方法无法休眠,即使在单线程环境下也无效,这通常是由于线程池管理不当导致的阻塞问题。本文将分析此问题并提供解决方案。 您的异步配置使用了ThreadPoolTaskExecutor,其参数如下: 核心线程数:2最大线程数:10…

    2026年9月2日
    300
  • 多次请求的坐标数据,如何高效持久化到数据库?

    高效处理多次请求的坐标数据并持久化到数据库 如何将多次请求获取的坐标数据高效地持久化到数据库?本文针对这个问题,提供两种方案并进行对比分析。假设需要将多个坐标点拼接成一条轨迹后存储。 方案一:直接字符串拼接 此方案使用 StringBuffer 或类似的字符串构建器,将每次请求接收到的坐标数据拼接成…

    2026年9月2日
    100
  • ThreadLocal存储配置信息不变?如何解决请求上下文数据更新问题?

    ThreadLocal 导致请求上下文数据更新失败 问题: 使用 ThreadLocal 存储配置信息后,即使数据库配置更新,请求仍然获取旧值。 解决方案: 添加日志: 在代码关键位置添加日志,追踪 ThreadLocal 的值变化,确认拦截器是否正确清除数据。 强制清除 ThreadLocal: …

    2026年9月2日
    200

发表回复

登录后才能评论
关注微信