Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
Python如何操作PDF文件?文本提取与生成_创想鸟

Python如何操作PDF文件?文本提取与生成

python操作pdf文件有成熟的解决方案,核心在于选择合适的库。1.文本提取常用pypdf2或pdfminer.six,后者更精细;2.生成pdf推荐reportlab或fpdf,前者功能强,后者简洁;3.处理挑战包括扫描件需ocr、复杂布局需专用库、字体乱码、加密及内存消耗;4.高级处理如合并分割、页面操作、水印添加、表单填写、图片提取等均可实现;5.选库需根据需求,pypdf2适合基础操作,pdfminer.six用于高精度提取,camelot-py/tabula-py针对表格,reportlab生成复杂文档,fpdf生成简单文档,pymupdf适用高性能低级操作。

Python如何操作PDF文件?文本提取与生成

Python操作PDF文件,无论是提取文本内容还是生成新的PDF文档,其实都有成熟的解决方案。核心在于选择合适的库,理解PDF格式的一些特性,然后就能通过代码实现自动化处理。这在数据分析、报告生成、文档管理等领域都非常有用,我个人在处理大量自动化报表时,就经常用到这些技术。说实话,一开始接触PDF操作会觉得有点复杂,但摸清门道后,会发现它能大大提升工作效率。

Python如何操作PDF文件?文本提取与生成

解决方案

要搞定PDF的文本提取和生成,我们通常会用到不同的Python库,因为它们各有侧重。

文本提取:对于从PDF中提取文本,PyPDF2是一个非常常用的选择,它轻量且易于上手。如果你需要更精细的文本提取,比如保留文本的布局信息,甚至是从一些复杂的、多列的PDF中提取,那么pdfminer.six会是更强大的工具

Python如何操作PDF文件?文本提取与生成

举个例子,用PyPDF2提取文本:

立即学习“Python免费学习笔记(深入)”;

from PyPDF2 import PdfReaderdef extract_text_from_pdf(pdf_path):    text = ""    try:        reader = PdfReader(pdf_path)        for page in reader.pages:            text += page.extract_text() or "" # 加上or ""防止extract_text返回None    except Exception as e:        print(f"提取文本时发生错误: {e}")    return text# 使用示例# pdf_file = "your_document.pdf"# extracted_content = extract_text_from_pdf(pdf_file)# print(extracted_content[:500]) # 打印前500字

PDF生成:创建PDF文档则通常会用到ReportLabFPDFReportLab功能非常强大,可以绘制复杂的图形、图表,进行精确的布局控制,适合生成高质量的报告或票据。而FPDF则相对轻量,API设计简洁,更适合快速生成简单的文本或表格PDF。

Python如何操作PDF文件?文本提取与生成

FPDF生成一个简单的PDF:

from fpdf import FPDFdef create_simple_pdf(output_path, content_lines):    pdf = FPDF()    pdf.add_page()    pdf.set_font("Arial", size=12)    for line in content_lines:        pdf.multi_cell(0, 10, line) # multi_cell支持自动换行    pdf.output(output_path)    print(f"PDF已生成到: {output_path}")# 使用示例# lines = [#     "这是一个用Python FPDF库生成的简单PDF文档。",#     "你可以添加多行文本,它们会自动换行。",#     "这对于生成报告、发票等非常方便。",#     "日期: 2023年10月27日"# ]# create_simple_pdf("my_generated_document.pdf", lines)

Python处理PDF文件时,有哪些常见的挑战和陷阱?

处理PDF文件,尤其是在文本提取这块,说实话,坑还是不少的。最常见的问题就是PDF格式的复杂性。它不是纯文本,而是包含了字体、布局、图片等各种元素的“画布”。

一个大挑战是扫描件PDF。这类PDF本质上是图片,不包含可直接提取的文本层。这时候,你需要引入OCR(光学字符识别)技术,比如使用Tesseract配合Python库pytesseract来识别图片中的文字。但这又带来了新的问题:识别准确率,特别是对于手写体或低质量扫描件。

其次是复杂的布局和表格。PDF中的文本可能分散在不同的位置,或者以表格的形式呈现。PyPDF2虽然能提取文本,但往往是按读取顺序,文本的逻辑顺序可能会被打乱,表格数据更是难以直接结构化。这时,pdfminer.six会好一些,因为它尝试理解布局,但对于表格,你可能需要更专业的库,比如camelot-pytabula-py,它们专门用于从PDF中提取表格数据。

字体嵌入也是个问题。如果PDF中使用了不常见的字体,并且没有完全嵌入到PDF文件中,那么在渲染或提取时可能会出现乱码。还有加密的PDF文件,需要密码才能访问,这在操作前必须解决。

最后,内存消耗对于大型PDF文件来说是个潜在的陷阱。有些库在处理大文件时可能会占用大量内存,导致程序崩溃或运行缓慢。这需要我们优化代码,比如分批处理页面,或者选择更高效的库。

除了文本操作,Python还能对PDF进行哪些高级处理?

Python操作PDF远不止文本的提取和生成那么简单,它还能实现很多高级功能,让PDF处理变得非常灵活。

你可以很方便地合并或分割PDF文件。比如,把多个报告合并成一个总览文档,或者把一个大文件按章节分割成多个小文件。PyPDF2就提供了PdfMerger类来做合并,而分割则可以通过遍历页面,然后将选定页面写入新的PDF来实现。

页面操作也是常见的需求,比如旋转页面(当扫描件方向不对时)、删除特定页面、或者重新排序页面。这些功能在PyPDF2中都有很好的支持。

添加水印或盖章是另一个实用功能。你可以在现有PDF的每一页上添加公司Logo、“草稿”字样或者保密水印。这通常涉及到在现有PDF的页面上叠加新的内容层。

更进一步,PDF表单的填写也是一个非常有用的功能。如果你的PDF是可填写的表单,Python库可以帮你自动填充表单字段,这对于批量生成个性化文档(如合同、邀请函)非常高效。

如果你需要处理PDF中的图片,一些库比如PyMuPDF(Fitz)可以帮助你提取PDF中的图片。而对于PDF的元数据(作者、标题、主题等),你也可以用Python来读取和修改。

总的来说,Python的PDF库生态非常丰富,从基础的合并、分割、页面操作,到复杂的表单填写、图片提取,甚至是对PDF进行加密解密,几乎你能想到的PDF操作,都有对应的解决方案。这让PDF的自动化处理成为可能,极大地提升了文档管理的效率。

如何选择合适的Python PDF库来满足不同需求?

选择合适的Python PDF库,关键在于明确你的具体需求。市面上的库不少,各有侧重,没有一个“万能”的。

如果你的任务是简单的PDF合并、分割、页面旋转或者基础的文本提取,那么PyPDF2通常是首选。它轻量、易用,文档也比较完善,对于日常的文档整理工作,它已经足够了。它的缺点是文本提取可能不那么精准,对于复杂布局的PDF效果一般。

对于高精度、布局敏感的文本提取,特别是你需要保留文本的原始位置、字体大小等信息时,pdfminer.six是更好的选择。它能更深入地解析PDF结构,提供更丰富的文本信息。但它的学习曲线比PyPDF2稍陡峭一些。

当你的需求是从PDF中提取表格数据时,常规的文本提取库往往力不从心。这时,camelot-pytabula-py会是你的救星。它们专门针对PDF中的表格进行优化,能更好地识别表格边界和内容。

而如果你需要从零开始生成复杂的PDF文档,包含图表、图片、精确布局,甚至需要生成可打印的专业报告,那么ReportLab是行业标准。它的功能非常强大,但相应地,学习成本和代码量也会更大。对于快速生成简单的PDF,比如只有几段文字、一个简单表格的文档,FPDF则更加轻量和友好,它的API设计直观,上手快。

最后,如果你需要一个功能全面、性能卓越的低级PDF操作库,可以考虑PyMuPDF (Fitz)。它基于C语言的MuPDF库,速度非常快,能进行高级的渲染、图像处理、文本搜索等操作,但它的API可能对初学者来说没那么直观。

我的建议是,先从PyPDF2FPDF开始,它们能满足大部分基础需求。遇到更复杂的问题时,再根据具体痛点去探索pdfminer.sixReportLabcamelot-pyPyMuPDF。多尝试,总能找到最适合你项目的工具。

以上就是Python如何操作PDF文件?文本提取与生成的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1365120.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫

如何使用Python实现基于聚类的实时异常检测?
上一篇 2025年12月14日 04:26:20
TatSu语法中方括号被忽略问题的解决
下一篇 2025年12月14日 04:26:30

相关推荐

  • 为什么GPU显存带宽比容量更重要?

    显存带宽比容量更重要,因其直接决定数据传输速度,影响GPU计算单元的利用率。在AI训练和高分辨率渲染中,高带宽可避免“数据饥饿”,确保海量数据高效流转,而HBM技术凭借3D堆叠和宽接口提供远超GDDR的带宽,成为高性能计算的关键。 GPU显存带宽比容量更重要,核心在于现代GPU的工作模式和其处理的数…

    2026年9月24日
    100
  • VSCode如何实现代码热重载 VSCode实时预览开发的高效配置方案

    使用live server扩展实现静态文件的实时预览,保存后浏览器自动刷新;2. 利用现代前端框架(如react、vue)内置的开发服务器(如vite、webpack dev server)实现hmr热模块替换,修改代码后仅更新变动模块而不刷新页面;3. 结合browsersync等工具实现多设备同…

    2026年9月24日
    000
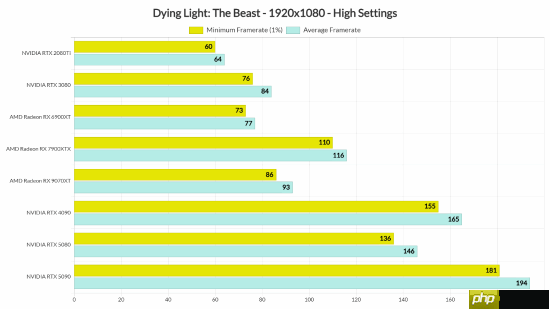
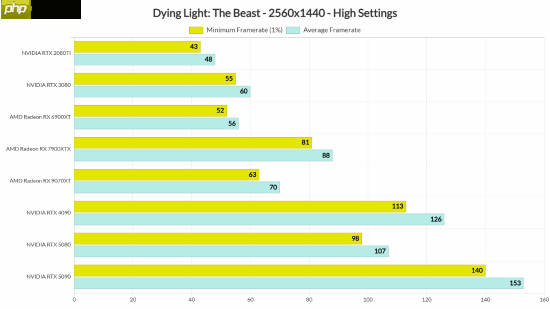
  • 外媒测试《消逝的光芒:困兽》PC性能:运行表现相当优秀

    外媒测试《消逝的光芒:困兽》PC性能:运行表现相当优秀外媒测试《消逝的光芒:困兽》PC性能:运行表现相当优秀外媒测试《消逝的光芒:困兽》PC性能:运行表现相当优秀外媒测试《消逝的光芒:困兽》PC性能:运行表现相当优秀

    来入手《消逝的光芒:困兽》吧!现享金币优惠叠加专属优惠券折上折,标准版仅需200.9元(共节省47.1元);豪华版233.2元(总计立减54.8元)。 由Techland打造的《消逝的光芒》系列新作《消逝的光芒:困兽》已正式上线。本作背景设定在曾经风景如画、如今却尸横遍野的河狸谷。玩家将在此组建临时…

    2026年9月24日 用户投稿
    000
  • UC浏览器怎么查看和清除LocalStorage数据 UC浏览器LocalStorage数据管理方法

    可通过隐私设置清除或开发者工具查看LocalStorage。①在UC浏览器设置中选择“隐私与安全”→“清除浏览数据”,勾选“Cookie及其他网站数据”即可批量删除LocalStorage;②打开uc://inspect启用开发者工具,通过电脑Chrome远程调试查看具体键值对;③root设备后使用…

    2026年9月24日
    200
  • Java语法基础中static关键字可以修饰哪些内容

    static关键字用于定义类成员,包括静态变量(如计数器)、静态方法(如工具方法)、静态代码块(类加载时执行)和静态内部类(不依赖外部类实例),均属于类而非对象,通过类名访问,提升成员至类级别实现共享与提前使用。 static 关键字在 Java 中主要用于定义与类相关而非与对象实例相关的成员。它不…

    2026年9月24日
    100
  • 抖音怎么看注册时间?怎么看百度网盘注册时间

    抖音已然成为国内炙手可热的短视频平台之一。凭借其独特的智能推荐系统,用户能够在短时间内找到自己喜爱的内容。你是否知道,你的抖音注册时间实际上隐含了许多关于你的社交轨迹的信息呢?本文将带领大家一同揭秘抖音注册时间背后的故事。 一、抖音注册时间的意义 1. 用户活跃程度的体现 抖音注册时间能够帮助我们判…

    2026年9月24日
    100
  • 为什么要4k对齐

    早期硬盘的每个扇区以512字节为标准,而新一代硬盘的扇区容量则为4096个字节,即所谓的4k扇区。虽然硬盘标准已经更新,但操作系统仍然使用512字节扇区的标准。为了确保兼容性,硬盘制造商将4k扇区模拟成了512字节扇区。文件系统的块(簇)通常是512字节的倍数,而新系统大多设定为4k的倍数,例如li…

    2026年9月24日
    000
  • 抖音怎么下载视频?抖音怎么提取别人的视频

    抖音作为一个热门的短视频社交平台,凭借其多样化的短视频内容吸引了众多用户。部分用户在浏览抖音视频时,希望能将其保存下来以供后续观看。那么,如何在抖音上下载视频呢?接下来,本文将详细介绍几种下载抖音视频的方法以及相关的注意事项。 一、抖音视频下载方法 使用抖音官方提供的下载功能 抖音自身具备下载功能,…

    2026年9月24日
    400
  • google浏览器怎么把网页保存为PDF_google浏览器网页保存为PDF方法

    使用Chrome将网页保存为PDF,首先按Ctrl+P进入打印界面,选择“另存为PDF”并调整设置后保存;也可通过F12打开开发者工具,截取指定元素或完整页面截图后转为PDF;还可安装“Save as PDF”等扩展程序实现更高质量的导出。 如果您希望将当前浏览的网页完整保存以便离线查看或分享,Go…

    2026年9月24日
    000
  • VSCode如何实现AI版本迁移辅助 VSCode跨版本升级的智能建议

    vscode的“ai版本迁移辅助”并非独立功能,而是通过扩展兼容性检查、设置同步、lsp/dap协议支持及社区资源等生态能力协同实现;2. 升级后扩展无法工作时,应检查更新日志、尝试降级或重新安装扩展、禁用冲突扩展、查看控制台错误信息并向作者报告问题;3. 备份设置和扩展列表可通过启用设置同步、手动…

    2026年9月24日
    1000
  • 抖音怎么投屏到电视上?抖音如何TV投屏

    智能电视已经成为了家庭娱乐的核心设备。在享受高清晰度大屏幕带来的视觉震撼的同时,抖音这款广受欢迎的短视频应用也吸引了众多用户。如何将抖音中的精彩内容传输到电视屏幕上,与家人和朋友一同分享呢?本文将详细介绍几种简单有效的方法,帮助您轻松实现抖音投屏到电视。 一、方法一:利用电视内置投屏功能 1. 内置…

    2026年9月24日
    000
  • uc浏览器如何清除指定的网站数据_UC浏览器定点清除网站Cookie与缓存

    可针对特定网站清理缓存或Cookie解决UC浏览器访问异常。1、进入设置→隐私与安全→管理网站数据,搜索目标网站并清除其数据;2、使用无痕浏览模式访问网站,避免数据残留;3、通过文件管理器手动删除UC浏览器缓存目录下对应域名的缓存文件夹。 如果您在使用UC浏览器访问某些网站时遇到加载异常、登录状态失…

    2026年9月24日
    000
  • MAC系统怎么开启防火墙_MAC开启防火墙教程

    1、建议在Mac系统中开启防火墙以提升网络安全,可通过“系统设置”中的“网络-防火墙”选项启用;2、高级用户可使用终端命令sudo /usr/libexec/ApplicationFirewall/socketfilterfw –setglobalstate on开启服务;3、启用后可在…

    2026年9月24日
    100
  • APM开发阅读

    APM开发阅读APM开发阅读APM开发阅读APM开发阅读

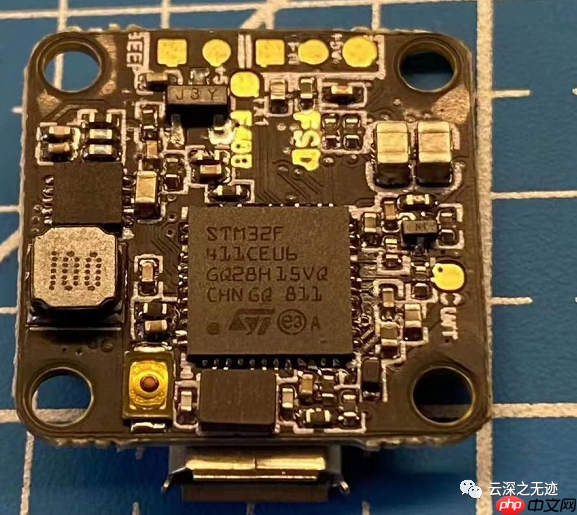
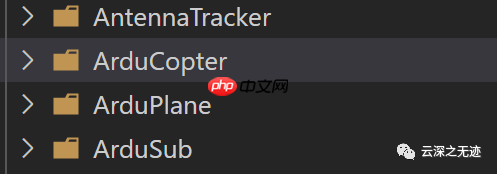
    我阅读apm的源码有两个主要目的:一是学习,了解飞控系统和大型项目的组织结构;二是为了移植的需要,满足项目需求。近年来,少儿编程市场非常火热,许多厂商推出了相关的产品,但这些产品大多使用空心杯电机,导致动力不足,且扩展性有限。许多任务需要io或图像识别的支持。 因此,我在考虑使用APM裁剪版的飞控系…

    2026年9月24日 用户投稿
    1600
  • MySQL中SQL注入防范 SQL注入攻击的预防与应对措施

    sql注入的防范核心在于参数化查询。具体措施包括:1.始终使用参数化查询,将用户输入视为数据而非可执行代码;2.对输入进行过滤与校验,如验证格式、转义特殊字符;3.遵循最小权限原则,限制数据库账号权限;4.控制错误信息输出,避免暴露敏感细节;5.定期更新框架与插件,及时修补漏洞。这些方法结合使用能有…

    2026年9月24日
    000
  • 如何在Linux中切换用户身份?

    Linux中切换用户主要用su和sudo命令;2. su切换用户需密码,su -可加载完整环境;3. sudo允许授权用户以root等身份执行命令而无需对方密码;4. 推荐使用sudo -i或sudo su -切换到root;5. 普通用户需加入sudo组或配置/etc/sudoers文件;6. 编…

    2026年9月24日
    100
  • VSCode的扩展设置是全局的还是局部的?

    VSCode扩展设置默认全局生效,存储于用户配置文件中,但部分扩展如ESLint、Prettier和Python支持项目级局部配置,通过在项目根目录的.vscode/settings.json文件中定义,可覆盖全局设置;在设置界面中,齿轮图标表示可被工作区覆盖,锁图标表示仅限全局修改,用户可根据需求…

    2026年9月24日
    200
  • PHP如何批量处理图片_PHP实现多张图片自动化处理

    批量处理图片时需循环读取并逐个处理,核心是使用scandir()获取文件列表,通过GD库或Imagick处理图像,每处理完一张用imagedestroy()释放内存以避免内存溢出;为提升效率可分批处理、优化算法、使用多进程或异步队列,并选用Intervention Image等高效第三方库。 批量处…

    2026年9月24日
    100
  • MySQL怎样处理SQL注入风险 参数化查询与特殊字符过滤方案

    MySQL怎样处理SQL注入风险 参数化查询与特殊字符过滤方案MySQL怎样处理SQL注入风险 参数化查询与特殊字符过滤方案MySQL怎样处理SQL注入风险 参数化查询与特殊字符过滤方案MySQL怎样处理SQL注入风险 参数化查询与特殊字符过滤方案

    参数化查询和特殊字符过滤是防止sql注入的有效方法。1. 参数化查询通过预处理语句将sql结构与数据分离,用户输入被视为参数,不会被解释为sql命令;2. 特殊字符过滤通过转义或拒绝单引号、双引号等危险字符来阻止攻击;3. 定期审查mysql安全配置,包括更新版本、限制权限、启用日志、使用防火墙和扫…

    2026年9月24日 用户投稿
    000
  • win8如何禁用usb端口_Win8 USB端口禁用教程

    1、通过组策略禁用USB存储:使用gpedit.msc进入可移动存储访问,启用“拒绝所有权限”并重启生效;2、修改注册表阻止驱动加载:将USBSTOR下的Start值设为4以禁用U盘等设备;3、设备管理器中手动禁用USB根集线器:逐一右键禁用各USB Root Hub实现端口封锁。 如果您希望在Wi…

    2026年9月24日
    300

发表回复

登录后才能评论
关注微信