基于记忆网络的异常检测模型通过学习和记忆“正常”模式实现异常识别,其核心步骤如下:1. 数据预处理:对输入数据进行标准化或归一化处理,时间序列数据还需滑动窗口处理以适配模型输入;2. 构建记忆网络架构:包括编码器(如lstm)、记忆模块(存储“正常”原型)和解码器,通过相似度计算与加权求和实现记忆增强表示;3. 模型训练:使用纯净正常数据训练,最小化重建误差,使模型记住“正常”特征;4. 异常评分与阈值设定:通过计算重建误差判断异常,设定阈值区分正常与异常。记忆网络因显式记忆“正常”模式、对新颖性敏感、鲁棒性强等优势在异常检测中表现优异,但构建时面临记忆库规模管理、训练稳定性、数据纯净度、资源效率等挑战。优化性能可通过记忆库剪枝、近似最近邻搜索、模型结构优化等方式实现,部署时需考虑模型服务化、资源管理、实时监控与更新等环节。
用Python实现基于记忆网络的异常检测模型,核心在于构建一个能够学习和记忆“正常”模式的神经网络结构。它通常包含一个编码器、一个外部记忆模块和一个解码器。模型通过学习将输入数据编码成一个向量,然后利用这个向量与记忆模块中的“原型”进行交互,最后再解码重建原始输入。当输入是异常数据时,由于其无法被记忆模块很好地表示和重建,重建误差就会显著增大,从而被识别为异常。

解决方案
要实现基于记忆网络的异常检测,我们可以从以下几个关键部分着手:
1. 数据预处理:异常检测模型对数据质量要求很高。无论是时间序列、图像还是表格数据,都需要进行标准化或归一化。对于时间序列数据,可能还需要滑动窗口处理,将其转换为适合模型输入的序列样本。比如,我通常会用MinMaxScaler将数据缩放到0-1之间,这样可以避免不同特征量纲差异过大影响模型学习。
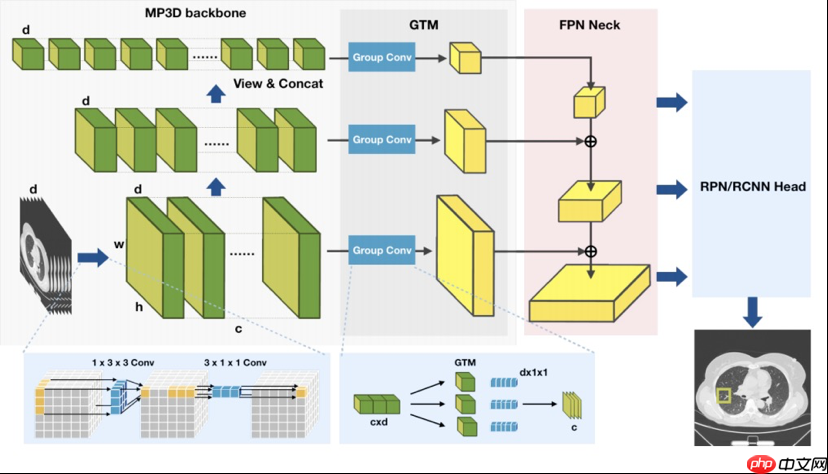
2. 记忆网络架构设计:这部分是核心。一个典型的记忆网络结构可能包括:
编码器(Encoder): 负责将输入数据映射到一个低维的潜在空间表示。这可以是简单的全连接层(tf.keras.layers.Dense),或者对于序列数据,可以使用循环神经网络(tf.keras.layers.LSTM或GRU)。我倾向于用LSTM,它处理序列数据时效果确实不错。记忆模块(Memory Module): 这是记忆网络最独特的部分。它本质上是一个可学习的“记忆库”,存储着一系列代表“正常”模式的记忆向量。当编码器输出一个查询向量时,记忆模块会计算这个查询向量与所有记忆向量的相似度(比如余弦相似度或点积),然后根据相似度加权求和,得到一个“记忆增强”的表示。记忆更新策略: 记忆模块可以是静态的,即在训练完成后不再更新;也可以是动态的,在推理阶段根据新数据进行有限的更新。动态更新更灵活,但处理不当容易引入异常模式。我通常会从静态记忆开始,如果效果不好再考虑动态更新。Python实现思路: 记忆模块可以作为自定义的Keras层或PyTorch模块来实现。内部维护一个tf.Variable或torch.nn.Parameter作为记忆矩阵。在前向传播中,执行相似度计算、加权求和。解码器(Decoder): 接收记忆增强后的表示,并尝试重建原始输入数据。解码器的结构通常与编码器对称,比如全连接层或LSTM层。重建损失: 模型训练的目标是最小化原始输入与重建输出之间的差异。对于连续数据,通常使用均方误差(MSE);对于二值数据,可能是二元交叉熵。
3. 模型训练:使用纯净的“正常”数据来训练模型。通过最小化重建损失,模型会学习如何有效地将正常数据编码、通过记忆模块,并准确地重建出来。这个过程,其实就是让模型记住“正常长什么样”。
4. 异常评分与阈值:训练完成后,我们用模型来对新的数据进行预测。计算输入数据与模型重建输出之间的重建误差。重建误差越大,说明数据与模型学到的“正常”模式偏离越大,是异常的可能性就越高。
阈值设定: 确定一个阈值来区分正常和异常。这通常通过在验证集上分析正常数据的重建误差分布来确定,比如使用第95或99百分位数作为阈值,或者结合统计方法(如Isolation Forest或One-Class SVM)来辅助确定。
Python代码概念片段(使用TensorFlow/Keras为例):
立即学习“Python免费学习笔记(深入)”;
import tensorflow as tffrom tensorflow.keras import layers, Modelimport numpy as npclass MemoryModule(layers.Layer): def __init__(self, memory_size, embedding_dim, **kwargs): super(MemoryModule, self).__init__(**kwargs) self.memory_size = memory_size self.embedding_dim = embedding_dim # 记忆库,存储memory_size个embedding_dim维的记忆向量 self.memory = self.add_weight(name='memory', shape=(memory_size, embedding_dim), initializer='random_normal', trainable=True) # 记忆向量也可以是可训练的 def call(self, query): # query: (batch_size, embedding_dim) # memory: (memory_size, embedding_dim) # 计算查询向量与每个记忆向量的相似度(这里用点积,也可以用余弦相似度) # (batch_size, embedding_dim) @ (embedding_dim, memory_size) -> (batch_size, memory_size) similarity = tf.matmul(query, self.memory, transpose_b=True) # 归一化相似度,得到注意力权重 attention_weights = tf.nn.softmax(similarity, axis=-1) # (batch_size, memory_size) # 加权求和,从记忆中检索信息 # (batch_size, memory_size) @ (memory_size, embedding_dim) -> (batch_size, embedding_dim) retrieved_memory = tf.matmul(attention_weights, self.memory) # 返回增强后的表示(这里简单相加,也可以是拼接或更复杂的交互) # 实际应用中,可能会返回 query + retrieved_memory 或者直接 retrieved_memory return retrieved_memory # 这里返回检索到的记忆,也可以是 query + retrieved_memorydef build_memory_network_model(input_shape, latent_dim, memory_size): inputs = layers.Input(shape=input_shape) # 编码器 x = layers.Dense(64, activation='relu')(inputs) encoded = layers.Dense(latent_dim, activation='relu')(x) # 编码到潜在空间 # 记忆模块 memory_output = MemoryModule(memory_size, latent_dim)(encoded) # latent_dim 作为 memory_module 的 embedding_dim # 解码器 decoded = layers.Dense(64, activation='relu')(memory_output) outputs = layers.Dense(input_shape[-1], activation='sigmoid')(decoded) # 输出与输入维度相同 model = Model(inputs, outputs) return model# 示例用法input_dim = 10 # 假设输入数据是10维的latent_dim = 32 # 潜在空间维度memory_size = 100 # 记忆库大小,存储100个记忆向量model = build_memory_network_model(input_shape=(input_dim,), latent_dim=latent_dim, memory_size=memory_size)model.compile(optimizer='adam', loss='mse')model.summary()# 假设有正常数据 normal_data (N, input_dim)# model.fit(normal_data, normal_data, epochs=50, batch_size=32)# 异常检测# reconstruction_error = np.mean(np.square(test_data - model.predict(test_data)), axis=1)# anomaly_score = reconstruction_error
为什么记忆网络在异常检测中表现出色?
在我看来,记忆网络在异常检测领域有其独到的优势,这主要得益于它处理“正常”模式的方式。传统的自编码器,虽然也能通过重建误差来识别异常,但它学习的是一个隐式的、连续的流形,对于一些细微的、但又确实是异常的偏离,可能不够敏感。记忆网络则不然,它通过一个显式的记忆库,将“正常”的各种原型特征存储起来,这就好比我们大脑里对“正常”事物有个清晰的图谱。
具体来说:
显式记忆“正常”模式: 这是最关键的一点。记忆网络通过维护一个离散或连续的记忆单元集合,直接存储了训练数据中学习到的“正常”数据模式。当新的数据输入时,它会去“查询”这些记忆,寻找最匹配的正常模式。如果一个输入无法在记忆中找到很好的匹配,或者说,它无法被记忆中的原型很好地“重建”出来,那它就很可能是异常。这种显式的存储,使得“正常”与“异常”的界限更加清晰。对新颖性(Novelty)的敏感性: 异常本质上就是数据中的新颖性或罕见模式。记忆网络通过将输入与已学习的正常模式进行比较,能够更有效地识别出那些与“已知正常”不符的模式。它不是简单地学习数据的压缩表示,而是学习如何通过“记忆”来重构数据。更强的鲁棒性: 在某些情况下,即使正常数据中存在少量噪声或微小变化,记忆网络也能通过其记忆检索机制,将其与最接近的正常原型关联起来,从而避免误判。但话说回来,如果训练数据本身就很“脏”,那记忆学到的也可能是“脏”的模式,所以数据清洗还是非常重要的。一定的可解释性: 某种程度上,我们可以通过分析输入数据与记忆单元的交互强度(比如注意力权重),来了解模型是基于哪些“正常”模式来判断当前输入的。虽然不像决策树那么直观,但比纯粹的黑箱模型要好一些。
构建记忆网络模型时常见的技术挑战有哪些?
在实际构建记忆网络模型时,我确实遇到过不少坑,有些问题还挺让人头疼的。这些挑战主要集中在模型的结构设计、训练策略和资源管理上。
记忆库的规模与管理:记忆大小(memory_size)的选择: 这是一个经验活儿。记忆库太小,可能无法充分捕捉“正常”模式的多样性,导致模型泛化能力不足,误报率高;记忆库太大,不仅增加计算开销,还可能导致记忆冗余,甚至记忆到一些不那么“正常”的噪声。我通常会从一个中等大小开始,然后根据验证集的表现进行调整。记忆更新策略: 记忆是静态的(训练完就不变)还是动态的(在推理时也允许更新)?静态记忆相对稳定,但无法适应数据分布的缓慢变化(概念漂移)。动态记忆虽然能适应,但如果更新策略不当,异常数据可能会“污染”记忆库,把异常也当成正常学进去,这简直是灾难。这方面需要非常谨慎的设计,比如只允许在确认是正常数据时才更新记忆,或者采用滑动窗口式的记忆更新。训练的稳定性和收敛性:梯度流问题: 记忆模块内部的相似度计算、softmax归一化和加权求和操作,可能会使得梯度在反向传播时变得复杂,导致训练不稳定,甚至出现梯度消失或爆炸。这需要仔细选择优化器、学习率,并可能需要梯度裁剪。过拟合与欠拟合: 记忆网络也面临所有深度学习模型都会遇到的过拟合和欠拟合问题。如果记忆库过大或训练数据不足,容易过拟合到训练数据中的特定模式;如果记忆库太小或模型容量不足,则可能欠拟合。数据纯净度: 记忆网络需要用“纯净”的正常数据进行训练。但在真实世界中,数据往往是混杂的,少量异常数据混入训练集会严重影响模型对“正常”的理解,导致模型学歪。这通常需要前期非常细致的数据清洗和标注工作。计算资源与效率:内存消耗: 记忆库本身就是一个矩阵,如果memory_size和embedding_dim都很大,会占用大量内存,尤其是在GPU上。推理速度: 每次推理都需要对输入与所有记忆向量进行相似度计算,这在大规模记忆库下会成为瓶颈。对于实时异常检测系统,这可能是个大问题。我曾尝试过用近似最近邻搜索(ANN)库,比如FAISS,来加速记忆检索过程,效果还不错。异常阈值的设定:模型输出的是一个异常分数(比如重建误差),但如何将这个分数转换为“是”或“否”的判断?阈值的选择至关重要。太高会导致漏报,太低会导致误报。这通常需要根据业务场景、可接受的误报率和漏报率,在验证集上进行反复试验和调整。我一般会绘制重建误差的分布图,结合业务专家的经验来定。
如何优化记忆网络的性能与部署?
优化记忆网络的性能和部署,我觉得就像打磨一件精密的工具,既要让它锋利,又要让它易于使用。这不仅仅是模型训练层面的事,还涉及到模型生命周期的管理。
模型性能优化:记忆库优化:动态剪枝与压缩: 记忆库在长时间运行后可能会积累一些冗余或不那么重要的记忆。可以定期对记忆库进行剪枝,移除那些很少被激活或贡献度低的记忆单元,或者对记忆向量进行量化,减少存储空间和计算量。近似最近邻搜索(ANN): 对于大型记忆库,每次查询都遍历所有记忆向量计算相似度效率很低。可以引入FAISS、Annoy或NMSLIB等ANN库,加速记忆检索过程。它们通过构建索引结构,可以在牺牲极小精度的情况下大幅提升查询速度。模型结构优化: 尝试更高效的编码器/解码器结构,比如使用更轻量的网络层,或者进行模型蒸馏,将大模型的知识迁移到小模型上。批处理与并行化: 确保数据在训练和推理时能够高效地进行批处理。在多GPU或分布式环境下,合理配置并行策略可以显著缩短训练时间。超参数调优: 学习率、批大小、记忆库大小、潜在空间维度等超参数对模型性能影响很大。使用网格搜索、随机搜索或贝叶斯优化等方法进行系统性调优。模型部署考量:模型序列化与加载: 训练好的模型(包括记忆库)需要能够方便地保存和加载。TensorFlow的SavedModel格式或PyTorch的state_dict是标准做法。确保记忆库作为模型的一部分被正确保存。推理服务化: 将模型封装成API服务(如使用Flask、FastAPI或TensorFlow Serving、TorchServe),以便其他应用调用。这需要考虑并发请求处理、延迟和吞吐量。资源管理: 部署时要考虑CPU/GPU资源、内存占用。对于资源受限的环境,可能需要部署优化过的轻量级模型。实时监控与告警: 部署后,需要持续监控模型的表现,比如重建误差的分布、异常检测的准确率等。当模型性能下降或数据分布发生显著变化时,及时触发告警。模型更新与迭代: 真实世界的异常模式会随时间演变,数据分布也可能发生漂移。因此,模型需要定期重新训练或进行增量学习。这可能涉及到周期性地收集新的正常数据来更新记忆库,或者在检测到概念漂移时触发全面重训练。我通常会建立一个MLOps管道来自动化这个过程,确保模型始终保持“新鲜”。边缘部署: 如果需要在边缘设备(如物联网设备)上进行异常检测,模型需要进一步的量化、剪枝和编译,以适应有限的计算和存储资源。这通常意味着要牺牲一些精度来换取极高的效率。
以上就是如何用Python实现基于记忆网络的异常检测模型?的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1365343.html
 微信扫一扫
 支付宝扫一扫