Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
运行Python脚本如何批量执行多个脚本文件 运行Python脚本的批量处理基础教程_创想鸟

运行Python脚本如何批量执行多个脚本文件 运行Python脚本的批量处理基础教程

最直接的方法是使用Python的subprocess模块编写主脚本批量调用子脚本,如run_all.py通过subprocess.run()依次执行process_data.py、generate_report.py等,可精确控制流程、捕获输出并处理错误;也可用Bash或Batch脚本循环调用,适合简单场景;对于复杂依赖或定时任务,可选用Makefile或任务调度器,而大型工作流推荐使用Airflow等专业工具

运行python脚本如何批量执行多个脚本文件 运行python脚本的批量处理基础教程

批量运行Python脚本,最直接也最常用的方法,通常是编写一个“主”脚本来调用其他需要执行的脚本,或者利用操作系统的命令行工具进行循环调用。核心在于自动化重复性的执行任务,无论是数据处理、报告生成还是系统维护,都能大大提升效率。

解决方案

要批量执行多个Python脚本文件,我个人最倾向于在Python内部完成这个任务,因为这样可以更好地控制执行流程、捕获输出,甚至处理脚本间的依赖关系。一个常见且强大的做法是使用Python的

subprocess

模块。

想象一下,你有一堆零散的Python脚本,比如

process_data.py

generate_report.py

cleanup_files.py

。你可以创建一个名为

run_all.py

的主脚本:

import subprocessimport osimport sys# 假设所有子脚本都在同一个目录下,或者你知道它们的路径script_dir = "./scripts" # 或者 os.path.dirname(__file__) 如果子脚本在主脚本的同级目录scripts_to_run = [    os.path.join(script_dir, "process_data.py"),    os.path.join(script_dir, "generate_report.py"),    os.path.join(script_dir, "cleanup_files.py")]print("开始批量执行Python脚本...")for script_path in scripts_to_run:    if not os.path.exists(script_path):        print(f"警告:脚本文件不存在 - {script_path},跳过。")        continue    print(f"n--- 正在执行: {os.path.basename(script_path)} ---")    try:        # 使用sys.executable确保用当前环境的Python解释器        result = subprocess.run([sys.executable, script_path],                                capture_output=True, text=True, check=True)        print("标准输出:")        print(result.stdout)        if result.stderr:            print("标准错误:")            print(result.stderr)        print(f"--- {os.path.basename(script_path)} 执行成功。 ---")    except subprocess.CalledProcessError as e:        print(f"--- 错误:{os.path.basename(script_path)} 执行失败,退出码 {e.returncode}。 ---")        print("错误输出:")        print(e.stderr)        # 可以在这里选择是继续执行其他脚本还是终止        # print("因错误终止后续脚本执行。")        # break    except FileNotFoundError:        print(f"错误:Python解释器或脚本路径不正确,无法执行 {script_path}。")    except Exception as e:        print(f"执行 {script_path} 时发生未知错误: {e}")print("n所有脚本执行尝试完成。")

这段代码的核心是

subprocess.run()

check=True

参数非常关键,它能让Python在子进程返回非零退出码时抛出

CalledProcessError

,这样我们就能捕获并处理错误,而不是让程序默默地失败。

capture_output=True

则能让你获取到子脚本的

stdout

stderr

,这对于调试和日志记录非常有帮助。

立即学习“Python免费学习笔记(深入)”;

当然,如果你只是想简单地按顺序执行,也可以通过操作系统的命令行循环。在Linux/macOS的Bash里:

#!/bin/bash# 假设所有脚本都在当前目录的 'scripts' 子文件夹里SCRIPT_DIR="./scripts"echo "开始批量执行Python脚本..."for script in "$SCRIPT_DIR"/*.py; do    if [ -f "$script" ]; then        echo -e "n--- 正在执行: $(basename "$script") ---"        python "$script"        if [ $? -ne 0 ]; then            echo "--- 错误:$(basename "$script") 执行失败。 ---"            # exit 1 # 如果想在第一个错误时停止        else            echo "--- $(basename "$script") 执行成功。 ---"        fi    fidoneecho -e "n所有脚本执行尝试完成。"

在Windows的Batch脚本里:

@echo offset SCRIPT_DIR=.scriptsecho 开始批量执行Python脚本...for %%f in ("%SCRIPT_DIR%*.py") do (    echo.    echo --- 正在执行: %%~nxf ---    python "%%f"    if errorlevel 1 (        echo --- 错误:%%~nxf 执行失败。 ---        REM exit /b 1 REM 如果想在第一个错误时停止    ) else (        echo --- %%~nxf 执行成功。 ---    ))echo.echo 所有脚本执行尝试完成。

选择哪种方式,很大程度上取决于你的具体需求、对错误处理的精细程度要求,以及你更习惯哪种环境。我个人偏爱Python主脚本,因为它提供了更强大的编程能力来处理复杂的逻辑。

为什么我们需要批量运行Python脚本?

这问题问得好,其实很多时候,我们的工作流程并不是一个单一、庞大的脚本就能解决的。它更像是一个由多个小工具组成的流水线。批量运行脚本的需求,往往源于对自动化、效率和流程标准化的渴望。

比如说,你可能每天都要从不同的数据源(数据库、API、CSV文件)抓取数据,然后对这些数据进行清洗、转换,接着可能需要生成几份不同格式的报告(PDF、Excel),最后还要把这些报告通过邮件发送给不同的人。如果这些步骤都写在一个巨大的脚本里,维护起来简直是噩梦。一个微小的改动,都可能影响到整个流程。

但如果把这些步骤拆分成独立的Python脚本:

fetch_data.py

clean_transform.py

generate_pdf_report.py

generate_excel_report.py

send_emails.py

。每个脚本只负责一个明确的任务,职责单一,易于测试和维护。这时候,你就需要一个机制来按顺序、按条件地执行它们,这就是批量运行的价值所在。它把原本手动、重复的“点击运行”过程自动化了,释放了我们的时间和精力,去思考更有创造性的问题。

另一个很重要的点是资源管理。有些脚本可能很耗内存,有些可能需要独占某个文件或网络连接。通过批量运行,我们可以精细地控制它们的启动顺序,甚至可以引入并发执行(如果脚本之间没有资源冲突),进一步榨取系统性能。所以,这不仅仅是省事儿,更是提升整个工作流鲁棒性和效率的关键一步。

通过Python主脚本控制批量执行的实现细节

当我们决定用Python主脚本来 orchestrate 整个批量执行流程时,有一些细节值得我们深入探讨,因为这直接关系到程序的健壮性和可维护性。

首先是路径管理。你不可能总是把所有子脚本都放在主脚本的同级目录。实际项目中,它们可能分布在不同的子文件夹里。这时,

os.path.join()

就显得尤为重要,它能跨平台地拼接路径,避免了Windows和Linux路径分隔符的差异(


vs

/

)。更进一步,如果你的子脚本需要访问它们自己的相对路径资源(比如配置文件、数据文件),那么在执行子脚本之前,可能还需要使用

os.chdir()

临时改变当前工作目录到子脚本所在的目录,或者确保子脚本内部能正确解析自己的路径。不过,

subprocess.run()

默认会在子进程中继承父进程的环境变量和当前工作目录,所以通常情况下,只要主脚本能找到子脚本,子脚本就能正常运行。

错误处理是另一个重中之重。仅仅捕获

subprocess.CalledProcessError

是不够的。我们还需要考虑子脚本执行过程中可能出现的其他异常,比如

FileNotFoundError

(如果Python解释器路径不对或者子脚本路径彻底错了)。更重要的是,要决定当一个子脚本失败时,整个批量执行流程是应该继续还是立即终止。在上面的代码示例中,我只是打印了错误信息并继续,但在实际生产环境中,你可能需要根据错误的严重性来决定:是记录日志、发送告警,然后继续?还是直接停止,防止错误蔓延?这需要根据业务逻辑来判断。

输出捕获和日志记录也至关重要。

capture_output=True

让我们可以拿到子脚本的

stdout

stderr

。这些信息对于调试至关重要。我通常会把这些输出写入到日志文件中,而不是直接打印到控制台,特别是当脚本数量多、运行时间长的时候。一个好的日志系统可以帮助我们追踪每个脚本的执行状态、性能瓶颈以及潜在问题。可以考虑使用Python内置的

logging

模块,为每个子脚本的执行创建一个独立的日志条目。

更高级的用法,我们可以考虑并发执行。如果你的多个子脚本之间没有严格的执行顺序依赖,并且它们是CPU密集型或I/O密集型任务,那么使用

concurrent.futures

模块(如

ThreadPoolExecutor

ProcessPoolExecutor

)可以让它们并行运行,显著缩短总执行时间。但这会引入额外的复杂性,比如资源竞争、死锁等问题,需要仔细设计和测试。通常,对于初学者或非性能敏感的场景,顺序执行已经足够。

最后,参数传递也是一个常见需求。如果你的子脚本需要接收命令行参数,你可以直接在

subprocess.run()

的第一个参数(列表)中添加这些参数:

[sys.executable, script_path, 'arg1', '--option', 'value']

。这样,子脚本就可以通过

sys.argv

来获取这些参数。这种方式非常灵活,允许我们根据不同的运行场景,动态地调整子脚本的行为。

除了Python,还有哪些工具或方法可以实现脚本批量执行?

当然,Python虽然强大,但它并非唯一的选择。在自动化脚本批量执行的领域,还有一些非常成熟且各有侧重的工具和方法,它们在特定场景下可能更加高效或便捷。

最基础也最通用的,就是操作系统自带的命令行脚本。我们前面提到的Bash脚本(Linux/macOS)和Batch脚本(Windows)就是典型。它们的优势在于无需额外安装任何软件,只要系统有对应的shell环境就能运行。对于简单的顺序执行、文件遍历、基础的错误判断(通过退出码

$?

errorlevel

),它们非常得心应手。尤其是在部署到服务器环境时,一个简单的shell脚本往往是启动整个服务的入口。但它们的缺点也很明显:语法相对晦涩,不擅长处理复杂的数据结构或逻辑,错误处理机制也比较原始。

接着,是Makefiles。这玩意儿可能听起来有点老派,但它在软件开发和数据工程领域依然扮演着重要角色。

make

工具最初是为了自动化编译过程而设计的,但它的“目标-依赖-命令”模型非常适合描述一系列有依赖关系的自动化任务。比如,你可能有一个脚本A生成数据,脚本B依赖于脚本A生成的数据来生成报告。在Makefile中,你可以清晰地定义这种依赖关系,

make

会自动判断哪些任务需要重新执行(因为其依赖项发生了变化),并只执行必要的部分。这对于增量更新和避免重复工作非常有效。

再往上,我们有任务调度器。在Linux上是

cron

,在Windows上是“任务计划程序”。它们主要用于在特定时间(比如每天凌晨3点)或特定事件发生时自动触发脚本执行。它们本身不负责脚本的内部逻辑或错误处理,只是一个定时启动器。通常,我们会把一个包含批量执行逻辑的shell脚本或Python主脚本配置到这些调度器中,实现无人值守的自动化。

对于更复杂的、跨多台机器的、需要图形化界面或更高级调度策略的场景,工作流管理系统(Workflow Management Systems)就派上用场了。比如Apache Airflow、Luigi、Prefect等。这些工具提供了强大的DAG(有向无环图)定义能力,可以可视化地构建复杂的工作流,处理任务间的依赖、重试机制、并行执行、失败通知等。它们通常自带Web界面,方便监控任务状态。但学习曲线相对陡峭,部署和维护也更复杂,更适合大型、长期运行的数据管道或ETL任务。

所以,选择哪种方法,完全取决于你的需求规模、技术栈偏好以及团队的熟悉程度。对于日常的、小规模的批量任务,Python主脚本或简单的shell脚本足矣;而对于生产级的、复杂的、有严格依赖关系和监控需求的工作流,专业的工作流管理系统才是王道。

以上就是运行Python脚本如何批量执行多个脚本文件 运行Python脚本的批量处理基础教程的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1367846.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Python命令怎样导出已安装库的列表 Python命令库列表导出的简单教程
上一篇 2025年12月14日 08:16:31
如何实现Python数据的分布式处理?PySpark基础
下一篇 2025年12月14日 08:16:48

相关推荐

  • VSCode极速配置TypeScript:类型检查、中文报错、编译优化

    答案:合理配置tsconfig.json并结合VSCode插件可提升TypeScript开发效率。1. tsconfig.json中设置target、module、strict、skipLibCheck及paths优化类型检查与编译速度;2. 使用TypeScript ESLint和Prettier…

    2026年9月22日
    000
  • 如何通过HD Tune和CrystalDiskInfo检测SSD健康度与寿命?

    CrystalDiskInfo和HD Tune可准确评估SSD健康状态与寿命。首先使用CrystalDiskInfo查看健康等级及SMART参数,重点关注重新分配扇区计数、磨损均衡计数和剩余寿命百分比;开启AUTOSAVE功能记录长期状态。再通过HD Tune检查SMART警告项,执行错误扫描排查读…

    2026年9月22日
    300
  • 抖店是连接抖音商城吗?抖音商店

    抖音商城也应运而生。抖店作为连接抖音商城的重要渠道,为商家提供了丰富的电商资源,助力商家实现电商新突破。本文将从抖店的作用、优势以及如何利用抖店进行电商运营等方面进行探讨。 一、抖店的作用 1. 降低商家入驻门槛 相较于传统电商平台,抖店降低了商家入驻门槛。商家只需在抖音平台注册成为商家,即可入驻抖…

    2026年9月22日
    100
  • 理解Next.js与Firestore数据获取中的多次读取现象及优化

    Next.js应用在获取单个Firestore文档时,可能遭遇实际读取次数远超预期的现象,且数据获取函数被多次调用。本文将深入探讨Firestore的计费机制、Next.js数据获取的生命周期特点,并提供使用React cache进行请求去重及其他优化策略,以有效管理Firestore读取成本和提升…

    2026年9月22日
    000
  • Docker的安装与卸载

    Docker的安装与卸载Docker的安装与卸载Docker的安装与卸载Docker的安装与卸载

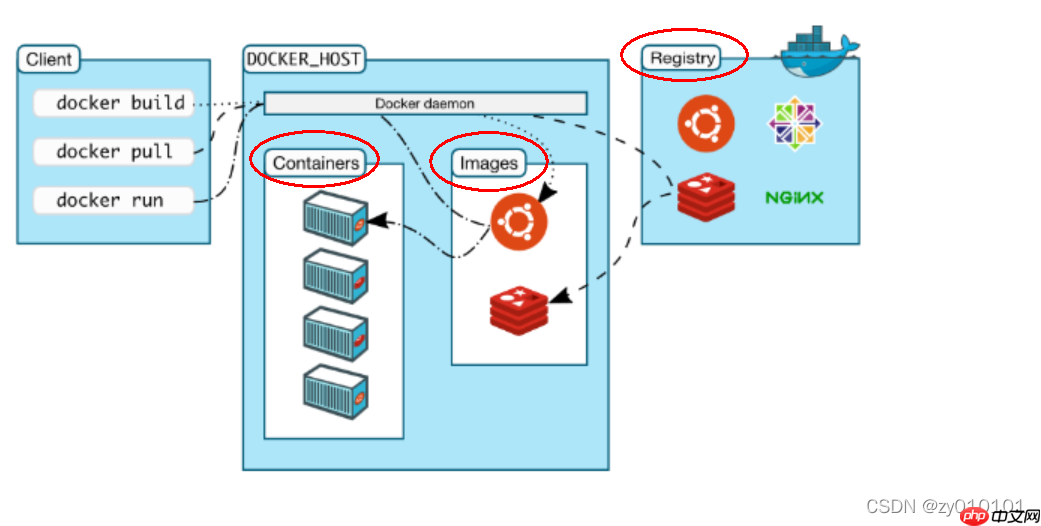
    docker并不是一个通用的容器工具,它依赖于linux内核环境。实际上,docker是在运行的linux系统下创建一个隔离的文件环境,因此它的执行效率几乎与宿主环境相当。因此,在windows上部署docker需要先安装wsl子系统来提供linux环境,然后才能安装docker。 Docker由三…

    2026年9月22日 用户投稿
    100
  • RunwayML的AI混合工具怎么用?教你轻松实现视频与图像融合创作

    RunwayML的AI混合工具通过Gen-1和Gen-2模型实现视频与图像的深度融合创作,Gen-1侧重风格迁移,保留原始运动轨迹,适用于艺术化处理;Gen-2支持文本、图像或视频生成新内容,适合概念可视化与大幅修改,结合高质量输入、精准提示词、参数调整及迭代优化,可高效融入创意工作流,提升视频创作…

    2026年9月22日
    000
  • VSCode如何配置Rust开发环境 VSCode搭建Rust项目的详细步骤

    安装rust工具链需在终端运行curl –proto ‘=https’ –tlsv1.2 https://sh.rustup.rs -ssf | sh,安装完成后重启终端或执行source $home/.cargo/env,并通过rustc &#821…

    2026年9月22日
    000
  • 如何配置Linux用户密码复杂度 pam_pwquality设置

    如何配置Linux用户密码复杂度 pam_pwquality设置如何配置Linux用户密码复杂度 pam_pwquality设置如何配置Linux用户密码复杂度 pam_pwquality设置如何配置Linux用户密码复杂度 pam_pwquality设置

    linux系统需要配置密码复杂度以提高安全性,防止弱密码被暴力破解或字典攻击。核心方法是通过编辑/etc/security/pwquality.conf文件并确保pam_pwquality.so模块被正确加载。1. 配置pwquality.conf设置minlen(最小长度)、dcredit/ucr…

    2026年9月22日 用户投稿
    300
  • 如何在Linux中杀死进程?

    最常用的方法是使用kill、pkill和killall命令;已知PID时用kill更精确,知道进程名则用pkill或killall更方便,优先尝试SIGTERM信号以避免数据丢失。 在Linux中终止进程有多种方式,主要通过命令行工具实现。最常用的方法是使用 kill、pkill 和 killall…

    2026年9月22日
    100
  • 大麦网惹鹿晗粉丝“炸毛”,买张票咋就这么闹心?

    大麦网惹鹿晗粉丝“炸毛”,买张票咋就这么闹心?大麦网惹鹿晗粉丝“炸毛”,买张票咋就这么闹心?大麦网惹鹿晗粉丝“炸毛”,买张票咋就这么闹心?大麦网惹鹿晗粉丝“炸毛”,买张票咋就这么闹心?

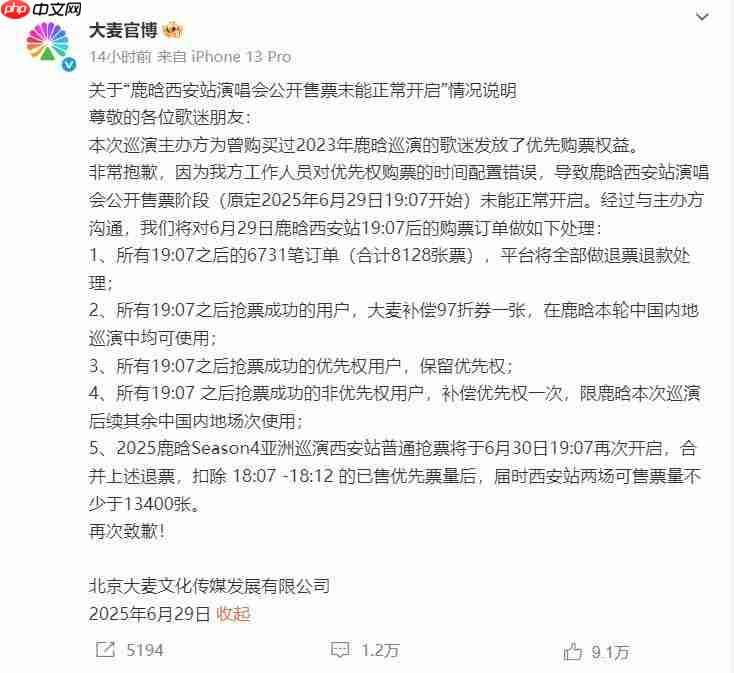
    6月29日晚,许多网友在大麦平台上抢购鹿晗西安站演唱会门票时发现异常。原定18:07为优先权购票时间,19:07则为普通用户开放抢票。然而到了普通场次的抢票时段,平台依旧只开放了优先权通道,导致普通用户无法参与抢票。部分原本不打算在西安站使用优先权的用户,被迫提前动用了优先权资格,影响了后续其他场次…

    2026年9月22日 用户投稿
    000
  • CPU 功耗墙设定对游戏帧数与稳定性的影响

    功耗墙直接影响CPU性能释放,设置过低导致游戏掉帧、卡顿,过高则引发过热降频;合理设定需结合散热与供电条件,台式机可提升PL2至150W~200W,笔记本建议维持45W~65W,通过HWiNFO64监控功耗与温度,平衡性能与稳定。 在高性能游戏场景中,CPU 的功耗墙(Power Limit)设置会…

    2026年9月22日
    000
  • React中动态导入图片:require.context 的高效实践

    React中动态导入图片:require.context 的高效实践React中动态导入图片:require.context 的高效实践React中动态导入图片:require.context 的高效实践React中动态导入图片:require.context 的高效实践

    在React组件中,直接使用变量进行动态图片导入(如import(variable)或require(variable))通常会因构建工具的静态分析限制而失败。本文将深入探讨这一常见问题,并详细介绍如何利用Webpack的require.context功能,实现对图片资源的灵活、批量导入与管理,从而…

    2026年9月22日 用户投稿
    100
  • VSCode配置FPGA的CI/CD流程(自动化测试与部署指南)

    答案是:使用VSCode配置FPGA的CI/CD流程完全可行,通过tasks.json和launch.json集成脚本化构建、仿真、测试与烧录任务,结合Git版本控制与Docker环境封装,实现设计流程自动化;利用Cocotb等框架构建可复用、高覆盖率的自动化测试环境,并通过统一项目结构和CI/CD…

    2026年9月22日
    100
  • mysql安装完成如何缓存 mysql查询缓存设置与优化

    mysql安装完成如何缓存 mysql查询缓存设置与优化mysql安装完成如何缓存 mysql查询缓存设置与优化mysql安装完成如何缓存 mysql查询缓存设置与优化mysql安装完成如何缓存 mysql查询缓存设置与优化

    mysql 5.7 及更早版本支持查询缓存,可通过配置 query_cache_type、query_cache_size 和 query_cache_limit 开启并优化缓存效果。首先确认 mysql 版本是否支持查询缓存,若为 5.7 或更低版本,可在配置文件中设置 query_cache_t…

    2026年9月22日 用户投稿
    300
  • 天猫超市买的东西是一个包裹吗?天猫超市买的东西是一个包裹吗怎么查

    同一订单通常合并发货,但可能分开发货。通过天猫App“我的订单”查看物流信息,若显示一个快递单号则为一个包裹,多个单号则为分开发货;也可通过支付宝账单查询物流详情,或使用第三方物流平台如17TRACK输入单号查询轨迹,单号与包裹数量对应,以此判断发货情况。 如果您在天猫超市下单后,不确定商品是否会被…

    2026年9月22日
    300
  • windows提示“该操作已被取消”是什么原因_“由于这台计算机的限制,该操作已被取消”的解决之道

    1、检查UAC设置并确保账户为管理员权限;2、临时关闭第三方安全软件以排除拦截可能;3、通过组策略编辑器禁用驱动器访问限制;4、在注册表中修改或删除NoDriveTypeAutoRun、DisallowRun等限制项;5、重置文件类型默认应用关联并重启电脑恢复操作功能。 如果您在使用Windows系…

    2026年9月22日
    000
  • 抖音小额收款在哪里?抖音小额打款的钱在哪里

    如今,抖音已成为年轻人展示才华、互动交流的重要平台。许多用户在平台上通过发布优质内容积累粉丝,并希望借助平台实现小额资金往来。那么,抖音小额收款功能到底在哪里呢?本文将为您全面解析抖音小额收款的使用方法及相关知识,帮助您轻松上手,安全操作。 一、抖音小额收款方式 1. 抖音直播互动 抖音直播是当前平…

    2026年9月22日
    000
  • 【Linux】While循环吃hang行了?(图是一个毒)

    【Linux】While循环吃hang行了?(图是一个毒)【Linux】While循环吃hang行了?(图是一个毒)【Linux】While循环吃hang行了?(图是一个毒)【Linux】While循环吃hang行了?(图是一个毒)

    最近被一首歌曲洗脑了:心火烧,原名《情伴》,作为新中国的第一首流行歌曲,绝对是神曲的开山祖师呀,而在《向往的生活》中被宋丹丹老师、黄磊老师等演绎后,每天忍不住哼唱? 进入正题 这两天因为测试准备了一个脚本,流程就是类似需要登录各个服务器然后执行命令,从设计上看感觉非常简单: 将各服务器的IP全部写入…

    2026年9月22日 用户投稿
    000
  • 抖音飞鸽客服名称怎么改?抖店客服名称怎么改

    电商行业在我国经济中的地位日益凸显。为了满足消费者日益增长的服务需求,各大电商平台纷纷推出特色客服服务。抖音飞鸽客服作为抖音平台的官方客服,以其独特的服务模式和创新精神,赢得了广大用户的认可和好评。本文将从抖音飞鸽客服的名称改写、服务特色、行业影响等方面进行分析,以期为电商客服行业的发展提供借鉴。 …

    2026年9月22日
    000
  • Krita中如何导出AI生成的分层图片?保存多层图像的步骤

    .kra格式是保存AI分层图像的最佳选择,因其完整保留Krita特有的图层、蒙版、滤镜等编辑信息,确保后续修改不受限;若需跨软件协作,则应导出为PSD格式,尽管可能损失部分Krita专属功能,但兼容性最广;TIFF适合高质量印刷场景,但分层支持不稳定;OpenEXR适用于含深度、法线等通道的专业合成…

    2026年9月22日
    100

发表回复

登录后才能评论
关注微信