Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
PySpark中高效移除重复数据的两种策略_创想鸟

PySpark中高效移除重复数据的两种策略

PySpark中高效移除重复数据的两种策略

本文详细阐述了在PySpark环境中处理重复数据的两种主要方法:针对原生PySpark SQL DataFrame的dropDuplicates()和针对PySpark Pandas DataFrame的drop_duplicates()。文章深入分析了这两种函数的用法、适用场景及关键区别,并通过代码示例和注意事项,指导用户根据其DataFrame类型选择最合适的去重策略,确保数据处理的准确性和效率。

PySpark中重复数据处理概述

在数据处理和分析中,移除重复记录是数据清洗的关键步骤之一,尤其是在处理大规模数据集时。pyspark作为大数据处理的强大框架,提供了高效的机制来识别和消除dataframe中的重复行。然而,由于pyspark生态系统的发展,目前存在两种主要的dataframe类型,它们各自拥有不同的去重api:原生的pyspark.sql.dataframe和基于pandas api的pyspark.pandas.dataframe。理解这两种类型的差异及其对应的去重方法,对于编写健壮且高效的pyspark代码至关重要。

使用 pyspark.sql.DataFrame.dropDuplicates() 进行去重

pyspark.sql.DataFrame是PySpark的核心数据结构,它提供了类似于关系型数据库表的操作接口。对于这种类型的DataFrame,去重操作通过dropDuplicates()方法实现。

函数签名与用法

dropDuplicates()函数可以接受一个可选的列名列表作为参数,用于指定在哪些列上进行重复检查。如果不指定任何列,则默认会检查所有列。

DataFrame.dropDuplicates(subset=None)

subset: 可选参数,一个字符串列表,指定用于识别重复行的列。如果为None,则所有列都将用于去重。

示例代码

假设我们有一个包含客户ID的PySpark SQL DataFrame,我们希望移除重复的客户ID。

from pyspark.sql import SparkSessionfrom pyspark.sql.functions import col# 初始化SparkSessionspark = SparkSession.builder.appName("DropDuplicatesSQL").getOrCreate()# 创建一个示例PySpark SQL DataFramedata = [("C001", "Alice"), ("C002", "Bob"), ("C001", "Alice"), ("C003", "Charlie"), ("C002", "Bob")]columns = ["CUSTOMER_ID", "NAME"]df_sql = spark.createDataFrame(data, columns)print("原始 PySpark SQL DataFrame:")df_sql.show()# 1. 对所有列进行去重df_distinct_all = df_sql.dropDuplicates()print("所有列去重后的 DataFrame:")df_distinct_all.show()# 2. 仅根据 'CUSTOMER_ID' 列进行去重# 注意:当仅根据子集去重时,对于重复的子集行,Spark会保留其中任意一行,其非子集列的值可能不确定。# 在此示例中,由于(C001, Alice)是完全重复的,所以行为一致。# 但如果数据是 (C001, Alice) 和 (C001, David),则去重后会保留其中一个。df_distinct_id = df_sql.dropDuplicates(subset=["CUSTOMER_ID"])print("根据 'CUSTOMER_ID' 列去重后的 DataFrame:")df_distinct_id.show()# 停止SparkSessionspark.stop()

输出示例:

原始 PySpark SQL DataFrame:+-----------+-------+|CUSTOMER_ID|   NAME|+-----------+-------+|       C001|  Alice||       C002|    Bob||       C001|  Alice||       C003|Charlie||       C002|    Bob|+-----------+-------+所有列去重后的 DataFrame:+-----------+-------+|CUSTOMER_ID|   NAME|+-----------+-------+|       C001|  Alice||       C002|    Bob||       C003|Charlie|+-----------+-------+根据 'CUSTOMER_ID' 列去重后的 DataFrame:+-----------+-------+|CUSTOMER_ID|   NAME|+-----------+-------+|       C001|  Alice||       C002|    Bob||       C003|Charlie|+-----------+-------+

使用 pyspark.pandas.DataFrame.drop_duplicates() 进行去重

PySpark Pandas API(pyspark.pandas)旨在为熟悉Pandas库的用户提供一个在Spark上运行的相似接口。对于通过pyspark.pandas创建或转换而来的DataFrame,其去重方法与Pandas中的drop_duplicates()保持一致。

函数签名与用法

drop_duplicates()函数提供了更丰富的参数,以控制去重行为,例如保留哪个重复项(第一个、最后一个或不保留)。

DataFrame.drop_duplicates(subset=None, keep='first', inplace=False, ignore_index=False)

subset: 可选参数,一个字符串列表,指定用于识别重复行的列。如果为None,则所有列都将用于去重。keep: 字符串,可选值有’first’、’last’或False。’first’: 保留第一个出现的重复行。’last’: 保留最后一个出现的重复行。False: 删除所有重复行(即,如果某行有重复,则该行及其所有重复项都会被删除)。inplace: 布尔值,如果为True,则在原始DataFrame上进行操作并返回None;如果为False,则返回一个新DataFrame。ignore_index: 布尔值,如果为True,则重置结果DataFrame的索引。

示例代码

import pyspark.pandas as psfrom pyspark.sql import SparkSession# 初始化SparkSession (pyspark.pandas 会自动使用现有的SparkSession)spark = SparkSession.builder.appName("DropDuplicatesPandas").getOrCreate()# 创建一个示例PySpark Pandas DataFramedata = {"CUSTOMER_ID": ["C001", "C002", "C001", "C003", "C002"],        "NAME": ["Alice", "Bob", "Alice", "Charlie", "Bob"]}psdf = ps.DataFrame(data)print("原始 PySpark Pandas DataFrame:")print(psdf)# 1. 对所有列进行去重 (默认 keep='first')psdf_distinct_all = psdf.drop_duplicates()print("所有列去重后的 DataFrame:")print(psdf_distinct_all)# 2. 仅根据 'CUSTOMER_ID' 列进行去重,保留第一个psdf_distinct_id_first = psdf.drop_duplicates(subset=["CUSTOMER_ID"], keep='first')print("根据 'CUSTOMER_ID' 列去重 (保留第一个) 后的 DataFrame:")print(psdf_distinct_id_first)# 3. 仅根据 'CUSTOMER_ID' 列进行去重,保留最后一个psdf_distinct_id_last = psdf.drop_duplicates(subset=["CUSTOMER_ID"], keep='last')print("根据 'CUSTOMER_ID' 列去重 (保留最后一个) 后的 DataFrame:")print(psdf_distinct_id_last)# 4. 仅根据 'CUSTOMER_ID' 列进行去重,删除所有重复项psdf_distinct_id_false = psdf.drop_duplicates(subset=["CUSTOMER_ID"], keep=False)print("根据 'CUSTOMER_ID' 列去重 (删除所有重复项) 后的 DataFrame:")print(psdf_distinct_id_false)# 停止SparkSession (如果需要,但通常在脚本结束时自动停止)spark.stop()

输出示例:

原始 PySpark Pandas DataFrame:  CUSTOMER_ID     NAME0        C001    Alice1        C002      Bob2        C001    Alice3        C003  Charlie4        C002      Bob所有列去重后的 DataFrame:  CUSTOMER_ID     NAME0        C001    Alice1        C002      Bob3        C003  Charlie根据 'CUSTOMER_ID' 列去重 (保留第一个) 后的 DataFrame:  CUSTOMER_ID     NAME0        C001    Alice1        C002      Bob3        C003  Charlie根据 'CUSTOMER_ID' 列去重 (保留最后一个) 后的 DataFrame:  CUSTOMER_ID     NAME2        C001    Alice4        C002      Bob3        C003  Charlie根据 'CUSTOMER_ID' 列去重 (删除所有重复项) 后的 DataFrame:  CUSTOMER_ID     NAME3        C003  Charlie

选择正确的去重方法:关键区别与注意事项

选择dropDuplicates()还是drop_duplicates()的核心在于你正在操作的DataFrame类型。

DataFrame类型识别:

如果你通过spark.createDataFrame()或读取Spark数据源(如Parquet、CSV)创建DataFrame,你得到的是pyspark.sql.DataFrame。此时应使用dropDuplicates()。如果你通过pyspark.pandas.DataFrame()构造函数创建DataFrame,或者将pyspark.sql.DataFrame通过df.to_pandas_on_spark()(或旧版df.to_pandas())转换为pyspark.pandas.DataFrame,那么你应该使用drop_duplicates()。

你可以通过type(df)或df.__class__.__name__来检查DataFrame的类型。

API一致性:

dropDuplicates()是Spark原生的API,其行为和性能优化是基于Spark分布式计算模型设计的。drop_duplicates()则遵循Pandas的API规范,对于熟悉Pandas的用户来说更直观。它在底层会转换为Spark操作,但其接口与Pandas保持高度一致。

功能差异:

dropDuplicates()相对简洁,主要关注去重本身。当基于子集去重时,它保留哪个重复项是不确定的(通常是Spark内部优化决定的任意一个)。drop_duplicates()提供了keep参数,允许你精确控制保留第一个、最后一个还是删除所有重复项,这在某些业务场景下非常有用。

性能考量:两种方法在底层都会触发Spark的distinct或groupBy操作,这通常涉及到数据的shuffle(混洗),对于大规模数据集而言,shuffle是计算密集型操作。因此,无论使用哪种方法,都应注意其对性能的影响。

总结

PySpark提供了两种强大且高效的方法来处理DataFrame中的重复数据:pyspark.sql.DataFrame的dropDuplicates()和pyspark.pandas.DataFrame的drop_duplicates()。理解它们各自的适用场景和功能特性是编写高效PySpark代码的关键。在实践中,务必根据你当前操作的DataFrame类型来选择正确的去重函数。当需要更精细地控制重复项的保留策略时,pyspark.pandas.DataFrame.drop_duplicates()的keep参数提供了更大的灵活性。始终牢记,去重操作可能涉及数据混洗,因此在处理超大规模数据集时,应评估其性能影响。

以上就是PySpark中高效移除重复数据的两种策略的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1369278.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Beautiful Soup 中定位字符串及其父标签
上一篇 2025年12月14日 09:31:23
利用BeautifulSoup定位字符串并获取其上下文标签
下一篇 2025年12月14日 09:31:43

相关推荐

  • 长佩阅读如何自定义封面

    在长佩阅读中,设置自定义封面可以让你的书架更具个人风格。以下是具体操作步骤: 一、确认书籍是否支持自定义封面 并非所有书籍都开放自定义封面功能,你需要先进入书籍详情页查看是否存在“自定义封面”这一选项。若该按钮存在,则说明这本书允许用户更换封面。 二、准备合适的封面图片 选择一张你喜欢的图片作为新封…

    2026年9月21日
    000
  • MySQL热点数据缓存策略_MySQL减少磁盘访问提升性能

    MySQL热点数据缓存策略_MySQL减少磁盘访问提升性能MySQL热点数据缓存策略_MySQL减少磁盘访问提升性能MySQL热点数据缓存策略_MySQL减少磁盘访问提升性能MySQL热点数据缓存策略_MySQL减少磁盘访问提升性能

    mysql热点数据缓存的核心在于将频繁访问的数据保留在内存中以减少磁盘i/o,提升查询速度并缓解数据库压力。1. innodb缓冲池是关键机制,需合理配置其大小(通常为服务器内存的70-80%)及实例数以优化性能;2. 应用层缓存如redis/memcached通过前置缓存逻辑减少对mysql的直接…

    2026年9月21日 • 用户投稿
    000
  • VSCode怎么更改解码方式_VSCode文件编码修改教程

    VSCode通过设置文件编码解决乱码问题,可手动选择“以不同编码重新打开”或“使用编码保存”,推荐统一使用UTF-8编码并启用files.autoGuessEncoding自动检测,避免编码错误。 VSCode更改解码方式主要通过设置文件编码来实现,以便正确显示文件内容。通常情况下,VSCode会自…

    2026年9月21日
    800
  • 如何用Animoto制作AI营销视频?快速生成商业AI视频的教程

    如何用Animoto制作AI营销视频?快速生成商业AI视频的教程如何用Animoto制作AI营销视频?快速生成商业AI视频的教程如何用Animoto制作AI营销视频?快速生成商业AI视频的教程如何用Animoto制作AI营销视频?快速生成商业AI视频的教程

    Animoto通过模板与拖放功能,结合AI生成的文案和配音,帮助用户快速制作品牌统一、节奏合理、带明确CTA的高效营销视频,适用于多平台推广。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ Animoto是一个非常适合快速制作AI营销视频的…

    2026年9月21日 • 用户投稿
    000
  • 如何在MindSpore中训练AI大模型?华为AI框架的训练教程

    如何在MindSpore中训练AI大模型?华为AI框架的训练教程如何在MindSpore中训练AI大模型?华为AI框架的训练教程如何在MindSpore中训练AI大模型?华为AI框架的训练教程如何在MindSpore中训练AI大模型?华为AI框架的训练教程

    答案:MindSpore通过自动并行、混合精度、优化器状态分片等技术,结合Profiler工具调试性能瓶颈,实现大模型高效分布式训练。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 在MindSpore中训练AI大模型,核心在于巧妙地利用其…

    2026年9月21日 • 用户投稿
    300
  • 如何使用Ribbet的AI功能裁剪图片?快速实现精准图像裁剪

    答案:Ribbet的AI裁剪功能可快速智能识别主体并推荐裁剪方案,支持手动微调与多种比例选择,结合亮度、色彩等编辑工具优化效果,适用于制作符合社交媒体尺寸要求的封面图,操作简便且大部分功能免费,适合追求效率的普通用户。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepS…

    2026年9月21日
    400
  • 如何用PyTorch训练AI大模型?构建高效神经网络的完整教程

    如何用PyTorch训练AI大模型?构建高效神经网络的完整教程如何用PyTorch训练AI大模型?构建高效神经网络的完整教程如何用PyTorch训练AI大模型?构建高效神经网络的完整教程如何用PyTorch训练AI大模型?构建高效神经网络的完整教程

    PyTorch大模型训练需综合运用分布式训练、内存优化与高效计算策略。首先采用DistributedDataParallel实现多GPU并行,配合DistributedSampler确保数据均衡;通过混合精度训练、梯度累积和激活检查点缓解显存压力;使用torch.compile优化模型计算效率;选择…

    2026年9月21日 • 用户投稿
    100
  • 怎么全选VSCode多个光标_VSCode多光标操作与批量选择文本教程

    VSCode中高效创建多光标的方法包括:Alt+Click手动添加光标,适用于不规则位置;Ctrl+Alt+方向键垂直添加光标,适合连续多行操作;Ctrl+D逐个选择匹配项,精准控制选择范围;Ctrl+Shift+L一次性选择所有匹配项,实现全局批量修改。结合查找替换和列选择模式可进一步提升编辑效率…

    2026年9月21日
    100
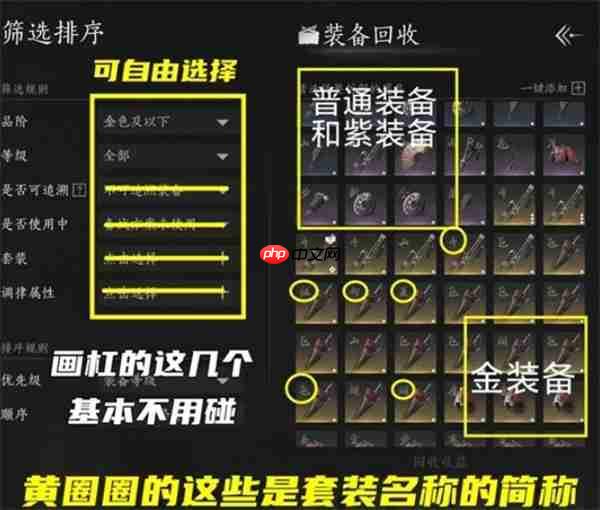
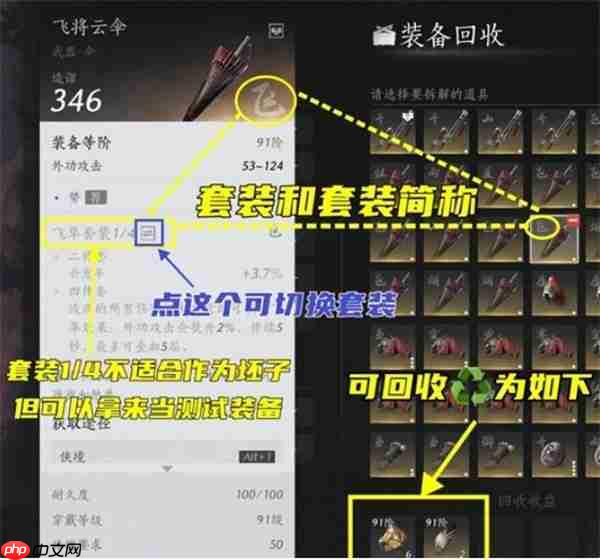
  • 燕云十六声装备回收转流派技巧分享

    燕云十六声装备回收转流派技巧分享燕云十六声装备回收转流派技巧分享燕云十六声装备回收转流派技巧分享燕云十六声装备回收转流派技巧分享

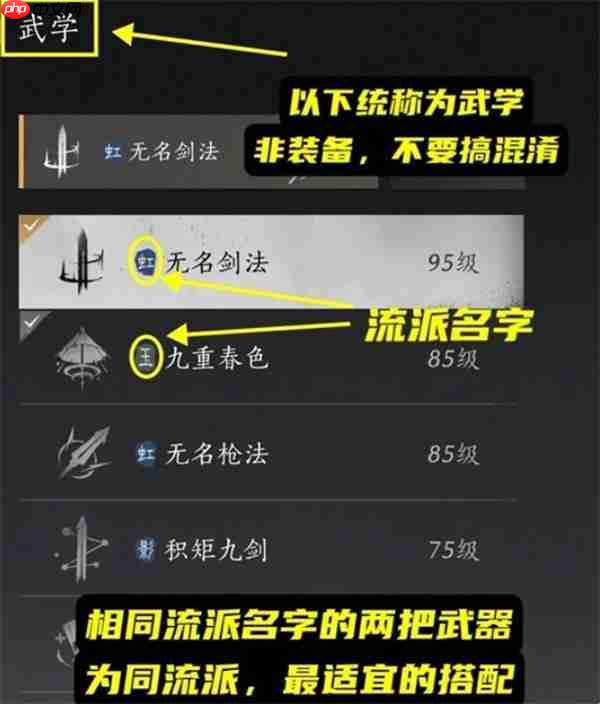
    燕云十六声中,装备是角色变强的关键所在!武器、防具、饰品各具特色,品质更是分为绿、蓝、紫、金四个等级。想要高效提升战力、不浪费培养资源?那就必须掌握装备回收技巧与流派转换策略。具体怎么操作?继续往下看,实用攻略全解析助你轻松上手! 燕云十六声装备回收与转流派技巧指南 一、装备和武学的区别要分清 新手…

    2026年9月21日 • 用户投稿
    200
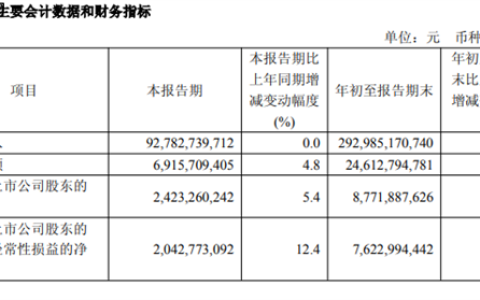
  • 中国联通:前三季度营收2929亿 净利润同比增长5.2%

    10月22日,中国联通发布2025年第三季度业绩报告,披露前三季度公司实现营业收入2929.85亿元,同比增长1.0%;归属于母公司股东的净利润达到87.72亿元,较去年同期增长5.2%。 单季度数据显示,第三季度公司营收为927.83亿元,与上年同期持平;净利润为24.23亿元,同比增长5.4%。…

    2026年9月21日
    000
  • 如何用SumoPaint的AI裁剪图片?快速完成智能图片裁剪教程

    如何用SumoPaint的AI裁剪图片?快速完成智能图片裁剪教程如何用SumoPaint的AI裁剪图片?快速完成智能图片裁剪教程如何用SumoPaint的AI裁剪图片?快速完成智能图片裁剪教程如何用SumoPaint的AI裁剪图片?快速完成智能图片裁剪教程

    答案:SumoPaint虽无AI裁剪功能,但可通过魔棒、套索工具精确选区,结合图层蒙版与羽化、反选等操作实现智能裁剪效果,最后按需导出PNG或JPG高质量文件。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 在SumoPaint中,虽然它不…

    2026年9月21日 • 用户投稿
    300
  • 抖音托管商品要钱吗?新人适合橱窗托管吗

    随着抖音平台影响力的不断扩大,越来越多的商家将其视为拓展线上业务的重要渠道。其中,抖音托管商品作为一种新兴推广方式,逐渐受到商家关注。然而,关于“抖音托管商品是否收费”这一问题,仍存在诸多疑问。本文将围绕这一话题展开分析,帮助商家更好地了解相关机制。 一、抖音托管商品概述 抖音托管商品是指商家将商品…

    2026年9月21日
    100
  • MySQL的binlog格式有哪些类型_它们有什么区别和影响?

    MySQL的binlog格式有哪些类型_它们有什么区别和影响?MySQL的binlog格式有哪些类型_它们有什么区别和影响?MySQL的binlog格式有哪些类型_它们有什么区别和影响?MySQL的binlog格式有哪些类型_它们有什么区别和影响?

    mysql的binlog有三种格式:statement-based(sbl)、row-based(rbl)和mixed-based(mbl),它们分别记录sql语句、行变更和智能混合方式。1. sbl记录执行的sql,优点是日志小、可读性强,但存在不确定性导致主从不一致;2. rbl记录每行的具体变…

    2026年9月21日 • 用户投稿
    400
  • 怎么弄微信公众号_微信公众号注册与功能配置教程

    怎么弄微信公众号_微信公众号注册与功能配置教程怎么弄微信公众号_微信公众号注册与功能配置教程怎么弄微信公众号_微信公众号注册与功能配置教程怎么弄微信公众号_微信公众号注册与功能配置教程

    答案:注册微信公众号需先确定账号类型,订阅号适合内容发布,服务号侧重功能服务,个人注册仅能选订阅号,企业可选服务号并需认证;注册后需配置自定义菜单、自动回复和欢迎语以提升用户体验。 微信公众号的注册与功能配置,说到底,就是把你的内容或服务,通过微信这个巨大的平台,有效地触达目标用户。这过程不复杂,但…

    2026年9月21日 • 用户投稿
    200
  • 如何在Java中理解Java I/O与NIO机制

    传统I/O是阻塞式流模型,适用于低并发场景;NIO基于缓冲区与通道,支持非阻塞和多路复用,适合高并发网络应用,核心区别在于线程模型与资源利用率。 Java中的I/O(输入/输出)与NIO(New I/O)是处理数据读写的核心机制,理解它们的区别和使用场景对开发高性能应用至关重要。传统I/O基于流模型…

    2026年9月21日
    100
  • 如何限制Linux用户cron任务 /etc/cron.deny使用技巧

    如何限制Linux用户cron任务 /etc/cron.deny使用技巧如何限制Linux用户cron任务 /etc/cron.deny使用技巧如何限制Linux用户cron任务 /etc/cron.deny使用技巧如何限制Linux用户cron任务 /etc/cron.deny使用技巧

    要限制linux用户执行cron任务,可编辑/etc/cron.deny文件,每行添加一个需禁止的用户名,保存后立即生效;若需更细粒度控制,可使用pam_time模块;此外,还可通过sudoers文件、chroot环境、linux capabilities、apparmor或selinux等方法限制…

    2026年9月21日 • 用户投稿
    200
  • Linux目录结构学习常见问题汇总

    Linux目录结构学习常见问题汇总Linux目录结构学习常见问题汇总Linux目录结构学习常见问题汇总Linux目录结构学习常见问题汇总

    Linux只有一个根目录,所有设备挂载于此,形成统一树状结构。根目录下各路径分工明确:/bin和/sbin分别存放用户与管理员命令;/etc集中配置文件;/home为用户家目录;/var存储日志等动态数据;/tmp用于临时文件;/usr存放系统程序,/usr/local供手动安装软件;/dev包含设…

    2026年9月21日 • 用户投稿
    200
  • 有趣的操作系统:文件IO和网络IO

    一、从i/o开始 在学习和使用计算机的过程中,i/o(输入/输出)是不可避免的一个概念,指的是操作、程序或设备与计算机之间发生的数据传输过程。 对于计算机来说,I/O操作和计算处理是其两大核心任务,其中大部分时间都用于执行I/O操作。I/O操作包括硬件和软件两部分,即I/O设备和I/O子系统。 I/…

    2026年9月21日
    100
  • Java Stream 高效分组计数并获取Top N元素

    本文深入探讨了如何利用java stream api对数据进行高效的分组计数,并从中提取出现频率最高的top n元素。文章首先介绍了一种简洁的基于全排序的实现方式,该方法适用于数据集较小或top n值接近总数的情况。随后,针对大数据量和小型top n场景下的性能瓶颈,文章详细阐述了如何通过自定义`c…

    2026年9月21日
    100
  • 如何在Java中使用接口实现多继承效果

    Java不支持多继承,但可通过实现多个接口模拟该效果。类可同时实现Flyable、Swimmable等接口,具备多种行为能力,并能利用默认方法复用逻辑,如Loggable提供日志功能。当多个接口含同名默认方法时,需在类中显式重写以解决冲突。接口用于定义“能做什么”,抽象类描述“是什么”,因类只能单继…

    2026年9月21日
    200

发表回复

登录后才能评论
关注微信