Python怎么处理pandas中的缺失值(NaN)_pandas缺失值NaN的处理策略

答案:处理Pandas缺失值需先识别再决策,常用df.isnull().sum()统计缺失,根据占比选择删除或填充;少量缺失可删,多则填充,数值型用均值、中位数,类别型用众数,时间序列适用前向/后向填充,也可插值或设特定值,需权衡数据完整性与信息损失。
python怎么处理pandas中的缺失值(nan)_pandas缺失值nan的处理策略

在Python中使用pandas处理缺失值(NaN),核心策略是先识别缺失值的位置和数量,然后根据数据的特性、缺失值的占比以及分析目标,选择合适的填充(Imputation)方法或直接删除(Dropping)含有缺失值的行或列。这并非一刀切的选择,而是在数据完整性与信息损失之间寻求最佳平衡。

解决方案

在Pandas中处理缺失值,核心思想无非是先找到它们,再根据业务场景和数据特性决定如何“修补”或“移除”。我通常的做法是,先快速审视缺失值的分布和数量,这决定了我后续的策略。

首先,识别是关键。

df.isnull().sum()

几乎是我每次数据探索的起点,它能迅速告诉我哪些列有缺失值,有多少。如果缺失值很少,比如占总数据的不到1%,我可能会倾向于直接删除这些行,或者用一个简单的统计量(如均值或中位数)来填充,因为这点缺失对整体影响不大。但如果缺失值很多,比如某个列有超过50%的缺失,那这个列的价值就得重新评估了,是直接删除列,还是尝试更复杂的填充方法?

填充策略多种多样。最常见的是用均值(mean)、中位数(median)或众数(mode)来填充。对于数值型数据,均值和中位数是首选。如果数据分布偏斜严重,中位数往往比均值更稳健。众数则常用于类别型数据,或者当数值型数据存在明显峰值时。

df['column'].fillna(df['column'].mean())

这样的代码简洁高效。

立即学习“Python免费学习笔记(深入)”;

另一种非常实用的填充方式是前向填充(

ffill

)或后向填充(

bfill

。这在时间序列数据中尤其有效,比如股票价格、传感器读数等,缺失值往往可以由前一个或后一个有效值来合理推断。想象一下,如果一个传感器短时间没读数,用前一个读数来补,通常比用整个数据集的平均值要合理得多。

df.fillna(method='ffill')

就能搞定。

当然,直接删除也是一种选择。

df.dropna()

可以删除含有缺失值的行或列。当缺失值数量非常少,或者这些缺失值所在的数据行对分析目标无关紧要时,直接删除是最省事、最安全的做法。但要警惕,如果删除过多,可能会导致数据量锐减,甚至丢失重要的信息和模式。我一般会先复制一份数据再进行删除操作,以防万一。

有时,缺失值本身可能就蕴含着某种信息。比如,一个用户在某个字段没有填写,可能意味着他们没有相关信息,而不是“缺失”了。在这种情况下,我可能会用一个特定的值(如-1或’Unknown’)来填充,甚至为缺失值创建一个新的指示变量。这需要对业务有深入理解,不能一概而论。

如何高效识别Pandas DataFrame中的缺失值?

识别缺失值,是处理它们的第一步,也是最基础的一步。我个人觉得,理解你的数据“哪里不完整”比“如何补齐”更重要,因为这直接影响你后续的决策。Pandas提供了非常直观且高效的方法来定位这些

NaN

最常用的莫过于

df.isnull()

df.isna()

。这两个函数是等价的,都会返回一个布尔型的DataFrame,其中

True

表示缺失,

False

表示非缺失。这就像给你的数据拍了一张“缺失值地图”。

但光有地图还不够,我们还需要知道“有多少缺失”。这时,链式调用

.sum()

就显得非常方便了。

df.isnull().sum()

会返回一个Series,显示每列的缺失值数量。我经常会再加一个

.sort_values(ascending=False)

,这样就能一眼看出哪些列是“重灾区”,需要优先处理。

如果你想知道缺失值占总数的比例,可以进一步除以

len(df)

df.isnull().sum() / len(df) * 100

。这能让你对缺失值的严重程度有个量化的认识。有时候,我还会结合

df.info()

来查看非空值的数量,与总行数对比,也能快速发现缺失。

对于更宏观的缺失模式,我会用

df.isnull().any(axis=1)

来找出至少包含一个缺失值的行,或者

df.isnull().all(axis=1)

来找出所有值都缺失的行(这种情况通常意味着数据录入错误或无效记录)。

在某些复杂场景下,比如想可视化缺失值的分布,

missingno

这样的库就派上用场了。它能生成矩阵图、条形图或热力图,直观地展示缺失值的模式,比如它们是否集中在某些行或列,或者某些列的缺失是相互关联的。这能帮助我更好地理解缺失值背后的原因,从而选择更合适的处理策略。识别工作做得越细致,后续处理的盲目性就越小。

Pandas缺失值填充(Imputation)策略的选择与实践

缺失值填充,也就是 Imputation,是数据预处理中一个充满艺术与科学结合的环节。选择哪种填充策略,往往取决于数据本身的性质、缺失值的类型(随机缺失、非随机缺失)以及你的分析目标。我通常会根据经验和一些基本原则来做判断。

对于数值型数据,最常见的填充方式是使用统计量:

均值(

mean

)填充

df['column'].fillna(df['column'].mean())

。这是最简单直接的方法,适用于数据分布近似正态,且缺失值是随机分布的情况。但它的缺点是容易受到异常值的影响,并且会降低数据的方差,可能导致模型低估变量的真实波动性。我一般在缺失值占比较小(比如低于5%)时会考虑,因为它引入的偏差相对可控。中位数(

median

)填充

df['column'].fillna(df['column'].median())

。当数据分布偏斜(skewed)严重,或者存在较多异常值时,中位数是比均值更稳健的选择。它不会被极端值拉偏,更能代表数据的“中心趋势”。我个人更倾向于在有疑虑时使用中位数,因为它对数据分布的假设更少。众数(

mode

)填充

df['column'].fillna(df['column'].mode()[0])

。虽然众数主要用于类别型数据,但对于数值型数据,如果存在明显的峰值(比如年龄数据中很多人都是某个特定年龄),也可以考虑。注意

mode()

可能返回多个众数,所以通常需要取第一个

[0]

对于时间序列或有序数据前向填充(

ffill

)和后向填充(

bfill

是极其有用的:

ffill

(forward fill)

df.fillna(method='ffill')

。用前一个有效值来填充。这在股票价格、传感器读数等场景下非常合理,因为当前时刻的值往往与前一时刻紧密相关。

bfill

(backward fill)

df.fillna(method='bfill')

。用后一个有效值来填充。与

ffill

类似,但在某些情况下(比如预测未来事件,但当前数据缺失时,用未来的信息来补可能更合理,虽然这在严格的时间序列预测中要小心使用)。我经常会先尝试

ffill

,因为这更符合“历史决定现在”的直觉。

除了这些,还有:

常数填充

df['column'].fillna(0)

df['column'].fillna('未知')

。当缺失值本身就代表着某种特定含义时(比如0表示“无此项”,’未知’表示“信息缺失”),这种方法很直接。插值(

interpolate

df['column'].interpolate()

。这是一种更复杂的填充方法,它会根据缺失值前后的数据点,通过线性、多项式、样条等算法来估算缺失值。这在时间序列数据中尤其强大,能够生成更平滑、更合理的填充值。我会在对数据变化趋势比较敏感的场景下使用,比如需要保持数据的连续性。

在实践中,我很少只用一种方法。通常我会对不同的列采用不同的策略,甚至会结合多种方法。比如,日期时间列用

ffill

,数值列用

median

,类别列用

mode

。更重要的是,填充后一定要重新检查数据分布,看看填充操作是否引入了不自然的模式或偏差。

删除还是填充:Pandas处理NaN时的数据完整性考量

当面对

NaN

时,是选择“忍痛割爱”地删除,还是“巧手修补”地填充,这真的是一个需要深思熟虑的问题。这不仅仅是技术操作的选择,更关乎你的数据完整性、分析的可靠性以及最终模型的性能。我个人认为,没有绝对的对错,只有在特定上下文中最优的权衡。

何时考虑删除(

dropna

)?

缺失值占比极小:如果某个列或某几行的缺失值只占总数据的非常小的比例(比如1%或2%),那么直接删除这些行或列,对整体数据量的影响微乎其微,同时也能避免填充可能引入的偏差。这是最省心且通常安全的做法。关键信息缺失:如果缺失值出现在对你的分析或模型至关重要的核心变量上,且无法合理推断或填充,那么保留这些缺失数据可能会导致错误的结论。比如,预测用户购买行为,如果核心的“购买金额”字段缺失,填充可能比删除更具误导性。数据量足够大:当你的数据集本身就非常庞大时,即使删除一部分含有缺失值的行,剩下的数据量也足以支撑后续的分析和建模,那么删除的风险就相对较低。缺失值无规律且数量不多:如果缺失值是完全随机的,且数量不多,删除可以避免对数据分布造成人为的改变。

df.dropna(axis=0, how='any')

会删除任何含有缺失值的行,而

df.dropna(axis=1, how='any')

则会删除任何含有缺失值的列。

how='all'

则只删除所有值都缺失的行或列。

thresh

参数也很有用,比如

df.dropna(thresh=3)

会保留至少有3个非NaN值的行。我通常会先用

how='any'

看看会丢失多少数据,如果丢失超过10%-20%,我就会开始考虑填充了。

何时倾向于填充(

fillna

)?

缺失值占比较大:如果直接删除会导致大量数据丢失,从而影响分析的代表性或模型的泛化能力,那么填充是更好的选择。**缺失

以上就是Python怎么处理pandas中的缺失值(NaN)_pandas缺失值NaN的处理策略的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1372001.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
python中如何使用numpy创建数组_Numpy创建数组(array)基础教程
上一篇 2025年12月14日 11:56:59
Conda环境创建中Python版本指定错误及解决方案:理解=与==的区别
下一篇 2025年12月14日 11:57:09

相关推荐

  • win11如何使用存储空间(storage spaces)功能_Win11存储空间(Storage Spaces)使用方法

    可使用Windows 11内置“存储空间”功能整合多块硬盘以提升安全性与效率。2. 创建存储池需清空选中硬盘数据,并设置名称、驱动器号、文件系统及布局类型。3. 布局类型包括简单(无冗余)、双向镜像(容错一块盘)、三向镜像(容错两块盘)和奇偶校验(高利用率低性能)。4. 可通过添加驱动器扩展存储池容…

    2026年9月20日
    000
  • VSCode有哪些必备的插件?

    EditorConfig for VS Code统一代码风格,2. Prettier自动格式化多语言代码,3. ESLint检查JS/TS错误并集成Prettier,4. GitLens增强Git可视化,5. Path Intellisense补全文件路径,6. 括号高亮提升嵌套识别,7. Auto…

    2026年9月20日
    1000
  • ChatGPT代码会出错吗_AI编程中5个常见错误及解决方法

    AI编程中常见错误包括语法不匹配、逻辑遗漏、API误用、安全漏洞和集成困难,需通过版本明确、测试验证、文档核对、安全扫描和上下文补充等方式解决,结合人工审查与测试才能确保代码质量。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ ChatGP…

    2026年9月20日
    100
  • RBAC(基于角色的权限控制)实现方案

    rbac重要,因为它通过角色管理权限,简化了权限管理,提高了系统安全和管理效率。实现rbac时:1.设计数据库结构,定义用户、角色、权限表及中间表;2.在代码中实现权限检查和角色、权限的动态管理;3.优化性能,防止权限泄露,管理角色膨胀。 在探讨RBAC(基于角色的权限控制)实现方案之前,让我们先来…

    2026年9月20日
    000
  • VSCode的扩展推荐是怎么工作的?

    VSCode的扩展推荐基于用户行为和项目环境智能生成,当你打开.py文件时会推荐Python相关工具,打开.ts、.vue等文件则触发对应语言插件;系统通过分析package.json、requirements.txt等依赖文件识别技术栈,推荐Docker、ESLint等匹配扩展;同时记录常用操作如…

    2026年9月20日
    000
  • 安全优雅地关闭Tomcat Embedded (无Spring环境)

    本文旨在提供一种在没有Spring框架的情况下,安全优雅地关闭Tomcat Embedded服务器的方法。通过手动管理Servlet生命周期和Tomcat实例,确保资源得到正确释放,避免数据丢失或连接中断,保证服务器的平稳关闭。 在嵌入式Tomcat应用中,优雅地关闭服务器至关重要,尤其是在生产环境…

    2026年9月20日
    100
  • 当VSCode启动或运行变慢时,有哪些系统性的排查和优化步骤?

    答案:VSCode变慢主要由扩展、文件监控和设置引起。先以安全模式启动排查扩展影响,使用内置性能工具分析启动耗时,优化工作区的文件监听与搜索范围,调整渲染设置并清理缓存,可显著提升运行效率。 VSCode 启动或运行变慢通常涉及扩展、设置、系统资源或文件索引等问题。以下是系统性的排查与优化步骤,帮助…

    2026年9月20日
    000
  • 如何在Linux中自动重启 Linux systemd自动恢复

    答案:通过配置systemd服务文件中的Restart、RestartSec、WatchdogSec及StartLimitInterval等参数,可实现Linux服务的自动重启与看门狗监控,并避免无限重启循环,提升系统稳定性。 在Linux中,可以通过systemd来实现服务的自动重启,确保服务在崩…

    2026年9月20日
    000
  • VSCode的侧边栏图标代表什么?

    资源管理器(文件夹图标)用于管理项目文件结构,支持新建、重命名、删除和拖拽操作;2. 搜索(放大镜图标)实现全局文本查找与替换,支持正则表达式及范围筛选;3. 源代码管理(分支图标)集成Git功能,可查看变更、提交代码并同步远程仓库;4. 运行和调试(虫子图标)支持断点调试、变量监控及多语言启动配置…

    2026年9月20日
    000
  • 漏洞复现 | DirtyPipe CVE-2022-0847 Linux 内核提权漏洞复现

    漏洞复现 | DirtyPipe CVE-2022-0847 Linux 内核提权漏洞复现漏洞复现 | DirtyPipe CVE-2022-0847 Linux 内核提权漏洞复现漏洞复现 | DirtyPipe CVE-2022-0847 Linux 内核提权漏洞复现漏洞复现 | DirtyPipe CVE-2022-0847 Linux 内核提权漏洞复现

    0x00 前言 CVSS 评分:7.8 影响范围:5.8 通过 CVE-2022-0847,RT 可以覆盖重写任意可读文件中的数据,从而将普通权限的用户提升到特权 root 级别。 这个漏洞被作者命名为 Dirty Pipe,之所以这样命名,是因为其原理与 Dirty Cow 相似,但 Dirty …

    2026年9月20日 用户投稿
    000
  • Linux如何将进程放入后台运行

    将Linux进程放入后台运行主要有四种方法:使用&符号在启动时放入后台;通过Ctrl+Z暂停后用bg继续运行;结合nohup与&防止会话关闭导致终止;使用screen或tm…

    2026年9月20日
    000
  • 日志审计与异常行为监控

    有效进行日志审计与异常行为监控需从多个角度结合技术和策略:1.确保日志的完整性和不可篡改性;2.收集和集中管理日志;3.分析和可视化日志;4.建立正常行为基线;5.使用异常检测算法识别偏离行为。通过这些步骤,可以提升系统安全性并提供诊断信息。 在现代的网络安全和系统管理领域中,日志审计与异常行为监控…

    2026年9月20日
    000
  • 模型(Model)的定义与数据库操作基础

    模型是软件架构中的一个概念,代表数据及其相关的业务逻辑。1) 模型通过继承类定义,如django中的book模型。2) 模型提供crud操作,如创建、读取、更新和删除book对象。3) 模型封装业务逻辑和数据验证,需考虑性能和迁移管理。4) 测试模型行为和数据库操作是关键,设计模型时需平衡当前需求和…

    2026年9月20日
    000
  • VSCode的终端集成有哪些技巧?

    掌握VSCode终端技巧可提升开发效率。1. 用Ctrl+`快速打开终端,支持多实例创建与重命名;2. 在设置中自定义默认shell如zsh或Git Bash;3. 优化字体、启用自动换行与智能复制;4. 终端联动编辑器实现一键运行、路径拖拽补全与点击跳转。 VSCode的终端集成非常实用,合理使用…

    2026年9月20日
    000
  • Python中print函数使用详解

    Python中print函数使用详解Python中print函数使用详解Python中print函数使用详解Python中print函数使用详解

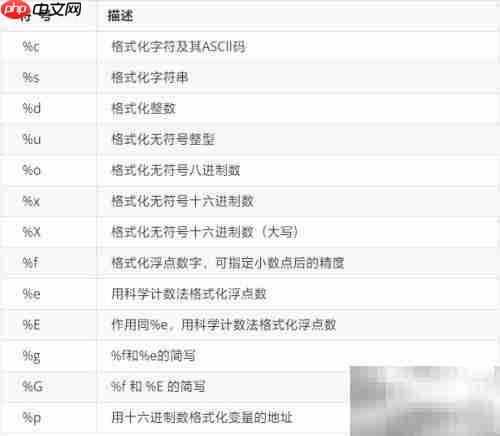
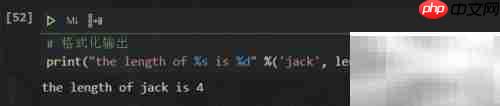
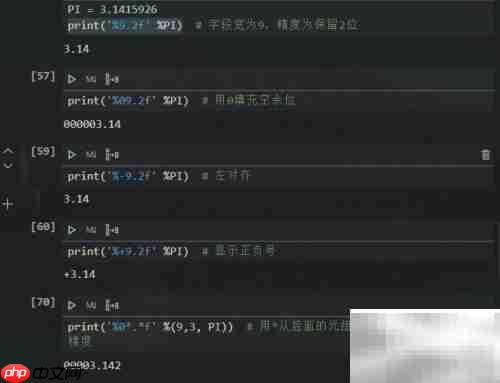
    1、 输出常见数据类型如字符串与整数 2、 对输出结果进行格式化处理 立即学习“Python免费学习笔记(深入)”; 3、 实现浮点数的格式化输出 4、 关闭自动换行功能 以上就是Python中print函数使用详解的详细内容,更多请关注创想鸟其它相关文章!

    2026年9月20日 用户投稿
    200
  • 如何为VSCode配置远程开发环境?

    使用Remote-SSH插件可在VSCode实现远程开发,首先安装插件并配置SSH主机信息,确保本地与远程连接通畅;随后通过远程资源管理器连接目标服务器,VSCode将自动部署服务端组件;连接成功后即可在本地编辑远程代码,需保证远程环境有基础开发工具及足够权限;若遇问题,检查SSH服务、配置准确性、…

    2026年9月20日
    100
  • 怎样在VSCode中为不同文件类型设置不同的缩进?

    在VSCode中可为不同文件类型设置缩进,通过settings.json按语言ID配置,如Python用4空格、HTML用2空格,保存后自动生效并覆盖全局设置。 在 VSCode 中为不同文件类型设置不同的缩进,可以通过配置语言特定的设置来实现。VSCode 支持按语言 ID 覆盖编辑器的缩进行为,…

    2026年9月20日
    100
  • VSCode的悬浮提示信息如何自定义?

    通过JSDoc或docstring添加注释可直接影响VSCode悬浮提示内容,如JavaScript/TypeScript中使用/* /格式、Python中使用三引号文档字符串,配合Pylance等扩展增强显示;安装语言支持扩展可提升提示丰富度;高级场景可通过开发自定义语言服务器,在textDocu…

    2026年9月20日
    500
  • 怎样在VSCode中重命名变量或文件?

    使用F2键可快速重命名变量或文件,VSCode会自动更新符号引用,支持多语言,重命名文件时需注意导入路径可能需手动调整。 在 VSCode 中重命名变量或文件非常方便,可以通过内置的重构功能快速完成,同时保持代码的一致性。 重命名变量(符号重命名) 当你想重命名代码中的变量、函数或类时,VSCode…

    2026年9月20日
    000
  • Linux系统目录bin的作用说明

    /bin 目录存放系统最基础的可执行命令,如 ls、cp、mv、rm、bash 等,是系统启动和单用户模式下运行所必需的核心二进制程序。 /bin 目录在 Linux 系统中存放的是系统最基础、最关键的可执行命令文件,也就是二进制程序(binary executables)。这些命令是系统启动和运行…

    2026年9月20日
    000

发表回复

登录后才能评论
关注微信