Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
如何使用Pandas高效更新SQL表中的数据_创想鸟

如何使用Pandas高效更新SQL表中的数据

如何使用pandas高效更新sql表中的数据

本文详细介绍了两种使用Pandas更新SQL数据库表中指定列数据的方法。首先,探讨了基于游标的逐行更新方法,适用于小规模数据更新,并提供了PyODBC示例。其次,针对大规模数据集,介绍了利用Pandas的to_sql功能结合临时表进行批量更新的策略,该方法通过SQLAlchemy实现,显著提升了更新效率,并提供了详细的代码示例和注意事项,旨在帮助读者根据具体场景选择最优的数据更新方案。

1. 引言

在数据分析和处理过程中,我们经常需要从SQL数据库中读取数据到Pandas DataFrame进行处理,然后将修改后的数据写回数据库。当需要更新数据库表中特定列的值时,尤其是在处理大量数据时,选择一个高效且稳健的方法至关重要。本文将介绍两种主要的策略来解决这个问题:逐行更新和批量更新。

2. 逐行更新方法 (PyODBC)

对于需要更新的数据量较小,或者更新逻辑较为复杂,需要精确控制每一行更新的情况,可以采用基于游标的逐行更新方法。这种方法直接通过SQL UPDATE语句针对每一行进行操作。

2.1 核心思路

连接到数据库。从目标SQL表中读取数据到Pandas DataFrame。在DataFrame中对目标列进行修改,生成新的值。遍历DataFrame的每一行,针对每一行执行一个UPDATE SQL查询,根据主键匹配并更新对应列的值。提交事务并关闭数据库连接。

2.2 代码示例

以下是一个使用pyodbc库实现逐行更新的示例:

import pandas as pdimport pyodbc as odbc# 数据库连接字符串,请根据实际情况替换# 例如:'DRIVER={ODBC Driver 17 for SQL Server};SERVER=your_server;DATABASE=your_database;UID=your_user;PWD=your_password'connection_string = "" sql_conn = odbc.connect(connection_string)try:    # 1. 从数据库读取数据到DataFrame    query = "SELECT * FROM myTable"    df = pd.read_sql(query, sql_conn)    # 2. 在DataFrame中更新数据    # 假设有一个新的值列表,长度与DataFrame行数相同    my_new_value_list = [11, 12, 13, 14, 15, 16, 17, 18, 19, 20] # 示例数据,实际应根据df行数生成    # 确保新值列表的长度与DataFrame的行数匹配    if len(my_new_value_list) != len(df):        raise ValueError("新值列表的长度必须与DataFrame的行数相同。")    # 将新值赋给DataFrame的指定列    # 请将 'myColumn' 替换为你要更新的实际列名    # 请将 'newColumnValues' 替换为你在DataFrame中存储新值的临时列名    df['myColumn'] = my_new_value_list     # 3. 准备SQL UPDATE语句    # 重要的:需要一个主键列来唯一标识每一行进行更新    # 请将 '' 替换为你的表的主键列名    update_sql = "UPDATE myTable SET myColumn = ? WHERE  = ?"    # 4. 遍历DataFrame并执行逐行更新    cursor = sql_conn.cursor()    for index, row in df.iterrows():        # 执行UPDATE语句,第一个问号对应 myColumn 的新值,第二个问号对应主键值        cursor.execute(update_sql, (row['myColumn'], row['']))    # 5. 提交事务,使更改永久生效    sql_conn.commit()    print(f"成功更新 {len(df)} 行数据。")except Exception as e:    print(f"更新过程中发生错误: {e}")    # 发生错误时回滚事务    sql_conn.rollback()finally:    # 6. 关闭游标和数据库连接    if 'cursor' in locals() and cursor:        cursor.close()    if sql_conn:        sql_conn.close()

2.3 注意事项

主键的重要性: 逐行更新必须依赖一个或多个主键列来唯一标识要更新的行。如果表中没有主键,更新可能会导致意外结果(例如,更新所有匹配特定条件的行)。性能瓶颈: 对于包含数十万甚至数百万行的大型数据集,这种逐行执行UPDATE语句的方法效率极低,因为它涉及大量的数据库往返通信和事务开销。错误处理: 建议在实际应用中加入try…except…finally块来处理可能发生的数据库错误,并确保在任何情况下都能关闭连接。

3. 批量更新方法 (Pandas to_sql 结合临时表)

当处理大规模数据集时,逐行更新的性能问题会变得非常突出。更高效的方法是利用数据库的批量操作能力。Pandas的to_sql方法虽然主要用于插入新数据,但可以结合数据库的特性实现批量更新。

3.1 核心思路

连接到数据库,建议使用SQLAlchemy引擎,因为它提供了更强大的to_sql功能。从目标SQL表中读取数据到Pandas DataFrame。在DataFrame中对目标列进行修改,生成新的值。将修改后的整个DataFrame写入数据库的一个临时表。执行一个SQL UPDATE…JOIN语句,将原表与临时表连接起来,并根据连接条件(通常是主键)批量更新原表的数据。删除临时表。提交事务并关闭数据库连接。

3.2 代码示例

以下是一个使用SQLAlchemy和pyodbc结合实现批量更新的示例:

import pandas as pdimport pyodbc as odbcfrom sqlalchemy import create_engine, text# 数据库连接字符串,请根据实际情况替换# 对于SQL Server,示例:'mssql+pyodbc://user:password@server/database?driver=ODBC+Driver+17+for+SQL+Server'# 注意:SQLAlchemy的连接字符串格式与pyodbc略有不同sqlalchemy_connection_string = 'mssql+pyodbc://'engine = create_engine(sqlalchemy_connection_string)# 也可以保留pyodbc连接用于read_sql(如果read_sql_table更方便则不需要)# pyodbc_connection_string = ""# sql_conn = odbc.connect(pyodbc_connection_string)try:    # 1. 从数据库读取数据到DataFrame    # 使用engine来读取,可以避免额外的pyodbc连接    query = "SELECT * FROM myTable"    df = pd.read_sql(query, engine)    # 2. 在DataFrame中更新数据    my_new_value_list = [11, 12, 13, 14, 15, 16, 17, 18, 19, 20] # 示例数据    if len(my_new_value_list) != len(df):        raise ValueError("新值列表的长度必须与DataFrame的行数相同。")    # 假设要更新的列是 'myColumn'    df['myColumn'] = my_new_value_list    # 确保DataFrame中包含主键列,以便后续JOIN操作    # 假设主键列为 'id'    # df['id'] = df['id_from_db_table'] # 如果原始DataFrame中没有,需要添加    # 3. 将修改后的DataFrame写入临时表    temp_table_name = 'temp_myTable_update' # 临时表名    # if_exists='replace' 会在每次运行时覆盖或创建新表    df.to_sql(temp_table_name, engine, if_exists='replace', index=False)    print(f"DataFrame已成功写入临时表 '{temp_table_name}'。")    # 4. 执行SQL UPDATE...JOIN语句进行批量更新    with engine.connect() as conn:        # 重要的:请将 'myColumn' 替换为你要更新的实际列名        # 请将 'id' 替换为你的表的主键列名        update_query = text(f"""        UPDATE myTable        SET myColumn = temp.myColumn -- 使用临时表中的新值        FROM myTable        INNER JOIN {temp_table_name} AS temp        ON myTable.id = temp.id; -- 通过主键进行连接        """)        conn.execute(update_query)        # 5. 删除临时表        drop_temp_table_query = text(f"DROP TABLE {temp_table_name};")        conn.execute(drop_temp_table_query)        # SQLAlchemy的conn.execute会自动提交事务,但显式commit也是好习惯        # conn.commit() # 对于一些数据库和SQLAlchemy版本,可能需要显式提交        print(f"主表 'myTable' 已更新,临时表 '{temp_table_name}' 已删除。")except Exception as e:    print(f"批量更新过程中发生错误: {e}")    # 在发生错误时,可以尝试删除临时表以清理    with engine.connect() as conn:        try:            conn.execute(text(f"DROP TABLE IF EXISTS {temp_table_name};"))            print(f"错误发生后,已尝试删除临时表 '{temp_table_name}'。")        except Exception as cleanup_e:            print(f"清理临时表时发生错误: {cleanup_e}")finally:    # 确保引擎连接被关闭,虽然with语句通常会处理    if engine:        engine.dispose()

3.3 注意事项

SQLAlchemy: to_sql方法通常与SQLAlchemy结合使用,它提供了更丰富的数据库抽象层和连接管理。临时表权限: 创建临时表可能需要数据库用户的特定权限。请确保你的数据库用户拥有CREATE TABLE或类似的权限。主键匹配: UPDATE…JOIN语句的核心是正确的主键匹配。确保你的DataFrame包含主键列,并且在JOIN条件中正确使用它。连接字符串: SQLAlchemy的连接字符串格式与pyodbc略有不同,需要根据你的数据库类型(如mssql+pyodbc、postgresql+psycopg2等)进行调整。事务管理: with engine.connect() as conn: 语句块会自动管理连接的打开和关闭。对于UPDATE和DROP TABLE操作,SQLAlchemy通常会在执行后自动提交事务。清理: 即使在发生错误时,也应尽量确保临时表被删除,以避免数据库中留下垃圾数据。

4. 总结

选择哪种更新方法取决于你的具体需求和数据规模:

逐行更新适用于数据量较小、更新逻辑复杂或需要精细控制每一行更新的场景。它的优点是实现简单直观,但缺点是效率低下。批量更新(临时表结合to_sql)适用于数据量大、需要高效更新的场景。它的优点是性能显著优于逐行更新,利用了数据库的批量处理能力;缺点是实现相对复杂,需要临时表权限,并正确构建UPDATE…JOIN语句。

在实际应用中,建议优先考虑批量更新方法,因为它能更好地应对大数据量带来的性能挑战。始终记得根据你的数据库类型、连接方式和权限配置来调整代码中的连接字符串和SQL语句。

以上就是如何使用Pandas高效更新SQL表中的数据的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1376218.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
使用 Python 和 OpenCV 录制视频教程
上一篇 2025年12月14日 15:43:02
深入理解Python类方法的动态性与比较陷阱
下一篇 2025年12月14日 15:43:18

相关推荐

  • Java布尔方法条件逻辑解析与预期行为校正

    Java布尔方法条件逻辑解析与预期行为校正Java布尔方法条件逻辑解析与预期行为校正Java布尔方法条件逻辑解析与预期行为校正Java布尔方法条件逻辑解析与预期行为校正

    本文旨在探讨Java中布尔方法条件表达式的常见误解,通过一个具体的kindaLiked()方法案例,详细分析代码逻辑与预期行为不符的原因。我们将演示如何精确定义条件,确保方法返回结果与业务逻辑一致,并提供示例代码、调试技巧及最佳实践,以帮助开发者编写更准确、可维护的布尔判断逻辑。 理解布尔方法与条件…

    2026年9月25日 • 用户投稿
    100
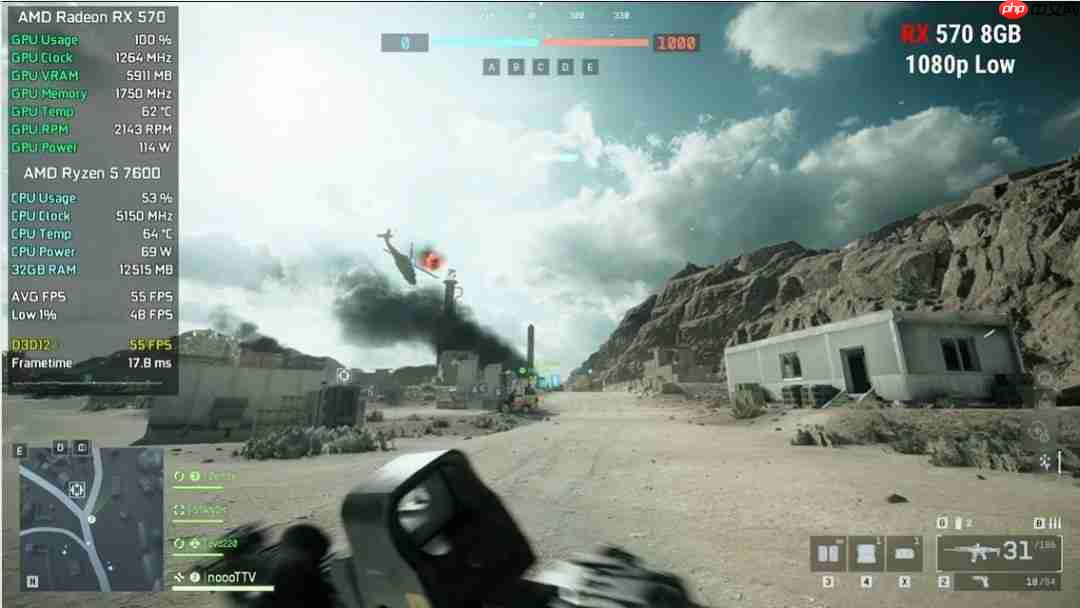
  • 一帧能玩 三帧电竞! 博主测试各主流显卡运行《战地6》帧数

    一帧能玩 三帧电竞! 博主测试各主流显卡运行《战地6》帧数一帧能玩 三帧电竞! 博主测试各主流显卡运行《战地6》帧数一帧能玩 三帧电竞! 博主测试各主流显卡运行《战地6》帧数一帧能玩 三帧电竞! 博主测试各主流显卡运行《战地6》帧数

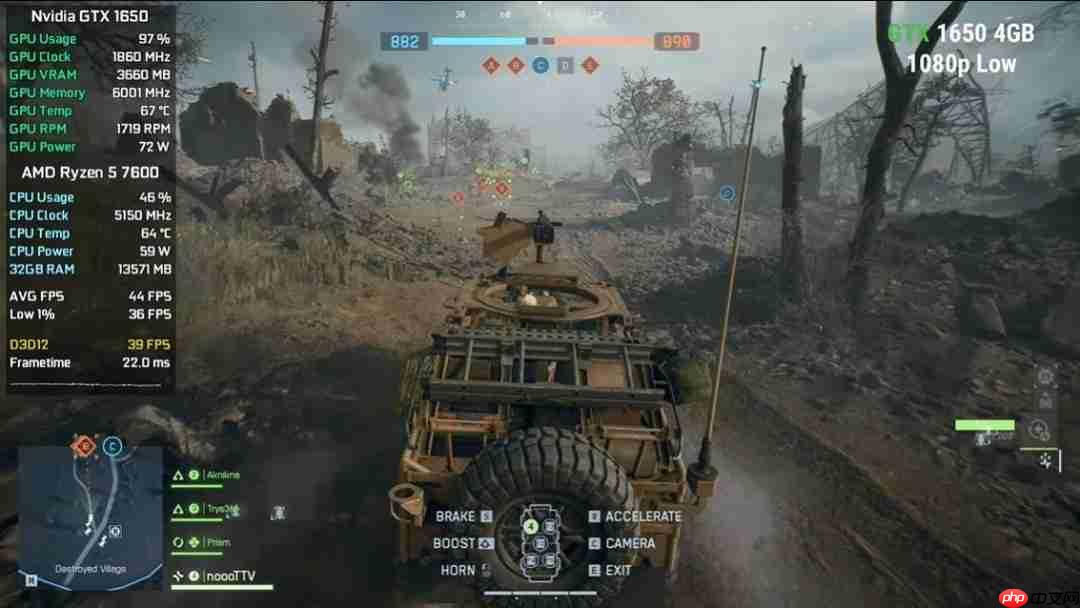
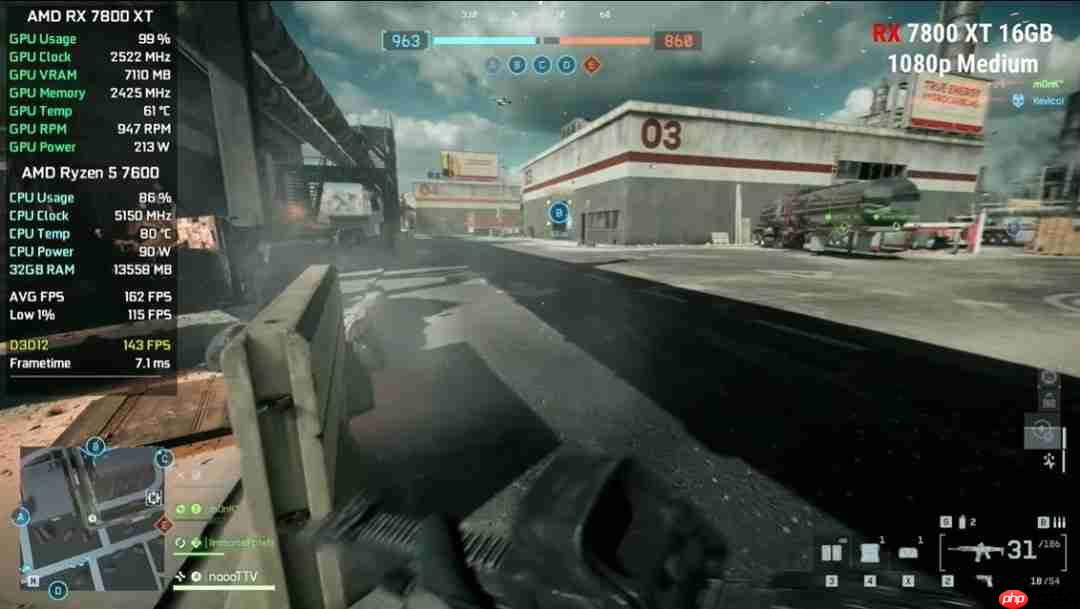
    近日,YouTube频道54 FPS对《战地风云6》在多款主流显卡上的运行表现进行了实测。测试平台搭载了AMD Ryzen 5 7600处理器与32GB内存,确保CPU不会成为性能瓶颈。 测试数据如下: GTX 1650(1080p,低画质)— 平均43帧;GTX 1650(1080p,低画质 + …

    2026年9月25日 • 用户投稿
    100
  • 关闭Win10这三大新功能:系统重回Win7风

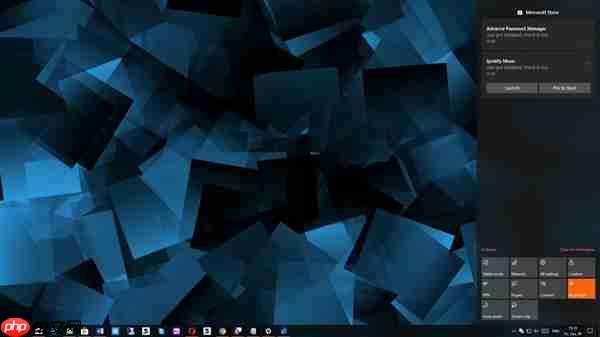
    关闭Win10这三大新功能:系统重回Win7风关闭Win10这三大新功能:系统重回Win7风关闭Win10这三大新功能:系统重回Win7风关闭Win10这三大新功能:系统重回Win7风

    发布超过3年,win10依然未能全面取代win7,反而因各类问题频繁遭到批评。 Softpedia发表文章,指出Win10目前的三项核心功能——Cortana(小娜)、Aciton Centre(操作中心)以及Timeline(时间线),其关闭方式过于繁琐且隐蔽,建议微软提供更加便捷的一键屏蔽选项。…

    2026年9月25日 • 用户投稿
    000
  • 电脑机箱风道设计对散热效率的影响有多大?

    电脑机箱风道设计对散热效率的影响有多大?电脑机箱风道设计对散热效率的影响有多大?电脑机箱风道设计对散热效率的影响有多大?电脑机箱风道设计对散热效率的影响有多大?

    合理的机箱风道设计能有效降低温度,提升硬件稳定性。判断风道是否合理可通过监控软件查看CPU、GPU温度(如满载超80℃或85℃),观察灰尘堆积情况及手触感知风量分布。理想风道为前进风、后排风的水平气流,塔式散热器应朝向后排风扇,高端显卡可加底面进风。理线也关键,杂乱线材会阻碍气流,需用扎带等整理。风…

    2026年9月25日 • 用户投稿
    000
  • 利用OSHI库监测与计算磁盘活动时间及传输速率

    利用OSHI库监测与计算磁盘活动时间及传输速率利用OSHI库监测与计算磁盘活动时间及传输速率利用OSHI库监测与计算磁盘活动时间及传输速率利用OSHI库监测与计算磁盘活动时间及传输速率

    本文详细介绍了如何利用Java OSHI库获取磁盘的活动时间与传输速率。通过HWDiskStore类的getReads()、getWrites()和getTransferTime()方法,结合时间间隔内的增量数据,可以精确计算出磁盘的活跃百分比和每秒传输次数。教程提供了示例代码,并逐步解析了数据采集…

    2026年9月25日 • 用户投稿
    000
  • 如何用豆包AI自动生成单元测试 提升代码质量的AI秘诀

    如何用豆包AI自动生成单元测试 提升代码质量的AI秘诀如何用豆包AI自动生成单元测试 提升代码质量的AI秘诀如何用豆包AI自动生成单元测试 提升代码质量的AI秘诀如何用豆包AI自动生成单元测试 提升代码质量的AI秘诀

    使用豆包ai可以高效生成全面的单元测试代码,首先确保函数或类逻辑清晰稳定,如定义了clean_input函数用于清理用户输入字符串;接着提示ai生成测试用例时描述功能背景,ai将自动覆盖正常值、空值、边界值及异常输入等场景;生成的测试样例包括空字符串、none、前后空格、大写字母、数字符号等情况;随…

    2026年9月25日 • 用户投稿
    100
  • 使用OSHI库精确测量磁盘活动时间和传输速率

    使用OSHI库精确测量磁盘活动时间和传输速率使用OSHI库精确测量磁盘活动时间和传输速率使用OSHI库精确测量磁盘活动时间和传输速率使用OSHI库精确测量磁盘活动时间和传输速率

    本文详细介绍了如何利用OSHI库的HWDiskStore类来精确测量磁盘活动时间百分比和数据传输速率。通过获取磁盘读写操作、总传输时间等累积性统计数据的快照,并计算两次快照之间的差值,可以准确分析特定时间段内的磁盘活跃度及每秒传输次数,从而有效监控系统磁盘性能。 OSHI库与磁盘性能监控 oshi(…

    2026年9月25日 • 用户投稿
    100
  • sublime的拼写检查怎么添加自定义词典_sublime拼写检查自定义词典设置

    sublime的拼写检查怎么添加自定义词典_sublime拼写检查自定义词典设置sublime的拼写检查怎么添加自定义词典_sublime拼写检查自定义词典设置sublime的拼写检查怎么添加自定义词典_sublime拼写检查自定义词典设置sublime的拼写检查怎么添加自定义词典_sublime拼写检查自定义词典设置

    Sublime Text拼写检查可通过用户词汇表自定义,首先启用spell_check并设置dictionary路径,然后右键误报词选“Add to Dictionary”或手动编辑User/Dictionary.sublime-settings添加词汇,也可复制.dic文件到User目录创建专用词…

    2026年9月25日 • 用户投稿
    100
  • Chrome浏览器怎么查看某个插件的资源占用_插件资源占用情况监控技巧

    Chrome浏览器怎么查看某个插件的资源占用_插件资源占用情况监控技巧Chrome浏览器怎么查看某个插件的资源占用_插件资源占用情况监控技巧Chrome浏览器怎么查看某个插件的资源占用_插件资源占用情况监控技巧Chrome浏览器怎么查看某个插件的资源占用_插件资源占用情况监控技巧

    首先使用Shift+Esc打开Chrome任务管理器,查看各扩展程序的CPU和内存占用情况,识别高耗能插件;接着通过chrome://extensions页面禁用或删除异常扩展;最后可启用chrome://flags中的悬停显示内存功能,便于实时监控标签页资源消耗。 如果您发现Chrome浏览器运行…

    2026年9月25日 • 用户投稿
    200
  • VBA使用API_04:创建按钮

    VBA使用API_04:创建按钮VBA使用API_04:创建按钮VBA使用API_04:创建按钮VBA使用API_04:创建按钮

    在创建了窗体的基础上,接下来我们将进一步添加一个按钮来增强程序的交互性。按钮是windows系统中预定义的控件,因此无需额外注册,直接使用createwindowex函数即可。在创建窗体之后、显示窗体之前,我们可以插入代码来创建这个按钮。 按钮的父窗口句柄(hWndParent)应当设置为之前创建的…

    2026年9月24日 • 用户投稿
    200
  • DeepSeek R1T2— TNG推出的改进型AI语言模型,基于DeepSeek

    DeepSeek R1T2— TNG推出的改进型AI语言模型,基于DeepSeekDeepSeek R1T2— TNG推出的改进型AI语言模型,基于DeepSeekDeepSeek R1T2— TNG推出的改进型AI语言模型,基于DeepSeekDeepSeek R1T2— TNG推出的改进型AI语言模型,基于DeepSeek

    deepseek r1t2 是 tng 在 deepseek 原始模型基础上开发的增强型语言模型。该模型采用 tri-mind 架构,融合了 deepseek r1-0528、r1 和 v3-0324 三个基础模型的优势,通过 assembly of experts(aoe)技术整合推理能力、结构化…

    2026年9月24日 • 用户投稿
    1000
  • 微软终止Cortana支持:Windows 10迎来重大调整

    微软终止Cortana支持:Windows 10迎来重大调整微软终止Cortana支持:Windows 10迎来重大调整微软终止Cortana支持:Windows 10迎来重大调整微软终止Cortana支持:Windows 10迎来重大调整

    N软网消息,微软近日宣布,将在Windows 10系统中停止对Cortana的支持。这是继Windows 11中取消Cortana支持之后的进一步动作,微软正将重心转移到Windows Copilot、Microsoft 365 Copilot以及Bing Chat等新技术上。 曾有人预计,微软会在…

    2026年9月24日 • 用户投稿
    100
  • 为什么有些SSD参数漂亮但实际体验却令人失望?

    为什么有些SSD参数漂亮但实际体验却令人失望?为什么有些SSD参数漂亮但实际体验却令人失望?为什么有些SSD参数漂亮但实际体验却令人失望?为什么有些SSD参数漂亮但实际体验却令人失望?

    SSD实际体验不佳的核心在于纸面参数仅反映理想条件下的峰值性能,而真实使用中受主控、闪存类型、SLC缓存耗尽、DRAM缓存缺失、固件优化不足及散热不良等因素影响,导致持续写入速度骤降、系统卡顿等问题。 很多时候,我们看着SSD产品页面上那些漂亮的顺序读写速度,比如几千MB/s,或者惊人的IOPS,心…

    2026年9月24日 • 用户投稿
    100
  • 2025年比较好用的生成图片AI工具前十推荐

    2025年比较好用的生成图片AI工具前十推荐2025年比较好用的生成图片AI工具前十推荐2025年比较好用的生成图片AI工具前十推荐2025年比较好用的生成图片AI工具前十推荐

    2025年AI图片生成工具将更加智能、精准且深度融入创作流程,具备超写实生成、多模态输入、实时交互和3D建模能力,代表工具包括Midjourney、Stable Diffusion、DALL-E 4、Adobe Firefly Max等,未来将朝个性化、多模态融合与实时协作发展,同时面临版权、伦理、…

    2026年9月24日 • 用户投稿
    100
  • 如何通过BIOS设置优化游戏性能与系统稳定性?

    如何通过BIOS设置优化游戏性能与系统稳定性?如何通过BIOS设置优化游戏性能与系统稳定性?如何通过BIOS设置优化游戏性能与系统稳定性?如何通过BIOS设置优化游戏性能与系统稳定性?

    启用XMP/DOCP可显著提升游戏帧数与系统响应,通过让内存运行于标称高频低时序,改善最低帧稳定性;正确设置需在BIOS中开启对应配置文件,并进行稳定性测试以确保兼容性。 BIOS设置是优化游戏性能和系统稳定性的一个关键但常被忽视的环节。通过细致调整内存频率、CPU电源管理模式,甚至是集成显卡分配,…

    2026年9月24日 • 用户投稿
    200
  • AI模型评测有哪些_好用的AI模型评测大全

    AI模型评测有哪些_好用的AI模型评测大全AI模型评测有哪些_好用的AI模型评测大全AI模型评测有哪些_好用的AI模型评测大全AI模型评测有哪些_好用的AI模型评测大全

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ MMLU:大规模多任务语言理解基准 Open LLM Leaderboard:Hugging Face推出的开源大模型排行榜单 C-Eval:一个全面的中文基础模型评估套件 FlagEval:智…

    2026年9月24日 • 用户投稿
    200
  • Debian环境下MongoDB如何进行性能调优

    在debian环境下进行mongodb性能调优,可以参考以下步骤和建议: 硬件和配置优化 选择合适的硬件:根据应用需求选择合适的CPU、内存和存储设备。配置内存:确保MongoDB有足够的内存来缓存数据和索引,减少磁盘I/O。使用SSD:SSD硬盘比传统硬盘提供更快的读写速度,显著提升数据库性能。 …

    2026年9月24日
    100
  • safari浏览器标签页图标(favicon)不显示怎么办_safari浏览器标签页图标不显示解决方法

    首先清除Safari缓存和网站数据,检查图像加载设置是否开启,刷新页面或重访网站,必要时重置浏览器设置,并确认系统显示设置未禁用相关视觉效果。 如果您在使用 Safari 浏览器时发现网页标签页的图标(favicon)未能正常显示,可能是由于缓存异常、网站资源加载问题或浏览器设置限制所致。以下是解决…

    2026年9月24日
    100
  • 安装系统时,如何手动加载第三方 SATA 或 NVMe 硬盘驱动?

    安装系统时,如何手动加载第三方 SATA 或 NVMe 硬盘驱动?安装系统时,如何手动加载第三方 SATA 或 NVMe 硬盘驱动?安装系统时,如何手动加载第三方 SATA 或 NVMe 硬盘驱动?安装系统时,如何手动加载第三方 SATA 或 NVMe 硬盘驱动?

    安装系统时若第三方SATA或NVMe硬盘不被识别,需在安装界面通过“加载驱动程序”选项手动导入厂商提供的.inf等驱动文件,确保USB驱动器格式为FAT32并存放解压后的正确版本驱动,进入BIOS确认SATA模式(如RAID/AHCI)与驱动匹配,且硬件连接正常。 安装系统时,如果遇到第三方 SAT…

    2026年9月24日 • 用户投稿
    100
  • Java双向链表:实现高效的按索引删除节点操作

    Java双向链表:实现高效的按索引删除节点操作Java双向链表:实现高效的按索引删除节点操作Java双向链表:实现高效的按索引删除节点操作Java双向链表:实现高效的按索引删除节点操作

    本文详细讲解了如何在Java中为双向链表实现按索引删除节点的操作。教程涵盖了泛型设计、节点结构、参数校验、以及针对头节点、尾节点和中间节点的删除逻辑,并强调了维护链表head、tail和size等状态的准确性,确保了删除操作的健壮性和正确性。 1. 双向链表节点与泛型设计 在实现双向链表时,为了提高…

    2026年9月24日 • 用户投稿
    200

发表回复

登录后才能评论
关注微信