Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
优化Pandas大型CSV文件处理:向量化操作与性能提升_创想鸟

优化Pandas大型CSV文件处理:向量化操作与性能提升

优化pandas大型csv文件处理:向量化操作与性能提升

本教程旨在解决Python Pandas处理大型CSV文件时的性能瓶颈。文章将深入探讨为何应避免使用iterrows()和apply()等迭代方法,并重点介绍如何利用Pandas的向量化操作大幅提升数据处理效率。此外,还将提供分块读取(chunksize)等进阶优化策略,帮助用户高效处理百万级别甚至更大规模的数据集。

理解Pandas性能瓶颈:为何避免iterrows()和apply()

在处理大型数据集时,Python Pandas因其高效的数据结构和丰富的操作函数而广受欢迎。然而,许多初学者在使用Pandas时常会遇到性能问题,尤其是在尝试逐行处理数据时。一个常见的误区是使用DataFrame.iterrows()或DataFrame.apply()方法。

例如,原始问题中提供的伪代码片段展示了典型的逐行迭代模式:

import osimport pandas as pd# 假设 dados 是一个已加载的DataFrame# dados = pd.read_csv('your_file.csv')for i, row in dados.iterrows():    # 对每一行执行复杂逻辑    # 例如:检查 row['column_a'] 或 row['column_b'] 是否包含特定值    # 如果满足条件,将 row['column_c'] 添加到列表中    pass

这种模式对于小型数据集可能可行,但当数据量达到数千行时,性能会急剧下降。根据原始问题描述,1000行数据需要约40秒,10000行则需要400秒,这表明处理百万行数据将耗费数小时甚至更长时间,效率极低。

核心原因在于: iterrows()和apply()本质上是Python级别的循环。Pandas底层是基于NumPy和C语言实现的,其大部分操作都经过高度优化。当使用Python循环逐行处理时,Pandas的这些底层优化优势无法发挥,每次迭代都需要将数据从优化的C结构转换回Python对象,导致巨大的开销。这使得这些方法在性能上远不如Pandas的内置向量化操作。

核心优化策略:拥抱向量化操作

Pandas的核心优势在于其能够对整个Series(列)或DataFrame执行操作,而无需显式的Python循环。这种方法称为“向量化操作”,它利用了NumPy数组的强大功能和C语言的执行效率。

什么是向量化操作?向量化操作是指将一个函数或操作应用到整个数组或Series上,而不是逐个元素地进行。Pandas会将这些操作转化为底层的C或NumPy函数调用,从而实现极高的执行速度。

示例:简单的向量化操作

考虑一个简单的例子,为DataFrame添加一个新列,该列是现有列加1的结果:

import pandas as pddf = pd.DataFrame({'existing_column': [1, 2, 3, 4, 5]})# 传统循环(应避免)# new_column_list = []# for val in df['existing_column']:#     new_column_list.append(val + 1)# df['new_column'] = new_column_list# 向量化操作df['new_column'] = df['existing_column'] + 1print(df)

输出:

   existing_column  new_column0                1           21                2           32                3           43                4           54                5           6

这里的df[‘existing_column’] + 1就是典型的向量化操作,它比任何Python循环都要快得多。

将原始问题逻辑转化为向量化操作

回到原始问题中的伪代码逻辑:“对于列表中的每个项,检查row[column_a]或row[column_b]是否包含该项作为值,如果为真,则将row[column_c]添加到列表中。”

假设我们有一个search_items列表,并且我们想检查column_a或column_b中的值是否精确匹配search_items中的任何一个。我们可以这样进行向量化:

import pandas as pd# 模拟数据data = {    'column_a': ['apple', 'banana', 'orange', 'grape', 'kiwi'],    'column_b': ['red', 'yellow', 'green', 'purple', 'yellow'],    'column_c': [10, 20, 30, 40, 50]}dados = pd.DataFrame(data)# 待搜索的项列表search_items = ['banana', 'green', 'kiwi']# 创建布尔掩码:检查 'column_a' 中的值是否在 search_items 中mask_a = dados['column_a'].isin(search_items)# 创建布尔掩码:检查 'column_b' 中的值是否在 search_items 中mask_b = dados['column_b'].isin(search_items)# 合并两个掩码:如果 column_a 或 column_b 满足条件combined_mask = mask_a | mask_b# 使用合并后的掩码选择 'column_c' 中的值,并转换为列表result_list = dados.loc[combined_mask, 'column_c'].tolist()print("符合条件的 column_c 值列表:", result_list)

输出:

符合条件的 column_c 值列表: [20, 30, 50]

这个向量化方法避免了显式循环,利用Pandas和NumPy的底层优化,大大提高了处理速度。对于字符串包含匹配(而非精确匹配),可以使用str.contains()结合正则表达式。

进阶优化:分块读取大型文件 (chunksize)

即使使用了向量化操作,如果CSV文件极其庞大(例如,数亿行或数十GB),一次性加载到内存中仍然可能导致内存溢出。在这种情况下,可以使用pd.read_csv()的chunksize参数来分块读取文件。

chunksize参数允许你指定每次读取的行数,read_csv会返回一个迭代器,每次迭代产生一个DataFrame块。你可以对每个块应用向量化操作,然后将结果聚合起来。

import pandas as pdimport os# 假设文件路径# 在实际应用中,请替换为你的CSV文件路径desktop_path = os.path.join(os.path.join(os.environ["USERPROFILE"]), "Desktop")file_path = os.path.join(desktop_path, 'your_large_file.csv') # 请替换为你的实际文件# 模拟一个大型文件处理场景# 待搜索的项列表search_items = ['banana', 'green', 'kiwi']# 定义一个函数来处理每个数据块def process_chunk(chunk_df, search_items_list):    mask_a = chunk_df['column_a'].isin(search_items_list)    mask_b = chunk_df['column_b'].isin(search_items_list)    combined_mask = mask_a | mask_b    return chunk_df.loc[combined_mask, 'column_c'].tolist()all_results = []# 设置 chunksize,例如每次读取100,000行# 根据你的内存和文件大小调整此值chunk_size = 100000# 迭代读取CSV文件for chunk_id, chunk in enumerate(pd.read_csv(file_path, chunksize=chunk_size)):    print(f"正在处理第 {chunk_id + 1} 个数据块...")    chunk_result = process_chunk(chunk, search_items)    all_results.extend(chunk_result)print("n所有符合条件的 column_c 值列表 (分块处理):", all_results)

通过分块处理,即使文件大小超过可用内存,也能有效地进行数据处理。这种方法适用于需要聚合结果或在每个块上独立完成任务的场景。

总结与最佳实践

处理大型CSV文件时,提高Pandas性能的关键在于:

避免Python循环: 尽量不使用iterrows()、itertuples()或apply()(尤其是当apply需要对每一行执行复杂逻辑时)。它们会将Pandas的性能优势降至最低。优先使用向量化操作: 尽可能将数据操作转化为对整个Series或DataFrame的函数调用。利用Pandas内置的函数、NumPy函数和布尔索引。利用chunksize处理超大文件: 当文件大小超出内存限制时,使用pd.read_csv(chunksize=…)分块读取和处理数据。数据类型优化: 确保DataFrame中的列使用最合适的数据类型(例如,使用category类型处理重复的字符串,使用更小的整数类型)。考虑其他库: 对于真正海量的数据集(例如,TB级别),可以考虑使用Dask(分布式Pandas)或Polars(Rust-based,速度极快)等专门为大数据设计的库。

通过遵循这些最佳实践,你可以显著提高Python Pandas处理大型CSV文件的效率,从而在面对百万级甚至更大数据量时也能游刃有余。

以上就是优化Pandas大型CSV文件处理:向量化操作与性能提升的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1376550.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Python pydoc:为何有时将 any() 识别为包?
上一篇 2025年12月14日 16:00:15
Docker构建时选择Python版本:ARG参数的运用与实践
下一篇 2025年12月14日 16:00:37

相关推荐

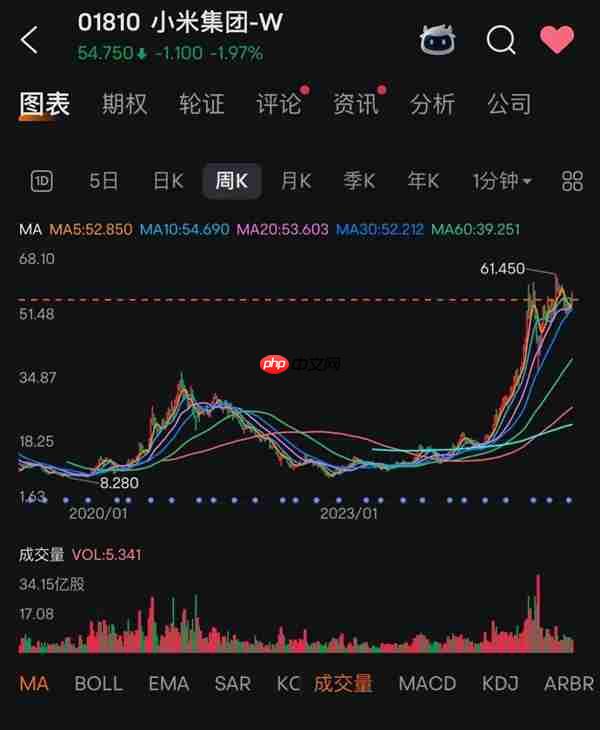
  • 那些为小米信仰充值的人 都怎么样了?

    那些为小米信仰充值的人 都怎么样了?那些为小米信仰充值的人 都怎么样了?那些为小米信仰充值的人 都怎么样了?那些为小米信仰充值的人 都怎么样了?

    2024年末,小米的股价一路上扬,逼近40港元。而在此前的很长一段时间,外界因对小米造车的不信任,唱空小米,股价一度跌至10港元以下。 为了庆祝小米重回股价峰值,在一个寒气逼人的冬日,一群小米股民相聚在北京小米互联网园区的门口。 他们像个孩子一样,打出一条“心里有火,眼里有光”的横幅。一位教授喝到尽…

    2026年9月22日 • 用户投稿
    100
  • 如何在VEED.io中制作AI视频?在线工具快速剪辑AI内容的步骤

    如何在VEED.io中制作AI视频?在线工具快速剪辑AI内容的步骤如何在VEED.io中制作AI视频?在线工具快速剪辑AI内容的步骤如何在VEED.io中制作AI视频?在线工具快速剪辑AI内容的步骤如何在VEED.io中制作AI视频?在线工具快速剪辑AI内容的步骤

    VEED.io通过“文本转视频”和“AI形象”功能,让视频制作变得简单高效。用户只需输入文本,即可生成带AI配音、字幕和匹配素材的视频,或选择AI虚拟人物进行口型同步播报。平台还提供AI语音合成、自动字幕、多语言支持及丰富编辑功能,便于后期精修。优化效果需从高质量文本入手,合理选择声音与形象,并通过…

    2026年9月22日 • 用户投稿
    000
  • Java中递归处理列表:条件性移除最大值策略与实现

    本教程深入探讨了如何在Java中使用递归方法,根据特定条件(如列表是否已排序、最大值是否位于列表的首尾)来移除列表中的最大值。文章将详细阐述如何设计一个高效的递归算法,包括排序检查、最大值定位以及条件性移除的实现细节,并提供完整的代码示例和注意事项,帮助读者掌握递归在复杂列表操作中的应用。 引言:递…

    2026年9月22日
    000
  • 玩转 Spring Boot 集成篇(定时任务框架Quartz)

    玩转 Spring Boot 集成篇(定时任务框架Quartz)玩转 Spring Boot 集成篇(定时任务框架Quartz)玩转 Spring Boot 集成篇(定时任务框架Quartz)玩转 Spring Boot 集成篇(定时任务框架Quartz)

    在日常项目研发中,定时任务可谓是必不可少的一环,关于 spring boot 如何实现静态定时任务、动态定时任务以及如何开启多线程跑任务,均已在上篇分享过,不再赘述。 虽然 Spring Boot 内置注解方式实现的定时任务,在一定程度上也能解决一定的业务场景问题,但是若做更复杂的动作,例如启停任务…

    2026年9月22日 • 用户投稿
    100
  • Cortana如何连接邮箱_Cortana邮箱同步配置方法

    首先需将邮箱账户与Cortana连接,可通过Windows设置添加账户或在Cortana应用内手动配置,支持Outlook.com、Gmail及Exchange等类型;完成账户添加后,须在隐私权限中启用邮件读取和同步权限,确保Cortana可访问邮件、日历及联系人数据,从而实现智能提醒与信息同步功能…

    2026年9月22日
    000
  • 如何用Sublime导出MySQL数据表结构_生成Markdown或HTML格式文档

    要使用 sublime text 导出 mysql 数据表结构并生成 markdown 或 html 文档,需通过以下步骤操作:1. 使用 show create table 命令或 mysqldump 工具获取建表语句;2. 在 sublime 中整理字段信息,按字段名、类型、是否为空、键、默认值…

    2026年9月22日
    000
  • 三角洲行动S6九格保险任务速通指南

    三角洲行动S6九格保险任务速通指南三角洲行动S6九格保险任务速通指南三角洲行动S6九格保险任务速通指南三角洲行动S6九格保险任务速通指南

    在《三角洲行动》s6赛季中,九格保险任务成了不少玩家头疼的难题,耗时久、节奏慢,稍不注意就被卡住。其实只要掌握策略,合理安排任务顺序,高效推进并非难事!接下来这份分阶段速通攻略,将帮你理清思路,快速通关九格保险任务! 三角洲行动S6赛季九格保险任务高效速通指南 第一阶段:聚焦主线与关键前置 优先完成…

    2026年9月22日 • 用户投稿
    100
  • VSCode如何安装和使用插件 VSCode插件管理的高效方法

    安装插件需通过vscode扩展视图搜索并点击安装,部分插件需重启或配置后生效;2. 使用插件时可通过命令面板、上下文菜单、状态栏或自动语言特性调用功能,并在设置中自定义行为;3. 高效管理应定期审视插件使用频率,禁用或卸载不常用者,关注性能影响,利用“开发者: 显示正在运行的扩展”识别资源占用高的插…

    2026年9月22日
    200
  • Java Stream API:从嵌套集合中提取唯一值的高效实践

    本文深入探讨如何利用Java Stream API,从包含嵌套集合的对象列表中高效地提取唯一的字符串值。我们将重点介绍flatMap()和mapMulti()这两种强大的流操作,演示它们如何替代传统的嵌套循环,从而实现代码的简洁性、可读性以及潜在的性能优化。 在java应用开发中,我们经常会遇到处理…

    2026年9月22日
    100
  • safari浏览器如何将网页保存为PDF_safari浏览器网页保存为PDF方法

    Safari浏览器支持将网页保存为PDF,可通过三种方式实现:1. 使用打印功能,点击“文件”→“打印”,选择“另存为PDF”并设置参数后保存;2. 点击共享按钮,选择“创建PDF”,生成后存储到指定位置;3. 利用快捷指令应用创建自动化流程,获取当前网页并转换为PDF自动归档。 如果您在浏览网页时…

    2026年9月22日
    100
  • CapCut的AI混合工具如何使用?快速制作高质量短视频的教程

    CapCut的AI混合工具通过智能算法将多段素材自然融合,支持画中画、双重曝光、背景替换等效果,提升视频创意与质感;使用时需导入素材并分层,选择“混合模式”如滤色、叠加等,结合不透明度、位置调整实现融合;可打造情绪隐喻、时间流逝等叙事效果,增强艺术表达;避免过度使用、素材冲突等问题,善用蒙版、色彩调…

    2026年9月22日
    500
  • 苹果手机如何快速整理桌面图标

    掌握技巧可轻松整理苹果手机桌面:1. 用文件夹归类应用,长按图标拖动合并并自定义命名;2. 批量移动图标时,抖动模式下双指滑屏切换页面;3. 利用App资源库自动分类,隐藏不常用应用;4. 恢复默认布局可通过设置中的“还原主屏幕布局”操作,保持桌面整洁有序。 苹果手机整理桌面图标其实很简单,只要掌握…

    2026年9月22日
    000
  • 使用Java Selenium验证表格数据排序:金额列的升序与降序检查

    本教程详细介绍了如何利用Java Selenium WebDriver验证网页表格中金额列的排序功能。文章涵盖了从环境配置、登录应用到数据提取、清洗、数值转换,再到实现表格数据(特别是金额数据)的升序或降序验证的完整流程。通过示例代码,演示了如何获取页面元素、处理文本数据,并使用JUnit进行断言,…

    2026年9月22日
    100
  • 抖音播放量是什么意思?抖音播放量如何变现呢

    短视频平台已成为当下最受欢迎的传播媒介之一。作为国内领先的短视频平台,抖音凭借其强大的算法推荐机制和丰富的内容生态,吸引了大量用户。而抖音播放量,作为衡量短视频传播效果的重要指标,也逐渐成为创作者和品牌方关注的重点。本文将深入解析抖音播放量的含义,探讨其背后的逻辑及影响因素,为短视频内容生产者提供有…

    2026年9月22日
    000
  • Could NOT find Doxygen (missing: DOXYGEN_EXECUTABLE)

    could not find doxygen (missing: doxygen_executable)  使用cmake .. 有时候会遇到如下问题: 代码语言:javascript代码运行次数:0运行复制 $ cmake ..– The CXX compiler identification …

    2026年9月22日
    100
  • 解决Spring Boot Actuator升级后Tomcat指标缺失问题

    本文旨在解决Spring Boot Actuator升级至2.7.0及更高版本后,部分Tomcat指标(如tomcat.cache.access、tomcat.global.error)在MetricsEndpoint中缺失的问题。通过在application.properties中配置server…

    2026年9月22日
    600
  • MAC的Safari浏览器怎么安装插件_MAC Safari浏览器安装插件教程

    首先通过App Store安装Safari扩展,打开Safari浏览器选择“Safari 浏览器扩展”进入下载页面,找到所需插件点击“获取”安装;其次可手动安装.safariextz文件,双击下载文件按提示完成安装并配置权限;最后在Safari设置中启用插件,进入“扩展”标签页勾选对应插件,调整功能…

    2026年9月22日
    100
  • 苹果手机忘记密码

    确认你的Apple ID与密码情况 首先,确认你是否真的忘记了密码。有时候可能是输错了Apple ID或密码,建议仔细核对。回想一下是否曾修改过密码,并检查与该账户绑定的邮箱、安全提示问题或双重认证设备,这些都有助于找回账户访问权限。 如何重设密码 若确认密码遗失,最有效的解决方式是进行密码重置。请…

    2026年9月22日
    100
  • Laravel 8 登录后重定向到仪表盘:完整教程

    本教程详细阐述了在 Laravel 8 中实现用户登录后重定向到仪表盘的多种方法。我们将探讨 Laravel 默认的重定向机制、如何正确配置仪表盘路由及其中间件,并提供通过自定义 LoginController 实现精确重定向的示例代码。通过本文,您将全面掌握 Laravel 认证后的重定向流程,并…

    2026年9月22日
    500
  • Ubuntu VMware Tools安装详细过程(非常靠谱)「建议收藏」

    Ubuntu VMware Tools安装详细过程(非常靠谱)「建议收藏」Ubuntu VMware Tools安装详细过程(非常靠谱)「建议收藏」Ubuntu VMware Tools安装详细过程(非常靠谱)「建议收藏」Ubuntu VMware Tools安装详细过程(非常靠谱)「建议收藏」

    大家好,很高兴再次与大家见面,我是你们的朋友全栈君。 说明:这篇博客是博主亲自编写的,内容独特,辛苦付出,请大家尊重原创,感谢支持! 一.前言VMware Ubuntu安装的详细指南:https://www.php.cn/link/35e7132c1742eaa9dacfedd5607b5f94。 …

    2026年9月22日 • 用户投稿
    900

发表回复

登录后才能评论
关注微信