Python从API获取并解析Parquet数据实战指南

Python从API获取并解析Parquet数据实战指南

本文旨在指导Python开发者如何从API正确获取并解码Apache Parquet格式的二进制数据。文章详细阐述了处理API响应时,区分response.text与response.content的重要性,并提供了使用io.BytesIO、pyarrow.parquet和pandas库将Parquet字节流高效转换为可读DataFrame的实用方法,从而解决常见的解码错误,确保数据顺利处理与分析。

1. 引言:API数据与Parquet格式

在现代数据集成任务中,通过api获取数据是常见操作。当api返回的数据采用apache parquet这种高效的列式存储格式时,直接处理其二进制流需要特定的方法。parquet格式以其压缩率高、查询性能优越等特点,在数据湖和大数据分析领域广受欢迎。然而,初次尝试从api获取并解码parquet数据时,开发者常因对http响应内容类型的误解而遇到解码错误。本文将详细介绍如何正确地从api获取parquet数据,并利用python生态系统中的强大工具进行解析和处理。

2. 理解HTTP响应:response.text与response.content

在使用requests库发送HTTP请求时,response对象提供了多种访问响应内容的方式。其中,response.text和response.content是最常用的两种,但它们之间存在本质区别:

response.text: 尝试将响应内容解码为文本字符串,默认使用response.encoding(通常是根据HTTP头推断的编码,如UTF-8)。这适用于处理文本数据,如JSON、HTML等。response.content: 返回响应内容的原始字节流。这适用于处理二进制数据,如图片、文件下载、以及本例中的Parquet数据。

当API返回Parquet格式的数据时,它实际上是一个二进制文件流。如果错误地使用response.text来获取内容,requests库会尝试将其解码为字符串,这会导致乱码甚至解码失败,因为Parquet的二进制结构无法被解释为有效的文本字符。

错误示例(应避免):

import requestsdef get_orders_data_incorrect(date):    url = "YOUR_API_BASE_URL/orders" # 替换为你的API地址    headers = {}    params = {"date": date}    response = requests.get(url, headers=headers, params=params)    if response.status_code == 200:        # 错误:Parquet是二进制数据,不应使用response.text        data = response.text.strip()        return data    else:        print(f"Failed to fetch orders data: {response.status_code}")        return None# 假设orders_info是使用上述错误方法获取的乱码字符串# parquet_data_str = orders_info# buffer = io.BytesIO(parquet_data_str.encode()) # 此时encode会再次出错或生成无效字节流

上述代码中,response.text会将Parquet二进制数据强行解码为字符串,导致后续的parquet_data_str.encode()操作无法生成有效的Parquet字节流,从而在pyarrow.parquet.read_table阶段抛出错误。

立即学习“Python免费学习笔记(深入)”;

3. 正确的Parquet数据解析流程

要正确解析从API获取的Parquet数据,我们需要遵循以下步骤:

获取原始二进制内容:使用response.content获取API响应的字节流。创建内存缓冲区:将字节流封装到io.BytesIO对象中,模拟一个文件对象,以便pyarrow或pandas能够从中读取数据。使用pyarrow或pandas解析:利用pyarrow.parquet或pandas.read_parquet从内存缓冲区中读取并解析Parquet数据。转换为DataFrame:将解析后的数据转换为pandas.DataFrame,以便于后续的数据分析和处理。

3.1 方案一:使用pandas.read_parquet直接解析

pandas库提供了read_parquet函数,它能够直接从文件路径、URL或类似文件对象(如io.BytesIO)中读取Parquet数据。这是最简洁高效的方法。

import requestsimport ioimport pandas as pdimport pyarrow.parquet as pq # 虽然这里直接用pandas,但pyarrow是其底层依赖def get_orders_data_solution1(date: str) -> pd.DataFrame | None:    """    从API获取订单数据并直接解析为Pandas DataFrame。    """    url = "YOUR_API_BASE_URL/orders" # 替换为你的API地址    headers = {} # 根据需要添加认证或其他头部    params = {"date": date}    try:        response = requests.get(url, headers=headers, params=params)        response.raise_for_status() # 如果状态码不是200,则抛出HTTPError        # 核心:使用response.content获取原始二进制数据        # 并通过io.BytesIO封装,然后由pd.read_parquet直接读取        df = pd.read_parquet(io.BytesIO(response.content))        return df    except requests.exceptions.RequestException as e:        print(f"请求失败: {e}")        return None    except Exception as e:        print(f"数据解析失败: {e}")        return None# 示例调用date_to_fetch = "2023-12-08"orders_df = get_orders_data_solution1(date_to_fetch)if orders_df is not None:    print("成功获取并解析订单数据,前5行:")    print(orders_df.head())    print(f"DataFrame形状: {orders_df.shape}")else:    print("未能获取或解析订单数据。")

3.2 方案二:使用pyarrow.parquet解析后转换为pandas.DataFrame

pyarrow是Apache Arrow项目的Python接口,提供了对Parquet格式的底层支持。pandas.read_parquet内部也依赖于pyarrow(或fastparquet)。此方案展示了更底层的解析过程,它先通过pyarrow.parquet.read_table创建Arrow Table对象,再将其转换为pandas.DataFrame。

import requestsimport ioimport pandas as pdimport pyarrow.parquet as pqdef get_orders_data_solution2(date: str) -> pd.DataFrame | None:    """    从API获取订单数据,通过pyarrow解析,然后转换为Pandas DataFrame。    """    url = "YOUR_API_BASE_URL/orders" # 替换为你的API地址    headers = {}    params = {"date": date}    try:        response = requests.get(url, headers=headers, params=params)        response.raise_for_status() # 如果状态码不是200,则抛出HTTPError        # 核心:使用response.content获取原始二进制数据        buffer = io.BytesIO(response.content)        # 通过pyarrow.parquet读取数据到Arrow Table        table = pq.read_table(buffer)        # 将Arrow Table转换为Pandas DataFrame        df = table.to_pandas()        return df    except requests.exceptions.RequestException as e:        print(f"请求失败: {e}")        return None    except Exception as e:        print(f"数据解析失败: {e}")        return None# 示例调用date_to_fetch = "2023-12-08"orders_df_alt = get_orders_data_solution2(date_to_fetch)if orders_df_alt is not None:    print("n成功获取并解析订单数据(方案二),前5行:")    print(orders_df_alt.head())    print(f"DataFrame形状: {orders_df_alt.shape}")else:    print("未能获取或解析订单数据(方案二)。")

两种方案都能够正确处理从API获取的Parquet二进制数据。方案一更为简洁,推荐在大多数情况下使用。

4. 将DataFrame保存为Parquet文件

在成功将Parquet数据解析为pandas.DataFrame后,如果需要将其保存到本地文件系统以便长期存储或后续处理,pandas也提供了便捷的方法。

# 假设 orders_df 是从API获取并解析后的DataFrameif orders_df is not None:    output_filename = f"orders_{date_to_fetch}.parquet"    try:        orders_df.to_parquet(output_filename, index=False) # index=False表示不将DataFrame的索引写入Parquet文件        print(f"nDataFrame已成功保存到 {output_filename}")    except Exception as e:        print(f"保存Parquet文件失败: {e}")

to_parquet()方法同样依赖于pyarrow或fastparquet作为后端引擎。

5. 注意事项

依赖安装:确保你的Python环境中安装了必要的库:requests、pandas和pyarrow。可以通过pip install requests pandas pyarrow进行安装。API地址与认证:示例代码中的YOUR_API_BASE_URL/orders需要替换为实际的API端点。如果API需要认证(如Bearer Token、API Key等),请在headers字典中添加相应的认证信息。错误处理:在实际应用中,应包含更健壮的错误处理机制,例如捕获网络连接错误、HTTP状态码非200的情况,以及数据解析过程中可能出现的异常。性能考量:对于非常大的Parquet文件,直接在内存中处理可能会消耗大量RAM。在这种情况下,可以考虑使用流式处理或者将数据分块下载和处理。pyarrow和pandas通常能高效处理中等大小的数据集。数据验证:在获取和解析数据后,建议对DataFrame的结构(列名、数据类型)和内容进行初步验证,以确保数据的完整性和正确性。

6. 总结

从API获取并解析Parquet二进制数据是数据工程师和分析师的常见任务。关键在于正确识别API响应的二进制性质,并使用response.content获取原始字节流。结合io.BytesIO内存缓冲区以及pandas.read_parquet或pyarrow.parquet.read_table,可以高效、可靠地将Parquet数据转换为可用的pandas.DataFrame。掌握这些技术,将有助于你更顺畅地处理多样化的API数据源,为后续的数据分析和应用奠定坚实基础。

以上就是Python从API获取并解析Parquet数据实战指南的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1376753.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
如何在Docker构建时动态选择Python版本
上一篇 2025年12月14日 16:10:44
TensorFlow TensorBoard 日志文件的程序化解析与数据提取
下一篇 2025年12月14日 16:10:56

相关推荐

  • ChatGPT如何优化剧本创作 ChatGPT戏剧冲突生成技巧

    ChatGPT如何优化剧本创作 ChatGPT戏剧冲突生成技巧ChatGPT如何优化剧本创作 ChatGPT戏剧冲突生成技巧ChatGPT如何优化剧本创作 ChatGPT戏剧冲突生成技巧ChatGPT如何优化剧本创作 ChatGPT戏剧冲突生成技巧

    本文将探讨如何利用ChatGPT来优化剧本创作,并分享ChatGPT在生成戏剧冲突方面的技巧。我们将首先概述ChatGPT在剧本创作中的潜力,然后深入讲解如何通过与ChatGPT的互动来打磨故事情节,特别是如何生成具有吸引力的戏剧冲突,为创作者提供实用可行的指导。 ☞☞☞AI 智能聊天, 问答助手,…

    2026年9月28日 • 用户投稿
    000
  • CCleaner怎么备份注册表_CCleaner备份注册表的正确操作流程

    CCleaner怎么备份注册表_CCleaner备份注册表的正确操作流程CCleaner怎么备份注册表_CCleaner备份注册表的正确操作流程CCleaner怎么备份注册表_CCleaner备份注册表的正确操作流程CCleaner怎么备份注册表_CCleaner备份注册表的正确操作流程

    开启CCleaner注册表备份功能可防止清理出错,需在“设置”中勾选“修复前备份注册表”并指定存储路径,扫描修复时会自动生成.reg备份文件,异常时双击该文件导入即可恢复系统。 CCleaner 备份注册表是为了防止清理或修复操作导致系统出现问题,提前保存当前注册表状态,以便需要时可恢复。虽然 CC…

    2026年9月28日 • 用户投稿
    000
  • 抖音小号开直播有收益吗?抖音直接开直播能赚钱吗

    抖音小号开直播有收益吗?抖音直接开直播能赚钱吗抖音小号开直播有收益吗?抖音直接开直播能赚钱吗抖音小号开直播有收益吗?抖音直接开直播能赚钱吗抖音小号开直播有收益吗?抖音直接开直播能赚钱吗

    在这个短视频风起云涌的时代,抖音已经成为了许多人生活中不可或缺的一部分。随着抖音平台的不断优化和功能的增加,越来越多的人开始尝试在抖音上开直播。抖音小号开直播有收益吗?今天,我们就来聊聊这个话题。 一、抖音小号开直播的收益来源 1. 直播打赏:这是抖音小号直播最直接的收益来源。观众可以通过赠送虚拟礼…

    2026年9月28日 • 用户投稿
    000
  • 别人堵车我chill?国庆宅家的正确姿势竟是躺平式充电……

    别人堵车我chill?国庆宅家的正确姿势竟是躺平式充电……别人堵车我chill?国庆宅家的正确姿势竟是躺平式充电……别人堵车我chill?国庆宅家的正确姿势竟是躺平式充电……别人堵车我chill?国庆宅家的正确姿势竟是躺平式充电……

    中秋遇上国庆,假期模式即将开启。与其在高速上寸步难行、在景区里人挤人,不如安心宅在家,享受一段自在又充实的时光。我已经用华为阅读精心挑选了一份实用又合口味的书单,还在华为视频收藏了一堆经典影视佳作,让这个长假既能彻底放松,又能悄悄提升自我,实现“躺平也能进步”的理想状态。 开通华为阅读会员后,仿佛打…

    2026年9月28日 • 用户投稿
    100
  • 提高效率的幕布快捷键大全

    提高效率的幕布快捷键大全提高效率的幕布快捷键大全提高效率的幕布快捷键大全提高效率的幕布快捷键大全

    掌握幕布快捷键可显著提升笔记效率,本文介绍Mac环境下基础文本格式(如Command+B加粗)、调整层级(Tab缩进)、移动管理主题(Command+D复制)、专注模式切换及内容编辑(Shift+Enter添加描述)等核心操作。 如果您正在使用幕布进行笔记整理或大纲规划,却发现频繁操作鼠标拖慢了您的…

    2026年9月28日 • 用户投稿
    100
  • 抖音怎么在电脑上直播?抖音不够1000粉丝怎么开橱窗

    抖音怎么在电脑上直播?抖音不够1000粉丝怎么开橱窗抖音怎么在电脑上直播?抖音不够1000粉丝怎么开橱窗抖音怎么在电脑上直播?抖音不够1000粉丝怎么开橱窗抖音怎么在电脑上直播?抖音不够1000粉丝怎么开橱窗

    随着抖音的火爆,越来越多的人想要在电脑上直播,分享自己的生活和才艺。但是,电脑上如何进行抖音直播呢?别急,今天就来给大家详细讲解一下电脑上抖音直播的步骤和技巧。 一、准备工作 1. 注册抖音账号 在电脑上直播之前,首先需要在抖音APP上注册一个账号。如果还没有账号,可以下载抖音APP进行注册。 2.…

    2026年9月28日 • 用户投稿
    000
  • Java控制台图案生成:基于用户输入的字符交替模式实现

    Java控制台图案生成:基于用户输入的字符交替模式实现Java控制台图案生成:基于用户输入的字符交替模式实现Java控制台图案生成:基于用户输入的字符交替模式实现Java控制台图案生成:基于用户输入的字符交替模式实现

    本文将详细介绍如何在Java中实现一个动态字符图案生成程序。该程序根据用户输入的整数值,逐行打印字符。每行字符的数量与行号相同,同时字符会根据行号的奇偶性在“+”和“-”之间交替。我们将通过嵌套循环和条件判断来构建这一逻辑,并提供完整的Java代码示例,帮助读者掌握此类图案生成技巧。 动态字符图案生…

    2026年9月28日 • 用户投稿
    000
  • AI Overviews如何设置数据脱敏 AI Overviews隐私保护处理流程

    AI Overviews如何设置数据脱敏 AI Overviews隐私保护处理流程AI Overviews如何设置数据脱敏 AI Overviews隐私保护处理流程AI Overviews如何设置数据脱敏 AI Overviews隐私保护处理流程AI Overviews如何设置数据脱敏 AI Overviews隐私保护处理流程

    本篇文章将详细介绍AI Overviews中数据脱敏的设置方法和隐私保护处理流程,帮助您理解并实现有效的隐私保护措施。我们将从数据脱敏的基本概念入手,逐步讲解实现数据脱敏的具体操作步骤,并阐述相关的隐私保护处理流程,确保您的AI Overviews在使用过程中符合隐私规范。 ☞☞☞AI 智能聊天, …

    2026年9月28日 • 用户投稿
    100
  • win10 DISM命令修复失败怎么办_部署映像服务和管理工具错误处理

    win10 DISM命令修复失败怎么办_部署映像服务和管理工具错误处理win10 DISM命令修复失败怎么办_部署映像服务和管理工具错误处理win10 DISM命令修复失败怎么办_部署映像服务和管理工具错误处理win10 DISM命令修复失败怎么办_部署映像服务和管理工具错误处理

    1、确保DISM命令格式正确并以管理员身份运行;2、更新系统至最新版本解决兼容性问题;3、先执行SFC扫描修复基础文件;4、必要时通过Windows安装U盘启动进入恢复环境使用DISM和SFC联合修复系统。 如果您在尝试使用DISM命令修复Windows 10系统时遭遇失败,可能是由于命令输入错误、…

    2026年9月28日 • 用户投稿
    200
  • sublime终端乱码问题_解决Sublime内置终端中文乱码

    sublime终端乱码问题_解决Sublime内置终端中文乱码sublime终端乱码问题_解决Sublime内置终端中文乱码sublime终端乱码问题_解决Sublime内置终端中文乱码sublime终端乱码问题_解决Sublime内置终端中文乱码

    解决Sublime内置终端中文乱码需统一编码为UTF-8:1. 将文件保存为UTF-8编码;2. 设置Build System的环境变量PYTHONIOENCODING为utf-8;3. 在Windows下通过chcp 65001切换控制台代码页至UTF-8;4. 或使用外部终端运行脚本,避免输出面…

    2026年9月28日 • 用户投稿
    100
  • 如何使用 SSHGUARD 阻止 SSH 暴力攻击

    如何使用 SSHGUARD 阻止 SSH 暴力攻击如何使用 SSHGUARD 阻止 SSH 暴力攻击如何使用 SSHGUARD 阻止 SSH 暴力攻击如何使用 SSHGUARD 阻止 SSH 暴力攻击

    ◆ 概述 sshguard是一个入侵防御实用程序,它可以解析日志并使用系统防火墙自动阻止行为不端的 ip 地址(或其子网)。最初旨在为 openssh 服务提供额外的保护层,sshguard 还保护范围广泛的服务,例如 vsftpd 和 postfix。它可以识别多种日志格式,包括 syslog、s…

    2026年9月28日 • 用户投稿
    100
  • 开放协作,共筑新章:openFuyao代码仓全面开源,多样化算力集群软件开源生态开启新篇

    开放协作,共筑新章:openFuyao代码仓全面开源,多样化算力集群软件开源生态开启新篇开放协作,共筑新章:openFuyao代码仓全面开源,多样化算力集群软件开源生态开启新篇开放协作,共筑新章:openFuyao代码仓全面开源,多样化算力集群软件开源生态开启新篇开放协作,共筑新章:openFuyao代码仓全面开源,多样化算力集群软件开源生态开启新篇

    [中国,上海,2025年9月18-20日]以“跃升行业智能化”为主题的“华为全联接大会2025”在上海隆重召开。大会上,openfuyao社区正式宣布其代码仓库全面开源,华为常务董事汪涛、华为鲲鹏计算业务总裁李义以及鲲鹏计算产品部部长刘林超分别在主题演讲中深入分享了社区在开源生态建设、技术演进成果及…

    2026年9月28日 • 用户投稿
    200
  • 2025年最新十大免费自动生成美女图片的AI工具排行榜

    答案是2025年值得关注的免费AI美女图片生成工具包括“星绘”智能画廊和“幻影之笔”自由创作平台:前者界面简洁、擅长亚洲风格女性形象生成,出图稳定且细节出色,适合新手快速获得高质量图片;后者支持高级提示词输入、负面提示和局部重绘,风格多元,适合掌握技巧后进行复杂角色与场景创作。两者均提供基础免费服务…

    2026年9月28日
    000
  • 骁龙X2 Elite正式发布:共3个版本 最高配达18核

    骁龙X2 Elite正式发布:共3个版本 最高配达18核骁龙X2 Elite正式发布:共3个版本 最高配达18核骁龙X2 Elite正式发布:共3个版本 最高配达18核骁龙X2 Elite正式发布:共3个版本 最高配达18核

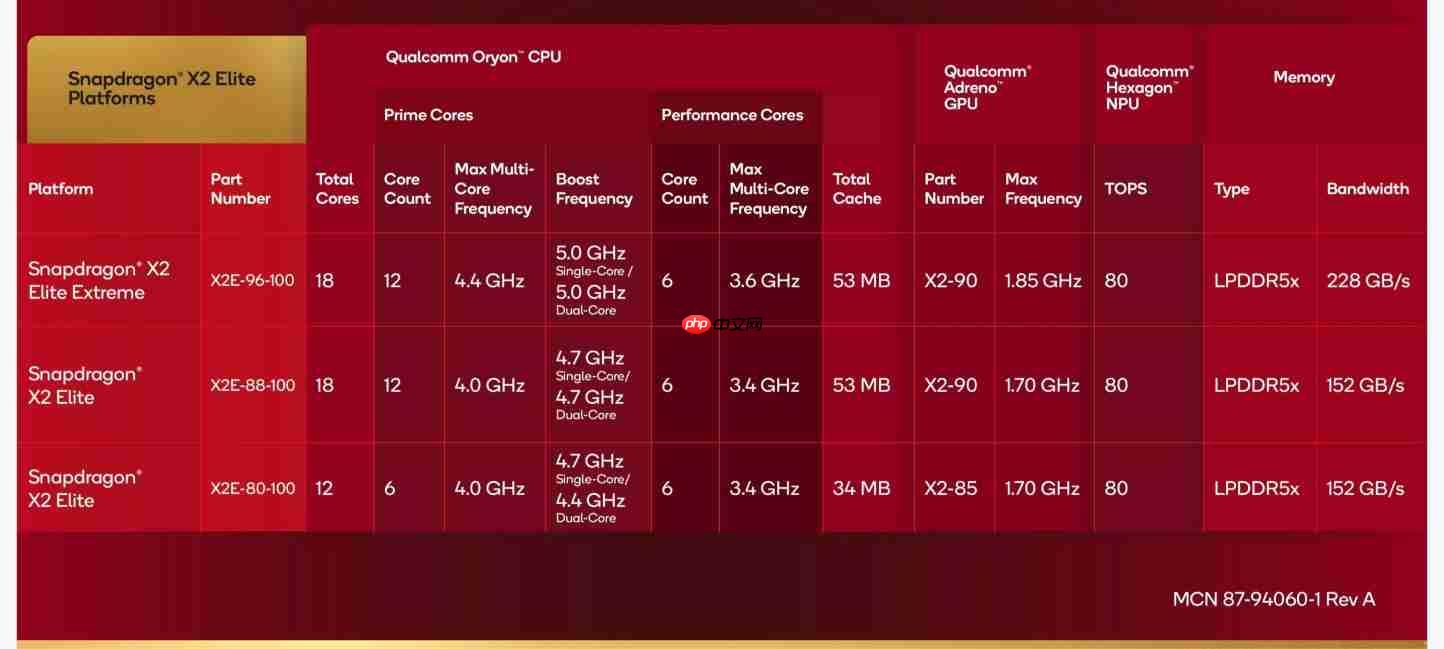
    在今日的骁龙峰会上,高通不仅推出了第五代骁龙8至尊版移动平台,还正式发布了全新的pc处理器——骁龙x2 elite。该芯片延续了基于arm架构的第三代oryon cpu设计,旨在进一步拓展其在windows笔记本市场中的竞争力。 此次发布的骁龙X2 Elite共包含三个型号:X2E-80-100、X…

    2026年9月28日 • 用户投稿
    100
  • 微信公众号第一篇文章怎么写_微信公众号首篇文章撰写教程

    微信公众号第一篇文章怎么写_微信公众号首篇文章撰写教程微信公众号第一篇文章怎么写_微信公众号首篇文章撰写教程微信公众号第一篇文章怎么写_微信公众号首篇文章撰写教程微信公众号第一篇文章怎么写_微信公众号首篇文章撰写教程

    首篇文章需明确内容定位、选题方向、排版设计与推广策略。应聚焦垂直领域,选择能体现定位且具吸引力的实用型选题,控制篇幅在1500-2000字,避免理论化与抄袭;通过秀米或135编辑器优化排版,使用高清相关配图并注意版权;发布后分享至朋友圈、微信群及互推公众号,细水长流积累粉丝;制定更新计划,持续输出原…

    2026年9月28日 • 用户投稿
    100
  • 多模态AI如何处理声学特征 多模态AI环境音识别技术

    多模态AI如何处理声学特征 多模态AI环境音识别技术多模态AI如何处理声学特征 多模态AI环境音识别技术多模态AI如何处理声学特征 多模态AI环境音识别技术多模态AI如何处理声学特征 多模态AI环境音识别技术

    本文将深入探讨多模态AI如何处理声学特征,重点介绍其在环境音识别技术中的应用。我们将从声学特征的提取入手,阐述多模态AI如何融合听觉信息与其他模态信息,以提升环境音识别的准确性和鲁棒性。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 声学特…

    2026年9月28日 • 用户投稿
    100
  • sublime怎么记住上次打开的文件和窗口_Sublime恢复上次会话与打开文件的设置方法

    sublime怎么记住上次打开的文件和窗口_Sublime恢复上次会话与打开文件的设置方法sublime怎么记住上次打开的文件和窗口_Sublime恢复上次会话与打开文件的设置方法sublime怎么记住上次打开的文件和窗口_Sublime恢复上次会话与打开文件的设置方法sublime怎么记住上次打开的文件和窗口_Sublime恢复上次会话与打开文件的设置方法

    Sublime Text通过hot_exit和remember_open_files设置实现会话恢复,关闭时将打开文件、未保存修改、光标位置等信息存入会话文件,重启时自动读取恢复状态。用户需在Preferences → Settings的用户配置中确保{“hot_exit”:…

    2026年9月28日 • 用户投稿
    100
  • 深入理解RESTful API的无状态性与数据持久化实践

    深入理解RESTful API的无状态性与数据持久化实践深入理解RESTful API的无状态性与数据持久化实践深入理解RESTful API的无状态性与数据持久化实践深入理解RESTful API的无状态性与数据持久化实践

    本教程深入探讨RESTful API的无状态性核心原则,阐明为何不应在服务器内存中维护跨API调用的数据状态。我们将详细介绍RESTful架构的无状态约束,分析在服务器端存储会话或资源状态的弊端,并推荐使用数据库等外部持久化机制来可靠地管理数据,确保API的可伸缩性、可靠性和一致性。 理解RESTf…

    2026年9月28日 • 用户投稿
    100
  • sublime怎么安装markdown预览插件_Sublime Markdown实时预览插件安装教程

    sublime怎么安装markdown预览插件_Sublime Markdown实时预览插件安装教程sublime怎么安装markdown预览插件_Sublime Markdown实时预览插件安装教程sublime怎么安装markdown预览插件_Sublime Markdown实时预览插件安装教程sublime怎么安装markdown预览插件_Sublime Markdown实时预览插件安装教程

    最直接的方式是通过Package Control安装MarkdownPreview或OmniMarkupPreviewer插件,先确保安装Package Control,再通过命令面板搜索并安装插件,最后使用快捷命令在浏览器中实时预览Markdown渲染效果。 在Sublime Text里安装Mar…

    2026年9月28日 • 用户投稿
    100
  • Excel数据怎么分组统计_Excel分类统计与汇总操作技巧

    Excel数据怎么分组统计_Excel分类统计与汇总操作技巧Excel数据怎么分组统计_Excel分类统计与汇总操作技巧Excel数据怎么分组统计_Excel分类统计与汇总操作技巧Excel数据怎么分组统计_Excel分类统计与汇总操作技巧

    数据透视表适合分析大量数据,按行和值字段自动汇总;组合功能可手动分级显示排序后的数据;SUMIF、COUNTIF等函数实现条件统计;分类汇总功能一键插入汇总行。根据场景选择方法可提升效率。 在Excel中进行数据分组统计和分类汇总,是日常工作中处理报表、分析数据的常用操作。掌握这些技巧能大幅提升工作…

    2026年9月28日 • 用户投稿
    100

发表回复

登录后才能评论
关注微信