Pandas与NumPy:高效构建基于索引的坐标DataFrame

Pandas与NumPy:高效构建基于索引的坐标DataFrame

本文详细介绍了如何从一个包含索引对的列表和一个现有dataframe中,高效地提取x和y坐标,并构建一个新的坐标dataframe。教程对比了基于循环的字典构建方法与利用numpy进行向量化操作的优化方案,强调了后者在处理大规模数据时的性能优势和代码简洁性,最终目标是为后续的路径绘制提供精确的坐标数据。

在数据分析和路径规划等场景中,我们经常需要根据一组索引从现有数据集中提取特定的坐标信息,并将其组织成一个新的数据结构。本教程将探讨如何利用Python的Pandas和NumPy库,从一个包含索引对的列表和一个DataFrame中,高效地构建一个包含X和Y坐标的新DataFrame。

1. 数据准备

首先,我们定义输入数据:一个名为 tours 的列表,其中每个子列表包含两个整数,分别代表X和Y坐标在另一个DataFrame df 中的行索引;以及一个名为 df 的Pandas DataFrame,它包含了我们所需的X和Y坐标以及其他相关信息。

import pandas as pdimport numpy as np# 索引对列表tours = [[0, 4], [0, 5], [0, 6], [1, 13], [2, 0], [3, 8], [4, 9], [5, 10],         [6, 7], [7, 1], [8, 2], [9, 3], [10, 11], [11, 14], [12, 0], [13, 12], [14, 0]]# 原始数据DataFramedata = {    'Node': [2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16],    'X': [5.7735, 2.8867, -2.8868, -5.7735, -2.8867, 2.8868, 8.6603, 0.0000, -8.6603, -8.6603, 0.0000, 8.6603, 5.3405, 3.3198, 6.4952],    'Y': [0.00, 5.00, 5.00, 0.00, -5.00, -5.00, 5.00, 10.00, 5.00, -5.00, -10.00, -5.00, 0.75, 4.25, -1.25],    'Demand': [40.0, 40.0, 40.0, 40.0, 40.0, 40.0, 40.0, 40.0, 40.0, 40.0, 40.0, 40.0, 10.0, 10.0, 10.0],    'Profit': [16.0, 16.0, 16.0, 16.0, 16.0, 16.0, 24.0, 24.0, 24.0, 24.0, 24.0, 24.0, 10.0, 10.0, 11.0]}df = pd.DataFrame(data, index=range(1, 16)) # 注意原始df的索引是从1开始,这里我们保持一致

重要提示: 原始 df 的索引是从1开始的,但在使用 .iloc[] 进行基于位置的索引时,它仍然从0开始计数。这意味着 df.iloc[0] 对应的是 df 的第一行(即索引为1的行)。tours 中的索引 [0, 4] 指的是 df.iloc[0] 的X值和 df.iloc[4] 的Y值。

2. 方法一:基于循环和字典的构建(初步尝试与改进)

一种直观的方法是遍历 tours 列表,在循环中根据索引从 df 中提取X和Y值,然后将这些值存储到一个字典中,最后再将字典转换为DataFrame。

2.1 初始尝试及问题

最初的尝试可能如下所示:

# 初始尝试d = {}for t, tour in enumerate(tours):    xi = tour[0]    yi = tour[1]    key = t    d[key] = df["X"].iloc[xi], df["Y"].iloc[yi]# print(d)# coord_initial = pd.DataFrame(d.items(), columns=['X', 'Y'])# print(coord_initial)

这种方法在将字典 d 转换为DataFrame coord_initial 时会遇到问题。pd.DataFrame(d.items(), columns=[‘X’, ‘Y’]) 会将字典的键(t)作为第一列,而将值(一个包含X和Y的元组)作为第二列,导致Y列存储的是元组,而非期望的两个独立列。

输出示例(错误):

     X                Y0    0   (5.7735, -5.0)...

2.2 改进后的字典转换方法

为了正确地将字典转换为DataFrame,其中字典的键作为索引,值(元组)拆分为两列,我们需要使用 pd.DataFrame.from_dict() 并指定 orient=’index’:

d_improved = {}for t, tour in enumerate(tours):    xi = tour[0]    yi = tour[1]    # 从df中根据iloc索引提取X和Y值    d_improved[t] = df["X"].iloc[xi], df["Y"].iloc[yi]coord_loop_dict = pd.DataFrame.from_dict(d_improved, orient='index', columns=['X', 'Y'])print("方法一:基于循环和字典构建的DataFrame")print(coord_loop_dict)

优点:

逻辑清晰,易于理解,适合初学者。对于小规模数据,性能影响不显著。

缺点:

使用Python循环遍历数据,对于大规模数据集,效率较低,可能成为性能瓶颈。代码相对冗长。

3. 方法二:利用NumPy进行向量化优化(推荐方法)

为了提高性能和代码简洁性,我们可以利用NumPy的向量化操作。这种方法避免了显式的Python循环,将数据操作委托给底层的C语言实现,从而获得显著的速度提升。

核心思想是:

将 tours 列表转换为NumPy数组,以便进行高效的数组操作。将 df 中需要提取的 X 和 Y 列也转换为NumPy数组。利用NumPy的高级索引(Advanced Indexing)功能,一次性从 df 的NumPy数组中提取所有对应的X和Y值。

# 将tours列表转换为NumPy数组tours_np = np.array(tours)# 提取df中X和Y列的数据,转换为NumPy数组# 这样arr[i, 0]就是第i行的X值,arr[i, 1]就是第i行的Y值arr = df[["X", "Y"]].to_numpy()# 使用高级索引一次性获取所有X和Y坐标# tours_np[:, 0] 提取所有X索引# tours_np[:, 1] 提取所有Y索引# arr[tours_np[:, 0], 0] 表示:对于tours_np中的每个X索引,去arr中取对应行的第0列(即X值)# arr[tours_np[:, 1], 1] 表示:对于tours_np中的每个Y索引,去arr中取对应行的第1列(即Y值)x_coords = arr[tours_np[:, 0], 0]y_coords = arr[tours_np[:, 1], 1]# 构建最终的DataFramecoord_numpy = pd.DataFrame({"X": x_coords, "Y": y_coords})print("n方法二:利用NumPy向量化构建的DataFrame")print(coord_numpy)

代码解析:

tours_np = np.array(tours): 将 tours 转换为一个 (N, 2) 形状的NumPy数组,其中 N 是 tours 中子列表的数量。arr = df[[“X”, “Y”]].to_numpy(): 从 df 中选择 X 和 Y 列,并将其转换为一个NumPy数组。这个数组的行索引与 df 的 .iloc 索引一致。tours_np[:, 0]:获取 tours_np 数组的所有第一列元素,即所有X坐标的索引。tours_np[:, 1]:获取 tours_np 数组的所有第二列元素,即所有Y坐标的索引。arr[tours_np[:, 0], 0]:这是一个NumPy高级索引的例子。它会遍历 tours_np[:, 0] 中的每个索引 i,然后从 arr 中取出 arr[i, 0](即第 i 行的X值)。最终结果是一个包含所有所需X值的NumPy数组。arr[tours_np[:, 1], 1]:同理,这会取出所有所需Y值。pd.DataFrame({“X”: x_coords, “Y”: y_coords}):使用两个NumPy数组直接构建新的DataFrame。

优点:

性能卓越: NumPy的底层实现是C语言,向量化操作避免了Python的循环开销,对于处理大量数据时效率极高。代码简洁: 几行代码即可完成复杂的逻辑,提高了代码的可读性和可维护性。Pandas兼容: 结果直接是Pandas DataFrame,方便后续的数据分析和操作。

4. 总结与最佳实践

本教程展示了两种从列表索引和DataFrame中提取坐标并构建新DataFrame的方法。

基于循环和字典的方法 (pd.DataFrame.from_dict(d, orient=’index’, columns=[‘X’,’Y’])):易于理解,适合数据量较小或逻辑复杂需要逐步调试的场景。利用NumPy向量化操作的方法 (pd.DataFrame({“X”: arr[tours_np[:, 0], 0], “Y”: arr[tours_np[:, 1], 1]})):在处理大规模数据集时表现出卓越的性能优势和代码简洁性。这是在Python数据科学中推荐的实践方式。

对于最终目标——使用 X 和 Y 坐标绘制完整路径——这两种方法都能生成所需的 coord DataFrame。然而,考虑到数据处理的效率和代码的优雅性,强烈建议采用NumPy向量化方案。它不仅能更快地生成坐标数据,也为后续的绘图操作(例如使用Matplotlib或Seaborn)提供了标准且高效的数据结构。

以上就是Pandas与NumPy:高效构建基于索引的坐标DataFrame的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1378948.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Python异步编程:实现延迟加载属性的最佳实践
上一篇 2025年12月14日 20:14:46
Psycopg3高效批量插入与冲突处理:executemany的正确姿势
下一篇 2025年12月14日 20:14:59

相关推荐

  • 豆包AI是否能生成代码 豆包代码生成功能及其适用范围分析

    本文将围绕豆包AI是否能生成代码这一问题展开探讨。我们将首先确认其代码生成能力,随后详细讲解如何有效利用此功能,并通过步骤拆解,帮助用户掌握操作过程。最后,会分析该功能的适用场景与潜在局限,以便用户能更全面地理解和运用。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 Deep…

    2026年9月26日
    100
  • 优化VSCode远程SSH开发体验与高性能扩展加载方案

    通过优化SSH连接复用、按需加载扩展、预启动远程服务及本地协同调优,可显著提升VSCode远程开发体验。具体包括:配置ControlMaster实现连接共享,减少重复认证;使用高效加密算法加快传输;通过extensionKind分离本地与远程扩展,降低远程负载;设置VSCODE_AGENT_FOLD…

    2026年9月26日
    000
  • 怎么让豆包AI生成Python数据可视化代码

    怎么让豆包AI生成Python数据可视化代码怎么让豆包AI生成Python数据可视化代码怎么让豆包AI生成Python数据可视化代码怎么让豆包AI生成Python数据可视化代码

    明确需求、指定图表类型和库、提供数据结构或示例,能高效让豆包ai生成python可视化代码。1. 先说明要画什么图,如“柱状图”;2. 指定用哪个库,如matplotlib或seaborn;3. 提供数据结构或部分数据;4. 检查生成代码是否完整,必要时补充导入语句或显示命令。 ☞☞☞AI 智能聊天…

    2026年9月26日 • 用户投稿
    000
  • NVMe驱动器的SLC缓存用完后性能下降多少?

    NVMe驱动器的SLC缓存用完后性能下降多少?NVMe驱动器的SLC缓存用完后性能下降多少?NVMe驱动器的SLC缓存用完后性能下降多少?NVMe驱动器的SLC缓存用完后性能下降多少?

    NVMe驱动器在SLC缓存耗尽后写入速度会骤降至数十到两百MB/s,具体取决于NAND类型、容量和主控方案,QLC型号甚至可能低于机械硬盘速度。 NVMe驱动器在SLC缓存耗尽后,性能会经历显著的下降,通常写入速度会从数百甚至数千MB/s骤降至数十到两百MB/s的水平,具体取决于驱动器采用的NAND…

    2026年9月26日 • 用户投稿
    100
  • sublime怎么配置python开发环境_sublime搭建Python开发环境教程

    sublime怎么配置python开发环境_sublime搭建Python开发环境教程sublime怎么配置python开发环境_sublime搭建Python开发环境教程sublime怎么配置python开发环境_sublime搭建Python开发环境教程sublime怎么配置python开发环境_sublime搭建Python开发环境教程

    首先安装Sublime Text并配置Package Control,接着安装Anaconda等插件以实现代码补全与检查,然后设置Python编译系统运行脚本,最后通过代码格式化、多光标编辑等功能提升开发效率。 Sublime Text 是一款轻量级但功能强大的代码编辑器,适合快速编写和调试 Pyt…

    2026年9月26日 • 用户投稿
    100
  • 多核处理器在运行虚拟机时有哪些优势?

    多核处理器在运行虚拟机时有哪些优势?多核处理器在运行虚拟机时有哪些优势?多核处理器在运行虚拟机时有哪些优势?多核处理器在运行虚拟机时有哪些优势?

    多核处理器通过提升并行处理能力使虚拟机运行更流畅,核心越多,可分配资源越多,减少上下文切换,提高并发效率,配合内存、存储、网络等优化,整体性能显著增强。 多核处理器让虚拟机运行更流畅,简单说,就是能同时处理更多任务,避免卡顿。虚拟机就像电脑里的“套娃”,每个都需要资源,核越多,分到的资源就多,自然跑…

    2026年9月26日 • 用户投稿
    100
  • 如何通过豆包AI进行异常检测?离群值分析实战

    如何通过豆包AI进行异常检测?离群值分析实战如何通过豆包AI进行异常检测?离群值分析实战如何通过豆包AI进行异常检测?离群值分析实战如何通过豆包AI进行异常检测?离群值分析实战

    异常检测是识别数据集中不符合预期模式的数据点的过程,这些“异常”可能由错误、欺诈、设备故障等引起,在金融、网络安全、制造质量控制等领域具有重要意义。常见方法包括基于统计的z-score、iqr法;基于距离的knn;孤立森林;one-class svm;以及深度学习中的自编码器。其中孤立森林因高效性和…

    2026年9月26日 • 用户投稿
    100
  • sublime怎么查看函数列表_sublime显示函数或方法导航列表的方法

    sublime怎么查看函数列表_sublime显示函数或方法导航列表的方法sublime怎么查看函数列表_sublime显示函数或方法导航列表的方法sublime怎么查看函数列表_sublime显示函数或方法导航列表的方法sublime怎么查看函数列表_sublime显示函数或方法导航列表的方法

    使用 Ctrl+R(或 Cmd+R)可打开符号面板查看函数列表,支持搜索并跳转;确保文件类型正确识别以启用解析;搭配 CTags 插件可增强索引与跨文件导航能力。 在 Sublime Text 中查看函数或方法列表,可以通过内置的侧边栏符号导航功能快速实现。这个功能会自动分析当前文件中的函数、类、方…

    2026年9月26日 • 用户投稿
    100
  • 用豆包AI实现Python内存管理优化

    用豆包AI实现Python内存管理优化用豆包AI实现Python内存管理优化用豆包AI实现Python内存管理优化用豆包AI实现Python内存管理优化

    豆包ai可通过分析内存使用模式、优化数据结构与对象创建、辅助编写内存友好代码帮助python内存管理优化。1. 发送代码片段给豆包ai,询问潜在内存问题,如循环引用或缓存未释放,并获得使用gc模块或弱引用的建议;2. 让豆包ai识别低效对象创建和不恰当数据结构,推荐生成器、itertools函数、节…

    2026年9月26日 • 用户投稿
    100
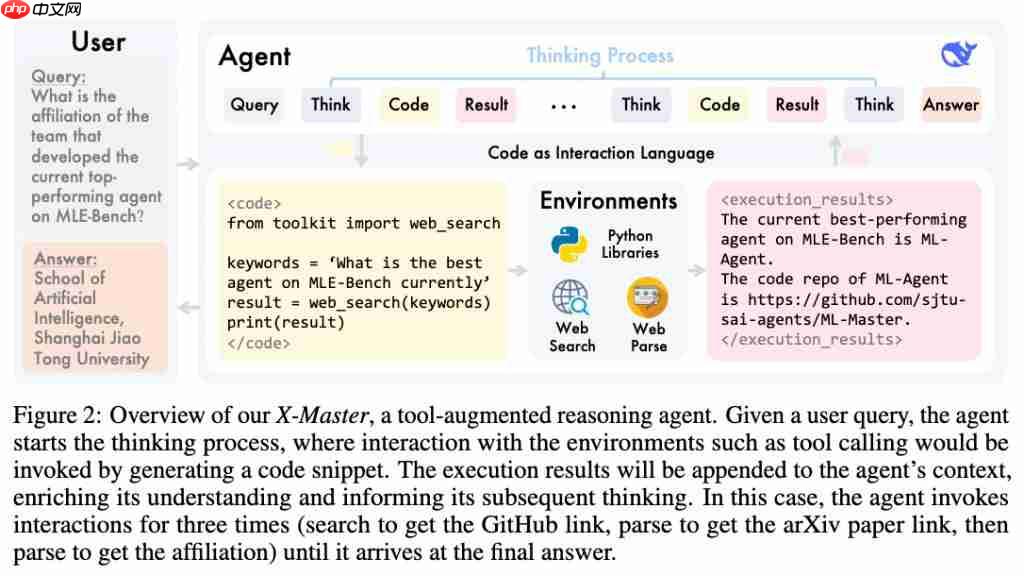
  • DeepSeek-R1 超级外挂!“人类最后的考试”首次突破 30 分,上海交大等开源方案碾压 OpenAI、谷歌

    DeepSeek-R1 超级外挂!“人类最后的考试”首次突破 30 分,上海交大等开源方案碾压 OpenAI、谷歌DeepSeek-R1 超级外挂!“人类最后的考试”首次突破 30 分,上海交大等开源方案碾压 OpenAI、谷歌DeepSeek-R1 超级外挂!“人类最后的考试”首次突破 30 分,上海交大等开源方案碾压 OpenAI、谷歌DeepSeek-R1 超级外挂!“人类最后的考试”首次突破 30 分,上海交大等开源方案碾压 OpenAI、谷歌

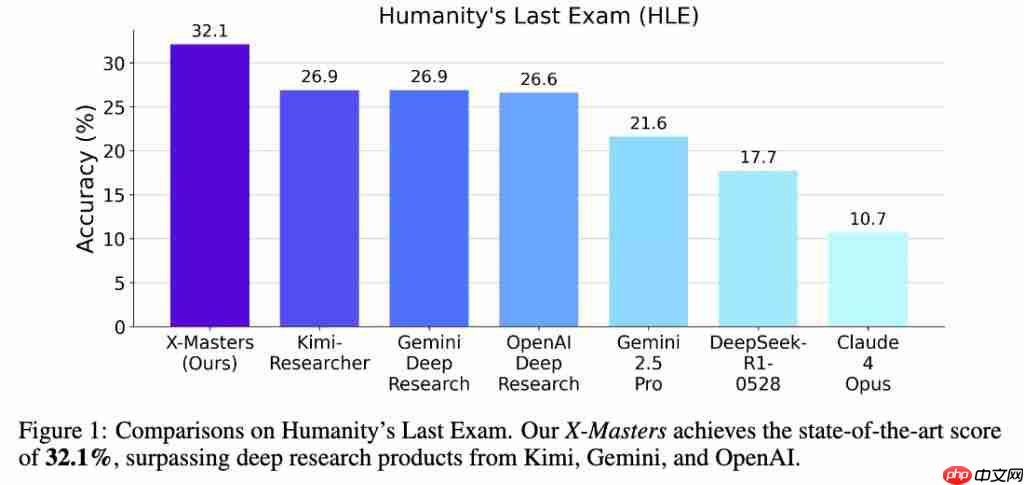
    ” 人类最后的考试 ” 首次突破 30 分,还是咱国内团队干的! 该测试集是出了名的超难,刚推出时无模型得分能超过 10 分。 直到最近,最高分也不过 26.9,由 Kimi-Research 和 Gemini Deep Research 并列取得。 现在,上海交大联合深势科…

    2026年9月26日 • 用户投稿
    200
  • sublime有哪些必装的插件_sublime推荐必装插件清单

    sublime有哪些必装的插件_sublime推荐必装插件清单sublime有哪些必装的插件_sublime推荐必装插件清单sublime有哪些必装的插件_sublime推荐必装插件清单sublime有哪些必装的插件_sublime推荐必装插件清单

    Sublime Text通过插件可大幅提升效率,建议安装Package Control以方便管理插件;SideBarEnhancements增强侧边栏功能,支持文件快速操作;Emmet和代码片段插件提升前端开发速度,实现HTML/CSS/JS的高效编写;Git集成插件支持版本控制操作,GitGutt…

    2026年9月26日 • 用户投稿
    200
  • VSCode如何实现脑机接口编程 VSCode神经信号分析工具集成

    vscode本身没有内置脑机接口功能,而是通过其扩展性支持bci编程。1. 安装python扩展并配置虚拟环境以管理依赖;2. 使用brainflow采集数据、mne-python处理eeg/meg信号,并通过jupyter notebook在vscode中进行交互式分析;3. 利用vscode调试…

    2026年9月26日
    200
  • sublime如何禁用拼写检查_sublime关闭拼写检查方法

    sublime如何禁用拼写检查_sublime关闭拼写检查方法sublime如何禁用拼写检查_sublime关闭拼写检查方法sublime如何禁用拼写检查_sublime关闭拼写检查方法sublime如何禁用拼写检查_sublime关闭拼写检查方法

    Sublime Text默认开启拼写检查,可用红色波浪线标记疑似错误;2. 可通过菜单临时关闭当前文件的拼写检查;3. 修改用户设置添加”spell_check”: false可永久全局关闭;4. 针对特定语言语法文件添加该配置则仅关闭对应类型文件的检查;5. 关闭后红色波浪…

    2026年9月26日 • 用户投稿
    300
  • 用豆包AI生成Python数据挖掘代码

    用豆包AI生成Python数据挖掘代码用豆包AI生成Python数据挖掘代码用豆包AI生成Python数据挖掘代码用豆包AI生成Python数据挖掘代码

    想用豆包ai生成python数据挖掘代码的关键在于明确任务目标和数据结构。1. 首先明确数据挖掘任务类型,如分类、聚类或回归,并具体描述需求,例如“根据用户年龄、消费金额和购买频率做客户分群”。2. 接着提供清晰的数据格式与来源,比如说明csv文件中的字段信息,以便ai进行数据预处理和建模。3. 要…

    2026年9月25日 • 用户投稿
    1000
  • RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启

    RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启

    10月13日,当汽车与高性能计算相遇,会激发出怎样的创意奇迹?nvidia在最新一期geforce garage节目中揭晓了答案。 这一次,他们携手改装界传奇人物JCustom(Justin Chu),将一台完整的RTX 5080游戏主机巧妙植入保时捷911的轮毂之中,实现了汽车工艺与电脑科技的惊艳…

    2026年9月25日 • 用户投稿
    100
  • sublime怎么折叠所有代码_sublime代码折叠快捷方法

    sublime怎么折叠所有代码_sublime代码折叠快捷方法sublime怎么折叠所有代码_sublime代码折叠快捷方法sublime怎么折叠所有代码_sublime代码折叠快捷方法sublime怎么折叠所有代码_sublime代码折叠快捷方法

    Sublime Text 支持多种代码折叠快捷键,Windows/Linux 使用 Ctrl + Shift + [/] 折叠/展开代码块,Ctrl + K, Ctrl + 1 展开所有用 Ctrl + K, Ctrl + J,macOS 用户将 Ctrl 替换为 Command。 在 Sublim…

    2026年9月25日 • 用户投稿
    200
  • 想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​

    想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​

    ai模型组装工具与豆包联用是可行且高效的,关键在于接口兼容性、数据流转和部署方式。具体步骤如下:1. 理解豆包的模型接入规范,包括支持的模型格式、api调用方式及资源需求;2. 在组装工具中完成模型构建、训练与导出,确保符合平台要求;3. 如需转换模型格式(如pytorch转onnx),使用相应工具…

    2026年9月25日 • 用户投稿
    100
  • sublime怎么实现sass/scss的自动编译_sublime配置SASS自动编译方法

    sublime怎么实现sass/scss的自动编译_sublime配置SASS自动编译方法sublime怎么实现sass/scss的自动编译_sublime配置SASS自动编译方法sublime怎么实现sass/scss的自动编译_sublime配置SASS自动编译方法sublime怎么实现sass/scss的自动编译_sublime配置SASS自动编译方法

    安装LiveSassCompiler插件并配置路径后,保存SCSS文件可自动编译为CSS。1. 通过Package Control安装插件;2. 设置输入输出路径;3. 保存文件触发编译,提升开发效率。 Sublime Text 要实现 SASS/SCSS 的自动编译,可以通过安装插件并配置构建系统…

    2026年9月25日 • 用户投稿
    400
  • 如何利用Debian Apache日志提升网站性能

    如何利用Debian Apache日志提升网站性能如何利用Debian Apache日志提升网站性能如何利用Debian Apache日志提升网站性能如何利用Debian Apache日志提升网站性能

    本文将阐述如何通过分析Debian系统下的Apache日志来提升网站性能。 一、日志分析基础 Apache日志记录了所有HTTP请求的详细信息,包括IP地址、时间戳、请求URL、HTTP方法和响应代码等。在Debian系统中,这些日志通常位于/var/log/apache2/access.log和/…

    2026年9月25日 • 用户投稿
    100
  • Debian Apache日志对SEO有何影响

    debian apache日志记录了网站的所有访问请求,包括ip地址、请求类型、响应状态等详细信息。这些日志对于seo有以下几个方面的影响: SEO GPT 免费的白帽SEO,PPC和网站经销商平台 17 查看详情 Apache日志对SEO的重要性 监控网站流量和用户行为:通过分析Apache访问日…

    2026年9月25日
    100

发表回复

登录后才能评论
关注微信