Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
JavaScript中计算通用树节点深度的递归方法_创想鸟

JavaScript中计算通用树节点深度的递归方法

JavaScript中计算通用树节点深度的递归方法

本教程详细介绍了如何在JavaScript中计算任意树结构中指定节点的深度(层级)。通过递归遍历,文章展示了两种核心实现策略:一种是从根节点出发,通过节点名称查找目标并计算深度;另一种是从目标节点视角,计算其相对于给定根节点的深度。文章提供了清晰的代码示例和注意事项,帮助开发者理解并应用这些技术。

理解树节点深度(层级)

在树形数据结构中,节点的“深度”(depth)或“层级”(level)是一个关键概念,它表示从根节点到当前节点的路径长度。通常,我们约定根节点的深度为0,其直接子节点的深度为1,以此类推。与二叉树不同,通用树的每个节点可以拥有任意数量的子节点,这使得其遍历逻辑更具普适性。本文的目标是为给定树中的特定节点,设计一个方法来准确计算其深度。

核心概念:递归遍历

由于树的天然递归结构,递归是解决节点深度计算问题的最直观和高效的方法。

递归原理: 一个节点的问题可以分解为其子节点相同问题的解决方案。终止条件: 当我们找到目标节点时,或者当遍历到叶子节点(没有子节点的节点)仍未找到目标时,递归需要停止。深度累加: 每向下深入一层,深度值就增加1。

方法一:从根节点向下搜索目标节点并计算深度

这种方法模拟了我们通常理解的“查找”过程:从树的顶部开始,逐层向下寻找目标节点。

思路分析:

从树的根节点开始调用计算深度的方法。在当前节点,检查它是否就是我们要查找的目标节点。如果是,那么当前节点的深度就是0(相对于它自身而言)。如果不是目标节点,则遍历当前节点的所有子节点。对每个子节点递归调用相同的深度计算方法。如果某个子节点的递归调用成功找到了目标节点(返回了一个非负的深度值),那么当前节点相对于目标节点的深度就是该子节点返回的深度值加1。如果所有子节点都遍历完毕,但都没有找到目标节点,则表示目标节点不在此分支下,返回一个表示“未找到”的值(例如-1)。

JavaScript实现示例 (按名称查找)

立即学习“Java免费学习笔记(深入)”;

class Node {    constructor(name, ...children) {        this.name = name;        this.children = children;    }    /**     * 从当前节点开始,向下搜索指定名称的节点,并返回其深度。     * 如果当前节点就是目标节点,深度为0。     * 如果未找到,返回-1。     * @param {string} targetName - 目标节点的名称。     * @returns {number} 目标节点的深度,相对于当前调用者而言。     */    getDepth(targetName) {        // 终止条件1:当前节点就是目标节点        if (this.name === targetName) {            return 0;        }        // 递归遍历子节点        for (const child of this.children) {            const depth = child.getDepth(targetName); // 递归调用            // 如果子节点找到了目标(depth >= 0),则当前节点的深度是子节点深度 + 1            if (depth >= 0) {                return depth + 1;            }        }        // 终止条件2:遍历完所有子节点仍未找到        return -1; // 表示未找到    }}// 构建示例树const root = new Node("root",    new Node("A",        new Node("C",            new Node("G"),            new Node("H"),            new Node("I")        ),        new Node("D")    ),    new Node("B",        new Node("E"),        new Node("F")    ));// 调用示例const depthOfC = root.getDepth("C");console.log(`节点C的深度: ${depthOfC}`); // 输出: 节点C的深度: 2const depthOfG = root.getDepth("G");console.log(`节点G的深度: ${depthOfG}`); // 输出: 节点G的深度: 3const depthOfNonExistent = root.getDepth("X");console.log(`节点X的深度: ${depthOfNonExistent}`); // 输出: 节点X的深度: -1

代码解释:getDepth(targetName) 方法在 Node 类中实现。它首先检查当前节点的 name 是否与 targetName 匹配。如果匹配,说明找到了目标,返回 0(因为这是目标节点自身)。如果不匹配,它会遍历 children 数组,对每个子节点递归调用 getDepth。如果任何一个子节点的递归调用返回了非负值(表示在其子树中找到了目标),那么当前节点到目标节点的深度就是该子节点返回的深度加 1。如果所有子节点都遍历完仍未找到,则返回 -1。

方法二:从目标节点视角计算其相对于根节点的深度

这种方法与第一种略有不同,它更符合“C.getLevel()”这种调用方式的语义,即从目标节点本身出发,询问其在整个树中的位置。然而,为了计算“相对于根节点”的深度,我们仍然需要传入根节点作为参照。

思路分析:

方法定义在目标节点上,但需要传入一个“参考根节点”。如果当前节点(即调用方法的this)就是传入的参考根节点,那么它的深度就是0。如果不是根节点,则需要检查根节点的所有直接子节点。对每个子节点,递归地询问“目标节点相对于这个子节点的深度是多少?”如果某个子节点的递归调用成功返回了非负深度值,则说明目标节点在那个子树中,那么目标节点相对于传入的参考根节点的深度就是该子节点返回的深度值加1。如果遍历完所有子节点仍未找到,返回-1。

JavaScript实现示例 (按节点实例查找)

class Node {    constructor(name, ...children) {        this.name = name;        this.children = children;    }    /**     * 计算当前节点相对于指定根节点的深度。     * 如果当前节点就是根节点,深度为0。     * 如果未找到当前节点在根节点下的位置,返回-1。     * @param {Node} rootNode - 作为参考的根节点实例。     * @returns {number} 当前节点相对于rootNode的深度。     */    getDepthWithRespectTo(rootNode) {        // 终止条件1:如果当前节点就是根节点        if (this === rootNode) {            return 0;        }        // 遍历根节点的子节点,寻找当前节点        for (const child of rootNode.children) {            // 递归地在子节点上调用此方法,寻找当前节点            // 注意:这里是 `this` (目标节点) 在 `child` 子树中寻找 `this` 自身相对于 `child` 的深度            const depth = this.getDepthWithRespectTo(child);            // 如果在子节点下找到了当前节点(depth >= 0)            if (depth >= 0) {                return depth + 1; // 深度加1            }        }        // 终止条件2:遍历完所有子节点仍未找到        return -1; // 表示未找到    }}// 构建示例树,并保持对节点C的引用let nodeC;const root = new Node("root",    new Node("A",        nodeC = new Node("C", // 引用节点C            new Node("G"),            new Node("H"),            new Node("I")        ),        new Node("D")    ),    new Node("B",        new Node("E"),        new Node("F")    ));// 调用示例const depthOfC_v2 = nodeC.getDepthWithRespectTo(root);console.log(`节点C相对于根节点的深度: ${depthOfC_v2}`); // 输出: 节点C相对于根节点的深度: 2// 假设我们有一个不在树中的节点const nodeX = new Node("X");const depthOfX_v2 = nodeX.getDepthWithRespectTo(root);console.log(`节点X相对于根节点的深度: ${depthOfX_v2}`); // 输出: 节点X相对于根节点的深度: -1

代码解释:getDepthWithRespectTo(rootNode) 方法定义在 Node 类上。它首先检查调用者 (this) 是否就是传入的 rootNode。如果是,深度为 0。否则,它会遍历 rootNode 的子节点。关键在于,它递归调用的是 this.getDepthWithRespectTo(child),这意味着目标节点 (this) 正在询问它自己相对于 child 节点的深度。如果 child 节点的子树中包含 this 并且返回了非负深度,那么 this 相对于 rootNode 的深度就是那个返回值加 1。

通用注意事项与最佳实践

术语选择: “深度”(Depth)和“层级”(Level)在许多上下文中可以互换使用,但“深度”通常更侧重于节点到根的距离,而“层级”有时可能从1开始计数(根为1)。在本文中,我们统一采用根节点深度为0的约定。错误处理: 当目标节点不存在于树中时,返回 -1 是一个常见的约定,它清晰地表示了“未找到”的状态。性能考量: 这两种递归方法都需要在最坏情况下遍历树的大部分节点才能找到目标。对于非常大的树,如果频繁查询,可以考虑:缓存深度: 在节点对象上存储其深度,但更新树结构时需要重新计算。广度优先搜索 (BFS): BFS 也可以用于查找节点并计算深度,但递归的深度优先搜索 (DFS) 在实现上更简洁。树结构的一致性: 确保所有节点都具有 name 和

以上就是JavaScript中计算通用树节点深度的递归方法的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1519789.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Google Apps Script UI自定义菜单创建指南:避免常见错误
上一篇 2025年12月20日 12:44:04
React-Redux组件状态访问与常见错误排查指南
下一篇 2025年12月20日 12:44:20

相关推荐

  • 使用 Jackson 进行复杂类的自定义反序列化

    使用 Jackson 进行复杂类的自定义反序列化使用 Jackson 进行复杂类的自定义反序列化使用 Jackson 进行复杂类的自定义反序列化使用 Jackson 进行复杂类的自定义反序列化

    本文介绍了如何使用 Jackson 库对包含复杂嵌套类的 JSON 字符串进行自定义反序列化。通过 ObjectMapper 的 readValue 方法可以实现简单场景下的自动反序列化。针对需要定制化处理的场景,可以结合 ObjectMapper 和自定义反序列化器来实现更灵活的反序列化逻辑,并提…

    2026年9月25日 • 用户投稿
    900
  • p5.js WebGL性能优化:首帧渲染耗时长的原因与对策

    p5.js WebGL性能优化:首帧渲染耗时长的原因与对策p5.js WebGL性能优化:首帧渲染耗时长的原因与对策p5.js WebGL性能优化:首帧渲染耗时长的原因与对策p5.js WebGL性能优化:首帧渲染耗时长的原因与对策

    在使用p5.js的WEBGL渲染模式时,首次调用image()函数渲染图片或p5.Graphics对象通常会比后续调用耗时显著增加。这主要是因为第一次渲染时,p5.js需要将图像数据从CPU内存上传到GPU的纹理内存中,涉及内存分配和数据复制,这是一个相对耗时的过程。后续调用由于纹理已被缓存,可以直…

    2026年9月25日 • 用户投稿
    700
  • sublime怎么配置eslint进行js校验_sublime集成ESLint代码检查配置

    sublime怎么配置eslint进行js校验_sublime集成ESLint代码检查配置sublime怎么配置eslint进行js校验_sublime集成ESLint代码检查配置sublime怎么配置eslint进行js校验_sublime集成ESLint代码检查配置sublime怎么配置eslint进行js校验_sublime集成ESLint代码检查配置

    首先安装SublimeLinter和SublimeLinter-eslint插件,确保系统或项目中已安装ESLint;通过npx eslint –init生成配置文件;插件会自动调用项目内的eslint,若未识别可手动设置executable路径;保存JavaScript文件时即可实时显…

    2026年9月25日 • 用户投稿
    000
  • Java 8 使用 Stream API 扁平化嵌套 Map 并提取首个元素

    Java 8 使用 Stream API 扁平化嵌套 Map 并提取首个元素Java 8 使用 Stream API 扁平化嵌套 Map 并提取首个元素Java 8 使用 Stream API 扁平化嵌套 Map 并提取首个元素Java 8 使用 Stream API 扁平化嵌套 Map 并提取首个元素

    本文将详细介绍如何使用 Java 8 的 Stream API 将一个嵌套的 Map 结构进行扁平化处理,并从中提取所需的数据。 具体来说,我们将把 Map<Integer, Map<String, List>> 转换为 Map,其中新 Map 的键是原内部 Map 的键,值…

    2026年9月25日 • 用户投稿
    1200
  • 修改 Android KeyStore 中 KeyPair 的用途

    修改 Android KeyStore 中 KeyPair 的用途修改 Android KeyStore 中 KeyPair 的用途修改 Android KeyStore 中 KeyPair 的用途修改 Android KeyStore 中 KeyPair 的用途

    本文档介绍了如何在 Android KeyStore 中修改现有 KeyPair 的用途,使其支持密钥协商 (Key Agreement) 操作。通过示例代码展示了如何利用 KeyStore.setEntry 方法在 Android 13 (API 33) 及以上版本中导入 KeyPair 并设置所…

    2026年9月25日 • 用户投稿
    600
  • 并发处理共享列表并收集结果的方案

    并发处理共享列表并收集结果的方案并发处理共享列表并收集结果的方案并发处理共享列表并收集结果的方案并发处理共享列表并收集结果的方案

    本文旨在介绍如何利用 Java 并行流高效地处理大型列表,尤其是在每个元素的处理过程耗时较长的情况下。并行流能够将列表分割成多个子任务,并在多个线程上并发执行,从而显著提升处理速度。但同时,并发编程也带来了共享资源同步的问题,需要谨慎处理。 使用并行流并发处理列表 假设我们有一个 Foo 类,其 p…

    2026年9月25日 • 用户投稿
    000
  • 高效并发处理共享列表与结果收集的Java教程

    高效并发处理共享列表与结果收集的Java教程高效并发处理共享列表与结果收集的Java教程高效并发处理共享列表与结果收集的Java教程高效并发处理共享列表与结果收集的Java教程

    本文介绍了如何利用Java并发特性,特别是并行流(Parallel Streams),来高效处理共享列表,并将处理结果进行收集。针对耗时操作,通过将列表分割成子列表,并利用并行流并发执行,可以显著提高处理效率。同时,强调了在并发环境下对共享资源进行同步的重要性,并提供了收集处理结果的示例代码。 在处…

    2026年9月25日 • 用户投稿
    000
  • 使用并行流并发处理共享列表并收集结果

    使用并行流并发处理共享列表并收集结果使用并行流并发处理共享列表并收集结果使用并行流并发处理共享列表并收集结果使用并行流并发处理共享列表并收集结果

    本文将探讨如何高效地并发处理共享列表,并收集处理结果。在处理大量数据时,将任务分解为多个子任务并行执行可以显著提高效率。Java 8引入的并行流(Parallel Streams)为我们提供了一种简洁而强大的方式来实现这一目标。 并行流简介 并行流是Java 8 Stream API的一个特性,它允…

    2026年9月25日 • 用户投稿
    400
  • 如何在微服务之间共享静态数据

    如何在微服务之间共享静态数据如何在微服务之间共享静态数据如何在微服务之间共享静态数据如何在微服务之间共享静态数据

    微服务架构的本质决定了微服务之间无法直接共享静态变量。正如上面摘要所说,每个微服务都是一个独立的进程,拥有自己的内存空间,静态变量只在其所属的进程内有效。试图在一个微服务中访问另一个微服务的静态变量,就像试图在一个独立的Java程序中访问另一个程序的变量一样,是不可能的。 微服务架构的独立性 微服务…

    2026年9月25日 • 用户投稿
    100
  • FineReport与.NET集成要点

    FineReport与.NET集成要点FineReport与.NET集成要点FineReport与.NET集成要点FineReport与.NET集成要点

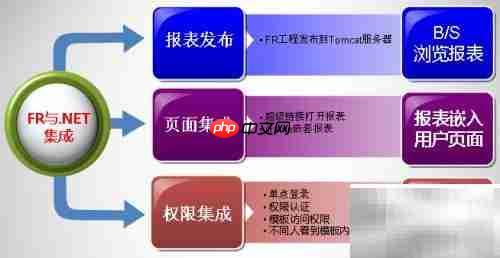
    1、FineReport(FR)与.NET项目的集成主要涵盖三个核心部分,如上图所示。 2、报表发布是集成过程中的关键步骤之一。 3、需要注意的是,FR报表工程本质上是基于Java的Servlet应用,无法由IIS直接解析处理,因此必须将其部署在支持Servlet规范的Web应用服务器(如Tomca…

    2026年9月25日 • 用户投稿
    200
  • 如何在微服务之间共享静态数据?

    如何在微服务之间共享静态数据?如何在微服务之间共享静态数据?如何在微服务之间共享静态数据?如何在微服务之间共享静态数据?

    在微服务架构中,各个服务都是独立的部署单元,拥有各自的内存空间。如同上述摘要所述,直接通过静态变量在不同的微服务之间共享数据是不可能的。 试图在一个微服务中设置静态变量的值,然后在另一个微服务中访问它,将会得到 null 或初始值,而不是之前设置的值。 这不是 Spring Boot 特有的问题,而…

    2026年9月25日 • 用户投稿
    100
  • Micronaut中动态数据结构的类型安全验证策略

    Micronaut中动态数据结构的类型安全验证策略Micronaut中动态数据结构的类型安全验证策略Micronaut中动态数据结构的类型安全验证策略Micronaut中动态数据结构的类型安全验证策略

    本文探讨了在Micronaut应用中,如何有效处理具有动态属性和类型依赖验证的类。通过引入多态接口、特化实现类以及自定义Jackson反序列化器,我们能够实现对复杂动态数据结构的类型安全解析与精细化验证,确保数据完整性和业务规则的正确执行。 动态数据结构的验证挑战 在现代微服务架构中,经常会遇到需要…

    2026年9月25日 • 用户投稿
    1000
  • sublime怎么让不同类型文件使用不同的缩进设置 _sublime不同文件缩进设置方法

    sublime怎么让不同类型文件使用不同的缩进设置 _sublime不同文件缩进设置方法sublime怎么让不同类型文件使用不同的缩进设置 _sublime不同文件缩进设置方法sublime怎么让不同类型文件使用不同的缩进设置 _sublime不同文件缩进设置方法sublime怎么让不同类型文件使用不同的缩进设置 _sublime不同文件缩进设置方法

    Sublime Text 可根据不同文件类型自动应用缩进设置,通过语法专属配置实现。1. 打开文件后点击右下角语法名称,选择 Open Syntax Specific Settings;2. 在配置文件中设置 tab_size 和 translate_tabs_to_spaces,如 Python …

    2026年9月25日 • 用户投稿
    100
  • Hibernate/Spring Boot中复合主键与多对多关联的实现指南

    Hibernate/Spring Boot中复合主键与多对多关联的实现指南Hibernate/Spring Boot中复合主键与多对多关联的实现指南Hibernate/Spring Boot中复合主键与多对多关联的实现指南Hibernate/Spring Boot中复合主键与多对多关联的实现指南

    本教程详细阐述了在Spring Boot和Hibernate框架中,如何优雅地处理具有附加属性的多对多关系,特别是当连接表需要复合主键时。我们将通过构建一个用户电影评分系统为例,深入探讨@EmbeddedId、@Embeddable以及@OneToMany、@ManyToOne等JPA注解的实际应用…

    2026年9月25日 • 用户投稿
    100
  • sublime的goto symbol in project功能怎么用_sublime Goto Symbol in Project使用方法

    sublime的goto symbol in project功能怎么用_sublime Goto Symbol in Project使用方法sublime的goto symbol in project功能怎么用_sublime Goto Symbol in Project使用方法sublime的goto symbol in project功能怎么用_sublime Goto Symbol in Project使用方法sublime的goto symbol in project功能怎么用_sublime Goto Symbol in Project使用方法

    使用快捷键Ctrl+Shift+R(Win/Linux)或Cmd+Shift+R(Mac)可快速调用Goto Symbol in Project功能,通过搜索符号名称跳转到函数、类等定义位置,支持模糊匹配与实时过滤,需确保项目已添加至侧边栏且语法包正确安装以保证索引识别效果。 Sublime Tex…

    2026年9月25日 • 用户投稿
    200
  • 解决Android Studio Gradle构建问题的网络仓库配置指南

    解决Android Studio Gradle构建问题的网络仓库配置指南解决Android Studio Gradle构建问题的网络仓库配置指南解决Android Studio Gradle构建问题的网络仓库配置指南解决Android Studio Gradle构建问题的网络仓库配置指南

    本文旨在解决Android Studio项目中因网络限制导致的Gradle构建失败问题,特别是“插件未找到”等错误。核心解决方案是通过配置替代的Maven仓库(如阿里云镜像)来绕过网络障碍,确保Gradle能够成功解析和下载所需的插件与依赖,从而恢复项目的正常构建。 1. 问题背景与常见症状 在an…

    2026年9月25日 • 用户投稿
    100
  • 谷歌浏览器开发者工具网络面板数据延迟如何修复

    谷歌浏览器开发者工具网络面板数据延迟如何修复谷歌浏览器开发者工具网络面板数据延迟如何修复谷歌浏览器开发者工具网络面板数据延迟如何修复谷歌浏览器开发者工具网络面板数据延迟如何修复

    延迟通常由网络环境、浏览器状态或页面性能导致。先通过Waterfall分析DNS、TCP等阶段耗时,确认是否真实延迟;更换网络或设备对比速度;清除缓存、禁用缓存或使用无痕模式排除干扰;检查代理设置并切换为公共DNS;最后结合Performance面板排查脚本阻塞与资源瓶颈。 Chrome开发者工具网…

    2026年9月25日 • 用户投稿
    900
  • 统一解析ISO Zoned Date-Time格式的日期字符串

    统一解析ISO Zoned Date-Time格式的日期字符串统一解析ISO Zoned Date-Time格式的日期字符串统一解析ISO Zoned Date-Time格式的日期字符串统一解析ISO Zoned Date-Time格式的日期字符串

    本教程详细阐述如何在Java 8+中使用java.time API统一解析看似不同但实则遵循ISO 8601扩展ISO_ZONED_DATE_TIME格式的日期字符串。通过ZonedDateTime的直接解析能力和OffsetDateTime结合DateTimeFormatter.ISO_ZONED…

    2026年9月25日 • 用户投稿
    100
  • sublime怎么安装和使用DocBlockr插件_sublime使用DocBlockr生成注释的教程

    sublime怎么安装和使用DocBlockr插件_sublime使用DocBlockr生成注释的教程sublime怎么安装和使用DocBlockr插件_sublime使用DocBlockr生成注释的教程sublime怎么安装和使用DocBlockr插件_sublime使用DocBlockr生成注释的教程sublime怎么安装和使用DocBlockr插件_sublime使用DocBlockr生成注释的教程

    安装DocBlockr插件:通过Package Control搜索并安装DocBlockr;2. 使用方法:在函数上方输入/**后回车,自动生成含参数、返回值的注释块;3. 配置优化:可设置快捷键、自定义模板及扩展语言支持,提升注释效率。 在Sublime Text中安装和使用DocBlockr插件…

    2026年9月25日 • 用户投稿
    1200
  • 使用Apache POI处理日期显示为””的解决方案

    使用Apache POI处理日期显示为””的解决方案使用Apache POI处理日期显示为””的解决方案使用Apache POI处理日期显示为””的解决方案使用Apache POI处理日期显示为””的解决方案

    在使用Apache POI导出Excel时,日期(特别是早期年份)显示为”####”通常是由于单元格宽度不足以完整显示日期值所致。本文将深入探讨这一常见问题,并提供通过调整单元格宽度来有效解决此问题的具体方法和示例代码,确保日期数据能够正确无误地呈现。 问题描述:Apache…

    2026年9月25日 • 用户投稿
    000

发表回复

登录后才能评论
关注微信