解决Python Requests访问受限链接:理解与应用Referer头

解决Python Requests访问受限链接:理解与应用Referer头

在使用python的requests库抓取网页内容时,有时会遇到无法直接访问目标链接,而必须通过点击来源页面的按钮才能成功跳转的情况。这通常是由于服务器端验证了http请求中的referer头部信息。本文将深入解析referer头的作用,并提供详细的python代码示例,指导开发者如何正确设置referer头,以模拟浏览器行为,从而成功访问这些受限的跳转链接。

探索链接访问受限的机制

在网络爬虫或自动化脚本开发中,我们经常会遇到一种特殊情况:某个链接无法通过直接复制粘贴到浏览器地址栏或使用requests.get()方法直接访问,但通过点击网页上的一个按钮或链接却能正常跳转到目标资源。例如,在尝试访问https://www.thenetnaija.net/videos/kdrama/16426-alchemy-of-souls/season-1/episode-7/download时,直接访问可能只会重定向回来源页面https://www.thenetnaija.net/videos/kdrama/16426-alchemy-of-souls/season-1/episode-7,而无法抵达真正的下载地址https://www.sabishare.com/file/mHxiMiZHW15-alchemy-of-souls-s01e07-netnaija-com-mp4。

这种现象的背后,往往是服务器端对HTTP请求中的Referer(注意,HTTP标准中拼写为Referer,而非Referrer)头部信息进行了校验。Referer头是一个HTTP请求头,它包含了当前请求的来源页面的URL。当用户在浏览器中点击一个链接时,浏览器会自动在发起的下一个请求中携带Referer头,其值就是用户当前所在页面的URL。网站服务器可以利用这个信息来:

安全验证: 确保请求来源于其预期的页面,防止未经授权的直接访问或“盗链”。流量分析: 统计不同来源页面的流量。防止恶意行为: 阻止某些自动化脚本绕过正常的导航路径。

当我们的Python脚本直接请求目标链接时,由于没有附带Referer头,或者附带的Referer头不符合服务器的预期(例如,Referer值是脚本自身的URL,或根本没有),服务器便会拒绝请求或将其重定向回来源页面,从而阻止我们访问最终的目标资源。

理解并设置Referer头

解决上述问题的关键在于,在发起HTTP请求时,手动设置Referer头,使其模拟浏览器从包含跳转按钮的页面发起的请求。Referer头的值应该设置为包含目标链接的那个页面的URL。

立即学习“Python免费学习笔记(深入)”;

以提供的案例为例:

目标下载链接:https://www.thenetnaija.net/videos/kdrama/16426-alchemy-of-souls/season-1/episode-7/download包含下载按钮的来源页面:https://www.thenetnaija.net/videos/kdrama/16426-alchemy-of-souls/season-1/episode-7

因此,我们在请求目标下载链接时,需要将Referer头的值设置为https://www.thenetnaija.net/videos/kdrama/16426-alchemy-of-souls/season-1/episode-7。

使用Python Requests库实现

Python的requests库提供了非常方便的方式来添加自定义的HTTP请求头。我们可以通过在requests.get()或requests.post()方法中传入一个字典作为headers参数来完成。

以下是具体的代码示例,演示如何正确设置Referer头以访问受限链接:

import requests# 目标下载链接,这是我们尝试直接访问但失败的链接target_url = 'https://www.thenetnaija.net/videos/kdrama/16426-alchemy-of-souls/season-1/episode-7/download'# 包含下载按钮的来源页面URL,即Referer的值# 这是浏览器在点击按钮时会发送的Referer头的值referrer_url = 'https://www.thenetnaija.net/videos/kdrama/16426-alchemy-of-souls/season-1/episode-7'# 构造请求头字典# Referer头是解决问题的关键# 建议同时添加User-Agent,以模拟更真实的浏览器行为,减少被识别为爬虫的风险headers = {    'Referer': referrer_url,    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124124 Safari/537.36'}print(f"尝试访问目标URL: {target_url}")print(f"使用Referer: {referrer_url}")try:    # 发送GET请求,携带自定义的headers    # allow_redirects=True 确保requests库会自动处理HTTP重定向    response = requests.get(target_url, headers=headers, allow_redirects=True)    # 打印最终重定向的URL,验证是否成功访问到目标资源    print(f"n请求完成。最终访问的URL: {response.url}")    # 检查响应状态码    if response.status_code == 200:        print("请求成功!")        # 如果最终URL与预期目标下载地址一致,说明成功        if "sabishare.com" in response.url: # 简单判断是否到达了预期的下载网站            print("成功重定向到目标下载页面。")            # 在这里可以进一步处理下载内容,例如保存到文件            # with open("downloaded_file.mp4", "wb") as f:            #     f.write(response.content)            # print("文件已成功下载。")        else:            print("未能重定向到预期的下载页面,请检查Referer或目标URL。")            # print("响应内容预览:n", response.text[:500]) # 打印前500个字符以供调试    else:        print(f"请求失败,状态码: {response.status_code}")        print(f"响应内容:n{response.text}")except requests.exceptions.RequestException as e:    print(f"请求发生错误: {e}")

代码解析:

target_url: 这是我们最终想要获取内容的URL,但直接访问会失败。referrer_url: 这是包含下载按钮的那个页面的URL。它的值将作为Referer头发送。headers字典:’Referer’: referrer_url:这是解决问题的核心。它告诉服务器,我们的请求是从referrer_url这个页面跳转过来的。’User-Agent’: 虽然不是强制性的,但强烈建议添加User-Agent头。它模拟了浏览器的身份信息,许多网站会根据User-Agent来判断请求是否来自真实的浏览器。不设置或设置不当的User-Agent也可能导致请求被拒绝。requests.get(target_url, headers=headers, allow_redirects=True):headers=headers:将我们自定义的请求头传递给requests。allow_redirects=True:这是requests库的默认行为,表示允许请求跟随HTTP重定向。在这种场景下,目标链接会先重定向到实际的下载地址,所以确保这个参数为True非常重要。

通过运行上述代码,你会发现response.url将不再是最初的来源页面,而是成功跳转到了https://www.sabishare.com/file/mHxiMiZHW15-alchemy-of-souls-s01e07-netnaija-com-mp4这样的最终下载地址,从而解决了直接访问受限的问题。

注意事项与最佳实践

Referer头的准确性: 确保Referer头的值是目标链接所在页面的完整URL。任何细微的差别(如协议、子域名、路径等)都可能导致服务器拒绝请求。User-Agent头: 始终建议在爬虫请求中设置User-Agent头,并使其看起来像一个真实的浏览器。这有助于降低被网站识别为爬虫并被屏蔽的风险。Cookies和会话: 如果目标网站需要登录或依赖于会话管理,你可能还需要在请求中包含相应的Cookies。requests.Session()对象可以帮助你管理会话和Cookies。动态内容与JavaScript: 本文介绍的方法主要适用于基于HTTP头进行验证的重定向。如果网站的跳转逻辑涉及复杂的JavaScript执行(例如,通过AJAX请求动态生成链接,或通过JS进行客户端重定向),那么仅使用requests库可能不足以解决问题。在这种情况下,你可能需要考虑使用Selenium等自动化测试工具来模拟完整的浏览器行为。网站爬取政策: 在进行任何形式的网络爬取之前,请务必查阅网站的robots.txt文件和使用条款,确保你的行为符合网站的规定和法律法规。错误处理: 在实际应用中,务必添加健壮的错误处理机制(如try-except块),以应对网络问题、HTTP状态码非200、解析错误等情况。

总结

当使用Python requests库访问某些网站链接时,如果遇到直接访问失败而必须通过点击来源页面按钮才能成功跳转的情况,这通常是由于服务器端对HTTP请求中的Referer头进行了验证。通过在请求头中正确设置Referer字段为包含目标链接的来源页面URL,我们可以有效地模拟浏览器行为,绕过这种访问限制,成功获取目标资源。同时,结合User-Agent等其他常用HTTP头,可以进一步提高爬虫的隐蔽性和成功率。

以上就是解决Python Requests访问受限链接:理解与应用Referer头的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1598906.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
使用PHP和JavaScript实现无刷新表单提交与数据保留的教程
上一篇 2025年12月23日 13:19:37
CSS垂直线显示问题诊断与修复指南
下一篇 2025年12月23日 13:19:50

相关推荐

  • 几个方法教会你windows10电脑如何录屏

    几个方法教会你windows10电脑如何录屏几个方法教会你windows10电脑如何录屏几个方法教会你windows10电脑如何录屏几个方法教会你windows10电脑如何录屏

    随着如今电脑技术的持续发展,不断升级的电脑系统总会带来许多新功能。前几天,有位粉丝朋友在网上的评论区向我提问,询问如何用windows 10电脑进行录屏。实际上,这个问题并不复杂,因为我们的电脑本身就已经具备这一功能了。下面,我就详细地为大家讲解一下具体的操作步骤。 首先,我们打开电脑,在桌面右下角…

    2026年9月25日 • 用户投稿
    300
  • sublime怎么设置python linter_sublime Python Linter配置方法

    sublime怎么设置python linter_sublime Python Linter配置方法sublime怎么设置python linter_sublime Python Linter配置方法sublime怎么设置python linter_sublime Python Linter配置方法sublime怎么设置python linter_sublime Python Linter配置方法

    首先安装SublimeLinter插件及SublimeLinter-pylint或SublimeLinter-flake8,然后通过pip安装pylint或flake8,最后在SublimeLinter设置中配置Python可执行文件路径和检查模式,启用实时与保存时检查即可实现Python代码质量监…

    2026年9月25日 • 用户投稿
    000
  • p5.js WebGL性能优化:首帧渲染耗时长的原因与对策

    p5.js WebGL性能优化:首帧渲染耗时长的原因与对策p5.js WebGL性能优化:首帧渲染耗时长的原因与对策p5.js WebGL性能优化:首帧渲染耗时长的原因与对策p5.js WebGL性能优化:首帧渲染耗时长的原因与对策

    在使用p5.js的WEBGL渲染模式时,首次调用image()函数渲染图片或p5.Graphics对象通常会比后续调用耗时显著增加。这主要是因为第一次渲染时,p5.js需要将图像数据从CPU内存上传到GPU的纹理内存中,涉及内存分配和数据复制,这是一个相对耗时的过程。后续调用由于纹理已被缓存,可以直…

    2026年9月25日 • 用户投稿
    700
  • Chrome浏览器怎么把所有标签页加入书签_一键收藏全部打开的标签页

    Chrome浏览器怎么把所有标签页加入书签_一键收藏全部打开的标签页Chrome浏览器怎么把所有标签页加入书签_一键收藏全部打开的标签页Chrome浏览器怎么把所有标签页加入书签_一键收藏全部打开的标签页Chrome浏览器怎么把所有标签页加入书签_一键收藏全部打开的标签页

    1、使用Ctrl+Shift+D可将当前所有标签页一键保存为书签文件夹;2、通过安装“Save All Tabs”等扩展程序实现选择性保存或导出链接;3、手动拖拽标签至书签栏后,利用书签管理器归类整理。 如果您在Chrome浏览器中打开了多个需要长期保存的网页标签,手动逐一收藏会非常耗时。通过特定操…

    2026年9月25日 • 用户投稿
    200
  • 为什么不同浏览器对硬件加速的实现存在差异?

    不同浏览器因渲染引擎、图形API及权衡策略差异导致硬件加速表现不同。1. Blink、Gecko、WebKit引擎在图层管理与GPU任务分配上设计不同;2. 各浏览器通过ANGLE等抽象层适配DirectX、Vulkan、Metal,转换开销与支持程度影响性能;3. 厂商在性能、兼容性、稳定性间取舍…

    2026年9月25日
    100
  • win11事件查看器在哪里打开_win11事件查看器打开路径介绍

    win11事件查看器在哪里打开_win11事件查看器打开路径介绍win11事件查看器在哪里打开_win11事件查看器打开路径介绍win11事件查看器在哪里打开_win11事件查看器打开路径介绍win11事件查看器在哪里打开_win11事件查看器打开路径介绍

    答案:可通过五种方式打开Windows 11事件查看器。依次为:开始菜单搜索“事件查看器”或eventvwr;使用Win+R运行eventvwr.msc;右键“此电脑”进入计算机管理并选择事件查看器;按Win+X后选事件查看器;通过控制面板的管理工具双击启动。 如果您需要排查系统故障或查看计算机的运…

    2026年9月25日 • 用户投稿
    000
  • sublime怎么配置eslint进行js校验_sublime集成ESLint代码检查配置

    sublime怎么配置eslint进行js校验_sublime集成ESLint代码检查配置sublime怎么配置eslint进行js校验_sublime集成ESLint代码检查配置sublime怎么配置eslint进行js校验_sublime集成ESLint代码检查配置sublime怎么配置eslint进行js校验_sublime集成ESLint代码检查配置

    首先安装SublimeLinter和SublimeLinter-eslint插件,确保系统或项目中已安装ESLint;通过npx eslint –init生成配置文件;插件会自动调用项目内的eslint,若未识别可手动设置executable路径;保存JavaScript文件时即可实时显…

    2026年9月25日 • 用户投稿
    000
  • firefox浏览器怎么截图整个网页 Firefox浏览器滚动长截图功能使用教程

    firefox浏览器怎么截图整个网页 Firefox浏览器滚动长截图功能使用教程firefox浏览器怎么截图整个网页 Firefox浏览器滚动长截图功能使用教程firefox浏览器怎么截图整个网页 Firefox浏览器滚动长截图功能使用教程firefox浏览器怎么截图整个网页 Firefox浏览器滚动长截图功能使用教程

    Firefox可通过内置截图工具截取长网页,点击菜单选择“截图”或使用Ctrl+Shift+S,再点“截取整页”即可保存完整页面。 如果您在浏览网页时需要保存完整页面内容,但Firefox默认仅截取当前可见区域,则可以通过内置的截图工具扩展功能实现全页截图。以下是具体操作方法: 本文运行环境:Del…

    2026年9月25日 • 用户投稿
    000
  • PHP文件引入时参数传递机制详解与最佳实践

    在php中,直接通过url查询字符串方式向`require`或`include`引入的文件传递参数是无效的,这会导致“未定义变量”错误。本文将深入探讨php文件引入的原理,并提供三种正确的参数传递方法:利用作用域共享、手动填充`$_get`数组,以及推荐的通过函数或类进行封装,旨在帮助开发者构建更健…

    2026年9月25日
    000
  • win10怎么彻底关闭快速启动功能

    win10怎么彻底关闭快速启动功能win10怎么彻底关闭快速启动功能win10怎么彻底关闭快速启动功能win10怎么彻底关闭快速启动功能

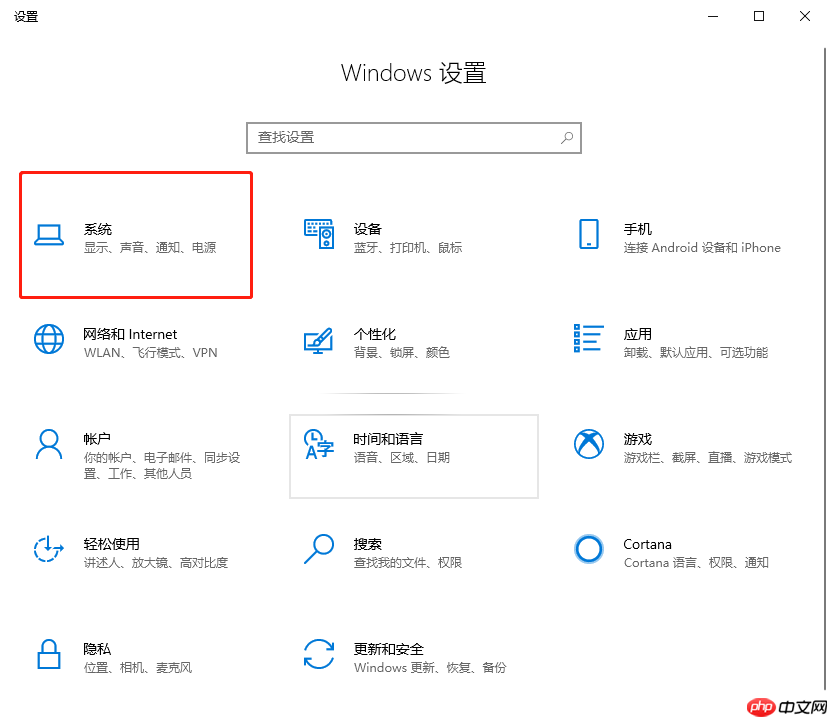
    有的用户在完成win10系统的安装后,想要再次进入bios设置界面,却发现无法顺利进入。这是因为在win10中启用了全新的快速启动机制,导致开机时直接跳转至系统界面,而不会显示主板自检画面。因此,我们只需关闭该功能即可正常进入bios。 操作步骤: 方法一: 打开“开始菜单”,点击其中的“设置”图标…

    2026年9月25日 • 用户投稿
    200
  • Safari浏览器怎么查看网页源代码_Safari浏览器网页HTML源代码查看方式

    Safari浏览器怎么查看网页源代码_Safari浏览器网页HTML源代码查看方式Safari浏览器怎么查看网页源代码_Safari浏览器网页HTML源代码查看方式Safari浏览器怎么查看网页源代码_Safari浏览器网页HTML源代码查看方式Safari浏览器怎么查看网页源代码_Safari浏览器网页HTML源代码查看方式

    首先启用Safari开发菜单,然后通过菜单命令或快捷键Option+Command+U查看完整HTML源代码;也可右键选择检查元素,使用Web检查器查看特定区域的DOM结构与样式信息。 如果您在浏览网页时需要检查页面的结构或调试内容,查看网页源代码是一个常用的方法。Safari浏览器提供了多种方式来…

    2026年9月25日 • 用户投稿
    000
  • Java 8 使用 Stream API 扁平化嵌套 Map 并提取首个元素

    Java 8 使用 Stream API 扁平化嵌套 Map 并提取首个元素Java 8 使用 Stream API 扁平化嵌套 Map 并提取首个元素Java 8 使用 Stream API 扁平化嵌套 Map 并提取首个元素Java 8 使用 Stream API 扁平化嵌套 Map 并提取首个元素

    本文将详细介绍如何使用 Java 8 的 Stream API 将一个嵌套的 Map 结构进行扁平化处理,并从中提取所需的数据。 具体来说,我们将把 Map<Integer, Map<String, List>> 转换为 Map,其中新 Map 的键是原内部 Map 的键,值…

    2026年9月25日 • 用户投稿
    1200
  • 惠普电脑如何进入安全模式

    惠普电脑如何进入安全模式惠普电脑如何进入安全模式惠普电脑如何进入安全模式惠普电脑如何进入安全模式

    在日常维护计算机时,我们有时需要进入安全模式来进行一些检查和修复工作,以解决系统出现的问题。不过,对于一些使用惠普电脑的用户来说,可能并不清楚如何让惠普电脑进入安全模式。接下来,小编将为大家介绍几种惠普电脑进入安全模式的方法,这里以windows 10为例。 方法一: 按下Windows徽标键+R,…

    2026年9月25日 • 用户投稿
    100
  • 对话逐际动力张巍:造机器人很容易,关键是用起来

    对话逐际动力张巍:造机器人很容易,关键是用起来对话逐际动力张巍:造机器人很容易,关键是用起来对话逐际动力张巍:造机器人很容易,关键是用起来对话逐际动力张巍:造机器人很容易,关键是用起来

    “让天下没有难落地的机器人。” 在这样向量子位表达定位和使命后,逐际动力”解释了”为何会成为阿里投资的第一家具身智能机器人公司。 在这样解释定位和使命后,量子位大概感受到了逐际动力被投资的原因—— 至少是成为阿里第一个具身智能投资项目的原因。 实际上,…

    2026年9月25日 • 用户投稿
    500
  • Word文档全选文本怎么做_Word文档全选文本如何做详细方法

    Word文档全选文本怎么做_Word文档全选文本如何做详细方法Word文档全选文本怎么做_Word文档全选文本如何做详细方法Word文档全选文本怎么做_Word文档全选文本如何做详细方法Word文档全选文本怎么做_Word文档全选文本如何做详细方法

    全选Word文档最常用方法是使用快捷键Ctrl+A(Windows)或Command+A(Mac),可快速选中全部内容;也可通过“开始”选项卡中“编辑”组的“选择”命令进行全选;小文档可用鼠标拖动选中;在分节或多栏文档中需确保页面视图并尝试双击“全选”以避免遗漏,推荐优先使用快捷键操作。 在Word…

    2026年9月25日 • 用户投稿
    600
  • Chrome浏览器怎么禁止图片和视频自动加载_网页媒体内容自动加载禁用教程

    Chrome浏览器怎么禁止图片和视频自动加载_网页媒体内容自动加载禁用教程Chrome浏览器怎么禁止图片和视频自动加载_网页媒体内容自动加载禁用教程Chrome浏览器怎么禁止图片和视频自动加载_网页媒体内容自动加载禁用教程Chrome浏览器怎么禁止图片和视频自动加载_网页媒体内容自动加载禁用教程

    可通过设置阻止Chrome自动加载媒体。①针对特定网站:点击地址栏锁形图标→网站设置→将“自动播放”设为不允许;②全局禁用:进入chrome://settings/content→自动播放→设为默认不允许;③使用扩展如uBlock Origin拦截媒体加载;④启用Lite模式以节省数据并延迟媒体加载…

    2026年9月25日 • 用户投稿
    300
  • 修改 Android KeyStore 中 KeyPair 的用途

    修改 Android KeyStore 中 KeyPair 的用途修改 Android KeyStore 中 KeyPair 的用途修改 Android KeyStore 中 KeyPair 的用途修改 Android KeyStore 中 KeyPair 的用途

    本文档介绍了如何在 Android KeyStore 中修改现有 KeyPair 的用途,使其支持密钥协商 (Key Agreement) 操作。通过示例代码展示了如何利用 KeyStore.setEntry 方法在 Android 13 (API 33) 及以上版本中导入 KeyPair 并设置所…

    2026年9月25日 • 用户投稿
    600
  • sublime怎么跳转到指定行_sublime快速定位行号的方法

    sublime怎么跳转到指定行_sublime快速定位行号的方法sublime怎么跳转到指定行_sublime快速定位行号的方法sublime怎么跳转到指定行_sublime快速定位行号的方法sublime怎么跳转到指定行_sublime快速定位行号的方法

    跳转到指定行可通过快捷键实现:Windows/Linux按Ctrl + G,Mac按Cmd + G,弹出对话框后输入行号(如50)或行:列(如50:10)即可定位,状态栏双击亦可打开该对话框,还可通过命令面板输入“goto line”进行跳转,其中快捷键方式最快捷。 在 Sublime Text 中…

    2026年9月25日 • 用户投稿
    700
  • sublime怎么查看和安装主题_Sublime主题安装与切换美化教程

    sublime怎么查看和安装主题_Sublime主题安装与切换美化教程sublime怎么查看和安装主题_Sublime主题安装与切换美化教程sublime怎么查看和安装主题_Sublime主题安装与切换美化教程sublime怎么查看和安装主题_Sublime主题安装与切换美化教程

    在Sublime Text中更换和安装主题能显著提升编码体验,让界面更美观、更符合个人习惯。下面详细介绍如何查看、安装以及切换主题。 查看当前使用的主题 要确认当前Sublime Text正在使用哪个主题,可以打开命令面板: 按下 Ctrl+Shift+P(Windows/Linux)或 Cmd+S…

    2026年9月25日 • 用户投稿
    600
  • uc浏览器怎么看小说没有广告_UC浏览器小说模式去广告阅读技巧

    uc浏览器怎么看小说没有广告_UC浏览器小说模式去广告阅读技巧uc浏览器怎么看小说没有广告_UC浏览器小说模式去广告阅读技巧uc浏览器怎么看小说没有广告_UC浏览器小说模式去广告阅读技巧uc浏览器怎么看小说没有广告_UC浏览器小说模式去广告阅读技巧

    开启UC浏览器阅读模式可屏蔽小说广告,点击书本图标进入纯净界面;使用去广告定制版能彻底杜绝广告加载;启用内置广告拦截功能,开启“智能拦截”开关,有效过滤弹窗与诱导内容。 如果您在UC浏览器中阅读小说时频繁遭遇广告弹窗,导致阅读体验中断,可以通过浏览器内置的特定功能来屏蔽干扰。这些功能能有效过滤网页中…

    2026年9月25日 • 用户投稿
    100

发表回复

登录后才能评论
关注微信